 コンテンツにスキップ

私がどのようにしてその Redis オフセット 的を絞って読み、分析し、高品質なデータを得るために一貫性 活用しています。これにより、レプリケーションのギャップを早期に検知し、フェイルオーバーのリスクを評価し、本番用クラスタを確実に同期させることができます。.
中心点
以下の要点では、テーマ、用語、および実践的な取り組みについて、具体的に解説しています。.
- オフセット レプリケーションストリームの進行状況を1バイトずつ計測します。.
- ラグ これは、master_repl_offset と slave_repl_offset の差です。.
- ID+オフセット 部分的な照合のための正確なデータバージョンを示します。.
- バックログ 一時的な接続切断時のフル同期を防ぎます。.
- モニタリング INFO/クラスターメトリクスを使用して、アラート通知とフェイルオーバーを制御します。.
Redisのレプリケーションオフセットとは何ですか?
レプリケーションオフセットは、転送される各 バイトストリーム プライマリとレプリカ間のレプリケーション状況を反映しています。これを見て、レプリケーションがどの程度進んでいるか、またレプリカにまだ処理が残っているかどうかを確認します。この master_repl_offset プライマリでは、新たに生成されるバイトごとにオフセットが増加しますが、レプリカはコマンドを適用するたびに独自のカウンタをインクリメントします。 この差はバイト単位の遅れとなり、レプリカが遅れをとっているかどうかを示します。このシンプルでありながら効果的な仕組みにより、オフセットは同期、障害分析、そして適切なフェイルオーバーの判断において極めて重要な数値となります。.
オフセットの読み取り:INFO replicationを正しく活用する
私は診断を、ほぼ毎回、次のように始める INFO replication。このコマンドは関連するフィールドを簡潔に表示してくれるためです。プライマリ側では、master_repl_offset および接続されたレプリカのステータス(それらのオフセットを含む)を確認します。 レプリカ側では、さらに master_link_status や同期状態を確認し、進行中のフル同期や部分同期を特定します。より詳細な分析を行う際には、構造化された出力情報を活用し、オフセットと CPU、I/O、ネットワークの値を照合します。 このコマンドに関する詳細な解説は、以下のガイドにまとめられています: モニタリング用のRedis INFO.
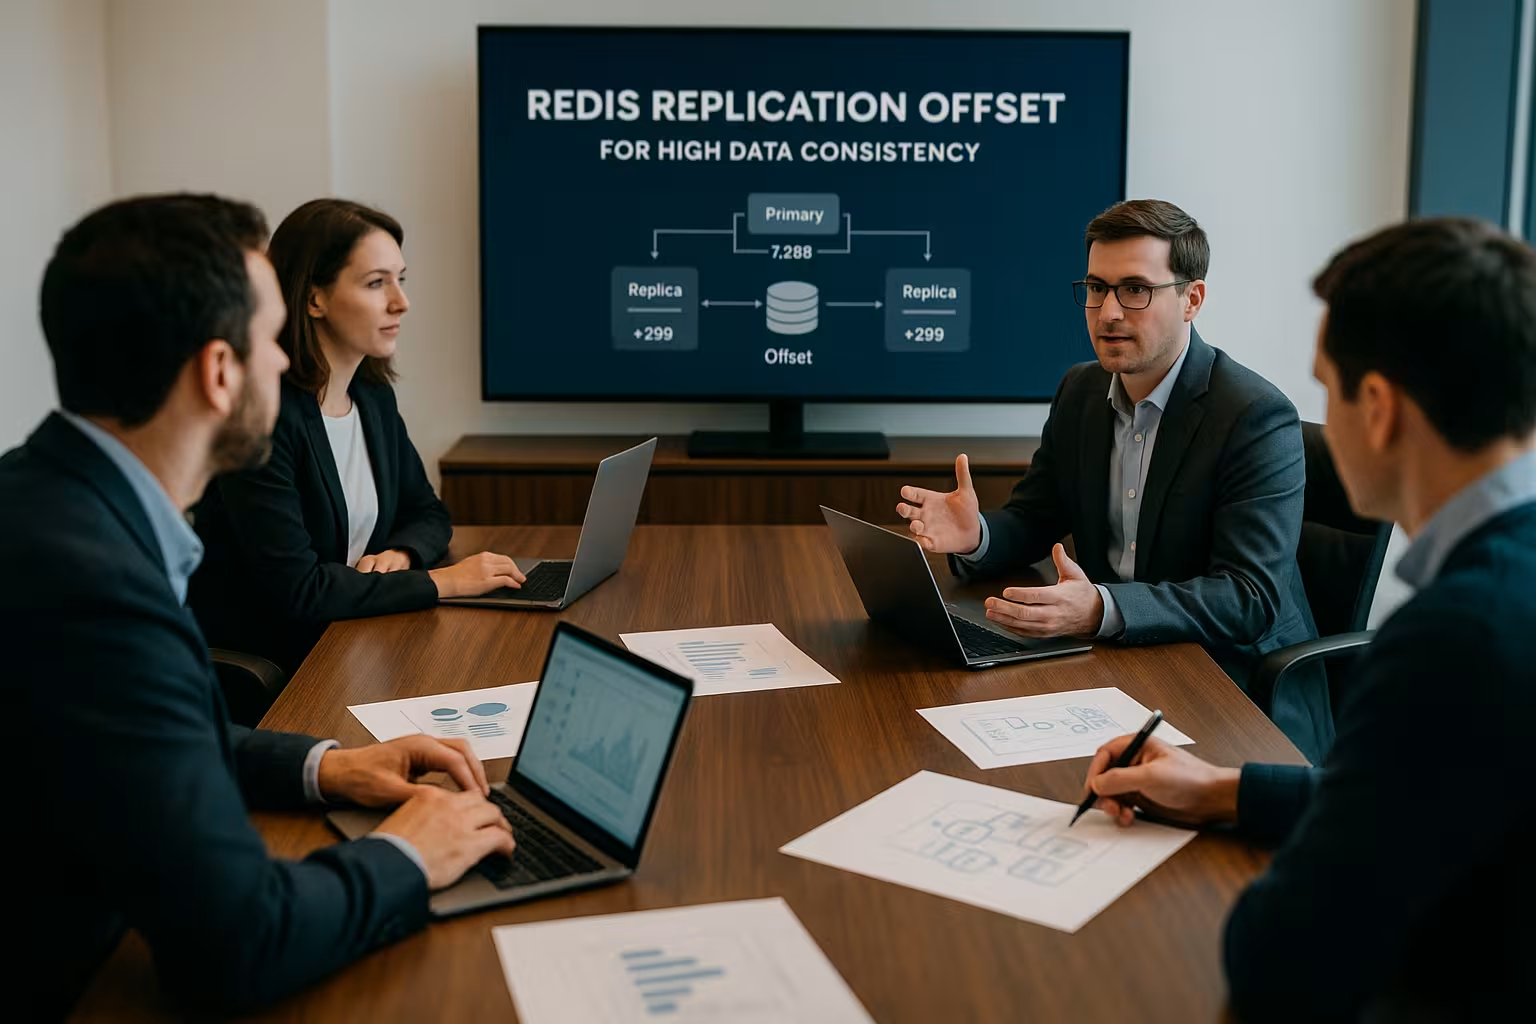
レプリケーションID + オフセット:一意のデータバージョン
バージョンを明確に区別するために、私は以下の組み合わせを使用しています。 レプリケーション IDとオフセット。IDは履歴を識別し、オフセットはその履歴内の位置を示します。2つのインスタンスでIDとオフセットが一致する場合、両者は同じデータ状態にあるとみなします。この組み合わせにより、レプリカがプライマリに対して、最後にどの状態だったかを正確に伝えることができるため、部分的な再同期が可能になります。 また、これにより、データの不一致なくフェイルオーバーが成功するか、それとも完全な同期が必要になるかを判断することもできます。.
レプリケーションのバックログとギャップの規模を算出する
プライマリーは一つ保持している バックログ リングバッファとして設定し、直近の書き込みを保存して部分的な同期を可能にします。 バッファが小さすぎると、負荷のピーク時にバイトが早く溢れ出し、一時的に切断されたレプリカが部分的な再同期を見逃してしまいます。私は、書き込みプロファイルとRPO目標に基づいてサイズを決定し、短時間の切断によってコストのかかるフル同期がトリガーされないようにしています。 大まかな指針として、数秒から数分の記録時間における予想データ量を少なくともバッファに収容できるサイズを選択しています。これにより、プライマリとレプリカ間のギャップを縮小し、再接続の負荷を最小限に抑えています。.
バックログの規模を正確に把握する
実際のところ、私はバックログのサイズを単なる感覚だけで決めるのではなく、実際に観測されたバイトストリームに基づいて計算しています:
- を決定する。 スループット(バイト/秒), 、master_repl_offset の増加を所定の間隔(例:10~60 秒)で測定し、ピーク値を記録することで。.
- を定義する。 許容される中断時間 (例:メンテナンスウィンドウ、ネットワークの変動)を秒単位で。.
- ピークバイト/秒に中断時間を掛け、さらに 安全係数 (1.5~3倍)を加える。.
例:ピーク80 MB/s、予想切断時間20秒、係数2 → 80×20×2 = 3,200 MBのバックログ。これにより、タイミングが悪くても部分的な同期が確実に成功するようにしています。 その後、モニタリングでバックログが容量限界に達することがほとんどないかを確認し、もし達している場合は、段階的にバックログを増やしていきます。.
Hz、バッチサイズ、ネットワークの調整
バックログに加えて、私は hz-この設定は、内部のメンテナンスサイクルに影響を与え、ひいては平均レイテンシにも影響するためです。さらに、書き込みバッチサイズ、パイプラインの利用率、TCPパラメータを確認し、レプリケーションのフローをよりスムーズにするよう調整しています。 プライマリとレプリカ間のレイテンシが低いほど、オフセットの差を直接的に小さくすることができます。レプリカ側のボトルネック、例えばストレージの速度が遅い場合やCPUリソースが不足している場合なども、オフセットの差を拡大させます。 そのため、私は一度に1つの要因のみを変更し、オフセットの差に与える影響を測定し、その効果を明確に記録しています。.
ディスクレス同期とスナップショットがオフセットに及ぼす影響
フルシンクを行う際には、私は主に以下を使用しています ディスクレス同期, 、これはプライマリがRDBストリームをネットワーク経由で直接配信するため、ローカルストレージへの追加の書き込み負荷が発生しないからです。これにより、I/Oのピークが低減され、接続および切断時のオフセットが安定します。適度な遅延(repl-diskless-sync-delay) により、他のレプリカが接続する時間を確保できるため、1つのRDBストリームが複数回利用されることになります。この際、CPUおよびネットワークの使用率を監視しています。というのも、データ量が非常に多い場合、ディスクレス転送であっても一時的な遅延が発生する可能性があるからです。.
スナップショット(RDB)は、フォーク時にコピー・オン・ライトを引き起こします。書き込みが頻繁に行われるシステムでは、これにより一時的にメモリ使用量が増加し、 適用率 レプリカでのパフォーマンス低下を防ぐため、スナップショットの取得を比較的負荷の少ない時間帯に設定し、メモリの空き容量を確認するとともに、レプリケーションパスとAOFパスが競合しないように注意しています。.
実務における部分的な再同期
レプリカが一時的に停止した場合は、私はまず常に 部分照合 を達成するためです。再接続時、レプリカはレプリケーションIDと最新のオフセットを通知し、これを受けてプライマリはバックログから不足しているバイトを送信します。バックログが不足している場合、またはIDが変更された場合は、RDB転送とキャッチアップフェーズを含むフル同期が開始されます。 この際、私はオフセットを監視し、レプリカがどのくらいの速さで追いついてくるか、また両方のカウンタがいつから再び接近し始めるかを確認しています。部分的な同期が成功すれば、レイテンシやI/Oのピークは大幅に低減されます。.
レプリケーションID、PSYNC2、およびリセット時の動作
正確な解釈を行うために、私はPSYNC2セマンティクスを採用しています。プライマリは最新の レプリケーションID さらに、履歴IDとそれに対応するオフセットも含まれます。 再出発やリーダーシップの交代 プライマリIDが変更されます。古いIDは、エンドオフセット付きの履歴として保持されます。これにより、必要な範囲がバックログに含まれている限り、レプリカはIDが変更されても部分同期によって遅れを取り戻し続けることができます。私は INFO レプリケーション そのため、両方のIDとオフセットを比較することで、IDの切り替えがすでに発生したか、あるいは間もなく発生するかを判別する。.
重要なのは、オフセットが 履歴ごとの単調, 、しかしIDの変更は新しいタイムラインを定義します。トレンド分析においてこの変化を正しく位置づけるため、私は運用中にこの変更を記録しています。64ビットのオフセットが上限を超えることは事実上ありません。履歴に影響を与えるのは、再起動、フェイルオーバー、あるいはバックログの配線といった要素の方がはるかに重要です。.
オフセットの文脈におけるクライアントの受領確認と有効期間
オフセットを表示する 進歩, 、ただし耐久性については保証しません。レプリカに関する確認が必要な場合は、以下も併用しています:
- WAIT: プライマリは、N個のレプリカが書き込みコマンドを受信し、そのコマンドをインプットバッファに取り込んだ後に確認を行う。これはフルシンク方式よりも高速だが、ストレージへの永続性は保証されない。.
- min-replicas-to-write そして min-replicas-max-lag: プライマリは、十分に近接したレプリカが接続されており、それらのレイジが閾値以下である場合にのみ、書き込みを受け付けます。これにより、スプリットブレインのリスクが低減されます。.
私はこれらのメカニズムをオフセットと組み合わせて使用しています。オフセットは 実際の WAIT/min-replicas における追いつき速度と長期的な傾向 コマンドごとに 保護を提供する。厳格なRPOの場合は、これらを組み合わせて、モニタリングで両方のビューを記録する。.
モニタリング・スタックにおけるアラートとメトリクス
監視のため、私は明確な しきい値 バイト単位のオフセット差に基づいて計算されます。このメトリクスをPrometheus/Grafanaの時系列データと連携させ、ギャップが定義された期間を超えて拡大した場合にアラームを発生させます。 さらに、負荷のピークを検知し、対策を計画するために傾向をログに記録しています。ダッシュボードでは、`master_repl_offset`、レプリカのオフセット、および算出された遅延を可視化しており、これにより運用中の分析が大幅にスピードアップします。時系列データを用いたセットアップに関する実用的なヒントは、こちらから入手できます: PrometheusとGrafanaを使ったRedisの監視.
ランブックとエスカレーション手順
遅延が増加した際にチームが的確に対応できるよう、標準化された手順を用意しています:
- 警告: レイテンシ > X MB、継続時間 > Y 秒 → レプリケーション接続のスループットとレイテンシを確認し、競合するジョブ(スナップショット、大規模な Lua スクリプト)を特定する。.
- 少佐: 負荷が継続的に上昇している → バックログの処理率、レプリカのCPU/IO、ネットワークエラー(再送信、パケットドロップ)の間に相関が見られるため、必要に応じて書き込み負荷を抑制する。.
- クリティカル: バックログが溢れそう → レプリカの負荷を軽減する(例:一時的に読み取り負荷を迂回させる)、フルシンクウィンドウを計画するか、追加のレプリカを投入する。.
フェイルオーバーがまだリスクが低い場合と、オフセット・ギャップが縮小するまで待つべき場合を明確にするため、意思決定ツリーを記録しています。.
Redis Cluster:シャードごとのオフセットの評価
クラスタ内でオフセットを確認しています シャードごと, 、というのも、各シャードが独自のレプリケーションストリームを管理しているからです。CLUSTER SHARDS コマンドを実行すると、スロット範囲、ノードの役割、およびプライマリとレプリカの関連するオフセットが返されます。あるシャード内で大きな差異が見られる場合、そのシャードの順序付きフェイルオーバーにおいてリスクが生じる可能性があります。 そのため、私はすべてのシャードのオフセットを体系的に比較し、遅延が最小限のノードをリーダー候補として優先的に選定しています。これにより、全体像の一貫性を保ち、切り替え時の予期せぬ事態を防ぐことができます。.
クラスタの日常:リシャーディングとスロット移行の監視
時点では スロットのずれ 書き込み負荷はしばしば不均一に増加します。私はMIGRATEフェーズ中にシャードごとのオフセットを測定し、個々のレプリカが遅れをとっていないかを確認しています。特に、バックログが小さい状態で移行ウィンドウが長引く場合は注意が必要です: このような場合、部分的な同期が失われないよう、バックログを大きく設定するか、移行を段階的に行うようにしています。各シャードのフェイルオーバーを行う前には、宛先ノードが最近スロット負荷を引き継いでいるか、そのレプリカオフセットが安定しているかを評価しています。.
ユースケース:オフセットを的確に解釈する
レプリケーションの遅れを評価するために、私は体系的に以下のものを比較しています。 マスター_repl_offset を各レプリカオフセットと照合し、そこから古くなっている可能性のあるデータの経過時間を算出します。計画的な切り替えを行う前には、最も近いレプリカを特定し、数分間にわたってその整合性を確認することで、フェイルオーバーのリスクを評価します。 ラグが繰り返し増加する場合は、ネットワークメトリクス、CPU負荷、I/Oと相関分析を行い、ボトルネックを特定して的を絞って解消します。 厳格な耐久性目標については、AOF 内の操作がコミットされているか、およびオフセットがそれにどのように対応しているかも確認します。これらのパターンを活用することで、客観的な数値に基づいて意思決定を行い、ダウンタイムを最小限に抑えることができます。.
カスケードレプリケーションとジオレイアウト
分散型構成では、私はよく レプリカのネックレス (Replica‑of‑Replica) を使用して、広域通信の負荷を軽減します。その際、オフセットはエッジごとに個別に適用される点に留意し、 WAIT:直接接続されたレプリカのみ 重要です。ジオレプリケーションについては、現実的なレイテンシ予算を設定し、リージョンごとにオフセットを個別に測定しています。計画的なリージョンフェイルオーバーは、次の候補リージョンが長期間にわたり最小限のギャップしか示さず、かつネットワークパスが安定している場合にのみ、妥当な措置となります。 距離が長い場合は、バースト書き込みを抑制し、パイプライン処理を適度に活用し、RTTが最も大きいノードのバックログを増やします。.
ホスティング環境における実務に即した運用
マネージド環境では、明確な ダッシュボード, 、オフセット、ラグ、および健全性ステータスを統合するものです。トラブルシューティングを迅速化したいチームにとっては、Redisの詳細な可視化と分かりやすいグラフ表示機能を備えたツールを検討する価値があります。これにより、オフセットのドリフトを早期に検知し、バックログが溢れかえる前や、フル同期によって負荷のピークが発生する前に、対策を講じることができます。 さらに、ステージング環境でフェイルオーバーのテストを行い、切り替え後にオフセットがどのくらいの速さで収束するかを測定しています。このガイドは、グラフィカルな分析への実践的な入門として役立っています: 診断のためのRedis Insight.
ラグの増加に伴うトラブルシューティングのパターン
オフセット・ギャップが大きくなった場合、私は決まった手順に従って対処します:
- レプリカCPUがフル稼働中: シングルスレッドのボトルネックや処理負荷の高いLuaスクリプトが処理を遅らせている。私は処理速度を検証し、スパイクを平滑化する。.
- メモリまたはI/Oの負荷: AOFのリライト、スナップショット、あるいは負荷の高い近隣ジョブがレイテンシを増加させる場合、ジョブのスケジュール変更、ストレージクラスの最適化、またはディスクレス同期の有効化を行います。.
- ネットワークパスが変動する: リトランスミッション、パケットドロップ、MTUの不一致など。インターフェースのエラーやバッファサイズを確認し、パケット損失を低減します。.
- レプリカ出力バッファ: レプリカの制限値を小さすぎに設定すると、プライマリが接続を切断します。私は client-output-buffer-limit 負荷に合わせたレプリカ用。.
- TLSのオーバーヘッド: 性能の低いCPUでは、暗号化処理によってパフォーマンスが低下する可能性があります。私は暗号化の負荷を測定し、コア数を調整するか、ハードウェアアクセラレーションを利用して負荷を軽減しています。.
- 副作用を伴う診断ツール: MONITOR あるいは、ログ出力が多すぎると処理が遅くなるため、私はこうしたツールを控えめに、かつ期間限定で利用しています。.
私はチーム内でこれらのパターンを常に意識するようにしています。そうすることで、警告サインが出た際に一から探し直すのではなく、仮説を迅速に検証し、却下できるようになるためです。.
表形式の概要:主要指標を一目で把握
以下の概要は、業務中に要点をまとめておくのに役立ちます。なぜなら、そこには最も重要な点が 主な数字 さまざまな情報やキャンペーンを一か所にまとめています。.
| 信号 | 意味 | 典型的な情報源 | アクション/解釈 |
|---|---|---|---|
| master_repl_offset | プライマリがレプリケーションストリーム内で生成したバイト数 | INFO レプリケーション | ラグ計算のベースライン、推移を観察する |
| slave_repl_offset | レプリカがすでに適用したバイト数 | INFO レプリケーション、レプリカセクション | master_repl_offset から差し引き、ギャップを算出する |
| レプリケーションID | データ履歴/生成時期を示すマーカー | INFO レプリケーション | オフセットと組み合わせ、部分的な整合性を確認する |
| バックログの規模 | 最新のバイト単位のデータ用リングバッファ | 設定、INFO replication | 書き込み量が多い場合は、より大容量のものを選ぶ |
| replication-offset (クラスタ) | プライマリ/レプリカごとのシャードごとのオフセット | クラスター・シャード | 切り替え対象のシャード候補を評価する |
まとめ:オフセットをマスターし、不具合を防ぐ
をセットした。 オフセット 一貫性、部分的な同期、およびフェイルオーバーの挙動を確実に制御するための主要な指標として採用しています。INFO replication、適切なバックログサイズ、そして適切なアラート設定により、レプリケートされたノード間の同期を緊密に保っています。 クラスタトポロジーでは、シャードごとにオフセットを評価し、遅延が最小限の候補を優先します。hz、ネットワーク、およびストレージパスのチューニングを行うことで、遅延をさらに低減し、コストのかかるフル同期を回避します。 オフセットを徹底的に監視することで、ダウンタイムを削減し、Redisスタック全体の信頼性を大幅に向上させることができます。.


