
Linuxのvmstatを的確に読み解く方法を教えます。CPUのボトルネック、メモリの逼迫状況、スワップ、I/Oの待ち時間をわずか数秒で把握できるようになります。 r、b、free、si/so、bi/bo、us/sy/id/wa/stの各列を確実に解釈し、そのパターンから具体的な対策を導き出す方法を解説します。当て推量に頼ることなく、 クリア ルール。.
中心点
- 実行キュー vs. ボトルネック:r は CPU 負荷を示し、b は I/O 待機時間を警告します。.
- メモリ 現実的に評価する:無料であるだけでは不十分で、その内容こそが決め手となる。.
- 入出力 注目点:waが低いままなら、bi/boは問題にならない。.
- CPUのシェア 解釈:us+syが高い、idが低い → 負荷が高い。.
- ベースライン 作成:日常生活における価値観と、困難な時期の状況を比較する。.
vmstatは実際には何を表示しているのでしょうか?
vmstat は、プロセスの状態、メモリ、スワップ、ブロック I/O、および CPU 使用率をコンパクトな出力にまとめ、数秒で システム全体で 印象的な結果が得られます。まず、r/bについては「procs」を、free、buff、cache、si/soについては「memory/swap」を確認します。次に、bi/boで「io」を検証し、最後にus、sy、id、wa、およびオプションでstについて「cpu」を確認します。 この順序は、原因と結果を区別するのに役立ちます。rの値が高い場合は計算負荷が高く、bの値が高い場合はI/Oの待ち時間を示し、waはCPUのアイドル時間とI/Oのレイテンシを関連付けています。 これにより、処理負荷、メモリ不足、あるいはストレージのどれがボトルネックになっているかを特定でき、さらに 迂回路.
60秒後に開始:呼び出しと間隔
ブート直後のスナップショットを取得するには、パラメータなしで「vmstat」を実行します。リアルタイムの分析には「vmstat 1」を使用するか、5秒ごとに12回の測定を行う場合は「vmstat 5 12」を実行し、その結果として 時間的な 行。重要:1行目はシステム起動以降の平均値を反映しているため、私は主にそれ以降の行を評価しています。 Delay/Count を使ってサンプリングレートと継続時間を制御します。例えば、短いピークの場合は「vmstat 1 30」といった具合です。変動の激しいワークロードでは 1~2 秒、安定したシナリオでは 5 秒程度に設定します。個々のフレームではなく傾向を観察するのは、パターンこそが真の 原因 ショー
プロセスを読み解く:日常生活における「r」と「b」
r 列は、実行可能状態で CPU 時間を待機しているスレッド数を示し、b 列は、多くの場合 I/O 待機中のブロックされたスレッド数をカウントします。r の値が物理コア数より明らかに多い場合、次のような疑問が浮かびます。 CPUのボトルネック ; 4コアの場合、r=8が長時間にわたって続けば、明確なシグナルと見なされます。b値が0より大きく、それが長時間にわたって続く場合は、読み込みに時間がかかるストレージ、負荷過多のデータベース、あるいは遅いネットワークやストレージパスを示唆しています。 私は r を us+sy および id と相関させています。id が低く r が高い場合は CPU が負荷に苦しんでおり、wa と b が高い場合は I/O がボトルネックとなっています。こうして、演算能力をスケールアップするか、クエリを最適化するか、あるいは ストレージシステム チェックする。
メモリの解釈:free、buff、cache、swpd
Linuxではfreeの値が低いのは普通のことです。これは、カーネルがRAMをキャッシュとして積極的に利用し、ファイルアクセスを高速化することで、実際の スループット をもたらします。そのため、私は「free」単独よりも、「swpd」やスワップストリームの「si/so」の方を重視しています。キャッシュ量が多いのは良いことですが、それは「si/so」がほぼ常に0のままである限りです。持続的なスワップの変動があって初めて、真の負荷が示されるのです。 さらにレイテンシが発生したり、OOMに至ったりした場合は、RAMの増設、プロセスの適時トリミング、あるいはキャッシュやJVMサイズの調整といった措置を講じます。重要なのはコンテキストです。ワークロード、メモリ容量、NUMAレイアウトによって、あなたの環境において何が 健康的 が適用される。.
スワップ取引:いずれにせよ分類する
「si/so」の列は、RAMとスワップ間の継続的なデータ転送量をKB/s単位で測定しており、単なる「感覚的な」ものではなく、実際のメモリ負荷を可視化しています。 欠陥. 短時間のピークは正常な現象であり、例えばめったに利用されないページがスワップされる際などに発生します。問題となるのは、si や so の値が継続的に 0 より大きいままの場合です。スワップが発生するたびに追加の I/O 負荷が生じるため、システム全体の動作が遅くなります。 soの値が高い場合は、アクティブなスワップが行われていることを示しており、応答時間が著しく悪化します。この時点で、私は原因の特定を停止します:メモリ消費量の削減、RAMの増設、またはメモリを大量に消費するサービスの 曲.
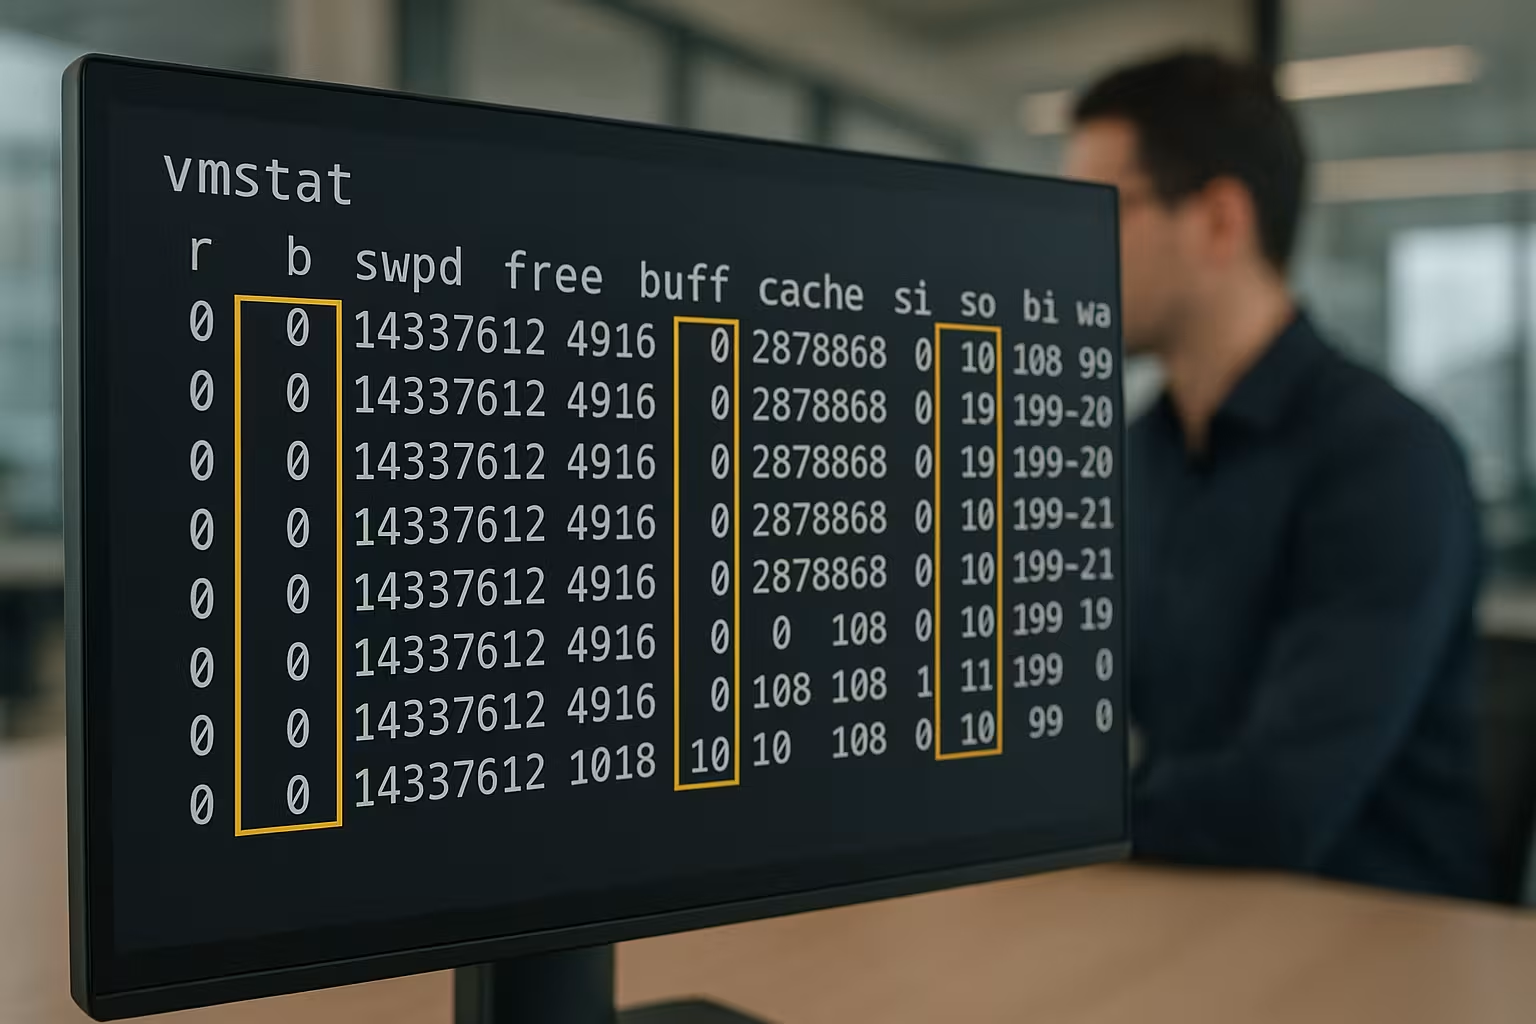
ブロックI/Oの理解:biとbo
bi/bo を使えば、1秒あたりのブロック単位の読み書き速度を把握できますが、文脈がなければそれを評価することはできません。重要なのは、 ウエ. bi/boの値が高く、同時にwa値も高い場合は、ストレージが処理に追いついていないことを示しています。biの値が高い状態でデータベースに問題が生じた場合は、ハードウェアを交換する前に、クエリプロファイルとキャッシュヒット率を確認します。 より詳細なタイミング分析を行う際は、iostatを使用してキューの長さやレイテンシを分析し、 I/O待機時間の分析 そして、ボトルネックを的確に解決できる。waが低いままなのに、bi/boが長期的に急増した場合にのみ、私は スケーリング ストレージシステムの仕様を確認してください。.
CPUの割合:us、sy、id、wa、st
waが低い状態でusの値が高い場合は生産的な有用作業が行われていることを示し、一方、syの値が高い場合は、無数の小さなI/O操作や多数の コンテキストの変更. idが0近くまで低下し、その状態が続く場合、CPUは限界まで稼働しています。これにrが高い値が組み合わさると、計算負荷が高いことを示唆します。waが上昇する場合は、CPUがI/Oを待機している状態です。この場合、ストレージの微調整は、CPUのアップグレードよりも大きな効果をもたらすことがよくあります。 VMでは、st(steal)に注目しています。stの値が高い場合は、ハイパーバイザーがCPU時間を割り当てていることを示しているため、運用担当者とホストの使用率について話し合います。私は常にus+syを合計値として評価しています。これはアクティブな 労働 システム内。.
クイックリファレンス:列と目安値
以下の表は、vmstatの出力を最初に確認する際の、手短なメモとして活用しています。 評価 ざっと目を通す。.
| 列 | 意味 | 注意していること |
|---|---|---|
| r | 実行可能なスレッド | 「永続的」 > コア → CPU負荷 |
| b | ロックされたスレッド | 定数 > 0 + wa 上昇 → I/O 問題 |
| 無料 | フリーラム | si/so が ≈ 0 のままである限り、低い値でも問題ない |
| buff/cache | FSバッファ/ページキャッシュ | キャッシュが多いのは良いこと;公開可 になる |
| シ/ソ | スワップ・イン/アウト | 定常 > 0 → 実貯蔵圧力 |
| bi/bo | ブロックI/O | waが同時に高い場合のみ、批判的である |
| us/sy | ユーザー/カーネル | us+sy 持続 > 80% → 高 負荷 |
| アイドル | アイドリング | 0付近で時間が経過 → CPUが飽和状態 |
| ウエ | I/O待機 | b大文字の「Hoch」→ 原因はストレージ |
| スト | スティール(VM) | 高 → ハイパーバイザーが CPU-時間 |
ベースラインと継続的モニタリング
私は単発のデータに頼るのではなく、平穏な時期のベースライン値と照らし合わせて値を調整し、外れ値を正確に 認識する. 「vmstat 1 60」を実行すると、1分間の負荷プロファイルが得られ、それを既知の通常状態と比較します。過去の状況を確認するには、 sar/sysstat の監視, 、数日単位の傾向を評価し、閾値を最適化するためです。アラート設定は保守的に行っています:Kernelに対するr、複数の区間においてsi/soが0と異なること、waが著しく上昇していることなどです。これにより、ユーザーから遅延の報告がある前や、 ピーク-フェーズがエスカレートする。.
Vmstatとその他のツールの併用
まずvmstatを実行し、その傾向に基づいて判断を下した後、iostat、mpstat、pidstat、あるいはアプリケーションメトリクスなどを活用して原因を特定するために、的を絞って詳細な分析を行います。 クリア 割り当てる。vmstatではI/O待ち時間を表示し、iostatではデバイスごとのレイテンシとキューを測定する。rはカーネルリミットを示し、mpstatはカーネルの非対称性を示す。プロセスのピーク負荷時には pidstat プロセス分析 時間に関する最も激しい議論。ログやアプリケーションのタイミングとの相関関係が、その全体像を明確にし、私を真実に導いてくれるのだ。 原因.
パターンを認識し、行動する
rが高い、idが低い、waが中程度と表示される場合、アプリケーションは計算負荷が高くなりすぎるように最適化されることが多いため、実行する前にコードや並列処理を確認し、CPUリソースを計画するようにしています。 ハードウェア 確認します。b、wa、bi/boが同時に上昇している場合は、ストレージのチューニング、クエリの最適化、キャッシュを検討します。freeが低く、si/soが0より大きい場合は、メモリ使用量を削減するか、結果をストリーミングするか、RAMを増設します。 usが中程度、syが非常に高い場合は、パケットフィルタ、ファイルシステムのオプション、またはドライバを確認します。このチェックリストを活用することで迅速に対処し、最も効果的な場所に時間を割くことができます。 カウント.
測定誤差を防ぐ:サンプリング、単位、最初の行
私は意図的に、最初の行を急激な障害の検出には用いません。というのも、この行は起動時から平均化を行っており、ピークを完全に平滑化してしまうからです。 また、サンプリングレートは原因の仮説に基づいて設定しています。CPUのピークは1秒間隔で、緩やかなメモリリークは5~10秒間隔で捕捉するようにしています。 単位にも注意を払っています:si/soはKB/s、bi/boは「ブロック/秒」です(歴史的には1ブロックあたり1KBですが、vmstatのバージョンによって異なります)。 「vmstat -w」(詳細出力)で列の切り捨てが発生しないか、またクロック周波数の変化(Pステート、ターボ)が短期的な負荷の認識に影響を与えないかを確認します。 測定は、単に「1分単位」を盲目的に観察するのではなく、アプリケーションのピークと同期させて行います。.
システムセクションの解読:in および cs
procs/memory/swap/io/cpu のほか、vmstat は「system」も表示します: に於いて (1秒あたりの割り込み数) および cs (コンテキストスイッチ/秒)。この2つの値からは、カーネルのオーバーヘッドについて多くのことが分かります。.
- csが、適度な負荷にもかかわらず非常に高い場合:スレッドのフラッター、ワーカーバッチのサイズが小さすぎる、またはロックの競合が考えられます。バッチサイズを拡大し、並列処理(スレッドプール)を調整し、スケジューラやミューテックスのホットスポットを確認します。.
- 急激な上昇:ネットワークまたはストレージ割り込みの集中発生、NAPI/ポーリング効果、あるいはタイマー割り込みなど。syの割合やiostatの分析結果と照らし合わせて、ドライバやネットワーク経路を確認しています。.
- cs が r に比例している:これは、過度な並列処理による絶え間ないコンテキスト切り替えの負荷を示唆しています。アクティブな並列処理を抑制するか、ホットスレッドをコアに固定します。.
私は常に in/cs を sy および b/wa と相関させて分析しています。これらを組み合わせて初めて、カーネルの処理が有意義なもの(例えばスループット)なのか、それとも単なるオーバーヘッドなのかが明確に把握できるのです。.
役立つvmstatのバリエーションとオプション
vmstatを柔軟に活用することで、ツールを切り替えることなく、新たな視点を得ています:
- vmstat -s: 累積カウンター(例:起動以来開始されたプロセス数、メジャー/マイナー・ページフォールト数)。リークやイベント数の推移を比較するのに最適です。.
- vmstat -m: スラブの利用 – カーネルキャッシュ(Dentry/Inode、ネットワーク)をメモリ消費要因として分類するのに役立ちます。.
- vmstat -d: 合計レベルのディスクイベント。iostatの代わりにはなりませんが、手っ取り早く現状を確認するには便利です。.
- vmstat -S M: 数値を読みやすくするために、単位を(M/K)に変換する。.
- vmstat -w: 列の幅を広くすると、長い数値の列でも文字が切り取られるのを防ぐことができます。.
イベントを見逃さず、かつ全体像を把握できるよう、これらの方法を短い間隔で組み合わせています。.
コンテナ、VM、およびcgroups:特徴
コンテナ内では、vmstat の数値を慎重に解釈しています。カーネルデータの多くはホスト全体に適用されるものであり、制限値は Cgroups から設定されます。コンテナ内の r 値が高い場合、それはネームスペースの観点からの数値を反映していますが、実際の CPU 時間は CPU クォータや CPU シェアによって制限されている可能性があります。私は スト (スティール)をVMに組み込む:スティール値が高いということは、ハイパーバイザーが私の処理時間を奪っていることを意味します。ホストがオーバーブッキングされている限り、アプリを完璧に最適化してもほとんど効果はありません。 Cgroupのメモリ制限が設定されている場合、コンテナが制限に達して「もがいている」にもかかわらず、スワップが発生せずにOOMキルが行われることがあります。そのため、私は追加でOOMログやCgroupの統計情報を確認し、vmstatのスナップショットと制限値を照合しています。.
NUMAとアフィニティ:ロカリティが重要となる場合
NUMAホストでは、コアごとにrおよびus/syを(mpstatを使用して)確認し、一部のソケットが「過熱」している一方で、他のソケットがアイドル状態になっていないかを観察します。メモリロカリティが適切でない場合、遠隔のメモリアクセスによってcs/syやb/waが増加します。 CPUおよびメモリのアフィニティ(cpuset、numactl)をテストし、大規模なヒープを「インターリーブ」または「ストリクトリーローカル」に設定し、ホットスレッドがデータのフットプリントがある場所で実行されるように注意を払っています。 安定したNUMAレイアウトは、csを平滑化し、waの異常値を低減し、 計画性 負荷がかかっている
誤解を避ける:「wa」と「b」は単なる「低速なデータ媒体」以上のもの„
waは、従来のディスク遅延だけでなく、NFSや高遅延ネットワーク、飽和状態のオブジェクトストレージ、ブロッキングするクラウドボリューム、あるいは処理に時間がかかるページキャッシュの書き込みなども、waを押し上げる要因となります。 bは、中断不可能なスリープ状態(Dステート)にあるタスクをカウントします。これには、ドライバ、ネットワークパス、またはファイルシステムのロックによるハングも含まれます。 そのため、私はwa/bを単独で評価することは決してなく、常にbi/boおよびアプリケーションのタイミングと併せて評価しています。waが高いのにbi/boが低い場合、多くの場合、 待機依存性 単なるデバイスのスループットの問題を超えた課題(例:ロッキング、リモートI/O、ライトバックのボトルネックなど)。.
節度あるチューニング:Swappiness、Writeback、Scheduler
Kernel-Tunerの変更は、測定を終えてから、かつロールバック計画を立ててから行います:
- vm.swappiness: 値が低いとプロアクティブなスワップが抑制され、レイテンシが重要なアプリに適している。ただし、低すぎるとページキャッシュへの負荷が高まる可能性がある。.
- vm.dirty_background_ratio / vm.dirty_ratio (または *_bytes):ライトバックのタイミングに影響を与えます。値が高すぎると長いライトバースト(waのピーク)が発生し、低すぎると頻繁な小規模なフラッシュが増加します(sy/boが上昇します)。.
- I/Oスケジューラ/キューの深さ: NVMeでは、HDD/RAIDとは異なる最適化設定を採用しています。設定を変更する前に、iostatを使ってレイテンシとスループットのトレードオフを測定しています。.
- ネットワークパス: 多くの小さなパケットや割り込みが /cs/sy に流入しています。大まかなチューニングの調整項目としては、GRO/LRO、RPS/RFS、IRQアフィニティなどがあり、私は変更前後の測定を行っています。.
私の目標は、vmstatのグラフが安定し、予測可能な状態になることです。つまり、us/syが穏やかで、wa/bが低く、si/soが0に近い状態です。その状態になって初めて、ハードウェアの拡張を行います。.
プレイブック:vmstat を使った 3 分間の分析
- 0:00–0:30 – 「vmstat 1 30」:最初の行は無視し、その後 r/b、us/sy/id/wa を確認する。質問:CPU リミット(r が高い、id が低い)か、それとも I/O リミット(b/wa が高い)か?
- 0:30–1:00 – タンクの状態確認:swpdおよびsi/soを確認。si/soが常に>0か? → 実際のタンク圧力。freeは参考程度。.
- 1:00–1:30 – I/Oのコンテキスト:bi/bo 対 wa。bi/boが高いのにwaが低い?→ I/Oがバイパスされる。bi/boが中程度なのにwaが高い?→ レイテンシ/ロック/リモートI/O。.
- 1:30–2:00 – システム・セクション:in/cs と sy の比率。cs が非常に高い?→ コンテキスト切り替えの負荷、並行処理/ロックを確認。.
- 2:00–3:00 – 仮説を固め、適切なツールを選択する:I/Oインデックスについてはiostat、カーネルの非対称性についてはmpstat、プロセスのホットスポットについてはpidstat。その後に初めてチューニング/スケーリングを行う。.
実務における応用例
- CPUの飽和状態(高いrなし): us+sy が 90%+、id ≈ 0、r は中程度 → シングルスレッドのホットスポット、またはアフィニティの問題。解決策:ホットパスを並列化し、コアピンニングを確認する。.
- スワップ・スラッシュ: いずれにせよ、同時に明らかに > 0 となり、b/wa が上昇し、us が低下する → RAM が著しく不足しているか、ヒープのサイズ設定が不適切である。対策:RAM を増やす、ワーキングセットを縮小する、スワッピネスを調整する。.
- カーネルのオーバーヘッド: sy が高い、cs/in が高い、us が中程度 → 多数の小さなシステムコール/I/O。対処法:バッチ処理、システムコールの削減、ファイルシステムのマウントオプションの確認。.
- 書き戻しの滞留: WA値が高い、BO値が高い、短い波形 → ダーティ・ボーダーが高すぎる、ストレージのレイテンシが変動している。ライトバックのチューニングとI/Oスケジューラを確認する。.
- 仮想化への圧力: st は表示されている、r は変動する、id は「跳ねる」→ ホストが CPU を共有している。解決策:vCPU の割り当て/配置を確認し、オーバーコミットを削減する。.
vmstatの限界を知る
Vmstat は非常に優れた 早期警報センサー, 、ただし顕微鏡ではない。これは、どこで問題が発生しているかを示してくれるが、個々の問題のあるファイルやクエリ、スレッドを特定するわけではない。 そのため、vmstatによる診断の後には、必ず詳細な分析ツールを使い、多角的な視点から仮説を検証し、変更は一つずつ行うようにしています。そうすることで、改善効果が測定可能かつ再現可能になります。.
練習からのまとめ
vmstat を使えば、r、b、si/so、bi/bo、us/sy/id/wa/st を組み合わせて確認することで、CPU、RAM、スワップ、あるいは I/O のどれがボトルネックになっているかを数秒で特定できます。 読む. 私は個々の数値ではなく傾向を評価し、ベースラインと比較し、必要に応じてiostat、mpstat、pidstat、および過去の測定値を参照します。急激な障害については最初の行を無視し、固定サンプリングレートで記録されたその後の行に焦点を当てます。 データに基づいて判断を下します。rがコア数に対する比率、si/soが継続的に0以外、waが持続的に上昇、us+syがフル稼働に近い状態であることなどを基準とします。このようにして、具体的な対策を迅速に導き出し、システムのパフォーマンスを著しく向上させます。 反応性.


