コンテンツにスキップ

Linuxのcgroup CPUコントローラ サービス、コンテナ、プロセスに割り当てられる計算時間を制御し、パフォーマンスを的確に計画できるようにします。CPU時間を確実に割り当て、ボトルネックを回避できるよう、重み付け、クォータ、およびベストプラクティスがどのように連携するかを具体的に解説します。.
中心点
- 重み付け 対 制限 理解する:公平な分配か、それとも厳しい上限か
- cgroup v2 優先すべき点:明確な意味論、一貫性のある階層構造
- CPU.weight そして cpu.max:2つの操作レバー
- システムディー 活用:サービスごとにルールを設定する
- モニタリング そして 透明性: cpu.stat と PSI の読み方
cgroupsの理解:プロセスグループと目標
私はプロセスを グループ これらをまとめ、CPU、メモリ、I/O といったリソースを、明確に区切られた階層構造で管理します。個々の PID を個別に扱う代わりに、サービス全体、コンテナ、あるいはワーカープールなどをコントロールグループに割り当て、明確なルールを設定します。 これにより、重要なコンポーネントが即座に応答する必要がある状況でも、制御不能になったタスクによってマシンのパフォーマンスが低下するのを防ぐことができます。特にホスティング環境では、同じハードウェア上で多数のクライアントやサービスが稼働しているため、このアプローチが大きな効果を発揮します。実用的な分類方法に関する概要については、こちらの記事をご覧ください。 cgroups とホスティング, 、これにより負担の配分が明確に理解できるようになる。.
CPUコントローラの動作原理
CPUコントローラは分割する 計算時間 2つのメカニズム、すなわち「相対的な重み付け」と「絶対的な帯域幅制限」について説明します。重み付けとは、競合が発生した際に、グループ同士が互いに相対的な比率でCPUシェアを割り当てられることを意味します。値が高いグループほど、タイムスライスを獲得する頻度が高くなります。一方、クォータによる制限は、競合が存在しない場合でも、特定の時間枠内での消費量に上限を設けるものです。 私は、公平性と動的な負荷分散を重視する場合は重み付けを選択し、厳格な上限を絶対に変更できない場合はクォータを設定します。カーネルのドキュメントでは、この違いが明確に説明されており、両方のメカニズムが組み合わさることで、一貫性のある制御モデルが構築されることが示されています[1]。.
cgroup v1 対 v2:違いとファイル
と一緒に cgroup v2 v1の旧バージョンに比べ、CPUルールを統一的かつ分かりやすく管理しています。v1ではコントローラーごとに異なるファイルを使用していましたが、v2では相対的な優先順位には`cpu.weight`を、厳格な帯域幅制限には`cpu.max`に焦点を当てています。 この明確な分離により、セットアップ時間が短縮され、誤解を防ぎ、監査も容易になります。多数のコンテナが存在するホスティング環境では、v2の階層構造によって、すべてのレベルにわたって追跡可能なルールが確保されます。実際の運用に関する評価については、以下の記事で詳しく解説しています。 ホスティングにおけるcgroup v2, 、共有ハードウェアにおける一貫した制御について解説している。.
| トピック | cgroup v1 | cgroup v2 | 代表的なパラメータ |
|---|---|---|---|
| CPUの重み付け | CPUシェア | CPU.weight | CPU.weight (通常は100) |
| CPU使用率/制限 | cpu.cfs_quota_us + cpu.cfs_period_us | cpu.max | cpu.max (例:20000 100000) |
| 階層 | 独立したコントローラー | 統一されたツリー構造 | 各レベルごとの共通ルール |
| リアルタイム | 独立したrtコントローラ | RTに関する制限 | カーネルに関する注意事項 [1] を参照してください |
管理者にとって重要なのは、 一貫性 ルールセットの誤りを減らし、変更を迅速に反映させます。グループノードのパラメータを文書化することで、誰もが現在の影響を把握できるようにしています。 v1からの移行時には、特に「Shares」と「Weight」、および「CFS-Quota」と「cpu.max」の対応関係を慎重に確認します。テスト負荷が予想通りに反応して初めて、本番サービスを新しい階層に移行します。この厳格な移行プロセスにより、後のサポート対応の負担を大幅に軽減できます。.
階層、サブツリー、および権限委譲
cgroup v2 では、コントローラーを制御しています 各レベルごとに 必要に応じて、それらをさらに委任します。以下の方法を通じて cgroup.subtree_control 子ノード用のCPUコントローラーを有効にします。通常、CPUプロパティを設定すれば、systemdが自動的にこれを処理してくれます。重要:v2では、プロセスは理想的には 葉のグループ 中間ノードには割り当てません。そうすることで、ルールがより明確になり、負荷分散もツリー構造に沿って明確に実行されます。複雑な構成では、サービス全体をスライスに割り当てます(例:. tenant-a.slice)、その中にはサービスやワーカープールも含まれます。この明確な分離により、「自分たちの」サブツリーで作業するチームへの権限委譲が容易になり、グローバルなポリシーに抵触することもありません。.
重要なパラメータ:cpu.weight および cpu.max
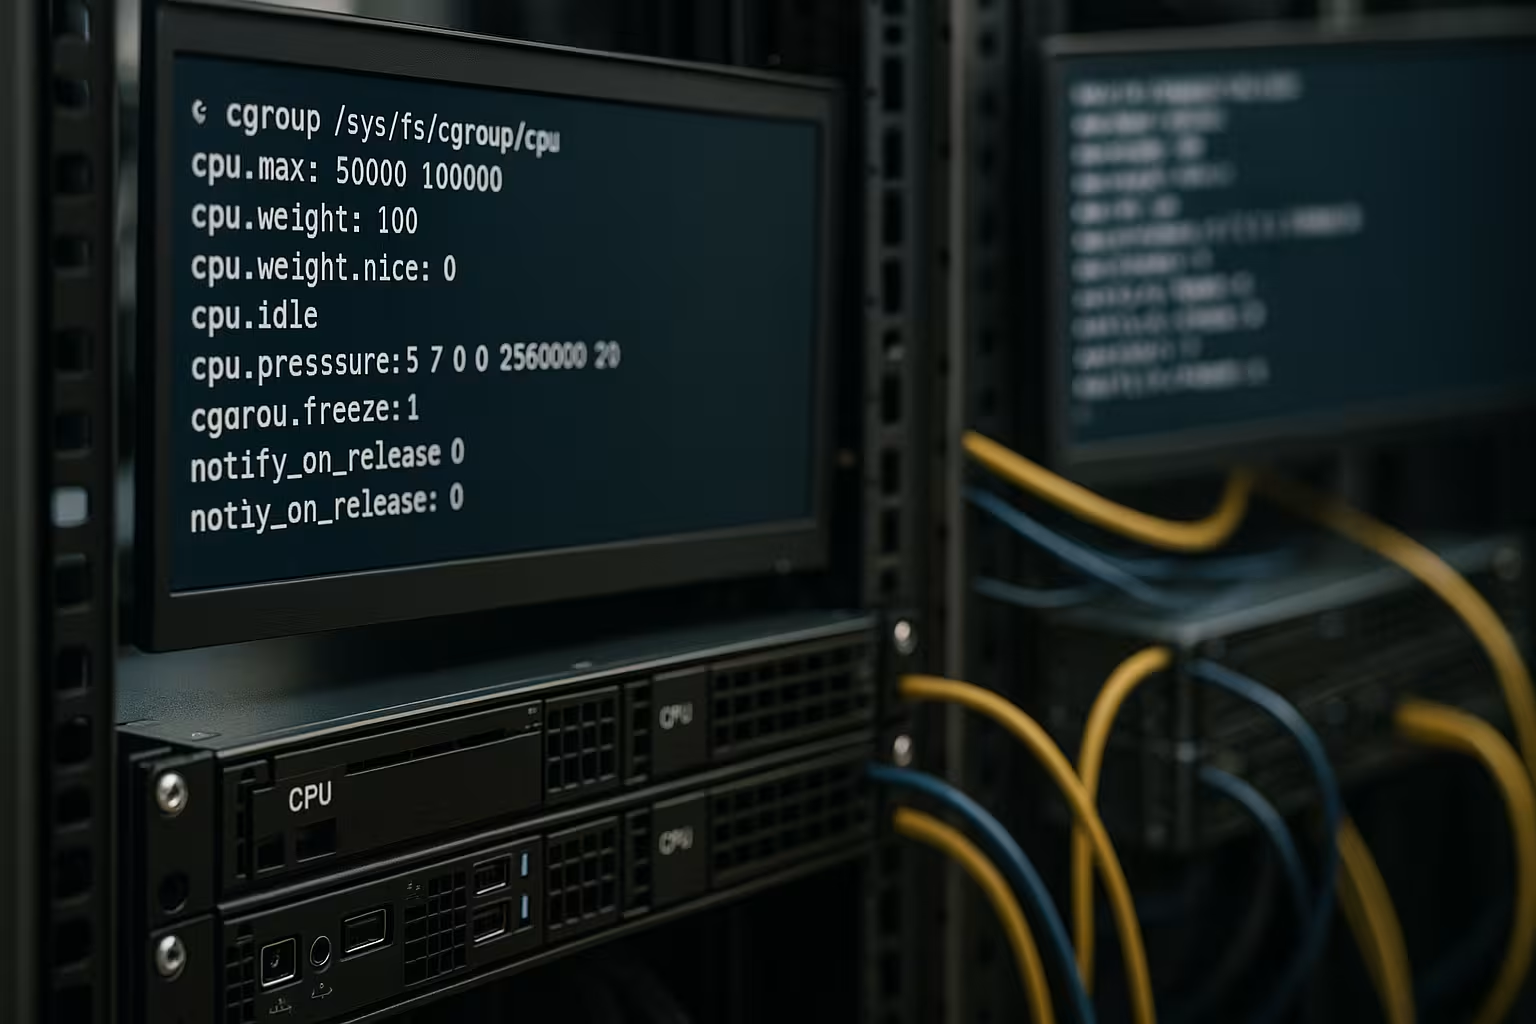
私はこうしている。 CPU.weight, 、サービス間の優先順位を相対的に設定するためです。サービスAにサービスBよりも高い重みが付与されている場合、負荷がかかっている際にAの方が頻繁にCPU時間を割り当てられます。v2での標準値は多くの場合100ですが、値が大きいほどそのグループが優先されます。ただし、バランスを適切に保つため、私は妥当な範囲内に収めるようにしています。 厳格な上限設定を行う場合は、 cpu.max 割当と期間、例えば 20000 100000 vCPUスロットの約20パーセント分。これにより max まず最初に、上限制限を解除しますが、期間の設定はそのままにしておきます。これにより、診断が容易になります。Red Hat は一般的な設定についてわかりやすく解説しており、運用における影響も示しています [2]。.
追加の調整パラメータ:cpu.weight.nice および UClamp
従来の方式から移行するチーム向けに nice-セマンティクスに対応し、v2では以下の機能を提供します cpu.weight.nice 実用的な架け橋:私は~の分野でグループを -20..19 を分類し、これを内部的に重みスケールにマッピングします。これにより、具体的な重みを毎回設定することなく、相対的な期待値(「少し優先する」、「やや抑える」)の一貫性を保つことができます。さらに、必要に応じて 利用率の固定 via cpu.uclamp.min そして cpu.uclamp.max, 、スケジューラレベルで実効CPU使用率の下限および上限を指定するためです。 これにより、例えば、レイテンシが重要なサービスがスレッド数が少ない場合でも必要な基本使用率を下回らないようにしたり、バッチジョブが過度にブーストされないようにしたりすることができます。 この微調整は、重み付けやクォータを補完するものであり、それらに取って代わるものではありません。私は、UClampを広く展開する前に、常に、それがガバナーやエネルギーポリシーとどのように調和するかを検証しています。.
ワークロードの計画:公平性と厳格な制限
を意識的に決めている。 公平性 あるいは、厳格な上限が優先されるようにしています。レイテンシが重要なWebサービスについては、他のグループに過度な不利益を与えることなく、競合時に優先的に実行されるよう、重み付けをわずかに高めています。 計算負荷の高いバッチジョブについては、システムにアイドル状態があっても過度に時間を消費しないよう、追加でクォータを設定しています。 データベースには適度な重み付けを行い、チェックポイント、リビルド、または大規模なクエリがどのように影響するかを監視し、必要に応じて期間限定で調整します。これらのルールをアラートと組み合わせることで、レイテンシが深刻化する前に早期に対応できるようにしています。.
マルチコアにおけるクォータの挙動と周期の選択
よくあるつまずきは、以下の解釈です。 マルチコアシステムにおけるパフォーマンス. 割当とは、 総計算時間 グループごとの期間単位であり、個々のコア単位ではない。. CPUQuota=200% 或いは cpu.max = 200000 100000 100 msの周期あたり、おおむね2 CPU秒が割り当てられます――これはすべてのスレッド/コアに分散されます。これにより、現在の周期における割り当て量が「使い果たされ」、スロットリングがかかるまで、多くのスレッドが短時間並行して実行されることがあります。 私は、クォータを常に「CPUスロット」として捉え、サービスの並列処理状況に合わせて調整することで、誤解を避けるようにしています。.
標準的な期間は、多くの場合、 100ミリ秒. より短い期間(z.B. 50 ms)に設定すると、スロットリングの効果がより早く現れますが、マイクロジッターが発生する可能性があります。周期を長くすると平滑化されますが、反応が遅くなります。systemd では、次のように設定して調整しています。 CPUQuotaPeriodSec= を適用し、レイテンシのピークやスループットの目標値の達成度を検証します。インタラクティブなサービスではエンドツーエンドのレイテンシを測定し、バッチ処理では総スループットと近隣ノードに対する公平性を基準としています。.
実践:systemd と cgroup v2 による設定
systemd では、サービスごとにルールを設定しています。その理由は、 業務ファイル 再現可能な構成を実現する。これにより、 systemctl set-property 設定は随時変更していますが、ドロップインファイルを使って設定のバージョン管理をきちんと行っています。例を挙げると: systemctl set-property --runtime nginx.service CPUWeight=150 NGINXは優先順位をわずかに調整します;; systemctl set-property --runtime batch.service CPUQuota=20% バッチジョブを終了させます。私は常に /etc/systemd/system/service.d/limits.conf 該当するオプションを設定し、ユニットを再読み込みしてください。実践的な入門として、こちらのガイドを参照することをお勧めします。 systemdリソース制御, 、最も一般的な選択肢を簡潔にまとめたものです。.
# cgroup v2 を使用した systemd v245+ の例
# 相対的な優先順位設定
systemctl set-property --runtime nginx.service CPUWeight=150

# ハード上限
systemctl set-property --runtime batch.service CPUQuota=20%

# ドロップインファイルでの組み合わせ
mkdir -p /etc/systemd/system/php-fpm.service.d
cat < /etc/systemd/system/php-fpm.service.d/cpu.conf
[Service]
CPUWeight=120
CPUQuota=50%
EOF
systemctl daemon-reload
systemctl restart php-fpm.service
テナントおよびチーム向けのスライス
クライアントやチームの境界線については、私は以下を使用しています スライス 組織的な枠組みとして。「スライス」は、まとめて管理される複数のサービスとスコープをカプセル化します。これにより、各ユニットを個別に管理することなく、顧客ごとに予算を割り当て、変更を管理された形で委任することができます。.
# テナントスライス(標準ルール)
mkdir -p /etc/systemd/system/tenant-a.slice.d
cat < /etc/systemd/system/tenant-a.slice.d/cpu.conf
[Slice]
CPUWeight=120
CPUQuota=150%
# オプション:よりきめ細かなスロットリングのための期間
CPUQuotaPeriodSec=100ms
EOF
systemctl daemon-reload
systemctl restart tenant-a.slice
以下のすべてのサービス tenant-a.slice これらの設定を引き継ぎます。一時的なピーク時には、負荷を一時的に増やしますが、近隣のシステムが押し出されないよう、割り当ては安定したままにします。.
モニタリングとトラブルシューティング
私は、以下の方法で効果と副作用を確認しています。 透明性 メトリクスとして。ファイルは cpu.stat そして cpu.pressure (PSI) を cgroup ごとに実行すると、帯域制限や過負荷を示唆する使用率、待ち時間、輻輳の状況がわかります。 トップ, htop そして systemd-cgtop リアルタイムで負荷分布の傾向を把握し、自身のルールと照らし合わせます。レイテンシが上昇しているにもかかわらずCPUがアイドル状態にある場合、問題はCPUの制限ではなく、I/Oやロックにある可能性が高いです。そのため、その場合は急いで重み付けを調整することはありません。 変更後は、誤った相関関係を避けるため、少なくとも1つの負荷サイクルにわたって測定値を記録します。.
モニタリング・プレイブック:私が実際に読んでいるもの
cpu.stat: usage_usec, user_usec, system_usec 消費量を表示;; nr_periods, nr_throttled, throttled_usec 厳しい規制の実態を暴く。上昇する nr_throttled/nr_periods 数パーセント以上の場合、その割合が狭すぎるか、期間が短すぎる。.cpu.pressure: 私は観察している some avg10/60/300 レイテンシに影響を与える輻輳について。CPUに空きがあるにもかかわらずこの値が継続的に高い場合は、ロックの競合、アフィニティの競合、またはNUMA間のリモートアクセスを示唆しています。.systemd-cgtopそしてps: スレッドが実際に並行して動作できるのか、それとも排他リソースを待機しているのかを確認します。.
再現性のあるテストを行うために、私は stress-ng, sysbench あるいは独自の負荷発生器を導入し、変更の前後でメトリクスのスナップショットを記録します。測定値が安定して期待通りの値を示すようになってから初めて、変更を本格的に展開します。.
リアルタイムと特徴
時点では リアルタイム-ワークロードに関しては、v2ではRT用のCPUコントローラの制御が限定的であるため、カーネルドキュメントの注意事項に従っています。特定のRTスレッドはルートcgroupに配置する必要があり、設定には慎重な対応が求められます。 また、RTスケジューリングがクォータとどのように共存するかについても検証し、意図せずデッドラインが破綻しないようにしています。 一般的なWebサービスやデータベースサービスについては、日常運用においてより確実に計画が立てられるため、通常のポリシーを使用しています。RTが必要な場合は、予期せぬ相互作用が発生しないよう、システムを分離するか、コアを明確に予約しています[1]。.
マルチコアシステムにおける微細制御
CPUコントローラは分割する タイム・ウィンドウ, 、クロック周波数ではないため、必要に応じてcpusetやアフィニティと組み合わせています。 低ノイズかつ低レイテンシを実現するため、クロスソケット切り替えを制限し、スレッドをNUMAローカルなコアにバインドし、IRQの割り当てを最適化しています。バッチサービスについては、重要なフロントエンド用のコアをブロックすることなく、余剰容量を活用できるよう、より柔軟に実行させています。 周波数の変化は負荷時の挙動を大きく変える可能性があるため、ターボモードや省電力ポリシーの設定を確認します。クォータ、重み付け、CPUアフィニティ、および電力戦略の組み合わせによって初めて、一貫した結果が得られます。.
SMT、NUMA、およびアフィニティの実践
以下のシステムでは SMT/ハイパースレッディング ここで注意すべき点は、1つの物理コア上の2つの論理スレッドが、必ずしも2つの完全なCPUスロット分の処理能力を提供するわけではないということです。「100 %」という割り当ては、1つの論理スロットをカバーするものであり、必ずしも物理コアの全処理能力をカバーするわけではありません。 そのため、SMTを使用する場合と使用しない場合で、レイテンシとスループットを測定しています。NUMAシステムでは、重要なサービスに対して AllowedCPUs= (cpuset) または CPUAffinity= ローカルカーネルを利用し、メモリバインディングを適切に設定して、リモートアクセスによって綿密な計画が台無しにならないようにする。.
ホスティングとコンテナのベストプラクティス
まずは控えめに デフォルト: Webサービスにはやや高い重み付けを行い、データベースは標準に近い設定、バッチ処理にはクォータを設定します。テナントについては、顧客ごとに上限を設定し、他の需要がない限り、重み付けを通じてバースト処理を許可しています。 プロファイルはユースケース(「レイテンシが重要」、「混合」、「計算負荷が高い」など)ごとに文書化し、プロファイルごとにweightとcpu.maxの明確な範囲を定義します。変更内容はまずステージング環境に適用し、ピーク負荷を現実的に再現した合成負荷を用いてテストを行います。 診断が不透明にならないよう、ログとメトリクスはcgroupの境界に近づけて管理しています。.
コンテナのオーケストレーション:シェア、リクエスト、リミット
コンテナ環境では リクエスト 相対的な重み付けと 限界 厳しいクォータ設定。これにより、ノードに空き容量がある限りバースト処理が可能となり、競合状況下でも重み付けに基づいた公平な配分が確保されます。重要なポッドやサービスには、他のリソースの余裕を奪うことなく、若干高い重みが割り当てられます。 私は、ノードごとの制限値の合計が、利用可能なCPUリソースに見合った現実的な値になるよう注意を払っています。そうしないと、ルールが適切であっても、システム全体でのスロットリングが発生し、すべてのテナントに影響が及んでしまうからです。.
設定例と計算例
私はいつも比率を 株式 vCPUスロットあたり: cpu.max = クォータ期間 に相当する 割当/期間 スロット。例: 20000 100000 単一のCPUあたり0.2です。4つのCPUの場合、合計で最大0.8スロットになりますが、その配分が保証されるわけではありません。systemdでのパーセンテージ指定については、次のように記述します。 CPUQuota=20%, 。これはバージョンによっては cpu.max と調和します。厳格な制限を設定する場合は、バースト挙動とレイテンシを天秤にかける必要があります。周期が短すぎると微細なカクつきが発生し、長すぎると処理は滑らかになりますが、反応が遅くなります。 そのため、50~100 msの範囲の周期をテストし、サービスのレイテンシクラスに適合するバリエーションを選択しています[2]。.
v1からv2への移行をトラブルなく行う
乗り換えの際、私は CPUシェア に於いて CPU.weight そして cpu.cfs_quota_us/period_us に於いて cpu.max. シェアに関する実用的なマッピングとしては、次のようなものがある: 1024 → 約100, 2048 → 約200, 512 → 約50. スケールが異なるため、負荷テストの後に微調整を行います。また、子供向けのv2ルールを策定する予定です 累積 効果:親ノードに制限クォータを設定すると、すべてのサブグループがまとめて制限されます。そのため、私はよく親ノードのクォータを解除します(max) そして、副作用を避けるために、シート内できめ細かく調整しています。.
よくある不具合とその対処法
- 100 % が「すべてのコア」と混同されている: 100 % は、マシン全体ではなく、1つの論理CPUスロットに相当します。解決策:必要なスロット数に基づいて割り当てを算出してください(例:4スロットの場合は400 %)。.
- 生理の間隔が短すぎる場合: インタラクティブサービスで発生する微細なカクつき。解決策:周期を長くするか、クォータの代わりに重みを使用する。.
- 競合のない状態で測定した重み付け: 重量は、競合状況下で初めてその効果を発揮する。解決策:実際の並列負荷条件下でテストを実施する。.
- 「親の割当」は忘れて: 制限のある親要素がすべての子要素のパフォーマンスを低下させています。解決策:
cpu.max=max親要素には、子要素には制限がある。. - NUMA/ソケットを無視: CPUに空きがあるにもかかわらずレイテンシが発生している。解決策:アフィニティ/CPUセットとメモリの局所性を確認する。.
概要
を使用しています。 CPUコントローラ 私は計算リソースを的確に割り当て、公平な優先順位を設定し、必要に応じて厳格な制限を設けています。cgroup v2 には、cpu.weight や cpu.max といった明確なパラメータが用意されており、ワークロードに応じてこれらを計画・測定しています。 systemd を通じてサービスごとにルールを設定し、cpu.stat や PSI でその効果を確認しながら、当てずっぽうな調整をせずに微調整を行います。テナント、コンテナ、および混合サーバー環境において、この制御は信頼性と予測可能性を実現するための鍵となります。 ルールを文書化し、段階的に導入し、負荷テストで検証することで、ボトルネックを防ぎ、CPU時間を適切に管理し続けることができます。.