 コンテンツにスキップ

MariaDB の適応型フラッシングは、私が ダーティページ バッファプールからディスクへ書き込むことで、リドゥログがボトルネックになるのを防ぎます。MariaDBのAdaptive Flushingを最適化すると、レイテンシのピークが低下し、 チェックポイント- 進捗は安定しており、書き込み負荷も計画通りに管理できる。.
中心点
- 測定値 まず:リドゥログの残量、ダーティページの割合、チェックポイントの経過時間
- I/O容量 推定ではなく、正確に決定する
- しきい値 適切な設定:adaptive_flushing_lwm および Dirty-Page-LWM
- バックグラウンドI/O 設定値:io_capacity および io_capacity_max
- リドゥログ 均一な流れを確保するための適切なサイズ設定
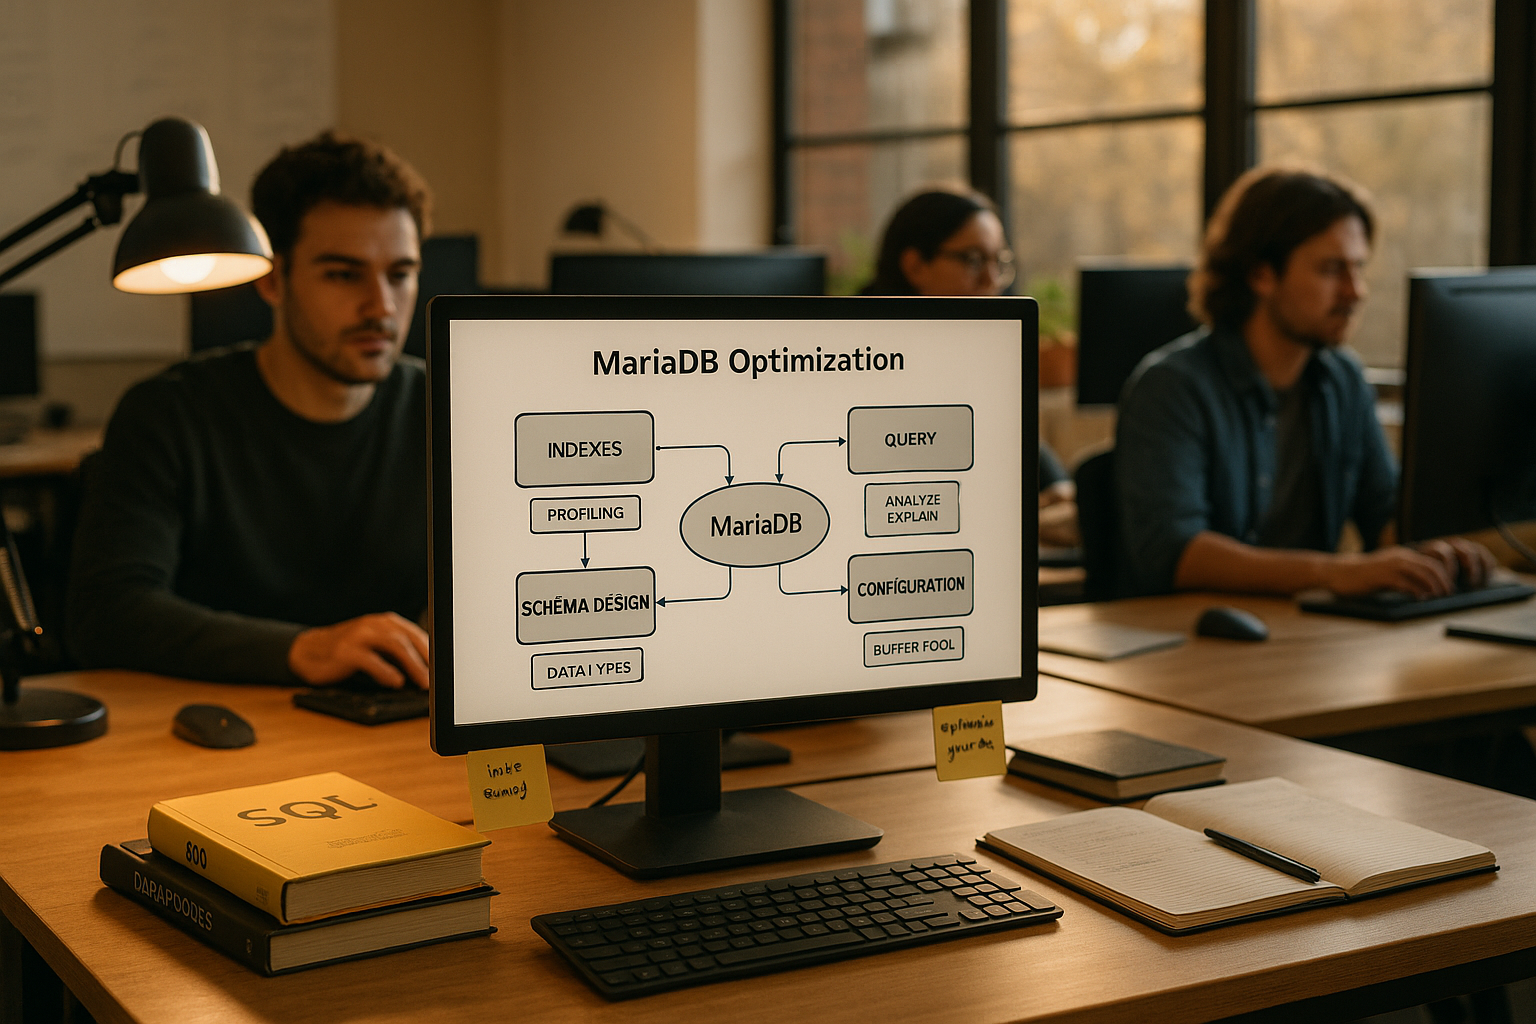
MariaDBにおけるアダプティブ・フラッシングの仕組み
以下の方法で動的ロジックを有効にします innodb_adaptive_flushing そして、早期警戒行動を次のように制御する innodb_adaptive_flushing_lwm. リドゥログの充填率が高く、その増加速度が速いほど、ボトルネックが発生しないよう、InnoDBはより積極的にフラッシュを行います。このルールにより、フラッシュレートが実際の変更スループットに連動するため、短時間のI/Oバーストが発生しにくくなります。 MariaDBのドキュメントによると、ディスクへの書き込み待ち時間を回避するため、フラッシュの頻度はチェックポイントの進行状況に合わせて調整されます。ただし、アダプティブ・フラッシングは処理を分散させるものの、メモリ性能の不足を補うものではないという点には留意しています。.
主要指標の理解:リドゥログ、ダーティページ、チェックポイント
まず、の%単位の充填率を観察します。 リドゥログ, 、バッファプール内のダーティページ率、そしてチェックポイントエイジです。これら3つの指標から、サーバーが適時にかつ均等にフラッシュできているか、それとも処理が滞っているかが分かります。 チェックポイント・エイジが急激に増加した場合、アダプティブ・フラッシングが反応しますが、その際はストレージのレイテンシも併せて確認します。I/O戦略に関する詳細な質問については、関連する フラッシュメソッド, 、これらはカーネルが書き込みコマンドをどれほど効率的に処理するかを決定するからです。私はこれらのシグナルを測定されたI/O処理能力と関連付けることで、閾値の変更を的確に行い、システム全体の一貫性を保っています。.
調整ネジを正しく調整する
私は次のように始める。 innodb_io_capacity そして、その値を蓄電池の理論上の最大値ではなく、実際の持続出力に近い値に設定する。ピーク出力については、私は innodb_io_capacity_max を大幅に高く設定し、負荷がかかった際にInnoDBがCPUをオーバーロードすることなく、一時的に処理能力を向上できるようにします。しきい値は innodb_adaptive_flushing_lwm Redoログが満杯になる前に、サーバーが確実にプリフラッシングを開始するように設定します。さらに、 innodb_max_dirty_pages_pct_lwm これにより、ダーティページの割合が増加しても、InnoDBが早期に対策を講じ、ボトルネックが発生しないようにします。1サイクルにつき1つのパラメータのみを変更し、その影響を綿密に記録した上で、さらなる最適化を行う前に、システムに複数の負荷フェーズを経る時間を与えます。.
I/O容量を具体的に測定する
私は、生産負荷下での連続書き込み性能を測定しています。というのも、合成ピークテストではしばしば誤った期待を抱かせてしまうことがあり、その 均一性 隠蔽してしまう。短期的な平滑化の影響を受けない中長期の平均値やパーセンタイルこそが、意味のある指標となる。私は、単に平均値だけを見るのではなく、書き込みIOPS、書き込みスループット、レイテンシ、および応答時間の分布を分析している。 最大値のみを基準にすると、過度なフラッシュ処理が発生するリスクがあり、一方で実際のトランザクション処理は遅くなってしまいます。私は以下の点について結論を導き出しています。 innodb_io_capacity 一時的な最高記録ではなく、観察された長期的なパフォーマンスに基づいて。.
初期値と限界値の概要
私は初期値を単なる出発点として利用し、決して絶対的な基準とはせず、実際のワークロードやバッファプールのサイズ、そして リドゥログ. SSDやNVMeシステムはHDDよりも明らかに高い数値を示しますが、私は読み取りアクセスがキューに滞留しない程度にのみレートを設定しています。 負荷の高いシステムでは、容量を徐々に増やしながら、レイテンシ、チェックポイントの経過時間、CPU使用率を総合的に監視します。ダーティページ率が均等に低下し、リドゥログの満杯度における変動が小さくなれば、十分な安全マージンを確保できたと判断します。 私にとって重要なのは、 ヒント 過剰なバックグラウンドI/Oで上書きするのではなく、これを制御する。.
| 可変 | 効果 | HDDの標準的な初期値 | SSDの一般的な初期値 | NVMeの一般的な初期値 | 注意していること |
|---|---|---|---|---|---|
| innodb_adaptive_flushing | 動的フラッシュを有効にする | オン | オン | オン | バーストの相殺 |
| innodb_adaptive_flushing_lwm | 早期プレフラッシング | 20–30% | 20-40% | 30–50% | リドゥログの残量 |
| innodb_io_capacity | 基本フラッシュ率 | 100-300 | 800–2000 | 2000–8000 | 持続的書き込みIOPS |
| innodb_io_capacity_max | 緊急限界 | 400–800 | 2000-6000 | 6000–20000 | 先端を削り取る |
| innodb_max_dirty_pages_pct_lwm | ダーティ・ページ・ロー・ウォーター | 5–10% | 5–15% | 5–15% | 早期の是正措置 |
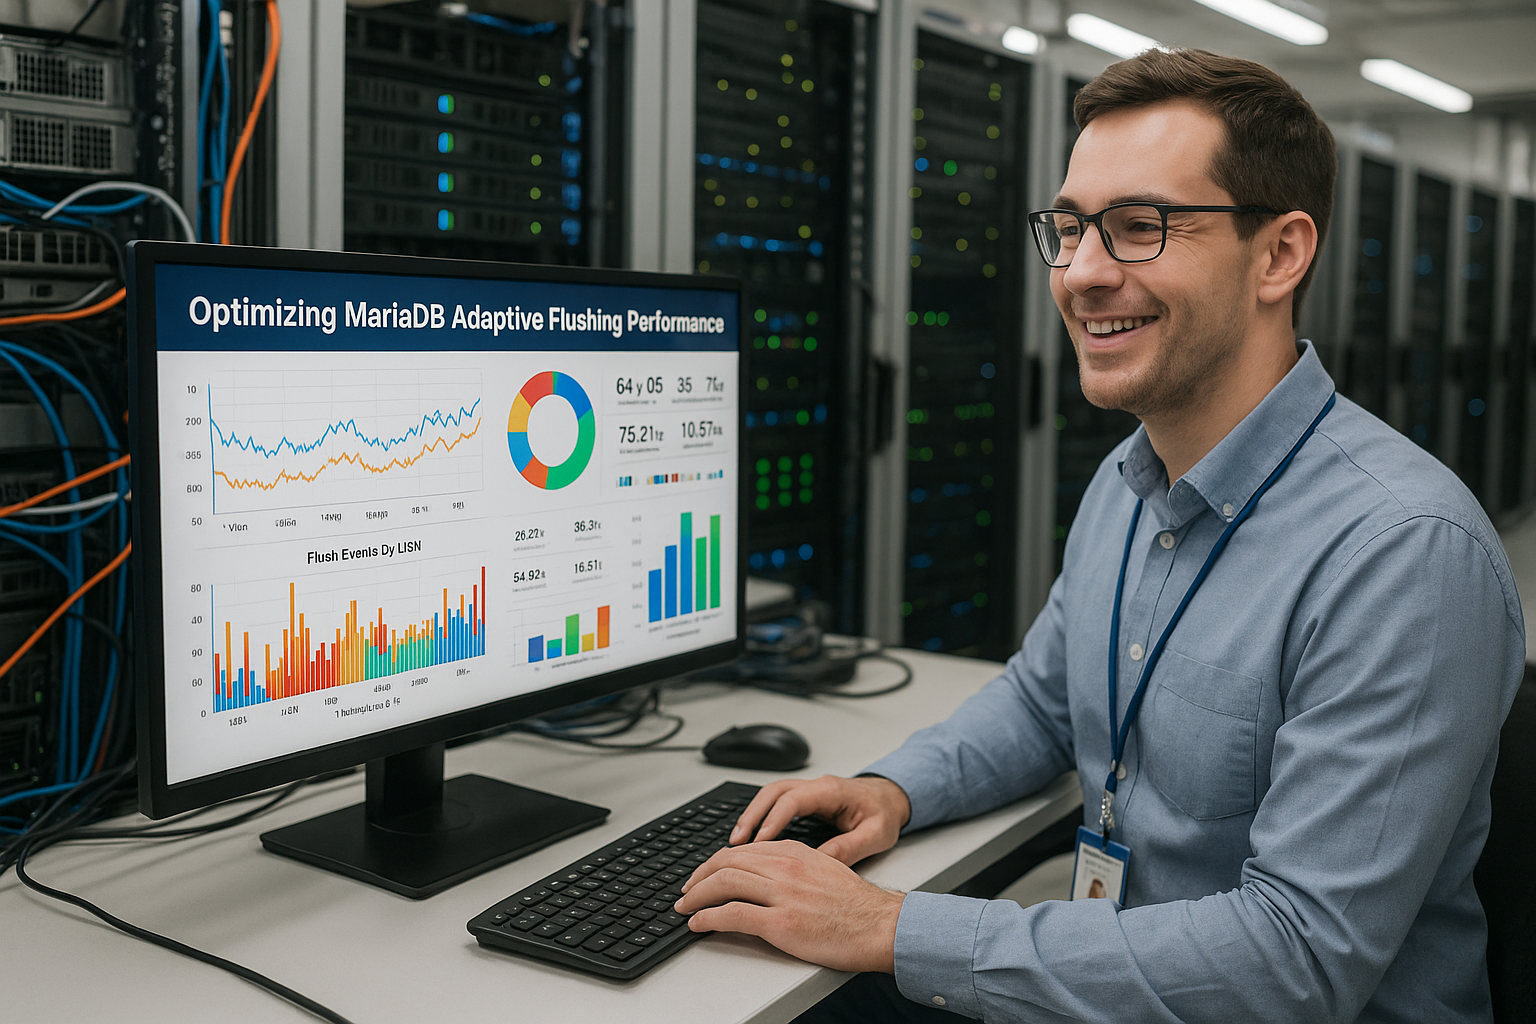
問題事例や症状を見極める
私が フラッシュ-のピークが見られた場合、まずI/O値を確認します。この値が低すぎると、ダーティページが蓄積され、システムは急いでクリーンアップを行わなければなりません。逆に値が高すぎると、バックグラウンドI/Oがライブワークロードを圧迫し、読み取り操作に待ち時間が生じます。 チェックポイント年齢が鈍化していたのに、突然急上昇した場合は、サーバーの反応が遅れていることを示しています。同時に、リドゥログの満杯率が急速に上昇している場合は、書き込み処理が追いついていないか、ログの容量が不足していることを示しています。 個々の数値だけではアダプティブフラッシングの挙動を完全に説明できることはめったにないため、私はこれらのパターンを総合的に読み解きます。.
負荷を均一にするためのリドゥ・ログのサイズ設定
私は~のサイズを選びます リドゥログ これにより、チェックポイントの長くなりすぎることなく、負荷のピークに対応できる十分な余裕を確保できます。 ログサイズを大きくすると、Adaptive Flushing が処理を分散させる余地が広がりますが、私はリカバリ時間とストレージの予算に注意を払っています。ログが毎秒のように上限に向かって増加している場合、控えめにサイズを増やすことで圧力を軽減し、フラッシュ曲線を平滑化できます。 ログの拡大によって負荷が軽減されない場合、問題はたいてい不適切なI/O容量やストレージのレイテンシの変動にあります。ログサイズをさらに引き上げるかどうかは、その瞬間の状況ではなく、一定期間の観測結果に基づいて判断します。.
Page Cleanerのスレッドと並行処理
ページクリーナースレッドの数を確認しています。これは、並列処理の フラッシュ-バッファプールインスタンスのパフォーマンスを制御する。書き込み負荷が高い場合、並列性を高めることでスループットが向上するが、ストレージキューを綿密に監視している。 キューの過負荷によりストレージの有効性が低下した場合は、スレッド数を減らすか、I/O容量を抑制します。このメカニズムの背景については、以下の概要が参考になります。 ページクリーナースレッド, 、プレッシャーと公平性のバランスを保つためです。私は実用的な観点から判断します。必要なだけスレッドを設け、一方で「リード」が後回しにならないよう、合理的な範囲で最小限に抑えるようにしています。.
ダブルライトバッファ:信頼性 vs. 書き込み速度
を考慮に入れている。 ダブルライト-バッファは、部分的な書き込みエラーを防ぐ役割を果たしますが、追加のI/Oコストが発生します。信頼性の高いNVMeシステムでは、この追加負荷の影響はさほど大きくありませんが、低速なストレージではより顕著に現れます。 この設定を調整する前に、レイテンシやページフラッシュレートへの実際の影響を測定しています。適切な判断を下すために、以下の詳細な情報も参考にしています。 ダブルライトバッファ そして、別のリスク・パフォーマンス・プロファイルが適しているかどうかを検討します。データの安全性とスループットは密接に関連しているため、私は決して軽率な決断はしません。.
実務におけるモニタリングと指標
私は、ダーティ・ページの割合、フラッシュ率と変更率の比率、および チェックポイント-Age を無効にします。さらに、リドゥログの使用率の経時変化も監視しています。これは、使用率が直線的に上昇すると、しきい値に近づいていることを示唆するからです。また、InnoDB の統計情報と併せて I/O レイテンシも注視し、原因と結果を明確に特定できるようにしています。 パラメータを変更するたびに、同一の負荷期間を比較するようにしています。そうしないと、誤った結論を導いてしまうからです。また、単一の測定値よりもグラフの方が多くの情報を伝えるため、トレンドの変化を確実に把握できるよう、グラフを記録しています。.
ステップバイステップのチューニング・プラン
まずは、以下の項目について現実的な測定から始めます。 書き込み率 そして、これに基づいてinnodb_io_capacityを設定します。その後、負荷が高い状況での一時的な対策として、基本値から十分な余裕を持たせてinnodb_io_capacity_maxを定義します。 次に、innodb_adaptive_flushing_lwm を確認し、チェックポイント・エイジの低下が遅すぎる場合はこの値を下げます。その後、プレフラッシングが適時に開始され、ピーク負荷が早期に解消されるよう、innodb_max_dirty_pages_pct_lwm を設定します。 最後に、redoログのサイズを調整し、再度複数の負荷サイクルを観察して、次のステップに進む前にすべての変更点を記録します。.
ボンネットの下に隠されたフラッシュ機構
私は、執筆の主な原動力を2つに分けます。それは、 フラッシュ・リスト・フラッシング (チェックポイントの進行状況に後押しされて)と、 LRUフラッシング (フリーリストの不足が原因)。バッファプールが満杯になり、空きページが不足すると、LRUフラッシングによって即時の書き込みが強制され、レイテンシの急上昇を引き起こします。アダプティブフラッシングは、フラッシュリストの継続的なフラッシュを通じて、こうした窮地を回避することを目的としています。 これを成功させるために、空きページの割合を安定させ、LRUスキャン深度やバッファプールインスタンスごとの使用率といった値を監視しています。フラッシュリストの処理が均一であればあるほど、フォアグラウンドで空きページを待つ必要が少なくなります。.
その際、私は以下の関係に留意しています。 innodb_buffer_pool_instances, innodb_page_cleaners および物理的なI/O容量。インスタンス数やクリーンアップスレッドを増やすことで並列性は向上しますが、ストレージのキューが溢れない範囲内でのみ意味があります。 フラッシュ操作のキュー長が長くなってしまった場合、それはもっと早く、かつ低速でフラッシュを行うべきだったという兆候であり、まさにこの問題を、innodb_adaptive_flushing_lwm および基本/最大容量の設定によって対処しています。.
トランザクションのコミット、リドゥ、およびバイナリログの関連性
フラッシュ平滑化の文脈において、コミットパスと有効期限保証について考察する。. innodb_flush_log_at_trx_commit また、Binlogの同期は、システムがfsyncを実行する頻度や、短期的なピークの発生度合いに影響を与えます。私の指針は以下の通りです:
- 1: 最大の耐久性(コミットごとにディスクへの再書き込みを行う)。安全だが、fsyncの処理負荷が高く、動作が不安定になる可能性がある。.
- 2: Redoは1秒ごとにフラッシュされ、CommitはOSキャッシュにのみ書き込みを行います。ピーク負荷は低くなりますが、その代わりにOSやホストの障害時にデータが失われるリスクがあります。.
- 0: 2と同様ですが、キャッシュの割り当てがさらに積極的です。本番環境では慎重に利用してください。.
Binlogの同期と併せて(sync_binlog)やグループコミットの効果を活用することで、コミットをまとめ、ハード同期の回数を減らすことができます。 重要なのは、これらの手段を、適切なアダプティブ・フラッシングのチューニングの代わりとして誤用しないことです。私は常にリスク、コンプライアンス要件、および望ましいレイテンシプロファイルを総合的に評価し、ビジネスルールが許容する範囲内でのみ調整を行います。.
スレッドの削除、履歴の長さ、および長期実行スレッド
私はその InnoDBのパージ 注目点:削除または更新された行が多くなると、非同期でクリーンアップされる「元に戻す」データが生成されます。もし 履歴の長さ 強力になると、バックグラウンドでの処理負荷が増加し、ページクリーナーとI/Oを奪い合うことになる。これにより、アダプティブ・フラッシングの間接的なパフォーマンス低下を招く可能性がある。対策としては、パージの並列処理に適切な値を設定すること、および履歴を人為的に開いたままにしてしまう長期実行トランザクションを避けることが挙げられる。 また、バッチ処理を計画する際には、短時間で数百万行をまとめて変更するのではなく、リドゥおよびアンドゥの発生量を制御するようにしています。.
変更バッファとマージフェーズ
を考慮に入れている。 バッファーの変更 セカンダリインデックスの大規模な更新時。これは実行時のランダムI/Oを削減しますが、処理の一部を後のマージフェーズに先送りします。これらのマージは、運用上のピーク時間帯と不都合に重なると、追加のフラッシュ負荷を引き起こす可能性があります。 そのため、私はチェンジバッファのサイズとアクティビティを監視し、必要に応じて制限を設け、マージフェーズがピーク時間帯と重ならないよう、一括変更を分散させています。これにより、フラッシュレートをより計画的に、かつ安定した状態に保つことができます。.
フラッシュメソッドとファイルシステムの影響
私は意識的に~について決定します フラッシュ法 およびファイルシステムのオプション。O_DIRECTはキャッシュの重複を回避し、それによって書き込みレイテンシを低減することが多い一方、AIOやFsyncパスにはそれぞれ独自の特性があります。 私は、これらの方法がレイテンシの分布やチェックポイントの進行状況の安定性にどのような影響を与えるかを測定し、詳細な質問については以下の参考情報を参照しています。 フラッシュメソッド. さらに、ファイルシステムのマウントオプションやメンテナンス手順(例:SSDにおける一貫性のあるTRIM/Discard戦略など)も確認し、基盤部分が気づかれないうちにジッターを引き起こすことがないよう注意を払っています。.
診断:ステータス出力を正しく読み取る
私は引っ越します INNODB エンジンのステータスを表示 チェックポイントの経過時間とフラッシュの進捗状況を評価するために使用します。出典: ログシーケンス番号, ログは以下までフラッシュされました そして 最後のチェックポイントは 生成された変更と永続化された変更の間の差がどれほど大きいかを調査します。その差が、リドゥログの許容サイズを超えるペースで継続的に拡大している場合、バックグラウンドフラッシュが不十分であるか、I/Oレイテンシが高すぎることを意味します。 これらの値を、InnoDBの「ダーティページ」「フラッシュレート」「ページクリーナーのアクティビティ」といったメトリクスと比較することで、単なる症状の対処ではなく、的確に適切な調整を行うことができます。.
運用シナリオ:バルク処理、DDL、メンテナンスウィンドウ
私は次のことを計画している。 一括読み込み そして、広範な DDL- 適応型フラッシングが上書きされないように操作を行います。予定可能なメンテナンス期間中は、一時的に innodb_io_capacity_max, 、保留中の書き込みを制御しながら処理し、その後、通常レベルに戻します。大規模なインポートの際は、リドゥの増加とチェックポイントの進行が同調するように、コミット頻度を調整します。 その間、リドゥログの充填率、ダーティページ率、レイテンシのパーセンタイルを継続的に監視し、異常が見られた場合は直ちに是正措置を講じられるようにしています。.
よくある誤解とアンチパターン
私はその罠にははまらない、, innodb_io_capacity_max 恒常的な状態として利用すべきではありません。最大値が高すぎると、メモリキューが溢れ、リアルタイムの読み取りアクセスが遅延する可能性があります。同様に、巨大なリドゥログの背後に性能の低いメモリを「隠す」ようなこともしません。ログを大きくしても負荷は平滑化されますが、I/Oの予備容量を生み出すわけではありません。 また、レイテンシのピークを当然のこととして受け入れることはありません。多くの場合、これらはプリフラッシングの遅れや、バックグラウンド負荷の激しい変動に起因するものであり、LWMのしきい値を下げたり、現実的な容量値を設定したりすることで緩和できます。 最後に、複数の調整パラメータを同時に変更することは避けています。そうしないと因果関係が不明確になり、改善効果を再現できなくなってしまうからです。.
簡単にまとめると
私はこうしている。 適応型 フラッシングを行うことで、書き込み処理を時間軸上で均等に分散させ、レイテンシのピークを回避します。最も効果的な対策は、innodb_io_capacity を適切に設定し、innodb_io_capacity_max とのバランスを適切に保つことです。 リドゥログの残量やダーティページ率に対して早期に発動するしきい値を設定することで、キューを小さく抑えることができます。適切なリドゥログ、ページクリーナースレッドの合理的な並列処理、そして注意深い監視により、より信頼性の高い書き込みルーチンを実現できます。 MariaDBのシステム変数およびページフラッシングに関するドキュメントによると、これらの調整パラメータは相互に作用します。私は、システムが安定して予測可能な動作をするようになるまで、段階的に調整を行い、その効果を注視しています。.


