
Pokażę ci, jak skutecznie analizować dane z vmstat w systemie Linux: w ciągu kilku sekund rozpoznasz wąskie gardła procesora, obciążenie pamięci, wykorzystanie przestrzeni wymiany oraz czasy oczekiwania na operacje we/wy. W ten sposób bezbłędnie zinterpretujesz kolumny r, b, free, si/so, bi/bo oraz us/sy/id/wa/st i na podstawie wykrytych wzorców wyznaczysz konkretne działania – bez zgadywania, z czysty Zasady.
Punkty centralne
- Kolejka zadań vs. blokady: litera „r” wskazuje obciążenie procesora, a litera „b” ostrzega o opóźnieniach we/wy.
- Pamięć Ocena rzeczywista: sama bezpłatność nie ma znaczenia, decyduje si/so.
- I/O W skrócie: bi/bo nie budzą zastrzeżeń, o ile wa pozostaje na niskim poziomie.
- Udziały w rynku procesorów odczyt: us+sy wysokie, id niskie → wysokie obciążenie.
- Wartości bazowe wykonaj: porównaj wartości w życiu codziennym z okresami trudności.
Co tak naprawdę pokazuje vmstat?
Vmstat łączy informacje o stanach procesów, pamięci, obszarze wymiany, operacjach wejścia/wyjścia blokowego oraz obciążeniu procesora w jednym zwięzłym wyniku, który w ciągu kilku sekund pozwala uzyskać dotyczące całego systemu Daje to pewien obraz sytuacji. Najpierw sprawdzam „procs“ dla r/b, potem „memory/swap“ dla free, buff, cache oraz si/so. Następnie sprawdzam „io“ z bi/bo i na koniec „cpu“ dla us, sy, id, wa oraz opcjonalnie st. Ta kolejność pomaga mi rozróżnić przyczyny i skutki: wysokie wartości r oznaczają obciążenie obliczeniowe, wysokie wartości b wskazują na czasy oczekiwania na operacje wejścia/wyjścia, a wa łączy bezczynność procesora z opóźnieniami wejścia/wyjścia. W ten sposób rozpoznaję, czy hamulcem jest obciążenie obliczeniowe, niedobór pamięci czy nośnik danych – i oszczędzam sobie Objazdy.
Rozpoczęcie za 60 sekund: wywołania i interwały
Aby uzyskać migawkę stanu systemu od momentu uruchomienia, uruchamiam polecenie „vmstat“ bez parametrów; do bieżącej analizy używam polecenia „vmstat 1“ lub „vmstat 5 12“, które generuje dwanaście odczytów co pięć sekund, i otrzymuję czasowe Wiersz. Ważne: pierwszy wiersz odzwierciedla wartości średnie od momentu uruchomienia systemu, dlatego analizuję przede wszystkim kolejne wiersze. Za pomocą opcji Delay/Count steruję częstotliwością próbkowania i czasem trwania, na przykład „vmstat 1 30“ w przypadku krótkich skoków. W przypadku niestabilnych obciążeń ustawiam 1–2 sekundy, a w spokojnych scenariuszach raczej 5 sekund. Obserwuję trendy, a nie pojedyncze klatki, ponieważ to właśnie wzorce odzwierciedlają rzeczywiste Przyczyny pokaz.
Odczytywanie procesów: r i b w życiu codziennym
Kolumna „r” pokazuje wątki gotowe do wykonania, które czekają na czas procesora, a kolumna „b” zlicza wątki zablokowane, często oczekujące na operacje wejścia/wyjścia. Jeśli wartość „r” znacznie przewyższa liczbę fizycznych rdzeni, nasuwa się wniosek, że Ograniczenie wydajności procesora ; na czterech rdzeniach wartość r=8 utrzymująca się przez dłuższy czas jest traktowana jako wyraźny sygnał. Wartość b większa od 0 utrzymująca się przez dłuższy czas wskazuje na powolne nośniki danych, przeciążone bazy danych lub powolne ścieżki sieciowe lub pamięci masowej. Koreluję r z us+sy i id: jeśli id jest niskie, a r wysokie, procesor ma trudności; jeśli wa jest wysokie, a b wysokie, spowalnia to operacje wejścia/wyjścia. W ten sposób decyduję, czy skalować moc obliczeniową, zoptymalizować zapytania, czy też System pamięci masowej sprawdzić.
Interpretacja pamięci: free, buff, cache, swpd
Niska wartość parametru „free” jest normalna w systemie Linux, ponieważ jądro intensywnie wykorzystuje pamięć RAM jako pamięć podręczną, co przyspiesza dostęp do plików i zapewnia rzeczywisty Przepustowość Dlatego zwracam większą uwagę na swpd oraz strumienie wymiany si/so niż wyłącznie na wartość free. Wysoki poziom pamięci podręcznej jest dobry, o ile si/so prawie zawsze pozostaje na poziomie 0; dopiero długotrwała aktywność wymiany wskazuje na rzeczywistą presję. Jeśli dodatkowo pojawia się opóźnienie lub nawet błąd OOM, podejmuję działania: zwiększam pamięć RAM, w odpowiednim czasie ograniczam procesy lub dostosowuję rozmiary pamięci podręcznej i JVM. Ważny pozostaje kontekst: obciążenie, rozmiar pamięci i układ NUMA określają, co w Twoim środowisku jest zdrowy ma zastosowanie.
Aktywność swapowa: klasyfikacja w obu przypadkach
Kolumny „si/so” mierzą stały przepływ danych między pamięcią RAM a partycją swap w KB/s i pokazują rzeczywiste obciążenie pamięci, a nie tylko to odczuwalne Niedobór. Krótkie skoki wartości są normalne, na przykład podczas przenoszenia rzadko używanych stron. Sytuacja staje się krytyczna, gdy wartości te utrzymują się na stałym poziomie powyżej 0; spowalnia to działanie systemu, ponieważ każde przeniesienie danych do pamięci zewnętrznej generuje dodatkowe obciążenie operacji wejścia/wyjścia. Wysokie wartości so wskazują na aktywne przenoszenie danych do pamięci zewnętrznej, a czasy odpowiedzi boleśnie się wydłużają. W tym momencie zajmuję się eliminowaniem przyczyn: ograniczam zapotrzebowanie na pamięć, rozbudowuję pamięć RAM lub optymalizuję usługi wymagające dużej ilości pamięci. melodia.
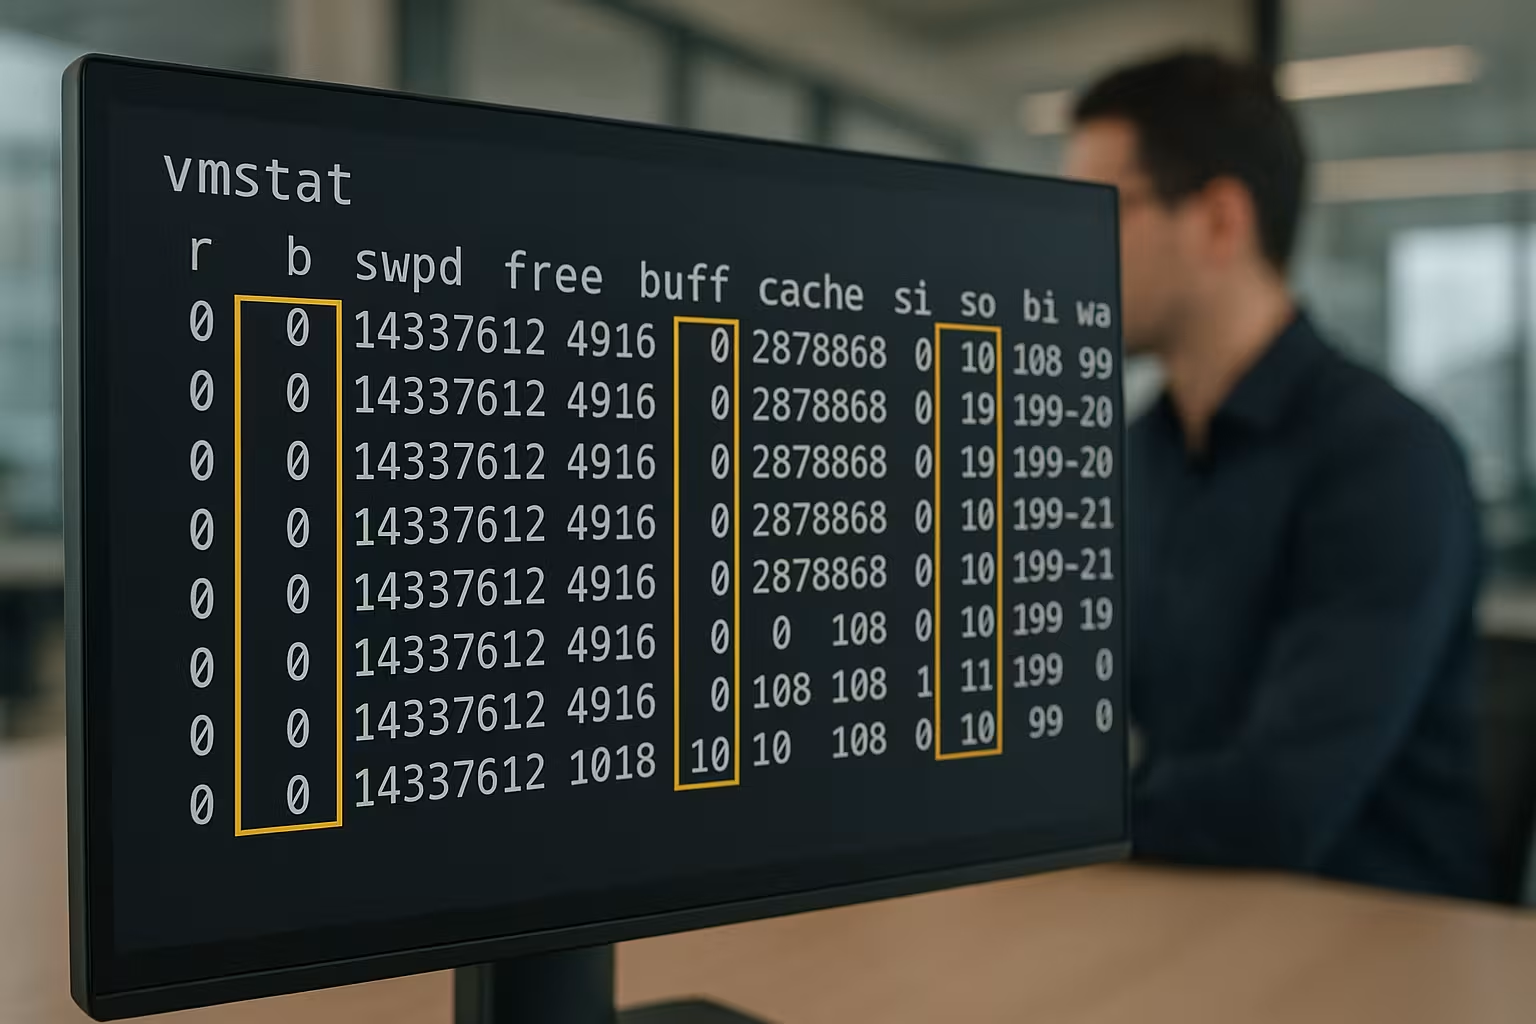
Zrozumieć blokowe wejście/wyjście: bi i bo
Dzięki bi/bo rozpoznaję szybkość czytania i pisania w blokach na sekundę, ale bez kontekstu nie oceniam jej zbyt wysoko; decydujące znaczenie ma współdziałanie z wa. Wysokie wartości bi/bo przy jednoczesnym wysokim wskaźniku wa wskazują, że pamięć masowa nie nadąża. Jeśli wysokie wartości bi występują w połączeniu z bazą danych, przed wymianą sprzętu sprawdzam profile zapytań i trafienia w pamięci podręcznej. Aby uzyskać bardziej szczegółowe dane dotyczące czasów, korzystam z narzędzia iostat i analizuję długość kolejek oraz opóźnienia, dzięki czemu mogę Analiza czasu oczekiwania na operacje wejścia/wyjścia i może skutecznie eliminować wąskie gardła. Dopiero gdy wa pozostanie na niskim poziomie, a bi/bo trwale gwałtownie wzrośnie, zacznę rozważać Skalowanie systemu pamięci masowej.
Udziały procesora: us, sy, id, wa, st
Wysokie wartości us przy niskiej wartości wa świadczą o wydajnej pracy użytecznej, podczas gdy wysokie wartości sy wskazują na duże obciążenie jądra, na przykład niezliczone drobne operacje wejścia/wyjścia lub wiele Zmiana kontekstu. Jeśli id jest bliskie 0 i utrzymuje się na tym poziomie, procesor pracuje na granicy swoich możliwości; w połączeniu z wysoką wartością r wskazuje to na duże obciążenie obliczeniowe. Jeśli wa rośnie, procesor czeka na operacje we/wy – w tym przypadku precyzyjne dostrojenie pamięci masowej często przynosi większe korzyści niż modernizacja procesorów. W maszynach wirtualnych zwracam uwagę na st (steal): wysokie wartości st wskazują, że hiperwizor przejmuje czas procesora, co skłania mnie do rozmowy z operatorem na temat obciążenia hosta. Zawsze oceniam us+sy jako sumę, ponieważ odzwierciedla to aktywne Praca w systemie.
Skrócony przewodnik: kolumny i wartości orientacyjne
Poniższa tabela służy mi jako zwięzła pomoc pamięciowa, gdy analizuję wyniki polecenia vmstat w celu wstępnej Ocena czytanie na skoczki.
| Kolumna | Znaczenie | Na co zwracam uwagę |
|---|---|---|
| r | Wątki gotowe do publikacji | Trwałe > Rdzenie → Obciążenie procesora |
| b | Zablokowane wątki | Stała > 0 + wa w górę → problem z wejściem/wyjściem |
| darmowy | Wolna pamięć RAM | Niski poziom jest w porządku, o ile si/so pozostaje ≈ 0 |
| bufor/pamięć podręczna | Bufor FS/pamięć podręczna stron | Duża pamięć podręczna to dobrze; można to opublikować stać się |
| si/so | Wymiana (w/z) | Stałe > 0 → rzeczywiste ciśnienie w zbiorniku |
| bi/bo | We/Wy blokowe | Krytyczne tylko wtedy, gdy wa jest jednocześnie wysokie |
| us/sy | Użytkownik/Jądro | us+sy stale > 80% → wysokie Obciążenie |
| id | biegu jałowym | Wartość bliska 0 w czasie → procesor przeciążony |
| wa | Oczekiwanie na operacje wejścia/wyjścia | Wysoki z b wysokim → Przyczyną jest pamięć masowa |
| st | Kradzież (maszyny wirtualne) | Wysoki → Hypervisor przyjmuje CPU-czas |
Linie bazowe i obserwacja ciągła
Nie opieram się na pojedynczych danych, lecz porównuję te wartości z wartościami odniesienia z spokojniejszych okresów, aby dokładnie wyeliminować wartości odstające uznanie. Polecenie „vmstat 1 60“ wyświetla mi profil obciążenia z ostatniej minuty, który porównuję ze znanymi stanami normalnymi. Aby uzyskać obraz historyczny, korzystam z Monitorowanie sar/sysstat, aby ocenić trendy w ujęciu dziennym i doprecyzować wartości graniczne. Powiadamania ustawiam ostrożnie: r względem rdzeni, si/so różne od 0 w kilku przedziałach, wa wyraźnie podwyższone. W ten sposób reaguję wcześnie, zanim użytkownicy zgłoszą opóźnienia i zanim Szczyt-fazy nasilają się.
Vmstat w połączeniu z innymi narzędziami
Zaczynam od vmstat, na podstawie wykresów podejmuję decyzję, a następnie szczegółowo analizuję dane za pomocą iostat, mpstat, pidstat lub metryk aplikacji, aby ustalić przyczyny czysty przypisuję. vmstat pokazuje czasy oczekiwania na operacje wejścia/wyjścia, natomiast za pomocą iostat mierzę opóźnienia i długości kolejek dla poszczególnych urządzeń. Jeśli r wskazuje na ograniczenie jądra, mpstat ujawnia asymetrie jądra. W przypadku szczytowego obciążenia procesów zapewnia Analiza procesów pidstat najbardziej burzliwe wątki na ten temat. Dopiero korelacja z logami i czasami działania aplikacji pozwala mi uzyskać pełniejszy obraz sytuacji i doprowadza mnie do prawdziwej Przyczyna.
Rozpoznawanie wzorców i podejmowanie działań
Jeśli widzę, że r jest wysokie, id niskie, a wa umiarkowane, aplikacja często optymalizuje się w sposób zbyt obciążający procesor, dlatego przed rozpoczęciem sprawdzam kod lub równoległość oraz planuję zasoby procesora, zanim Sprzęt wymagam. Jeśli wartości b, wa oraz bi/bo występują jednocześnie, rozważam dostosowanie pamięci masowej, optymalizację zapytań i buforowanie. Przy niskiej wartości free z si/so większym od 0 zmniejszam zużycie pamięci, przesyłam wyniki strumieniowo lub zwiększam pamięć RAM. Jeśli wartości us są umiarkowane, a sy bardzo wysokie, sprawdzam filtry pakietów, opcje systemu plików lub sterowniki. Dzięki tej liście kontrolnej działam sprawnie i poświęcam czas tam, gdzie jest to najbardziej liczy.
Jak uniknąć błędów pomiarowych: próbkowanie, jednostki miary, pierwszy wiersz
Celowo nie uwzględniam pierwszego wiersza przy analizie nagłych zakłóceń, ponieważ od momentu uruchomienia systemu dane z tego wiersza są uśredniane, co całkowicie wygładza skoki wartości. Ponadto dostosowuję częstotliwość próbkowania do hipotezy dotyczącej przyczyny: szczyty obciążenia procesora rejestruję w odstępach 1-sekundowych, a powolne wycieki pamięci – w odstępach 5–10 sekund. Zwracam uwagę na jednostki: si/so to KB/s, bi/bo to „bloki/s“ (historycznie 1 KB na blok, wartość zmienna w zależności od wersji vmstat). Sprawdzam, czy polecenie „vmstat -w“ (szeroki wydruk) pozwala uniknąć ucięć kolumn oraz czy zmiany częstotliwości taktowania (stany P, Turbo) wpływają na krótkotrwałą percepcję obciążenia. Synchronizuję pomiary ze szczytami obciążenia aplikacji, zamiast ślepo analizować „całe minuty“.
Rozszyfrowanie sekcji systemowej: in i cs
Oprócz parametrów procs/memory/swap/io/cpu, vmstat wyświetla również „system“: w (przerwa/s) oraz cs (zmiany kontekstu na sekundę). Te dwie wartości dostarczają mi wielu informacji na temat obciążenia jądra.
- cs bardzo wysokie przy umiarkowanym obciążeniu: flutter wątków, zbyt małe partie zadań roboczych lub konflikty blokad. Zwiększam rozmiary partii, reguluję równoległość (pule wątków) i sprawdzam wrażliwe punkty harmonogramu/mutexów.
- gwałtowny wzrost: burze przerwań sieciowych lub związanych z pamięcią masową, efekty NAPI/pollingu lub przerwania timera. Porównuję te dane z udziałem sy i wynikami iostat, aby sprawdzić sterowniki lub ścieżki sieciowe.
- cs proporcjonalne do r: Wskazuje to na ciągłą presję związaną ze zmianą kontekstu spowodowaną nadmierną równoległością. Ograniczam aktywną równoległość lub przypisuję wątki typu „hot-thread” do rdzeni.
Zawsze koreluję wskaźniki in/cs z sy oraz b/wa: dopiero w połączeniu można uzyskać jasny obraz tego, czy praca jądra ma sens (np. przepustowość), czy też stanowi czysty obciążenie systemowe.
Przydatne warianty i opcje polecenia vmstat
Korzystam z vmstat w elastyczny sposób, aby uzyskać dodatkowe perspektywy bez konieczności zmiany narzędzia:
- vmstat -s: Liczniki sumaryczne (np. procesy uruchomione od momentu rozruchu systemu, poważne i drobne błędy stron). Idealne do porównywania wycieków lub liczby przypadków w określonych przedziałach czasowych.
- vmstat -m: Wykorzystanie slabu – pomaga zaklasyfikować pamięć podręczną jądra (Dentry/Inode, sieć) jako element zużywający pamięć RAM.
- vmstat -d: Zdarzenia dyskowe na poziomie sumarycznym. Nie zastępuje programu iostat, ale nadaje się do szybkiej weryfikacji rzeczywistej sytuacji.
- vmstat -S M: Zmiana jednostek (M/K), aby ułatwić odczytanie liczb.
- vmstat -w: Szersze kolumny zapobiegają obcinaniu długich kolumn liczb.
Łączę te opcje w krótkich odstępach czasu, aby nie przegapić żadnych wydarzeń, a jednocześnie zachować orientację.
Kontenery, maszyny wirtualne i grupy C: cechy szczególne
W kontenerach interpretuję vmstat z ostrożnością: wiele danych jądra dotyczy całego hosta, a limity pochodzą z Cgroups. Wysokie wartości r w kontenerze odzwierciedlają perspektywę przestrzeni nazw, ale rzeczywisty czas procesora może być ograniczony przez kwoty procesora (CPU-quota) lub udziały procesora (CPU-shares). Opieram się na st (Steal) w maszynach wirtualnych: Wysoki wskaźnik st oznacza, że hiperwizor zabiera mi czas – w takiej sytuacji nawet idealna optymalizacja aplikacji niewiele pomaga, dopóki host jest przeciążony. W przypadku limitów pamięci w grupach Cgroup może to nie nastąpić, mimo że kontener „miota się“ przy limicie (zabijanie procesów z powodu braku pamięci (OOM) zamiast swapowania). Dlatego dodatkowo sprawdzam logi OOM i statystyki grup Cgroup oraz porównuję obrazki vmstat z limitami.
NUMA i powinowactwo: kiedy lokalizacja ma znaczenie
Na hostach NUMA sprawdzam wartości r oraz us/sy na rdzeń (za pomocą mpstat) i obserwuję, czy poszczególne gniazda „przegrzewają się“, podczas gdy inne pozostają w stanie bezczynności. Niewłaściwa lokalizacja pamięci prowadzi do wzrostu wartości cs/sy oraz b/wa spowodowanego odległymi dostępami do pamięci. Testuję powinowactwo procesora i pamięci (cpuset, numactl), konfiguruję duże sterty jako „interleaved“ lub ściśle lokalne i dbam o to, by gorące wątki działały tam, gdzie znajduje się ich ślad danych. Stabilny układ NUMA wyrównuje cs, redukuje wartości odstające wa i zwiększa Możliwość planowania pod obciążeniem.
Jak uniknąć błędnych interpretacji: wa i b to coś więcej niż „wolne nośniki danych“
Wartość wa rośnie nie tylko w przypadku klasycznych opóźnień dyskowych: również sieci NFS/o wysokich opóźnieniach, nasycona pamięć obiektowa, blokujące woluminy w chmurze lub powolne operacje zapisu do pamięci podręcznej stron powodują wzrost wartości wa. Wskaźnik b zlicza zadania znajdujące się w stanie nieprzerwanego uśpienia (stan D) – obejmuje to również zawieszenia w sterownikach, ścieżkach sieciowych lub blokadach systemu plików. Dlatego nigdy nie oceniam wskaźnika wa/b w oderwaniu, lecz zawsze w połączeniu ze wskaźnikami bi/bo oraz czasami działania aplikacji. Jeśli wartość wa jest wysoka, a bi/bo niskie, często oznacza to Zależność od czasu oczekiwania poza samą kwestią przepustowości urządzeń (np. blokowanie, zdalne wejścia/wyjścia, zatory w trybie writeback).
Tuning z wyczuciem: Swappiness, Writeback, Scheduler
Zmieniam ustawienia Kernel-Tuner dopiero po przeprowadzeniu pomiarów i mając gotowy plan przywrócenia poprzednich ustawień:
- vm.swappiness: Niższa wartość ogranicza proaktywne przełączanie pamięci, co jest korzystne dla aplikacji, w których opóźnienia mają kluczowe znaczenie – zbyt niska wartość może zwiększyć obciążenie pamięci podręcznej stron.
- vm.dirty_background_ratio / vm.dirty_ratio (lub *_bytes): Wpływają na momenty zapisu zwrotnego. Zbyt wysokie wartości powodują długie serie zapisów (szczyty wa), zbyt niskie wartości zwiększają liczbę ciągłych niewielkich operacji flush (wzrost sy/bo).
- Harmonogram wejścia/wyjścia / Głębokość kolejki: W przypadku NVMe inne ustawienia Optima niż w przypadku HDD/RAID. Przed wprowadzeniem zmian mierzę kompromisy między opóźnieniem a przepustowością za pomocą programu iostat.
- Ścieżki sieciowe: Wiele małych pakietów/przerw trafia do /cs/sy. Ogólnymi parametrami dostrajającymi są GRO/LRO, RPS/RFS oraz IRQ-Affinity – dokonuję pomiarów przed i po.
Moim celem są stabilne, przewidywalne wykresy w vmstat: us/sy na stałym poziomie, wa/b na niższym poziomie, a si/so bliskie 0. Dopiero wtedy rozbudowuję sprzęt.
Podręcznik: 3-minutowa analiza za pomocą vmstat
- 0:00–0:30 – „vmstat 1 30“: Zignoruj pierwszy wiersz, a następnie sprawdź wartości r/b, us/sy/id/wa. Pytanie: limit procesora (r wysoki, id niski) czy limit operacji wejścia/wyjścia (b/wa wysokie)?
- 0:30–1:00 – Widok zbiornika: sprawdzić swpd oraz si/so. Czy si/so utrzymuje się powyżej 0? → rzeczywiste ciśnienie w zbiorniku. free ma znaczenie drugorzędne.
- 1:00–1:30 – Kontekst wejścia/wyjścia: bi/bo a wa. Wysokie wartości bi/bo bez wa? → Wejście/wyjście jest odłączane. Wysokie wartości wa przy umiarkowanych wartościach bi/bo? → Opóźnienie/blokada/zdalne wejście/wyjście.
- 1:30–2:00 – sekcja systemowa: stosunek in/cs do sy. cs bardzo wysoki? → Sprawdzić presję zmiany kontekstu, równoległość/blokowanie.
- 2:00–3:00 – Sformułowanie hipotezy i wybór odpowiedniego narzędzia: iostat w przypadku wskaźnika I/O, mpstat w przypadku asymetrii jądra, pidstat w przypadku wąskich gardeł procesów. Dopiero potem można przejść do optymalizacji/skalowania.
Rozszerzone wzory z praktyki
- Wykorzystanie procesora bez wysokiego r: us+sy przy 90%+, id ≈ 0, ale r na umiarkowanym poziomie → wąskie gardło w trybie jednowątkowym lub problem z afinnością. Rozwiązanie: zrównoleglić ścieżkę krytyczną, sprawdzić przypisanie rdzeni.
- Swap-Thrash: w obu przypadkach wartość jest wyraźnie > 0, b/wa rosną, a us spada → pamięć RAM jest zdecydowanie za mała lub rozmiar sterty jest nieprawidłowo dobrany. Działania: zwiększyć pamięć RAM, zmniejszyć zestaw roboczy, dostosować współczynnik swappiness.
- Obciążenie jądra: sy wysokie, cs/in wysokie, us umiarkowane → wiele małych wywołań systemowych/operacji wejścia/wyjścia. Rozwiązanie: przetwarzanie wsadowe, ograniczenie liczby wywołań systemowych, sprawdzenie opcji montowania systemu plików.
- Zator w procesie odpisów: wysokie wartości wa i bo, krótkie fale → zbyt wysokie wartości parametryczne „dirty”, zmienne opóźnienia pamięci masowej. Należy sprawdzić ustawienia writeback oraz harmonogram operacji wejścia/wyjścia.
- Presja związana z wirtualizacją: st widoczny, r waha się, id „skacze“ → Host dzieli procesor. Rozwiązanie: sprawdzić przydział/rozmieszczenie vCPU, zmniejszyć overcommit.
Poznaj ograniczenia programu vmstat
Vmstat to doskonałe narzędzie Czujnik wczesnego ostrzegania, ale nie mikroskop. Pokazuje mi, że coś się zacina i gdzie – nie wskazuje konkretnego pliku, zapytania ani wątku. Dlatego po przeprowadzeniu diagnostyki za pomocą vmstat konsekwentnie sięgam po zaawansowane narzędzia, weryfikuję hipotezy z różnych perspektyw, a następnie wprowadzam zmiany pojedynczo. Dzięki temu ulepszenia pozostają mierzalne i powtarzalne.
Podsumowanie z praktyki
Dzięki vmstat w ciągu kilku sekund mogę sprawdzić, czy spowolnienie wynika z obciążenia procesora, pamięci RAM, partycji swapowej czy operacji wejścia/wyjścia, analizując współdziałanie parametrów r, b, si/so, bi/bo oraz us/sy/id/wa/st czytaj. Analizuję trendy zamiast pojedynczych wartości, porównuję je z wartościami bazowymi i w razie potrzeby korzystam z narzędzi iostat, mpstat, pidstat oraz historycznych pomiarów. W przypadku nagłych zakłóceń pomijam pierwszy wiersz i skupiam się na kolejnych wierszach o stałej częstotliwości próbkowania. Podejmuję decyzje w oparciu o dane: r w stosunku do jąder, si/so trwale różne od 0, wa stale podwyższone, us+sy bliskie pełnemu obciążeniu. W ten sposób szybko wyznaczam konkretne działania i utrzymuję systemy w dobrym stanie. reaktywny.


