 Przejdź do treści

Wyjaśnię w skrócie i wyczerpująco, jak Wydarzenie MPM która wykorzystuje kolejkę zdarzeń Apache’a do wydajnego zarządzania wieloma równoczesnymi połączeniami HTTP. Przedstawię tu podstawy, pętlę zdarzeń, wewnętrzne kolejki oraz konkretne kroki optymalizacyjne dla wydajny Konfiguracja.
Punkty centralne
- Pętla zdarzeń oddziela zarządzanie połączeniami od obsługi żądań
- Keep-Alive nie blokuje już wątków
- Kolejka zdarzeń sortuje gniazda według stanu
- Parametry jak precyzyjnie dostosować wartość parametru MaxRequestWorkers
- Monitoring zapewnia niezawodne planowanie mocy produkcyjnych
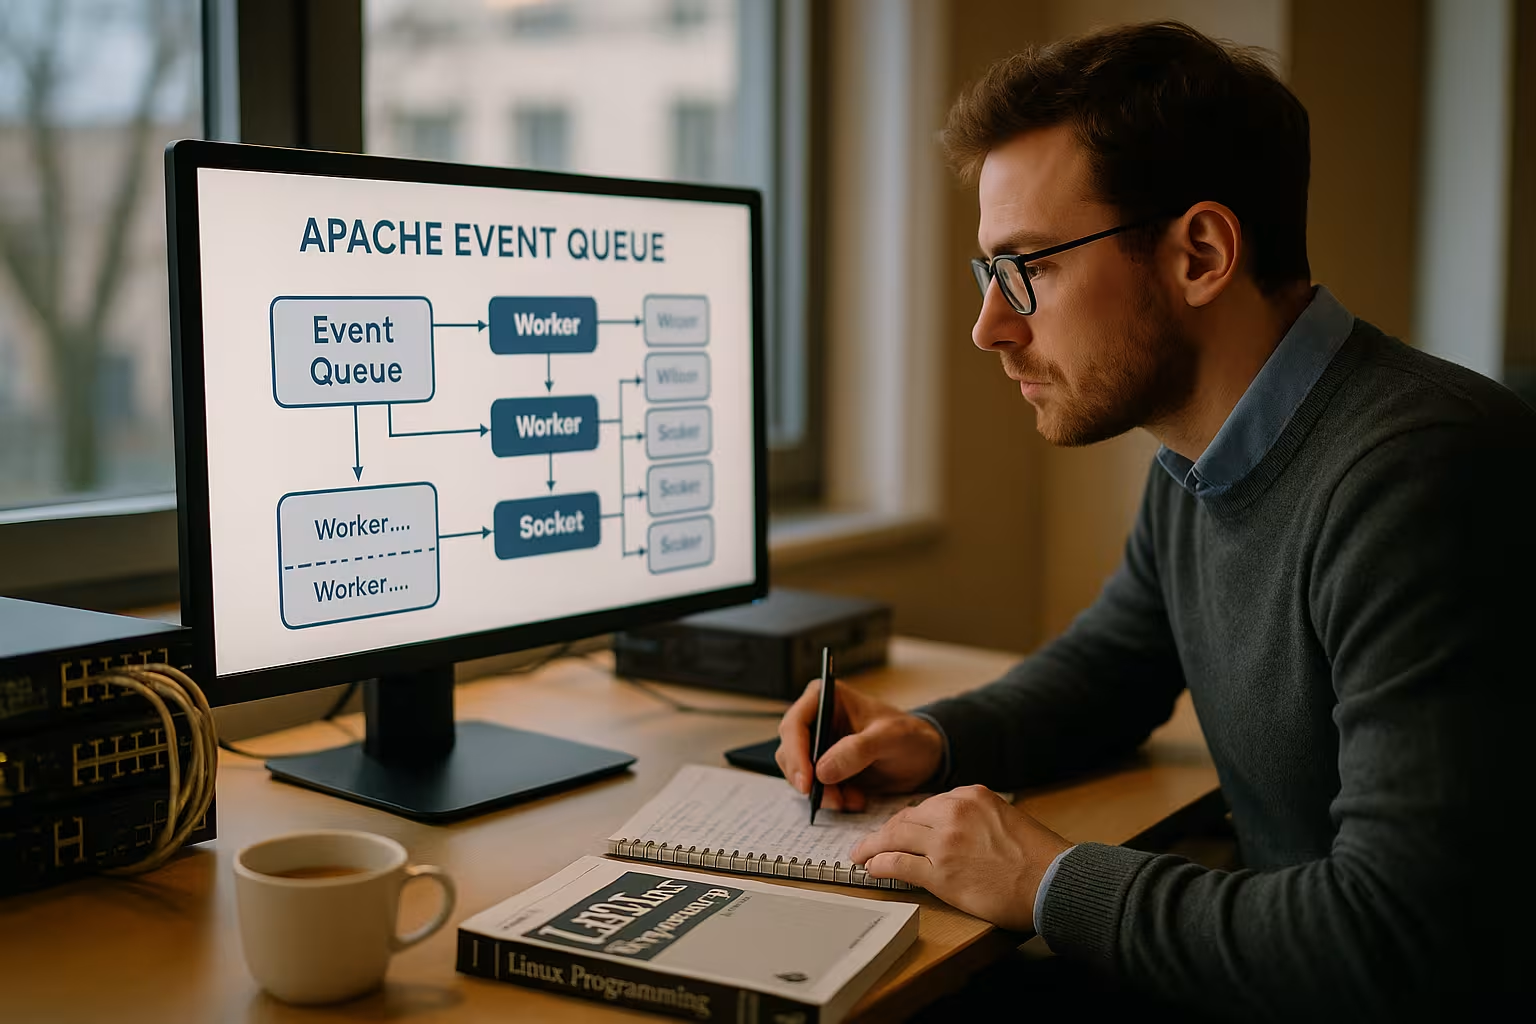
W jaki sposób Event MPM steruje połączeniami
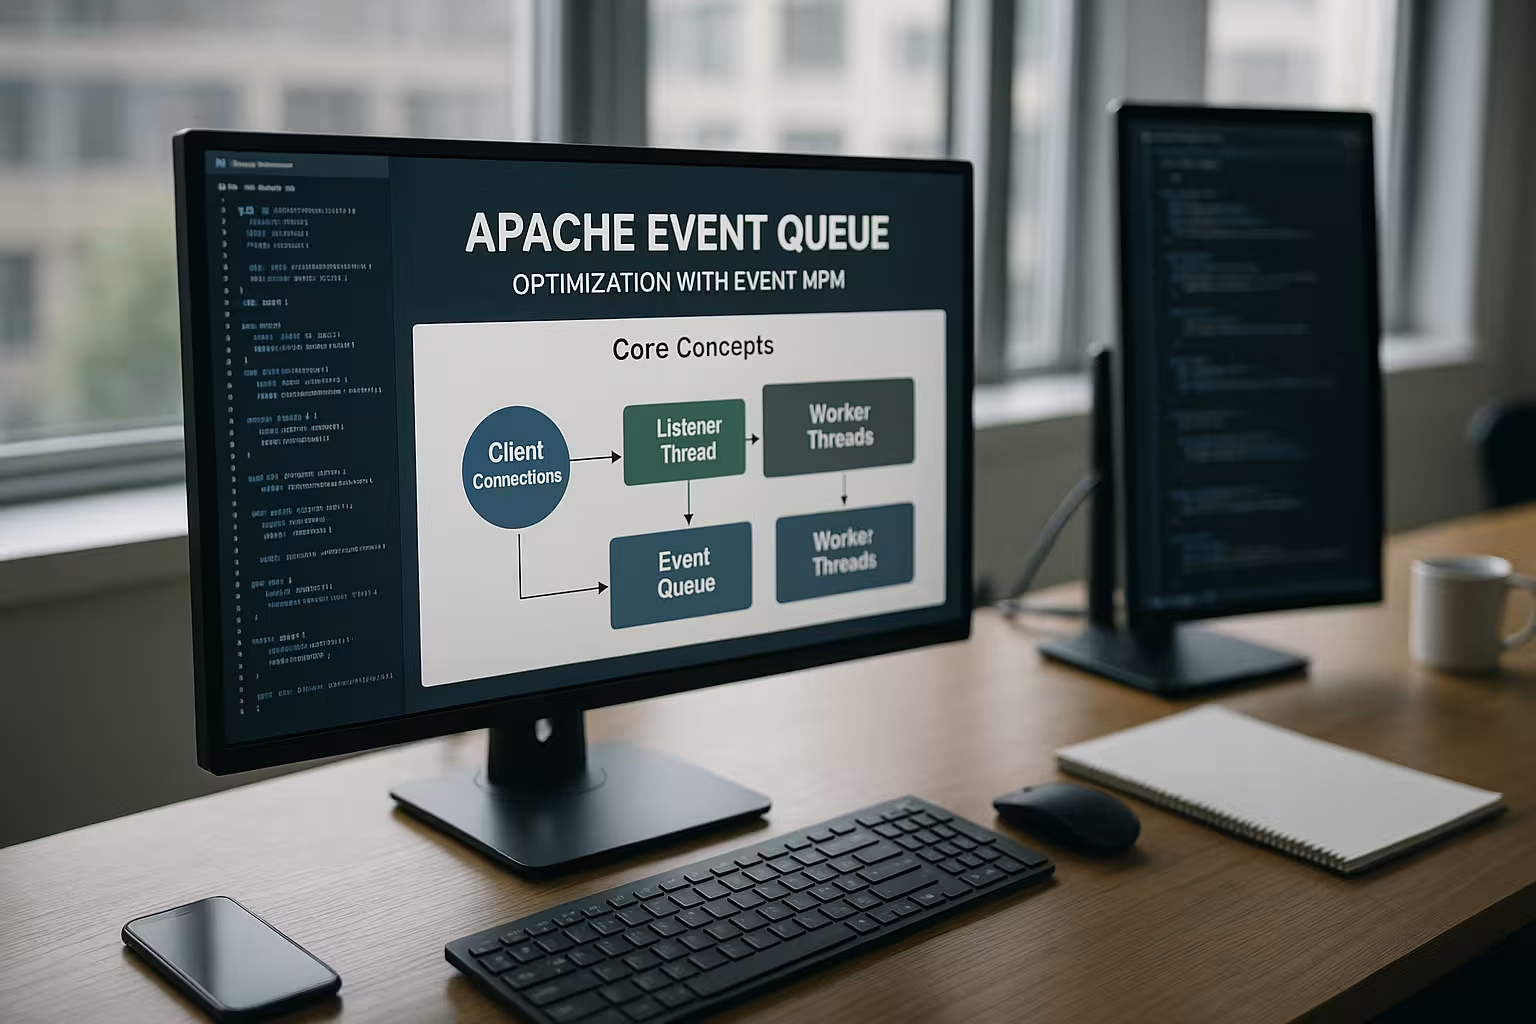
Zacznę od pytania, jak uruchomić Apache'a w Obciążenie zarządza tak wieloma połączeniami. Event MPM łączy procesy i wątki, ale nadaje priorytet zdarzeniom za pośrednictwem pętli zdarzeń. Wątki nasłuchujące przyjmują nowe gniazda i monitorują istniejące połączenia bez natychmiastowego blokowania wątku roboczego. Dopiero gdy dane są gotowe do odczytu lub zapisu, warstwa zdarzeń przekazuje gniazdo do wolnego wątku roboczego. W ten sposób zapobiegam sytuacji, w której biegu jałowym-Połączenia zajmują wątki i marnują pamięć.
To rozdzielenie zauważalnie zmniejsza obciążenie pamięci RAM. Wątki zajmują się przede wszystkim „rzeczywistą pracą“, taką jak analizowanie żądań, generowanie odpowiedzi czy działanie jako serwer proxy. Pętla zdarzeń przywraca następnie gniazda do odpowiedniego stanu, na przykład z powrotem do trybu Keep-Alive lub do fazy zakończenia. W praktyce obserwuję krótsze kolejki w momentach szczytowego obciążenia, ponieważ wolne wątki szybciej stają się ponownie dostępne. Architektura zapewnia przejrzystą skalujące Wydajność w przypadku typowych obciążeń protokołów HTTP/1.1 i HTTP/2.
Szczegółowe omówienie kolejki zdarzeń Apache
Kolejka zdarzeń przypisuje każdemu połączeniu określony stan i właśnie w tym tkwi Zysk w porównaniu z klasycznymi modelami MPM. Nowe połączenia trafiają najpierw do kolejki sprawdzającej czytelność. Gdy napływają dane, pętla zdarzeń przenosi gniazdo do kolejki „readable“ i przypisuje je do procesu roboczego. Po przetworzeniu status ponownie decyduje o dalszym postępowaniu: zakończenie zapisu, zawieszenie Keep-Alive lub zamknięcie. Cykl ten pozostaje oszczędny, ponieważ zarządzanie kolejkami odbywa się w sposób wydajny za pomocą epoll lub kqueue.
Często spotykam się z nieporozumieniami: kolejka zadań (Event Queue) nie zastępuje procesów roboczych (Worker), lecz koordynuje ich Użycie bardziej wydajnie. Wątki nadal przetwarzają żądania, ale tylko wtedy, gdy faktycznie przepływają bajty. Oszczędza to zasoby procesora i pamięci w sytuacjach, w których występuje wiele „bezczynnych“ połączeń typu keep-alive. Im bardziej przemyślana jest konstrukcja mechanizmów timeoutu i buforowania, tym mniejsze jest ryzyko, że połączenia będą niepotrzebnie długo pozostawać w kosztownych stanach. W ten sposób można utrzymać stały czas odpowiedzi nawet przy tysiącach otwartych gniazd.
Problem utrzymywania połączenia w klasycznych MPM
W protokole HTTP/1.1 połączenia często pozostają otwarte, aby umożliwić wysyłanie wielu żądań bez konieczności przeprowadzania nowego uzgadniania połączenia, co Opóźnienie oszczędza. Prefork lub Worker wiążą jednak w tym celu procesy lub wątki, które po prostu czekają. W przypadku szczytów obciążenia wiele połączeń typu keep-alive blokuje wówczas cenne zasoby wykonawcze. Powoduje to wzrost zużycia pamięci RAM i ogranicza liczbę równoległych klientów. Moduł Event MPM łagodzi ten problem, utrzymując w kolejce zdarzeń gniazda pozostające w stanie bezczynności bez wątku w korzystnym stanie oczekiwania.
W ten sposób odkładam na później wiele połączeń i rozpoczynam ich przetwarzanie dopiero wtedy, gdy faktycznie jest to potrzebne. Zmienia to model wydajności: zamiast stosunku „wątki = połączenia” stosuję zasadę „wątki = aktywna praca”. Dzięki temu w scenariuszach testowych mogę dopuścić znacznie większą liczbę otwartych połączeń bez spadków wydajności w zakresie Czas reakcji. W przypadku backendów API, hostingu WordPressa i dużych witryn z treścią oznacza to znacznie bardziej równomierne obciążenie. Korzyści płynące z funkcji Keep-Alive pozostają zachowane, a wątki nie ulegają blokowaniu.
MPM zdarzeniowe a MPM robocze
Podsumuję te różnice w zwięzły sposób w jednej Tabela razem. Celem jest szybki przegląd obsługi, wymagań dotyczących zasobów oraz typowych obszarów zastosowań. Oba warianty opierają się na procesach z wieloma wątkami, jednak w przypadku Event funkcja Keep-Alive rzadziej jest powiązana z jednym wątkiem. Worker sprawdza się dobrze przy umiarkowanym obciążeniu, podczas gdy Event wyróżnia się przy dużej liczbie równoległych połączeń. Ta klasyfikacja pomaga w podejmowaniu trafnych decyzji dotyczących własnego środowiska. Bardziej szczegółowe porównanie przedstawiam pod adresem Zdarzenie a pracownik.
| MPM | Obsługa funkcji Keep-Alive | Wątki/procesy | Wymagania dotyczące pamięci RAM | Odpowiedni dla |
|---|---|---|---|---|
| Prefork | Proces blokuje się na biegu jałowym | Tylko procesy | Wysoki | Starsza wersja PHP bez bezpieczeństwa wątków |
| Pracownik | Wątek często pozostaje związany | Procesy i wątki | Średni | Umiarkowane obciążenie, proste konfiguracje |
| Wydarzenie | Pętla zdarzeń zapisuje gniazda pozostające bezczynne | Procesy i wątki | Niski do średniego | Wielu klientów, długie fazy utrzymywania połączenia |
Typowe scenariusze zastosowań
Korzystam z Event MPM, gdy występuje wiele równoległych Klienci żądania o małej i średniej wielkości. Blogi o dużym natężeniu ruchu, sklepy internetowe z buforowaniem, zasoby statyczne i punkty końcowe API odczuwają wymierne korzyści. Podobnie jest w przypadku konfiguracji hostingowych z wieloma stronami internetowymi na jednym serwerze, w których dominują połączenia typu Keep-Alive. Kolejka zdarzeń (Event Queue) utrzymuje tam niewielką liczbę aktywnych wątków i równomiernie rozdziela obciążenie. Użytkownicy protokołu HTTP/2 odnoszą dodatkowe korzyści, ponieważ jedno połączenie może obsługiwać wiele strumieni, podczas gdy warstwa zdarzeń (Event Queue) sprawnie koordynuje ich stany.
Event wykazuje swoje zalety również w topologiach z odwrotnym serwerem proxy. Pozwalam Apache’owi na zakończenie połączeń SSL, obsługę buforowania oraz przekazywanie żądań do warstwy aplikacji. Dzięki temu zarządzanie połączeniami pozostaje lekkie, co łagodzi wąskie gardła. Nawet w przypadku szczytów ruchu czasy odpowiedzi pozostają pod kontrolą, o ile limity są rozsądnie ustawione. Zmniejsza to ryzyko Kolejka-Zatory i przekroczenia limitów czasu.
Konfiguracja: dyrektywy kluczowe
Aby sformułować trafną opinię, najpierw sprawdzam ServerLimit, StartServers, ThreadsPerChild i MaxRequestWorkers. Ogólna zasada: wartość ServerLimit × ThreadsPerChild powinna być zbliżona do MaxRequestWorkers, z rezerwą na konserwację i rozwój. Zbyt mała wartość ogranicza równoległość, a zbyt duża nadmiernie zwiększa zapotrzebowanie na pamięć RAM. Ustawiam KeepAlive na On, ale wartość KeepAliveTimeout ustalam na umiarkowanym poziomie, aby uniknąć nadmiernego obciążenia w stanie bezczynności. Wartości od kilku do kilkudziesięciu sekund często sprawdzają się dobrze, w zależności od profilu ruchu.
Ponadto zwracam uwagę na limity czasu dla operacji odczytu, zapisu i serwerów proxy. Krótsze wartości chronią przed zawieszaniem się serwerów zaplecza, dłuższe pomagają w przypadku powolnie reagujących klientów, co Kompromisy jest wymagane. W przypadku plików statycznych warto wysyłać je w większych blokach i stosować wydajne łańcuchy filtrów. W przypadku PHP za pośrednictwem FPM lub balanserów proxy skaluję liczbę procesów backendowych tak, aby odpowiadała równoległości działania frontendu. Dokumentuję każdą zmianę i mierzę jej wpływ, zanim przejdę do kolejnych działań.
Optymalizacja kolejki zdarzeń: krok po kroku
Zaczynam od jasnego profil obciążenia: liczba jednoczesnych połączeń, liczba żądań na sekundę, rozmiary odpowiedzi, odsetek połączeń typu Keep-Alive. Następnie ustalam wartość MaxRequestWorkers tak, aby procesor nie pozostawał w stanie bezczynności, a pamięć RAM była wystarczająca. Parametr ThreadsPerChild dostosowuję tak, aby szczyty obciążenia były obsługiwane bez opóźnień. Parametr KeepAliveTimeout kalibruję tak, aby uzyskać dobrą równowagę między komfortem użytkowania a oszczędzaniem zasobów. Osoby pragnące głębiej zrozumieć zachowanie kolejkowania znajdą podstawowe informacje pod adresem Kolejkowanie serwera WWW.
Przeprowadzam testy iteracyjne przy użyciu narzędzi takich jak ab, wrk czy k6 i analizuję opóźnienia w przedziałach P50, P95 i P99. Obserwuję przy tym, kiedy połączenia pozostają w trybie Keep-Alive, a kiedy się zamykają. Nieznaczne zwiększenie liczby wątków pomaga złagodzić krótkie skoki obciążenia bez przeciążania serwera. Jednocześnie sprawdzam logi błędów pod kątem komunikatów takich jak „server reached MaxRequestWorkers“. W ten sposób uzyskuję harmonijny Współdziałanie kolejki zdarzeń i puli pracowników.
Monitorowanie i wskaźniki
Dobre wskaźniki zapewniają wiarygodne Pojemność. Włączam mod_status i śledzę procesy aktywne, bezczynne oraz oczekujące. Tablica wyników pokazuje, czy żądania oczekują, czy też zasoby są wolne. Dodatkowo mierzę liczbę procesów i wątków, wykorzystanie pamięci RAM oraz operacje wejścia/wyjścia sieciowego. Wizualna analiza pomaga rozpoznać trendy i punkty krytyczne. Więcej szczegółów można znaleźć w Apache Scoreboard.
Koreluję te wartości z logami dostępu i kodami błędów. Jeśli wskaźniki błędów 5xx rosną przy pełnym obciążeniu, często oznacza to, że limity są zbyt niskie. Jeśli wydłuża się czas oczekiwania, sprawdzam usługi zaplecza, rozpoznawanie adresów DNS oraz ścieżki sieciowe. Przy dużym obciążeniu sprawdzam również zaległości TCP i retransmisje SYN. W ten sposób ustalam, czy Przyczyna czy to na serwerze WWW, w backendzie, czy w sieci.
HTTP/2, serwer proxy odwrotny i moduły
HTTP/2 łączy kilka strumieni w jedno połączenie, co Wydarzenie-Architektura idealnie spełnia swoje zadanie. Dbam o równowagę między limitami strumieni a pulą wątków, aby wiele małych strumieni nie trafiało do kolejek. Jako serwer proxy odwrotny Apache czerpie korzyści z krótkich limitów czasu i niezawodnych połączeń z serwerami zaplecza. Moduły działające w sposób silnie blokujący mogą jednak zajmować wątki i ograniczać te korzyści. Dlatego sprawdzam kompatybilność i wymieniam przestarzałe komponenty, jeśli powodują one skoki opóźnień.
Moduły pamięci podręcznej i kompresja zwiększają wydajność, o ile profile procesora są do tego dostosowane. Optymalizacja TLS z wykorzystaniem nowoczesnych szyfrów oraz priorytetyzacja HTTP/2 pomagają w szybkim dostarczaniu treści. Stosuję wznowienie sesji i obserwuję koszty uzgadniania połączenia pod obciążeniem. W przypadku zasobów statycznych dobrze sprawdzają się rozwiązania typu zero-copy oraz sendfile. Sztuka polega na tym, by łańcuch składający się z TLS, kolejki zdarzeń, modułu roboczego i zaplecza był jak najmniej rozbudowany.
Wewnętrzny przebieg i stany w zdarzeniu MPM
Aby zrozumieć wewnętrzne procesy, myślę w kategoriach stanach: accept → readable → processing → writable → keep-alive → close. Wątki nasłuchujące monitorują gniazda za pomocą wydajnych mechanizmów jądra (epoll/kqueue) i budzą wątki robocze tylko wtedy, gdy wystąpi zdarzenie. Po przetworzeniu żądania warstwa zdarzeń decyduje, czy połączenie zostanie pozostawione w trybie Keep-Alive, bezpośrednio zamknięte, czy też zakończone w sposób zbliżony do „lingering close“, aby późniejsze pakiety TCP zostały poprawnie przetworzone. Ten automat stanów zapobiega „busy waiting“ i minimalizuje zmiany kontekstu.
Ważne jest przy tym rozróżnienie między Czas oczekiwania na operacje wejścia/wyjścia oraz obciążenie procesora: analizowanie żądań, potoki filtrów (np. kompresja) oraz generowanie odpowiedzi odbywają się w wątkach roboczych. Samo oczekiwanie na dostępność do odczytu/zapisu pozostaje w pętli zdarzeń. Dzięki temu Apache lepiej wykorzystuje dostępne wątki i zmniejsza Gęstość splotu w przypadku otwartego połączenia – drastycznie.
Biorę również pod uwagę zachowanie tablicy wyników: w mod_status można odczytać fazy takie jak „R“ (odczyt), „W“ (wysyłanie odpowiedzi), „K“ (Keepalive) i „G“ (płynne zakończenie). Wysoki odsetek „K“ przy jednoczesnej dostępności wolnych procesów roboczych wskazuje, że kolejka zdarzeń działa poprawnie i nie marnuje wątków. Jeśli czasy „R“ wyraźnie wzrosną, może to oznaczać, że powolne klienty lub zbyt restrykcyjne limity czasu odczytu wskazują na możliwość optymalizacji.
Planowanie zasobów: przykładowe obliczenia i sensowne wartości domyślne
Obliczam Równoległość z uwzględnieniem procesora, pamięci RAM i obciążenia. Przykład: 8 vCPU, 16 GB pamięci RAM, treści przechowywane głównie w pamięci podręcznej oraz PHP-FPM w backendzie. Zaczynam od wartości MaxRequestWorkers 512–768, ThreadsPerChild 32–64, a ServerLimit odpowiednio 8–12. Na każdy aktywny proces pracujący planuję 1–3 MB na obciążenie Apache’a wraz z modułami, do czego dochodzą bufory odpowiedzi, obciążenie związane z TLS oraz gniazda zaplecza. Realistycznie rezerwuję 4–8 GB na procesy/wątki Apache’a, 2–4 GB na pamięć podręczną systemu operacyjnego, a resztę na zaplecze. Zwracam uwagę, aby ServerLimit × ThreadsPerChild nigdy nie jest mniejsza niż MaxRequestWorkers; warto pozostawić pewien zapas.
Przegląd przydatnych wskazówek: – MinSpareThreads/MaxSpareThreads: Należy utrzymywać rezerwę w taki sposób, aby pokrywać szczytowe obciążenia bez konieczności „rozruchu na zimno“, ale tak, by zbyt wiele wątków bezczynnych nie zajmowało pamięci. – MaxConnectionsPerChild (znany również jako MaxRequestsPerChild): Ograniczenie cyklu życia każdego procesu pomaga uniknąć fragmentacji pamięci i wycieków pamięci podczas długotrwałej pracy (np. 5k–20k). – MaxKeepAliveRequests: Ogranicza liczbę żądań na połączenie; umiarkowane wartości chronią przed „nieskończonymi“ sesjami, nie ograniczając przy tym korzyści płynących z funkcji Keep-Alive (np. 100–1000). – Limit czasu, Limity czasu odczytu/zapisu oraz ProxyTimeout: Zapobieganie zawieszaniu się; ustawiam zróżnicowane wartości dla poszczególnych kontekstów, zamiast stosować zbyt konserwatywne ustawienia globalne.
W przypadku plików statycznych używam EnableSendfile oraz Włącz MMAP Zgodnie z zamierzeniem: na dyskach lokalnych obie opcje mogą przynosić korzyści; w przypadku woluminów NFS/chmury często wyłączam sendfile, aby uniknąć skrajnych przypadków. W ścieżkach TLS sendfile ma z natury rzeczy mniejszy wpływ, ponieważ dane przechodzą przez potoki szyfrowania; w tym przypadku liczy się przede wszystkim wydajność łańcuch filtrów.
Ograniczenia związane z systemem operacyjnym i siecią
Nawet najlepsza architektura wydarzeń niewiele daje, jeśli ograniczenia systemu operacyjnego ją hamują. Sprawdzam: – Deklaratory plików (ulimit -n): Wartość ta powinna znacznie przewyższać maksymalną liczbę jednoczesnych połączeń powiększoną o liczbę gniazd zaplecza; w przypadku obciążonych serwerów typowa jest liczba rzędu kilkudziesięciu tysięcy. – ListenBacklog: Wystarczająco duży bufor akceptacji zapobiega odrzucaniu pakietów SYN w okresach szczytowego obciążenia. – Zaległości w jądrze (np. somaxconn) oraz kolejki SYN: muszą być dostosowane do przewidywanej częstotliwości „burst“. – Bufor sieciowy (rmem/wmem): Nie należy przesadzać, ale należy dobrać parametry tak, aby nie dochodziło do załamania się połączeń o wysokim RTT lub dużej przepustowości.
Rozkładam obciążenie związane z operacjami „Accept” na kilka wątków nasłuchujących i zazwyczaj pozwalam platformie na wybór mechanizmu obsługi operacji „Accept” (AcceptMutex auto). Na systemach, które to obsługują, można SO_REUSEPORT (w zależności od platformy, za pomocą opcji listy) wyrównać ścieżki akceptacji. Ważne jest, aby unikać sytuacji typu „thundering herd”, w których wiele wątków walczy o tę samą akceptację.
Również Tymczasowe porty TCP (ip_local_port_range) oraz zachowanie w fazie TIME-WAIT muszą być dostosowane do liczby równoległych połączeń proxy. Unikam agresywnych modyfikacji, zamiast tego przeprowadzam realistyczne testy i upewniam się, że serwery zaplecza obsługują protokół Keep-Alive, dzięki czemu połączenia mogą być ponownie wykorzystywane, a liczba zmian portów jest mniejsza.
Subtelności działania serwera proxy odwrotnego: pule połączeń i serwery zaplecza
W przypadku serwera proxy odwrotnego ogólna wydajność w dużym stopniu zależy od stabilnych połączeń z serwerami zaplecza. Dbam o to, aby Połączenia proxy Utrzymuj trwałość połączeń (Keep-Alive z backendem) i skaluj pule backendowe tak, aby dostosowywały się do równoległości działania frontendu. Zbyt małe pule powodują zatory w frontendzie, a zbyt duże – niepotrzebne obciążenie aplikacji.
Praktyczne rozwiązania: – ProxyTimeout: Krótsze dla ścieżek niekrytycznych, dłuższe dla „kosztownych“ punktów końcowych – należy rozróżniać, a nie stosować globalnych uogólnień. – Balanser-Ustawienia (w mod_proxy_balancer): wagi, maksymalna liczba połączeń na serwer backendowy, interwały ponownych prób zależne od stanu działania. – mod_proxy_fcgi dla PHP-FPM: FPM-pm.*-Wartości (pm.max_children, pm.start_servers itp.) muszą być dostosowane do równoległości Apache’a, aby uniknąć szczytów błędów 502/504.
Dbam o to, by błędy po stronie serwera były sprawnie i szybko eskalowane, zamiast blokować wątki po stronie klienta. Kontrole stanu, ostrożna polityka ponownych prób oraz wzorce podobne do wyłączników obwodów pozwalają utrzymać stabilne opóźnienia. Tam, gdzie to możliwe, dbam o Buforowanie odpowiedzi w odpowiednich miejscach, aby serwis MPM mógł wysyłać przede wszystkim krótkie i proste odpowiedzi.
Dostrajanie protokołu HTTP/2 w środowisku Event
W przypadku protokołu HTTP/2, oprócz TLS, optymalizuję przede wszystkim Limity przepływu oraz przypisanie procesów roboczych. Duża liczba małych strumieni na połączenie może zmniejszyć opóźnienie, ale zwiększyć obciążenie wątków. Ustawiam maksymalną liczbę strumieni na sesję tak, aby zadziałało multipleksowanie, ale nie doszło do zastąpienia „Head-of-line“. Ponadto ostrożnie zwiększam liczbę procesów roboczych, aby złagodzić skutki faz szczytowego obciążenia bez nadmiernego obciążania pamięci RAM.
Zauważam, że strumienie często czekają, mimo że wątki są wolne. W takich przypadkach przepustowość jest zazwyczaj ograniczana przez limity strumieni lub rozmiary buforów. Jedna Ustalanie priorytetów Korzystanie z zasobów krytycznych (np. CSS/JS z priorytetami HTTP/2) ma bezpośredni wpływ na postrzeganą wydajność. Jeśli chodzi o TLS, wznowienie sesji, mechanizmy podobne do 0-RTT (o ile są bezpieczne i dostępne) oraz nowoczesne algorytmy szyfrowania zmniejszają koszty nawiązywania połączenia.
Niezawodność: limity czasu, ochrona przed atakami typu Slowloris oraz płynne wyłączanie systemu
Aktywuję mod_reqtimeout, aby złagodzić zjawiska podobne do „slowloris”. Limity czasu odczytu zapobiegają sytuacji, w której klienci przesyłają bajty w ślimaczym tempie, zajmując w ten sposób zasoby. Limity czasu zapisu chronią przed powolnymi połączeniami z klientem. Wartości te należy dobierać w zależności od kontekstu – interfejsy API wymagają innych profili niż pobieranie dużych plików.
W przypadku wdrażania i ponownego uruchamiania stawiam na Wdzięczny-Przebieg procesów. Dzięki odpowiednio ustawionemu „graceful timeout“ stare procesy są w kontrolowany sposób wygaszane, podczas gdy nowe przejmują ich zadania. W ten sposób połączenia typu „keep-alive“ pozostają stabilne, a kolejka zdarzeń likwiduje pozostałe obciążenie bez gwałtownych przerw. Rotujące pliki logów, niski poziom szczegółowości logów w szczytowych momentach (np. „info” zamiast „debug”) oraz opcjonalnie Dzienniki buforowane znacznie zmniejszają obciążenie wejść i wyjść.
Wykrywanie usterek pod obciążeniem: rozpoznawanie wzorców
Typowe objawy i sposoby postępowania: – Wysoka P95/P99-Opóźnienia przy wolnych procesach roboczych: najczęściej wynikają z czasu oczekiwania na serwerze zaplecza lub w sieci; należy sprawdzić limity czasu proxy i odczytu, a także pule serwerów zaplecza. – „server reached MaxRequestWorkers“: zbyt mała równoległość – zwiększyć wartość MaxRequestWorkers i/lub ThreadsPerChild, sprawdzić zużycie pamięci RAM. – Wiele Keep-Alive-Połączenia, niewiele aktywnych wątków, a mimo to działa wolno: często blokujące się moduły/filtry lub wąskie gardła w backendzie; sprawdzić profilowanie łańcucha filtrów, obciążenie procesora i operacje wejścia/wyjścia. – Szczyty 5xx z korelującym obciążeniem TLS: uzgodnienia ograniczone wydajnością procesora – zoptymalizować szyfry, wznowienie sesji i, w razie potrzeby, odciążenie.
Eliminuję wąskie gardła w całym łańcuchu: obsługa gniazd (zaległości), pętla zdarzeń (stany oczekiwania), procesy robocze (ograniczone przez procesor), filtry (ograniczone przez operacje wejścia/wyjścia), serwer proxy (ograniczony przez backend). Ten model myślenia pozwala mi uniknąć zmiany wartości parametru MaxRequestWorkers, mimo że w rzeczywistości to backend jest przeciążony.
Lista kontrolna dotycząca praktyki i typowe przeszkody
Pracuję z krótką Lista kontrolna: aktualna wersja Apache’a, włączony moduł MPM typu Event, odpowiednio dobrane limity, rozsądne wartości limitów czasu. Następnie sprawdzam częstotliwości Keep-Alive oraz relację między połączeniami a aktywnymi wątkami. Sprawdzam, czy moduły są bezpieczne pod względem wątków oraz czy filtry nie powodują długotrwałych blokad. W przypadku PHP za pośrednictwem FPM upewniam się, że liczba procesów roboczych FPM jest dostosowana do równoległości działania frontendu. Kalibruję również limity systemu operacyjnego, takie jak deskryptory plików, kolejka TCP oraz parametry jądra dotyczące buforów sieciowych, aby Rurociąg nie zacinają się.
Szybko rozpoznaję typowe przeszkody: zbyt duże wartości KeepAliveTimeout, zbyt małe wartości MaxRequestWorkers, niskie wartości ThreadsPerChild lub nieodpowiednie logowanie. Zbyt szczegółowe logowanie pochłania zasoby wejścia/wyjścia i spowalnia odpowiedzi. Zbyt mała wielkość puli serwerów zaplecza proxy niweczy efekty optymalizacji frontendu. Błędna konfiguracja TLS niepotrzebnie wydłuża proces uzgadniania połączenia. Kto uporządkuje te kwestie, stworzy niezawodny Podstawa stałych opóźnień.
Podsumowanie dla osób odpowiedzialnych za kwestie techniczne
Event MPM wyraźnie rozdziela zarządzanie połączeniami od ich realizacji i stawia na Kolejka zdarzeń, które efektywnie zarządzają połączeniami w stanie bezczynności. Dzięki temu Apache skaluje się przy dużej liczbie jednoczesnych klientów, nie pozostawiając wątków zawieszonych w powietrzu. Odpowiednie połączenie parametrów MaxRequestWorkers, ThreadsPerChild i przemyślanych limitów czasu pozwala utrzymać opóźnienia i zużycie pamięci RAM pod kontrolą. Dzięki ciągłemu monitorowaniu, testom porównawczym i kilku ukierunkowanym dostosowaniom powstaje system, który radzi sobie ze szczytami obciążenia i konsekwentnie odpowiada na żądania. Kto zastosuje się do tych zasad, uzyska z swojego Apacz-Instalacja oferuje znacznie więcej możliwości, a jednocześnie pozostaje kompatybilna z popularnymi aplikacjami i protokołami.


