 Przejdź do treści

Apache Scoreboard pokazuje mi w czasie rzeczywistym, ilu pracowników właśnie odczytuje zapytania, wysyła odpowiedzi lub pozostaje w stanie bezczynności, a ja wykorzystuję te dane do oceny Wykorzystanie serwera bez zgadywania. Dzięki mod_status uzyskuję uporządkowany dostęp do danych o stanie, interpretuję symbole, mierzę przepustowość i na tej podstawie wyznaczam konkretne Etapy tuningu od.
Punkty centralne
- Stan w czasie rzeczywistym zrozumieć wszystkich pracowników i szybko rozpoznać wąskie gardła.
- mod_status Zapewnij bezpieczeństwo i efektywnie wykorzystuj ExtendedStatus.
- Kluczowe dane jak systematycznie analizować wskaźniki takie jak Req/s, Busy/Idle i CPU.
- Symbole interpretować dane z tablicy wyników i podejmować ukierunkowane działania.
- Monitoring zautomatyzować i konfigurować alarmy w oparciu o dane.
Czym jest Apache Scoreboard?
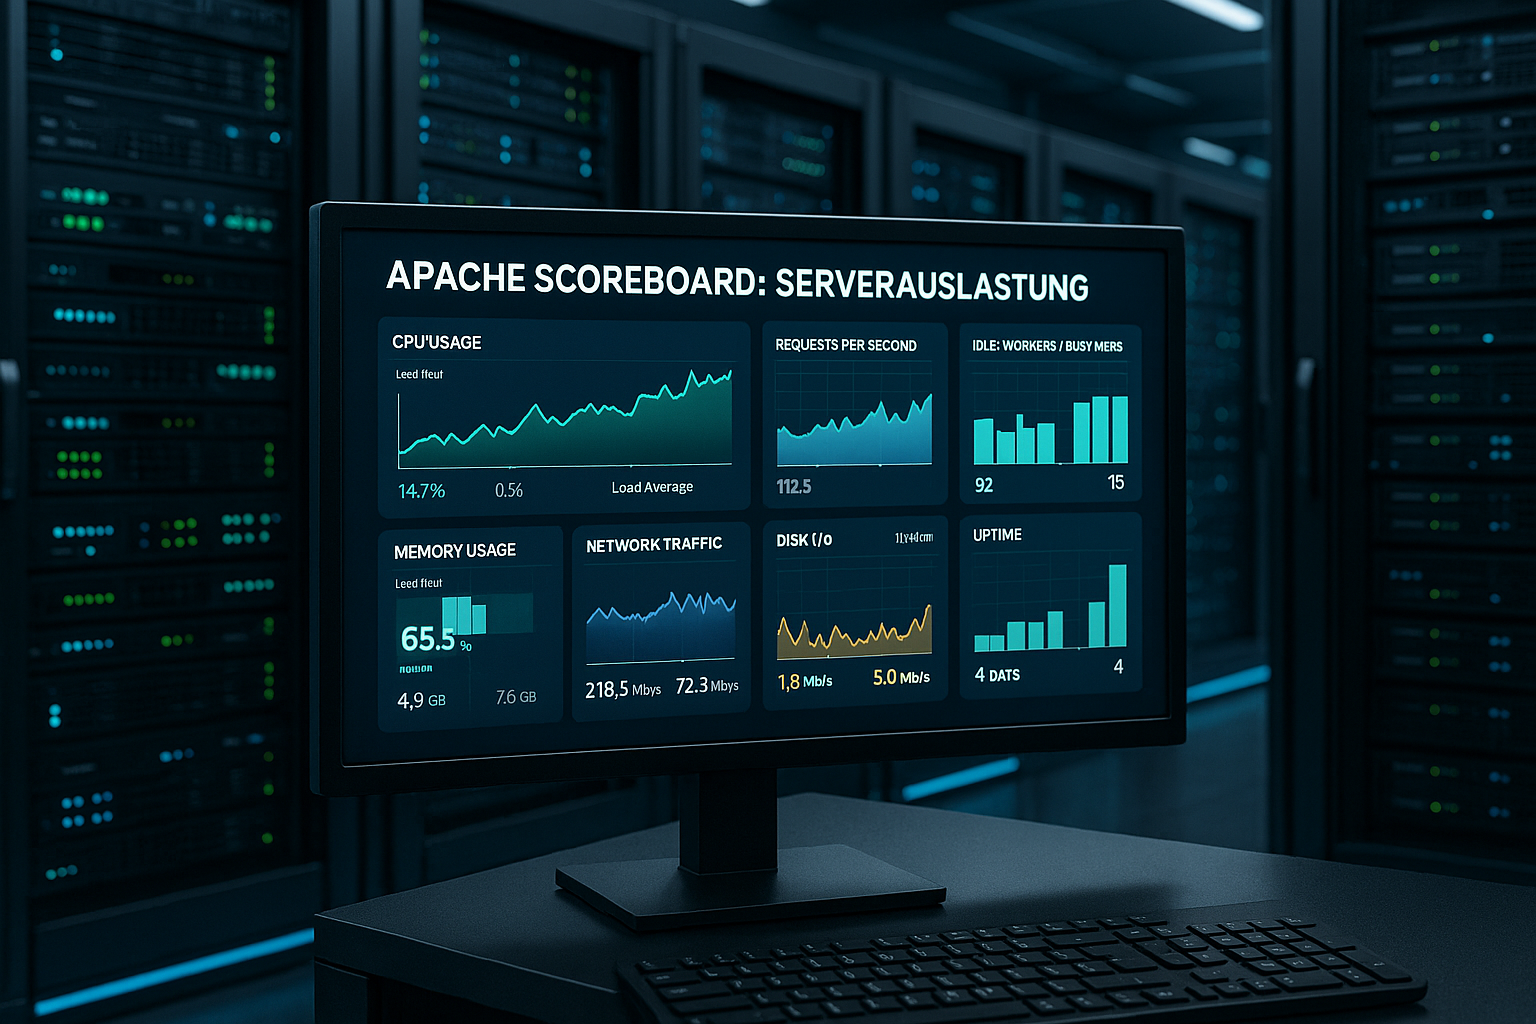
W Scoreboardzie Apache zapisuje dla każdego pracownika aktualny status, taki jak „Odczyt”, „Wysyłanie” lub „Bezczynność”, dzięki czemu widzę Podział obowiązków procesów. Dane są dostępne wewnętrznie i trafiają do interfejsu użytkownika za pośrednictwem mod_status, w formacie HTML lub w trybie nadającym się do odczytu maszynowego. Sprawdzam tam liczbę zajętych i bezczynnych procesów, obciążenie procesora, czas działania, a także liczbę dostępów i ilość bajtów. Za szczególnie pomocny uważam szczegółowy wgląd w poszczególne procesy robocze, ponieważ pozwala mi to rozpoznać czas przetwarzania i aktywny host. W ten sposób mogę podjąć uzasadnioną decyzję, czy brakuje wydajności, czy żądania trwają zbyt długo, czy też sloty Keep-Alive są zablokowane; te Przejrzystość oszczędza czas przy analizie przyczyn.
W ten sposób uzyskuję dostęp za pomocą mod_status
Za pomocą adresu /server-status otwieram przejrzystą stronę HTML; za pomocą adresu /server-status?auto otrzymuję zwięzły wynik tekstowy dla Monitoring oraz skrypty. W środowiskach produkcyjnych włączam ExtendedStatus, ponieważ dodatkowe wskaźniki dla każdego pracownika dostarczają mi niezbędnego kontekstu. Dostęp ograniczam ściśle do sieci administracyjnych lub poszczególnych hostów i nie udostępniam strony publicznie. Do ręcznego przeglądu wystarczy krótka sesja w przeglądarce, natomiast w przypadku ciągłego monitorowania integruję widok automatyczny z systemem monitorowania. W ten sposób ograniczam obciążenie i zapewniam dane statusowe w sposób sensowny.
Ocena bezpiecznej konfiguracji i obciążenia systemowego
Konsekwentnie chronię /server-status i w zależności od sytuacji wybieram między zezwoleniem na adres IP, uwierzytelnieniem a wewnętrznym serwerem wirtualnym administratora. ExtendedStatus powoduje mierzalne, ale w praktyce niewielkie Nad głową; włączam go na stałe, jeśli korzystam z tych danych również w monitoringu, albo tylko tymczasowo w przypadku analiz ad hoc. Przejrzysta przykładowa konfiguracja pomaga mi uniknąć błędów:
Włącz #
ExtendedStatus On

Udostępnij status # wyłącznie wewnętrznie

  SetHandler server-status

  # Wariant 1: na podstawie adresu IP
  Require ip 10.0.0.0/8 192.168.0.0/16 ::1

  # Wariant 2: uwierzytelnianie podstawowe (np. dodatkowo do adresu IP)
  #AuthType Basic
  #AuthName "Server Status"
  #AuthUserFile "/etc/httpd/conf/.htpasswd"
  #Require valid-user
Umożliwiam dostęp do strony również poza wirtualnymi hostami produkcyjnymi (np. poprzez adres wewnętrzny), aby żadne reguły przepisywania ani trasy proxy nie zakłócały działania. Po zakończeniu fazy debugowania sprawdzam, czy publikowane są wyłącznie niezbędne informacje.
Szybkie rozpoznawanie symboli na tablicy wyników
W razie zakłóceń najpierw zwracam uwagę na symbole, ponieważ gęsty wzór liter R i W wskazuje na obciążenie, a duża liczba znaków _ sygnalizuje spokój; te Kodowanie przyspiesza diagnozę. Również litera K pokazuje mi otwarte połączenia Keep-Alive, które w przypadku nieodpowiedniego limitu czasu blokują działanie workerów. Skupienie się na literze D wskazuje na operacje wyszukiwania DNS, które opóźniają odpowiedzi. Częste wpisy z literą L wskazują na blokujące procesy rejestrowania i podsystemy pamięci. Dzięki temu jednym spojrzeniem rozpoznaję dominujące wąskie gardło i rozpoczynam ukierunkowane Środki.
| Symbol | Znaczenie | Natychmiastowa informacja |
|---|---|---|
| _ | Pracownik bezczynny | Wystarczające Pojemność dostępne |
| R | Prośba o przeczytanie | Sprawdź opóźnienie sieciowe lub Klient |
| W | Wysyłanie odpowiedzi | Czas działania backendu i rozmiar danych wyjściowych analizować |
| K | Keep-Alive | Przerwy i przypisanie slotów sprawdzić |
| D | Wyszukiwanie DNS | Wyłączyć odwrotne DNS lub pamięć podręczna |
| L | Rejestrowanie | Rejestrowanie asynchroniczne oraz I/O czek |
| C | Zakończenie | Normalne zakończenie połączenia, krótki widoczny |
| G | Eleganckie wykończenie | Zakończone zapytanie, proces roboczy sprząta na stronie |
| I | Czyszczenie w stanie bezczynności | Bezkrytyczny, pracownik skorygowane |
| . | Bezczynny | Okres spokoju, zasoby darmowy |
Wykrywanie zaawansowanych wzorców i profili ataków
Oceniam nie tylko poszczególne stany, ale także Czas trwania oraz rozkład symboli. Duża liczba długotrwałych stanów R przy jednocześnie niskiej przepustowości sieci wskazuje na powolne klienty lub wzorce Slowloris; w takim przypadku ograniczam czas odczytu na żądanie (np. za pomocą RequestReadTimeout) i ustalam realistyczne minimalne szybkości. Jeśli przeważają stany typu W z dużą liczbą bajtów na żądanie, to raczej przepustowość lub pamięć masowa stanowią ograniczenie. Występowanie jednocześnie stanów typu D i L sprawia, że nadaję priorytet rozpoznawaniu nazw i operacjom wejścia/wyjścia dzienników. Decydujące znaczenie ma to, czy wzorce szeroki (wszyscy pracownicy) lub lokalny (tylko jeden VHost lub ścieżka) – dzięki temu szybciej znajduję punkty newralgiczne w aplikacji.
Wskaźniki służące do analizy serwerów internetowych
Liczba żądań na sekundę pokazuje mi przepustowość, ale równolegle analizuję liczbę bajtów na sekundę oraz liczbę bajtów na żądanie dla ładowność. Stosunek czasu zajętości do czasu bezczynności wskazuje, czy brakuje slotów, czy też ustawienia są zbyt konserwatywne. Koreluję obciążenie procesora z czasami odpowiedzi, aby odróżnić obciążenia związane z procesorem od obciążeń związanych z operacjami wejścia/wyjścia. Czas działania pomaga odróżnić świeże restarty od rzeczywistych trendów. Na podstawie tej kombinacji wyznaczam konkretne dźwignie optymalizacyjne dla workerów, keep-alive i Limity czasu od.
Wartości graniczne i sygnalizacja alarmowa w praktyce
Nie ustawiam alarmów na podstawie wartości chwilowych, lecz na podstawie średnich kroczących i Czas trwania. Sprawdziły się np. następujące heurystyki: Idle 4:1 w tym samym okresie wskazuje na nasycenie. Wartość Req/s spada przy stałym natężeniu ruchu, podczas gdy wskaźnik Busy pozostaje na stałym poziomie – często oznacza to problem po stronie backendu. Udział K > 50 % w godzinach szczytu wskazuje na zbyt hojne ustawienia Keep-Alive. Dodaję progi dotyczące alarmów trendowych (rosnące czasy odpowiedzi przy niezmiennym obciążeniu) oraz Sezonowość (wzorce dzienne i tygodniowe), abym mógł odróżnić rzeczywiste zmiany od normalnego zachowania.
Prawidłowe sklasyfikowanie pliku ScoreboardFile
Na niektórych platformach Apache zapisuje dane o stanie w pliku Scoreboard, a ja umieszczam go w szybkim, zabezpieczonym katalogu, takim jak /var/run/httpd; zwiększa to niezawodność. Zapobiegam sytuacji, w której wiele instancji korzysta z tego samego pliku, ponieważ grozi to zafałszowaniem wartości. Niektóre narzędzia odczytują dane bezpośrednio z pliku, co sprawia, że punkt końcowy HTTP staje się zbędny. Jest to korzystne z punktu widzenia bezpieczeństwa i wydajności, o ile uprawnienia są odpowiednio skonfigurowane. Dokumentuję ścieżkę i dostęp, aby ułatwić konserwację i Monitoring zachować spójność.
Specyfika systemów operacyjnych i kontenerów
Dbam o to, aby limity deskryptorów plików, zaległości i ścieżki tymczasowe były dostosowane do obciążenia. W systemd sprawdzam, czy PrivateTmp lub ReadOnlyPaths mają wpływ na ścieżkę Scoreboard. W kontenerach ostrożnie planuję zapotrzebowanie na pamięć dla każdego procesu/wątku i umieszczam ścieżkę Scoreboard w katalogu z prawem do zapisu Katalog uruchomieniowy. W przypadku obciążenia szczytowego dostosowuję parametry jądra:
# Przykładowe wartości sysctl (należy przetestować i udokumentować w całym systemie)
net.core.somaxconn = 4096
net.ipv4.tcp_max_syn_backlog = 4096
fs.file-max = 1048576
Ponadto dostosowuję parametr `ulimit -n` dla usługi Apache tak, aby maksymalna jednoczesność pasuje (zasada ogólna: liczba otwartych FD ≈ 2–3 × MaxRequestWorkers w konfiguracjach opartych głównie na serwerach proxy). Po wprowadzeniu zmian ponownie sprawdzam tablicę wyników, aby potwierdzić efekty.
Typowe zastosowania: wykrywanie przeciążonych pracowników
Jeśli prawie wszystkie sloty są zajęte przez R lub W i prawie nie pojawiają się wpisy _‑, serwer osiąga swoje Limit. Następnie sprawdzam ustawienie `MaxRequestWorkers`, czasy odpowiedzi oraz blokujące procesy backendowe. Jeśli dodanie dodatkowych procesów roboczych nie pomaga, wąskie gardło często tkwi w aplikacji, bazie danych lub pamięci masowej. Za pomocą /server-status?auto śledzę zmiany w określonych odstępach czasu, zamiast ograniczać się do pojedynczych migawek. W ten sposób decyduję, czy dostosować ustawienia, wzmocnić buforowanie, czy Skalowanie planować.
Model zasobów i wzory dotyczące zdolności produkcyjnej
Z góry obliczam wymagane zasoby, aby nie dopuścić do niedoborów pamięci. W przypadku modelu Prefork obowiązuje wzór: pamięć ≈ liczba procesów × RSS na proces. W przypadku modelu Worker/Event: pamięć ≈ liczba procesów × (RSS na proces) + liczba wątków × obciążenie związane z wątkiem. Mierzę rzeczywistą wartość RSS za pomocą narzędzi systemowych i zachowuję marginesy bezpieczeństwa. Mały przykład: 20 procesów × 50 MB + 500 wątków × 1 MB daje ≈ 1,5 GB, plus pamięć podręczna i bufory systemu operacyjnego. Na tej podstawie wyznaczam wartości MaxRequestWorkers, ServerLimit i ThreadsPerChild. Biorę również pod uwagę, że moduły takie jak SSL, PHP czy reverse-proxying zwiększają zużycie pamięci o Wątek mogą się zwiększyć; dlatego przeprowadzam testy przy rzeczywistym obciążeniu, a nie tylko na biegu jałowym.
Interpretacja kolejek i opóźnień
Jeśli zapytania pozostają przez dłuższy czas w stanie „Accept” lub „Write”, wzrasta odczuwalne opóźnienie, a ja analizuję długości kolejek oraz zaległości w stanie „Accept”; tablica wyników dostarcza w tym zakresie cennych Wskaźniki. Bardziej szczegółowe wyjaśnienie dotyczące kolejek, opóźnień i obsługi żądań znajduję w tym artykule: Kolejki i opóźnienia. Na tej podstawie oceniam, czy wąskie gardła powstają przed serwerem Apache, w samym serwerze Apache czy za nim. Krótkie skoki obciążenia akceptuję, ale długotrwałe zatory eliminuję poprzez zwiększenie przepustowości lub modyfikację architektury. W ten sposób zapobiegam eskalacji przekroczeń limitów czasu i klientom przerwać.
Nawiązanie połączenia z backendem i serwerem proxy
W środowiskach opartych na proxy na podstawie faz W ustalam, czy workerzy są w Strumienie w górę Czekam. ExtendedStatus pokazuje mi VHost i żądany zasób; na tej podstawie kojarzę ścieżki z powolnymi serwerami zaplecza. Ustawiam realistyczne limity czasu (TimeOut, ProxyTimeout) i sprawdzam pulę połączeń, aby wątki nie blokowały się niepotrzebnie. Jeśli w potoku przesyłania plików powstają zatory, reguluję szybkość odczytu na klienta i zabezpieczam się przed wolnymi nadawcami. Jeśli generowanych jest wiele dużych odpowiedzi, stosuję kompresję, chunking i Buforowanie w celu skrócenia okresów W.
Precyzyjna konfiguracja funkcji Keep-Alive
Wiele wpisów typu „K” wskazuje na klientów, którzy pozostawiają otwarte połączenia; przyspiesza to kolejne żądania, ale może powodować wyczerpanie slotów wiązanie. Ustawiam limity czasu tak, aby korzystały na tym prawdziwe powtórzenia, a jednocześnie nie blokowały zbyt długo bezczynności. Na stronach o dużym natężeniu ruchu pomaga mi serwer proxy umieszczony przed serwerem, który efektywnie grupuje połączenia Keep-Alive. Aby uzyskać szczegółowe informacje na temat precyzyjnego dostosowywania ustawień, korzystam z tego przewodnika: Ustawianie limitu czasu Keep-Alive. Dzięki odpowiedniemu czasowi oczekiwania zmniejsza się obciążenie gniazd, a serwer pozostaje sprawny pod obciążeniem responsywny.
Współpraca protokołów HTTP/2, TLS i MPM
W przypadku protokołu HTTP/2 zazwyczaj obserwuję mniejsze wykorzystanie łącza na klienta, ponieważ wiele strumieni korzysta z jednego połączenia udostępnić. Event-MPM wykazuje tutaj swoje mocne strony: obsługa Keep-Alive jest bardziej wydajna, a aktywna praca pozostaje w gestii wątków. TLS zwiększa zapotrzebowanie na moc procesora na jedno połączenie; obserwuję, czy wysoki udział W koreluje z wysokim obciążeniem procesora, i optymalizuję zestawy szyfrów oraz wznawianie sesji. W widokach stanu rozpoznaję dla każdego VHost, czy dominują ścieżki HTTP/2 czy terminacji TLS, i odpowiednio dostosowuję zasoby (np. więcej wątków zamiast większej liczby procesów, jeśli zmiany kontekstu są kosztowne).
Pełna kontrola nad wyszukiwaniem adresów DNS i rejestrowaniem danych
Jeśli litera „D” pojawia się często w tabeli wyników, sprawdzam odwrotne DNS i włączam lokalną pamięć podręczną lub wyłączam wyszukiwanie; to zmniejsza Opóźnienie. Jeśli widzę dużo wpisów typu L, rejestrowanie spowalnia przetwarzanie, więc rozdzielam pliki logów, korzystam z szybszej pamięci masowej lub asynchronicznych potoków. Rotujące logi konfiguruję tak, aby nie dochodziło do szczytów obciążenia podczas opróżniania. Równolegle mierzę operacje wejścia/wyjścia zapisu oraz blokady plików, aby wyeliminować wzorce blokujące. W ten sposób odzyskuję czas przetwarzania i odciążam Pracownik.
Integracja z systemami monitorowania
Okresowo pobieram dane z /server-status?auto, zapisuję je jako szereg czasowy i wizualizuję wskaźniki „Busy vs Idle”, Req/s, Bytes/s oraz obciążenie procesora na Pulpity nawigacyjne. Alarmy definiują wartości progowe dla stale zapełnionych slotów, rosnących czasów odpowiedzi lub nietypowych wzorców ruchu. Za pomocą adnotacji oznaczam wdrożenia, dzięki czemu od razu widzę skutki. Ta historia pozwala odróżnić jednorazowe szczyty od prawdziwych trendów. W ten sposób planowo zarządzam wydajnością i zapobiegam Niespodzianki.
Zautomatyzowane gromadzenie danych za pomocą skryptów
Do szybkich sprawdzeń wystarcza mi lekki skrypt, który analizuje widok „Auto” i wyświetla tylko kluczowe dane. Ustalam umiarkowane interwały zapytań (np. 10–30 sekund), aby ograniczyć obciążenie systemu, a każdą próbkę oznaczam tagami host, VHost i środowisko.
#!/bin/sh
URL="http://127.0.0.1/server-status?auto"
curl -s "$URL" | awk -F': ' '
  /BusyWorkers/ {busy=$2}
  /IdleWorkers/ {idle=$2}
  /ReqPerSec/   {rps=$2}
  /BytesPerSec/ {bps=$2}
  END { printf("busy=%s idle=%s rps=%.2f bps=%.0f\n", busy, idle, rps, bps) }
'
W większych środowiskach dodatkowo agreguję czasy według poszczególnych pracowników, przypisuję je do VHostów i obliczam Kwantyle w odniesieniu do czasów odpowiedzi. W ten sposób mogę stwierdzić, czy problemy dotyczą tylko części użytkowników, czy też większości z nich.
MPM i planowanie zdolności produkcyjnych
MPM określa, w jaki sposób Apache przetwarza połączenia; dane z Scoreboardu pokazują mi, czy czynnikiem ograniczającym są procesy, czy wątki Czynnik są. W celu doboru i optymalizacji porównuję zdarzenia i procesy robocze, mierzę czasy bezczynności, trwałość połączeń Keep-Alive oraz zmiany kontekstu. Zwięzłe porównanie przedstawia ten artykuł: Zdarzenie a pracownik MPM. Po wprowadzeniu zmian ponownie sprawdzam wskaźniki zajętości/bezczynności oraz liczbę żądań na sekundę, aby potwierdzić efekty. W ten sposób podejmuję decyzje w oparciu o dane i zwiększam Wydajność.
Płynne ponowne uruchomienie, wdrażanie stopniowe i konserwacja
W przypadku wdrożeń lub zmian konfiguracji najczęściej uruchamiam wdzięczny Wyłączam restart. Na tablicy wyników widzę to po wielu stanach G, gdy nowe procesy się uruchamiają, a stare płynnie się kończą. Planuję zmiany typu „rolling” tak, aby pozostała wystarczająca pojemność w stanie bezczynności: najpierw zmniejszam obciążenie, potem płynnie przeładowuję, a na końcu pozostałe węzły. Długotrwałe fazy G wskazują, że stare procesy czekają na powolne żądania – wówczas sprawdzam limity czasu i ustawienia Keep-Alive, aby skrócić czas przełączania.
Krok po kroku ku rzetelnej analizie
Włączam mod_status, zabezpieczam dostęp i włączam ExtendedStatus, aby móc wyświetlić wszystkie szczegóły otrzymuję. Następnie sprawdzam stronę HTML w przeglądarce i zapoznaję się z rzeczywistym rozkładem symboli. W kolejnym kroku włączam /server-status?auto do mojego systemu monitorowania i weryfikuję wskaźniki. Następnie optymalizuję kolejno: liczbę procesów roboczych, Keep-Alive, limity czasu, buforowanie i ścieżki aplikacji. Każdą zmianę ponownie mierzę, aż Req/s, czas odpowiedzi oraz wskaźniki zajętości/bezczynności ponownie znajdą się w Teren zielony kłamstwo.
Podsumowanie: Apache Scoreboard jako kompas
Apache Scoreboard zapewnia mi przejrzysty i gotowy do natychmiastowego wykorzystania wgląd w obciążenie, wąskie gardła oraz zachowanie Pracownik. Dzięki mod_status, ExtendedStatus i sprawnemu monitorowaniu przekształcam surowe dane w rzetelne decyzje. Symbole i wskaźniki pokazują, czy powinienem zwiększyć wydajność, skrócić limity czasu, czy też zająć się samą aplikacją. Niewielka zmiana w ustawieniach Keep-Alive lub MPM może przynieść ogromne efekty, jeśli dane są prawidłowe. Kto właściwie odczytuje sygnały, ten utrzyma Apache'a pod obciążeniem responsywny i możliwe do zaplanowania.


