Przejdź do treści

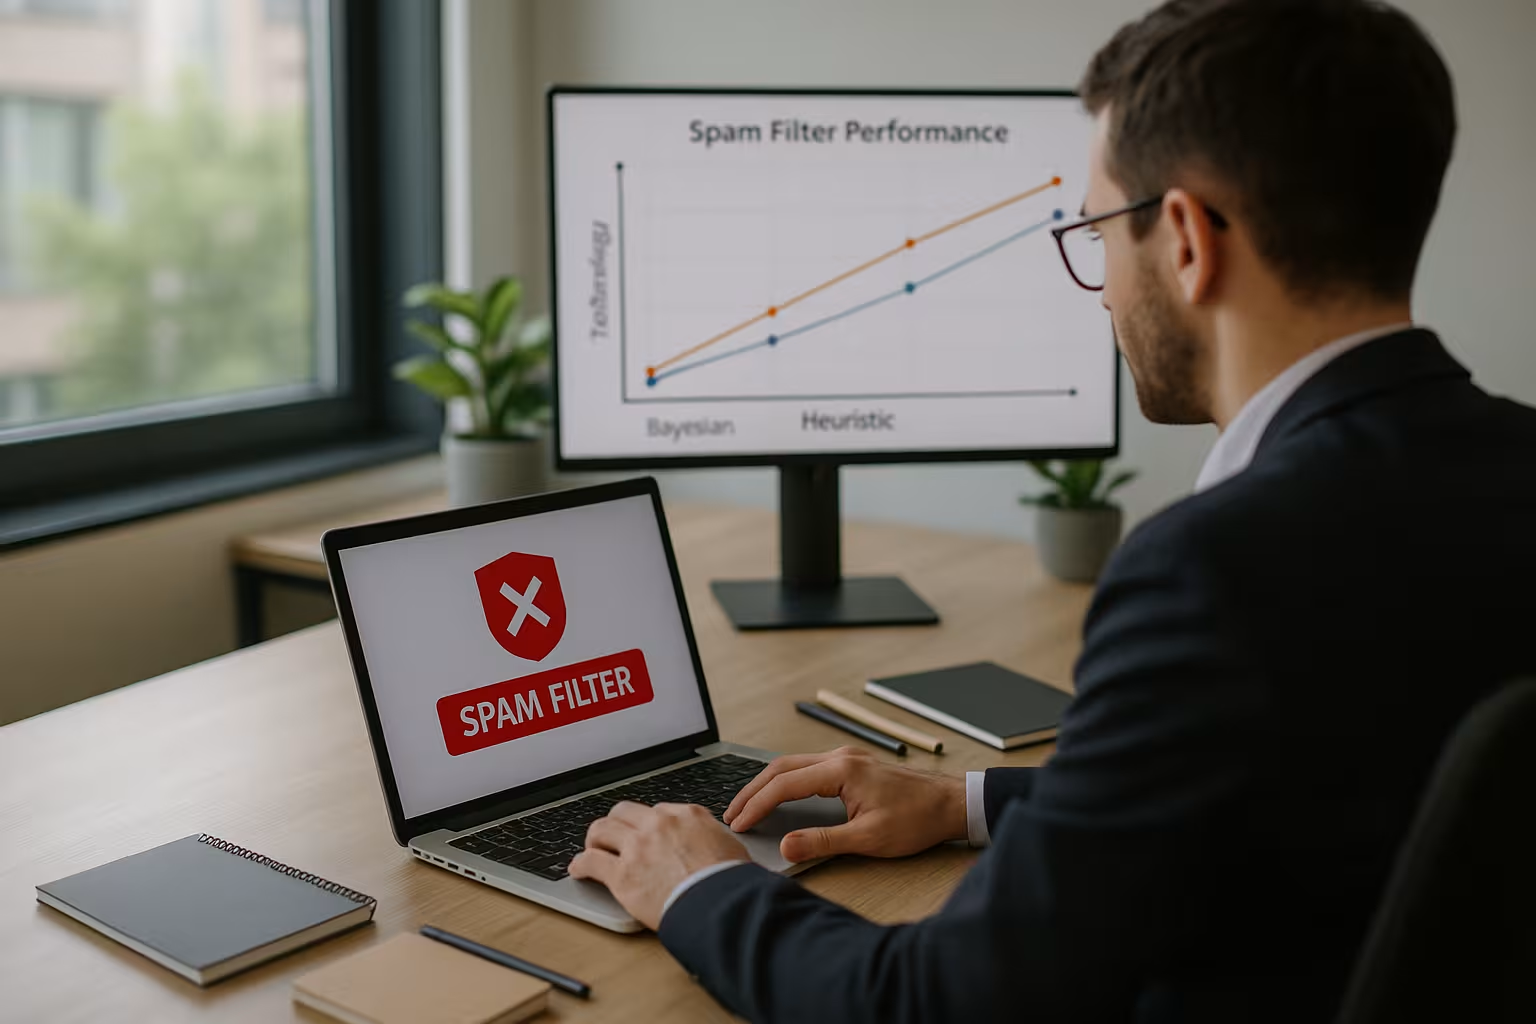
Profesjonalista hosting filtrów antyspamowych jest najbardziej niezawodne dzięki jasnemu zrozumieniu filtrów Bayesa i procesów heurystycznych, ponieważ te dwie technologie podejmują decyzje w zupełnie inny sposób. Pokażę w praktyczny sposób, jak działają oba podejścia, kiedy który filtr przynosi korzyści i jak hybrydowe stosy zmniejszają wskaźniki błędów i zapewniają dostarczanie legalnych wiadomości e-mail.
Punkty centralne
- Bayesian wykorzystuje prawdopodobieństwo, uczy się w sposób ciągły i dynamicznie dostosowuje punktację.
- Heurystyka pracuje z regułami, rozpoznaje wzorce i rozumie kontekst w wiadomościach.
- Połączenie z obu zwiększa wskaźnik wykrywalności i zmniejsza liczbę fałszywych alarmów w hostingu.
- ML zwiększa dokładność, ponieważ modele znajdują subtelne sygnały w dużych ilościach danych.
- PraktykaKluczowe dane, szkolenia, integracja i opóźnienia decydują o sukcesie.
Dlaczego wybór filtra ma znaczenie w hostingu
Spam kosztuje czas, reputację i często Pieniądze, Dlatego też specjalnie planuję i mierzę strategie filtrowania. Bezpieczeństwo poczty e-mail zaczyna się od kontroli nadawców, takich jak SPF, DKIM i DMARC, ale dobre wyniki osiągam tylko wtedy, gdy oceniam samą treść. To właśnie w tym miejscu sprawdzają się podejścia bayesowskie i heurystyczne, które chronią skrzynki pocztowe przed phishingiem, złośliwym oprogramowaniem i oszustwami. Uzupełniam te filtry technikami takimi jak Greylisting, aby rozbroić fale botów na wczesnym etapie i zmniejszyć obciążenie skanowania treści. Zdefiniowanie jasnych celów, progów i ścieżek informacji zwrotnych minimalizuje liczbę fałszywych alarmów i zwiększa jakość dostarczania dla legalnych botów. Wiadomości.
Filtry Bayesa: funkcjonalność i mocne strony
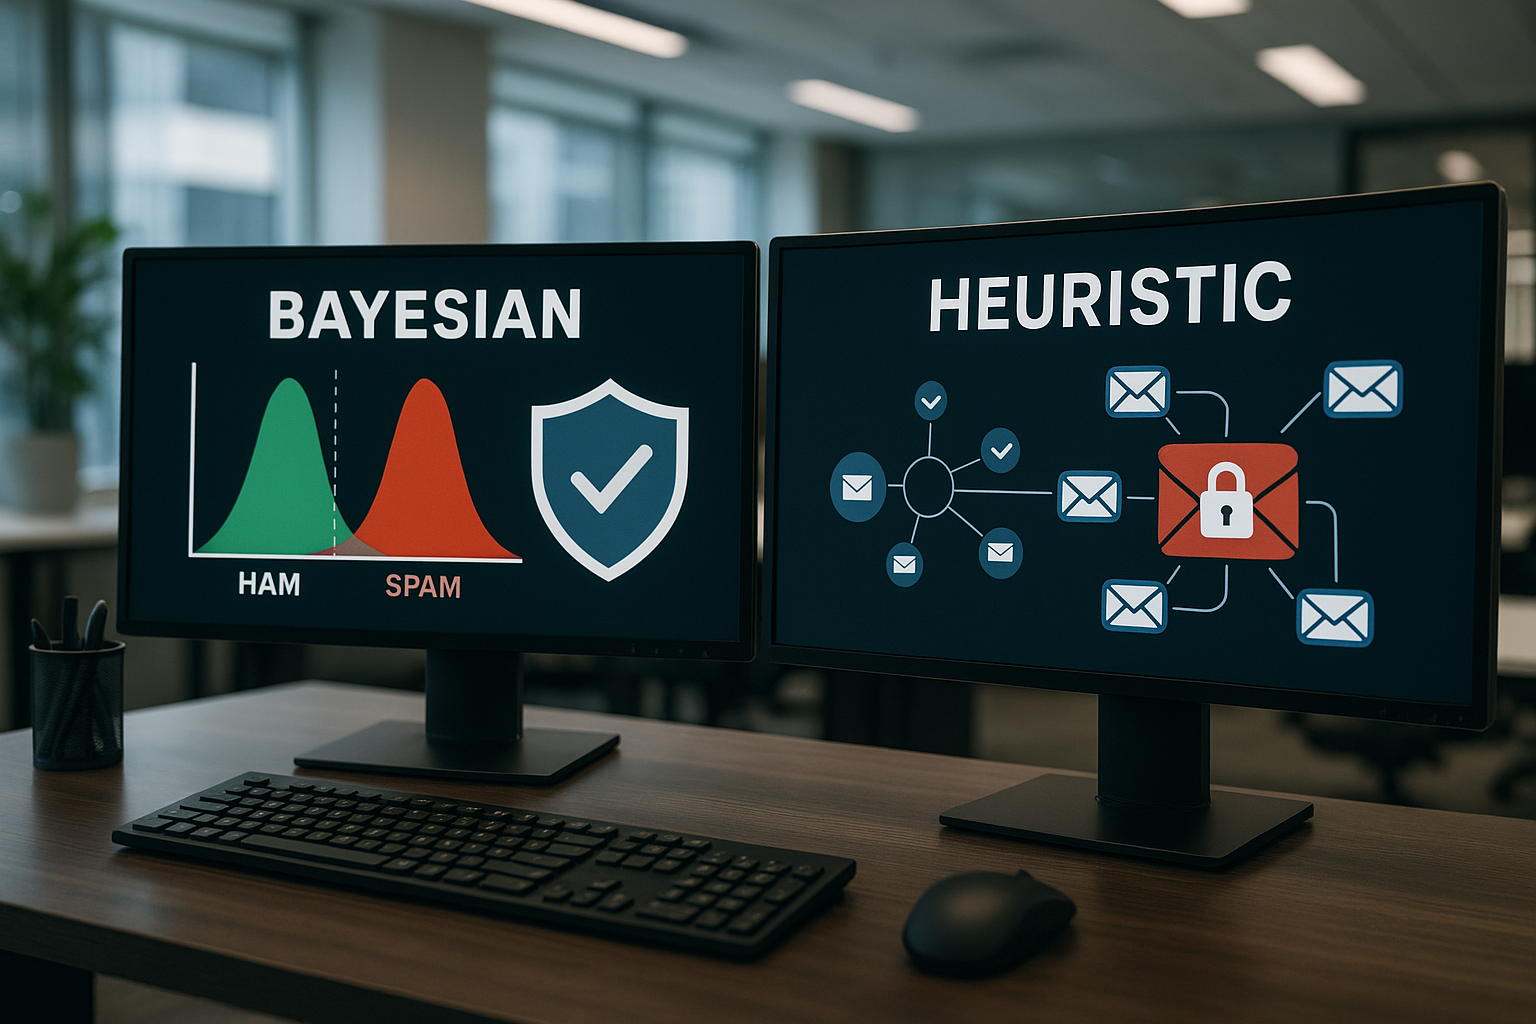
Filtr Bayesa ocenia słowa, części nagłówków i wzorce n-gramów w sposób probabilistyczny i oblicza wynik spamu, który mieści się w przedziale między 0 i 1. Trenuję model z czystymi przykładami spamu i spamu typu ham i szybko osiągam stabilne wskaźniki trafień, które poprawiają się z każdą odpowiedzią. W praktyce kilkaset oznaczonych wiadomości e-mail często wystarcza do podjęcia wiarygodnych decyzji, podczas gdy dalsze cykle szkoleniowe zapewniają dostrojenie. Narzędzia takie jak SpamAssassin lub Rspamd łączą funkcję Bayesa z innymi testami i zwracają ogólny wynik, który dostosowuję do każdego przepływu poczty. Jedną z zalet jest to, że Bayes często używa tylko kilku, szczególnie znaczących tokenów i dlatego może być używany wydajnie i efektywnie. szybki pozostaje.
Filtry heurystyczne: reguły, wzorce, kontekst
Filtry heurystyczne działają w oparciu o reguły i rozpoznają rzucające się w oczy wzorce, powtarzające się frazy i nietypową strukturę w treści. Tekst. Używam reguł dotyczących nadużywania adresów URL, sztuczek z zestawem znaków, pikseli śledzących, fałszywych nazw nadawców lub manipulacyjnych tematów. Dobra heurystyka sprawdza kontekst: samo słowo takie jak “oferta” nie wywołuje alarmu, dopiero nagromadzenie, osadzenie i metadane zapewniają wiarygodne wskazanie. Rozwiązania takie jak wielowarstwowe skanery z heurystyką analizują części wiadomości oddzielnie i łączą punkty w wynik. Wysiłek związany jest z regularną konserwacją, ale utrzymuję ją w ryzach, dokumentując centralnie częste wzorce i wysyłając aktualizacje w jasny sposób. Cykle roll out.
Bezpośrednie porównanie: praktyczne wartości dla hostingu
Obie technologie zapewniają dobre wyniki, ale różnią się znacznie pod względem szkoleń, konserwacji i obciążenia obliczeniowego. Decyduję, jak ustawić wagę w zależności od typu skrzynki pocztowej, profilu ruchu i tolerancji ryzyka. W przypadku marketingowych skrzynek pocztowych preferuję dobrze wyszkolone modele bayesowskie, podczas gdy w przypadku skrzynek administratorów aktywuję bardziej rygorystyczną heurystykę. Równowaga pozostaje ważna: zbyt rygorystyczne reguły zwiększają liczbę fałszywych alarmów, podczas gdy zbyt luźne wyniki przepuszczają spam. Poniższa tabela podsumowuje najważniejsze punkty w praktyczny sposób i służy mi jako przewodnik. Przewodnik.
| Kryterium | Filtr Bayesa | Filtr heurystyczny |
|---|---|---|
| Zasada działania | Prawdopodobieństwo za pomocą tokenów/funkcji | Zasady, wzorce, kontekst |
| Zdolność uczenia się | Wysoki poziom ciągłego uczenia się | Ograniczone, konieczne aktualizacje zasad |
| Wysiłek szkoleniowy | Umiarkowane (kilkaset przykładów) | Wyższe (projekt zasad i testów) |
| Szybkość adaptacji | Szybko dzięki nowym opiniom | W zależności od cykli wydawniczych |
| Zrozumienie kontekstu | Pośrednio poprzez częstotliwości | Bezpośrednio poprzez logikę opartą na regułach |
| Wskaźnik wyników fałszywie dodatnich | Niski przy dobrym wyszkoleniu | Zmienna w zależności od jakości kontroli |
| Intensywność obliczeń | W większości umiarkowany | Wyższy w zależności od dogłębnej analizy |
| Typowe narzędzia | Rspamd, SpamAssassin | Skanery wielowarstwowe, silniki polityki |
Podejścia hybrydowe: Najlepsze wyniki w połączeniu
Polegam na potokach, które najpierw przeprowadzają twarde kontrole nagłówków i transportu, a następnie stosują heurystykę i ostatecznie obliczają wynik bayesowski. losowanie. W ten sposób wcześnie blokuję czysty spam, utrzymuję niskie obciążenie obliczeniowe i zyskuję moc uczenia bayesowskiego dla przypadków granicznych. W przypadku powtarzających się legalnych kampanii, trenuję Bayesa z przykładami “Ham”, aby takie wiadomości nie trafiały już do obszaru granicznego. W przypadku bieżących fal spamu używam dodatkowej heurystyki, którą ponownie dezaktywuję po ich ustąpieniu. W ten sposób stos pozostaje elastyczny, a wskaźniki dostarczalności i zadowolenie użytkowników pozostają niezmienione. wzrost.
Uczenie maszynowe w stosie filtrów antyspamowych
Poza modelami Bayesa korzystam z modeli uczenia maszynowego, które łączą cechy nagłówków, treści, linków, typów załączników i wzorców czasowych. połączenie. Gradient boosting, regresja logistyczna lub lekkie sieci neuronowe dostarczają dodatkowych sygnałów, które uwzględniam w ogólnej punktacji. Takie modele odkrywają wzorce, które trudno byłoby sformułować ręcznie i szybciej reagują na nowe fale. Jednocześnie przejrzystość pozostaje ważna, więc rejestruję wkład funkcji i oferuję użytkownikom krótkie wyjaśnienia podjętych decyzji. Utrzymuję lekkie modele, aby opóźnienia w ścieżce SMTP nie były zbyt duże. wzrasta.
Wdrożenie w hostingu: praktyczny przewodnik
Zaczynam od domeny testowej, zbieram ruch, mierzę podstawowe wartości, a następnie stopniowo wprowadzam reguły i trening bayesowski, dzięki czemu mogę wyraźnie rozpoznać efekty. zob.. Foldery kwarantanny, tagowanie nagłówków i jasne zasady SRS/ARC pomagają mi podejmować zrozumiałe decyzje. Użytkownicy otrzymują zwięzłe instrukcje dotyczące białych/czarnych list, folderów szkoleniowych i funkcji raportowania, dzięki czemu informacje zwrotne w sposób przejrzysty wpływają na szkolenie. Dla administratorów dokumentuję zmiany reguł i wartości progowe, aby konserwacja była powtarzalna. Jeśli potrzebujesz pomocy z konfiguracją, możesz zacząć od kompaktowego rozwiązania Przewodnik po wyposażeniu szybko i skraca czas uruchamiania własnych Testy.
Kluczowe liczby i tuning: jak mierzyć sukces?
Porównuję współczynnik wykrywalności, wyniki fałszywie dodatnie, fałszywie ujemne i jakość dostarczania według typu poczty, aby podejmować ostateczne decyzje. spotkanie. Ważne jest, aby mieć jasny przepływ pracy dla skarg, tak aby legalne wiadomości e-mail były oznaczane z kwarantanny i wykorzystywane do szkolenia. W przypadkach granicznych minimalnie obniżam próg punktacji i kompensuję go bardziej rygorystycznymi regułami dla niebezpiecznych wzorców, takich jak archiwa EXE lub Unicode spoofing. Dzienniki i pulpity nawigacyjne pokazują mi trendy, dzięki czemu mogę rozpoznać nowe fale, zanim liczba skarg wzrośnie. Zwięźle dokumentuję każdą zmianę, testuję ją w fazie przejściowej i wdrażam po zatwierdzeniu. szeroki od.
Skalowanie i opóźnienia w codziennej pracy
Wysoka przepustowość poczty wymaga wydajnych łańcuchów filtrów, dlatego też umieszczam drogie analizy z opóźnieniem i buforuje repeatery za pomocą odcisków palców i reputacji przed. Równoległe przetwarzanie, asynchroniczne sprawdzanie adresów URL i limity szybkości na nadawcę utrzymują opóźnienia na niskim poziomie. Mierzę TTFD (Time To First Decision) i TTR (Time To Resolve Quarantine), ponieważ użytkownicy zauważalnie reagują na opóźnienia. W przypadku biuletynów masowych planuję reguły białej listy powiązane z DKIM i stabilnym adresem IP wysyłającego, aby regularna poczta biznesowa nie zatrzymywała się. Ci, którzy korzystają z hostingu współdzielonego, korzystają z przejrzystych profili dla każdego klienta i opcjonalnych ustawień wstępnych, takich jak Filtr antyspamowy All-Inkl, szybka obsługa standardowych przypadków do pokrycia.
Prawo, ochrona danych i przejrzystość
Przetwarzam wiadomości e-mail zgodnie z zasadą minimum i usuwam dane szkoleniowe, gdy tylko spełnią one swój cel. spełnienie. Ustalam krótkie okresy przechowywania logów i anonimizuję je tam, gdzie to możliwe, zwłaszcza w przypadku adresów IP lub osobistych nagłówków. Użytkownicy otrzymują jasne informacje na temat tego, jakie dane gromadzi system, w jakim celu i w jaki sposób mogą usunąć dane treningowe. Na żądanie dokumentuję wynik, zastosowane reguły i źródło szkolenia, aby decyzje pozostały identyfikowalne. Ta przejrzystość buduje zaufanie i zmniejsza liczbę zapytań do Wsparcie.
Typowe przeszkody i sposoby ich unikania
Częstym błędem są niezrównoważone dane treningowe, które sprawiają, że algorytm Bayesa jest zbyt twardy lub zbyt miękki. marka. Dlatego regularnie sprawdzam, czy przykłady ham/spam są aktualne i usuwam stare kampanie, które nie są już dziś istotne. Zbyt agresywna heurystyka spowalnia legalne newslettery, więc stosuję twarde reguły kontekstowe, takie jak uwierzytelnianie i reputacja nadawcy. Monitoruję również typy załączników, ponieważ nowe formaty archiwów mogą omijać wykrywanie, a następnie szybko wymagać nowych reguł. Prosty, cotygodniowy cykl przeglądu utrzymuje wysoką jakość i zmniejsza ryzyko błędów. Ryzyko kosztownych fałszywych alarmów.
Normalizacja treści i różnorodność językowa
Zanim jeszcze filtry podejmą wiarygodne decyzje, konsekwentnie normalizuję zawartość: HTML jest konwertowany na renderowany tekst, bloki CSS/stylu są usuwane, Base64 i cytowane sekcje drukowalne są dekodowane w czysty sposób. Normalizuję Unicode (np. NFKC), aby identyczne wizualnie znaki były również uważane za identyczne, i usuwam znaki o zerowej szerokości, które spamerzy lubią wykorzystywać do dekompozycji tokenów. Wiarygodne tokeny mają kluczowe znaczenie dla algorytmu Bayesa: w zależności od języka, uzupełniam tokenizację słów n-gramami znaków, aby objąć ukrytą pisownię (An.ge.b.ot) i języki bez wyraźnych granic słów. Ostrożnie używam filtrów stemming i stopword, aby uzyskać semantycznie istotne tokeny bez tworzenia niejednoznacznych terminów. rozcieńczony. Tworzy to solidną bazę funkcji, która przynosi korzyści zarówno Bayesowi, jak i heurystyce - niezależnie od tego, czy tekst jest napisany w języku niemieckim, angielskim czy mieszanym.
Taktyki unikania i środki zaradcze
Spamerzy łączą kilka sztuczek: e-maile zawierające tylko obrazy z niewielką ilością tekstu, domeny homoglificzne (paypaI vs. paypal), niewidoczne znaki, zagnieżdżone struktury MIME lub agresywne przekierowania adresów URL. Przeciwdziałam temu za pomocą renderowania HTML na tekst, wykrywania niedopasowania (temat/język treści, typ treści a rzeczywista treść) oraz reguł dotyczących łańcuchów skracaczy, parametrów śledzenia i spoofingu Unicode. W przypadku wiadomości e-mail zawierających obrazy oceniam metadane, teksty ALT, rozmiary obrazów i anomalie układu; proste sygnały OCR są często wystarczające bez przekraczania opóźnień. Sprawdzanie nieprawidłowych granic, zduplikowanych nagłówków, niespójnych deklaracji zestawu znaków i niebezpiecznych kontenerów załączników pomaga w walce z oszustwami MIME. Te środki zaradcze są modułowe, dzięki czemu mogę je tymczasowo zwiększać lub zmniejszać w zależności od fali. zamknięty.
Architektura w stosie MTA
W potoku dokonuję ścisłego rozróżnienia między poziomem SMTP (SPF/DKIM/DMARC, greylisting, limity stawek) a skanowaniem treści. Integruję filtry jako milter/proxy lub downstream “after-queue”, w zależności od tego, czy decyzje muszą być podejmowane inline, czy mogą być tolerowane z niewielkim opóźnieniem. Oddzielam Rspamd-Worker od instancji MTA i utrzymuję Redis jako wysokowydajną pamięć dla skrótów Bayesa, reputacji i pamięci podręcznych. Ściśle reguluję timeouty i backpressure: jeśli zewnętrzna usługa zawiedzie, wolę dostarczyć ją z konserwatywnymi wartościami domyślnymi lub tymczasowo odpowiedzieć 4xx, zamiast pozwolić kolejce rosnąć w nieskończoność. Aktualizacje kroczące, hosty kanaryjskie i flagi funkcji pozwalają mi na wprowadzanie zmian bez ryzyka. Działanie na żywo.
Kwarantanna, UX i pętle sprzężenia zwrotnego
Dobra technologia jest mało przydatna bez odpowiednich wskazówek dla użytkownika. Wysyłam podsumowania kwarantanny, których wydanie automatycznie uruchamia ponowną ocenę i opcjonalne szkolenie bayesowskie jako “Ham”. Do każdej wiadomości dodaję nagłówki wyjaśniające (np. wynik i najważniejsze sygnały), aby użytkownicy i pomoc techniczna mogli zrozumieć podejmowane decyzje. W przypadku informacji zwrotnych używam dedykowanych folderów IMAP (spam/ham learning), opcjonalnych reguł sita do automatycznego przesuwania i przycisków raportowania z ograniczoną szybkością, aby uniknąć nadużyć i zatruwania danych. Ważne: Opinie użytkowników nie przepływają w sposób niekontrolowany do wszystkich klientów, ale przede wszystkim szkolą lokalne profile najemców i dopiero po przejrzeniu profili globalnych. Modele.
Pomiar i optymalizacja poza wartościami podstawowymi
Oprócz dokładności i wskaźnika wykrywalności, oceniam precyzję/odzyskiwalność, a w szczególności koszty na klasę błędów. W wielu środowiskach fałszywie dodatni wynik jest znacznie droższy niż fałszywie ujemny; w związku z tym optymalizuję próg w sposób świadomy kosztów zamiast wyłącznie pod kątem maksymalnej łącznej liczby trafień. Ponieważ wskaźniki bazowe spamu ulegają wahaniom, kontroluję efekt wskaźnika bazowego i kalibruję wyniki tak, aby wartość 0,9 naprawdę odpowiadała wysokiemu prawdopodobieństwu spamu. Wdrożenia w trybie cienia dostarczają mi danych porównawczych bez ryzyka; testy A/B z zestawami wstrzymującymi pokazują, czy zmiana reguły jest mierzalnie lepsza, czy tylko inna. Przedziały ufności i kontrole dryfu uniemożliwiają mi reagowanie na krótkie wartości odstające. reagować.
Wysoka dostępność i odzyskiwanie danych
Obsługuję węzły skanowania bezstanowo za load balancerem, cache i dane bayesowskie są przechowywane redundantnie w szybkim magazynie klucz-wartość. Migawki i krótkie TTL dla tokenów chronią przed uszkodzeniem i ułatwiają wycofywanie. Podczas aktualizacji upewniam się, że bazy danych tokenów są kompatybilne, modele wersji i mam gotowy scenariusz downgrade. Jeśli część potoku ulegnie awarii (np. URL Intel), stos przełącza się na profile degradacji: bardziej konserwatywne progi, mniej kosztowne kontrole, przejrzysta telemetria. W sytuacji awaryjnej mogę tymczasowo pominąć skanowanie zawartości bez utraty poziomu transportu, kwarantanny i rejestrowania - dzięki temu zaległości są niewielkie, a Operacje biznesowe stabilny.
Możliwości, profile i role wielu klientów
Różne profile ryzyka są regułą w środowisku hostingowym. Zapewniam ustawienia wstępne dla każdego klienta (ścisłe, zrównoważone, tolerancyjne) i łączę je z uprawnieniami opartymi na rolach: Administratorzy kontrolują progi, użytkownicy utrzymują białe/czarne listy i foldery szkoleniowe. Izolacja dzierżawców zapobiega “wyciekaniu” danych szkoleniowych między klientami. W przypadku wrażliwych sektorów (np. finansów lub opieki zdrowotnej) definiuję bardziej restrykcyjne wyjątki dotyczące załączników, surowsze wymagania dotyczące uwierzytelniania i węższe tolerancje dla niedopasowania domen. Dokumentuję te profile w przejrzysty sposób, aby wsparcie i klienci mogli Oczekiwania wiedzieć.
Obsługa, zarządzanie i dokumentacja
Reguły, modele i wyniki są częścią kontrolowanego procesu zmian. Pracuję z notami wydania, flagami funkcji, oknami konserwacji i jasnymi ścieżkami wycofania. Dzienniki audytu śledzą zmiany reguł i modeli, dzięki czemu mogę udowodnić, dlaczego podjęto daną decyzję w przypadku reklamacji. Na co dzień prowadzę krótki playbook: jak przetwarzane są informacje zwrotne, kto zmienia progi, które wskaźniki są sprawdzane codziennie, co tydzień i co miesiąc oraz kiedy wypuszczam wersję od etapu do produktu. Ta dyscyplina zapobiega niekontrolowanemu wzrostowi i zapewnia, że ulepszenia są powtarzalne i trwałe. pobyt.
Ocena końcowa
Filtry Bayesa zapewniają adaptacyjne punkty scoringowe, heurystyki wnoszą silną wiedzę kontekstową, a razem tworzą najbardziej efektywny system scoringowy. Ochrona w codziennym hostingu. Polegam na rozłożonym w czasie potoku, jasnych kluczowych danych, krótkich ścieżkach informacji zwrotnych i lekkich modelach ML dla dodatkowych sygnałów. Dzięki temu wskaźniki wykrywalności są wysokie, liczba fałszywych alarmów niska, a zadowolenie użytkowników stabilne. Jeśli pracujesz z dyscypliną szkoleniową, udokumentowanymi regułami i czystą integracją, osiągniesz niezawodne dostarczanie i niskie opóźnienia w dłuższej perspektywie. To właśnie ta kombinacja sprawia, że profesjonalny hosting filtrów antyspamowych jest niezawodny, kontrolowany i dobry zarówno dla administratorów, jak i użytkowników końcowych sterowalny.