
Raporty CloudLinux wyraźnie pokazują mi, jakie limity LVE dotyczą poszczególnych kont oraz gdzie faktycznie występują spowolnienia związane z procesorem, pamięcią, operacjami wejścia/wyjścia lub procesami wejściowymi. Analizuję te dane w sposób ukierunkowany, aby wykrywać powtarzające się awarie, dzienne wzorce i nagłe wąskie gardła, a następnie wyciągać z nich konkretne wnioski dotyczące optymalizacji.
Punkty centralne
Poniższe punkty podsumuję na wstępie, abyś mógł od razu przystąpić do analizy.
- Wskaźniki LVE przeczytaj poprawnie: SPEED, MEM, IO, IOPS, PNO, EP
- Dane na żywo sprawdzić za pomocą LVE Manager i lvetop
- Przebieg za pośrednictwem lveinfo, lvechart, cloudlinux-statistics
- Usterki ustalenie priorytetów: częstotliwość, moment wystąpienia, przyczyna
- Środki wyliczyć dla procesora, pamięci RAM, wejścia/wyjścia i EP
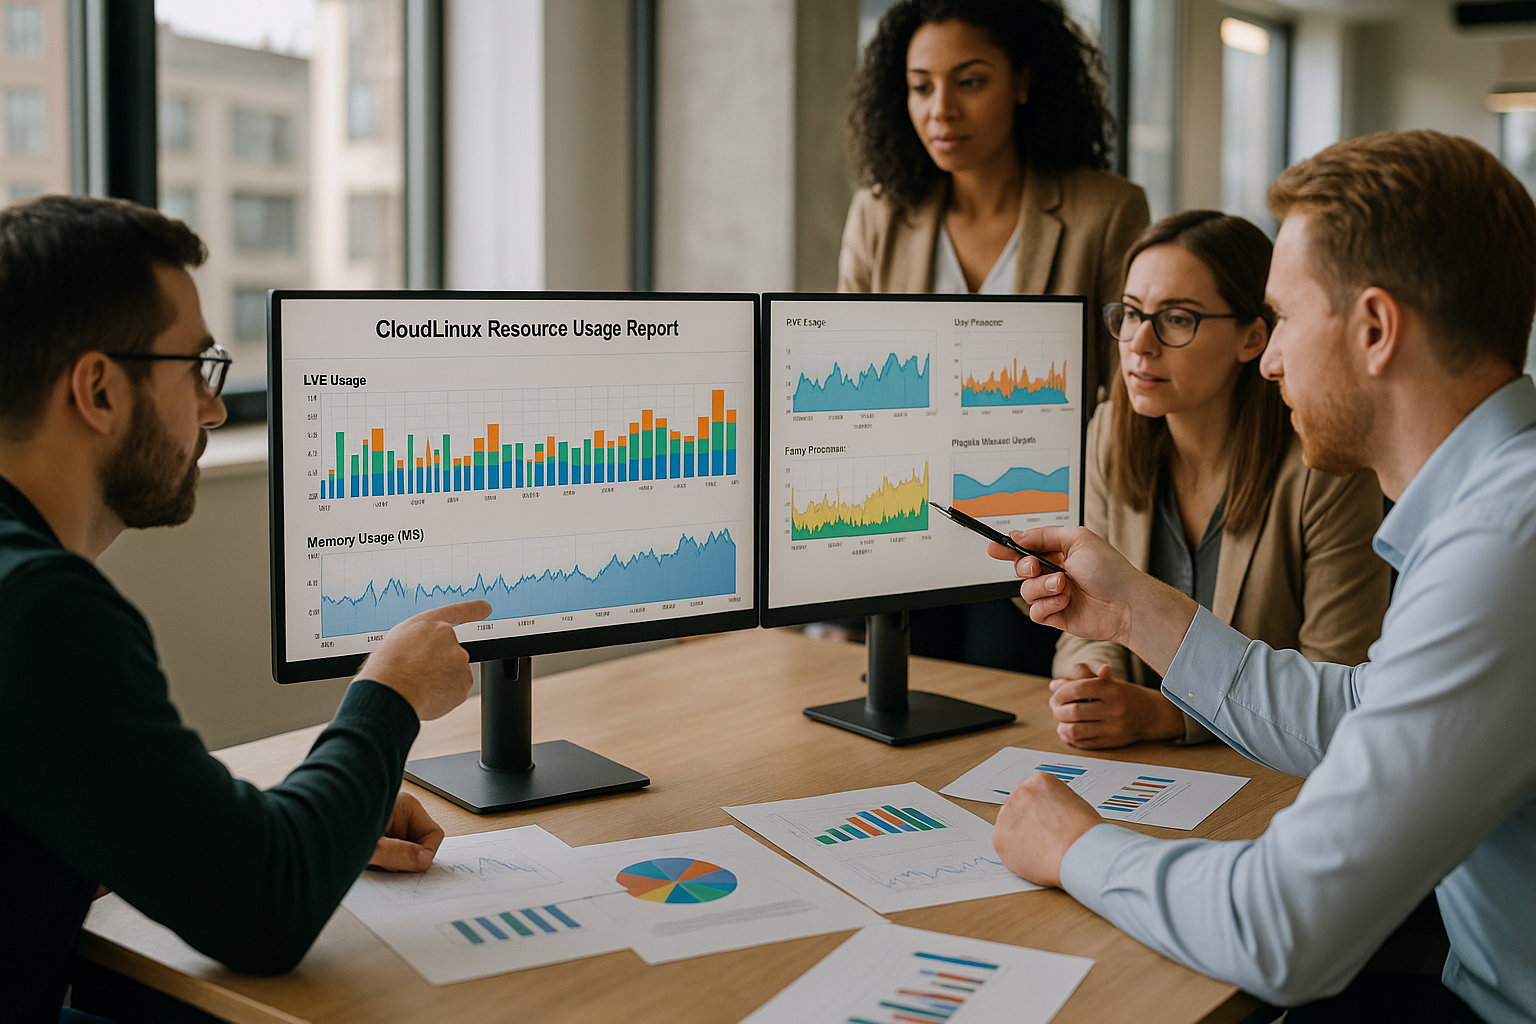
Jak interpretować właściwe wskaźniki: SPEED, MEM, IO, IOPS, PNO, EP
Każdą analizę rozpoczynam od Kluczowe dane, które CloudLinux wyświetla w kontekście LVE. SPEED opisuje przydzieloną moc obliczeniową procesora, MEM oznacza zużycie pamięci RAM, IO przepustowość danych, a IOPS liczbę operacji wejścia/wyjścia. PNO pokazuje całkowitą liczbę uruchomionych procesów, a EP – liczbę równoczesnych procesów wejściowych, które ograniczają dostęp do sieci. Jeśli obserwuje się stale wysokie wartości, zazwyczaj nie jest to problem krótkotrwałych szczytów, lecz strukturalny profil obciążenia. Zawsze sprawdzam przy tym, czy limity są osiągane w sposób ciągły, czy też występują jedynie pojedyncze skoki, które można wyjaśnić bez konieczności stosowania dławienia.
| Kluczowa liczba | Znaczenie | Typowe objawy | Pierwsze kontrole |
|---|---|---|---|
| SPEED | Wydajność procesora (udział/limit) | Długie czasy wykonywania kodu PHP, przekroczenia limitów czasu | Sprawdź profile PHP, pamięć podręczną opcode i buforowanie |
| MEM | Pamięć robocza na konto | Zabójstwa OOM, błąd 500 pod obciążeniem | Sprawdzanie wartości memory_limit w PHP, wtyczek i zapytań |
| IO | Przepustowość w MB/s | Powolne pobieranie/wysyłanie | Pamięć podręczna statyczna, kompresja multimediów, pamięć masowa |
| IOPS | Liczba operacji wejścia/wyjścia | Powolny dostęp do bazy danych/plików | Indeksy, plan zapytania, pamięć podręczna obiektów |
| PNO | Procesy ogólne | Zwiększone obciążenie serwera | Nadwyżki procesów daemonów/cronów, limity procesów roboczych |
| EP | Jednoczesne wejścia na stronę | Błąd 503 w Peaks | Sprawdź pamięć podręczną HTTP, limity przepustowości i boty |
Monitorowanie na żywo za pomocą LVE Manager i lvetop
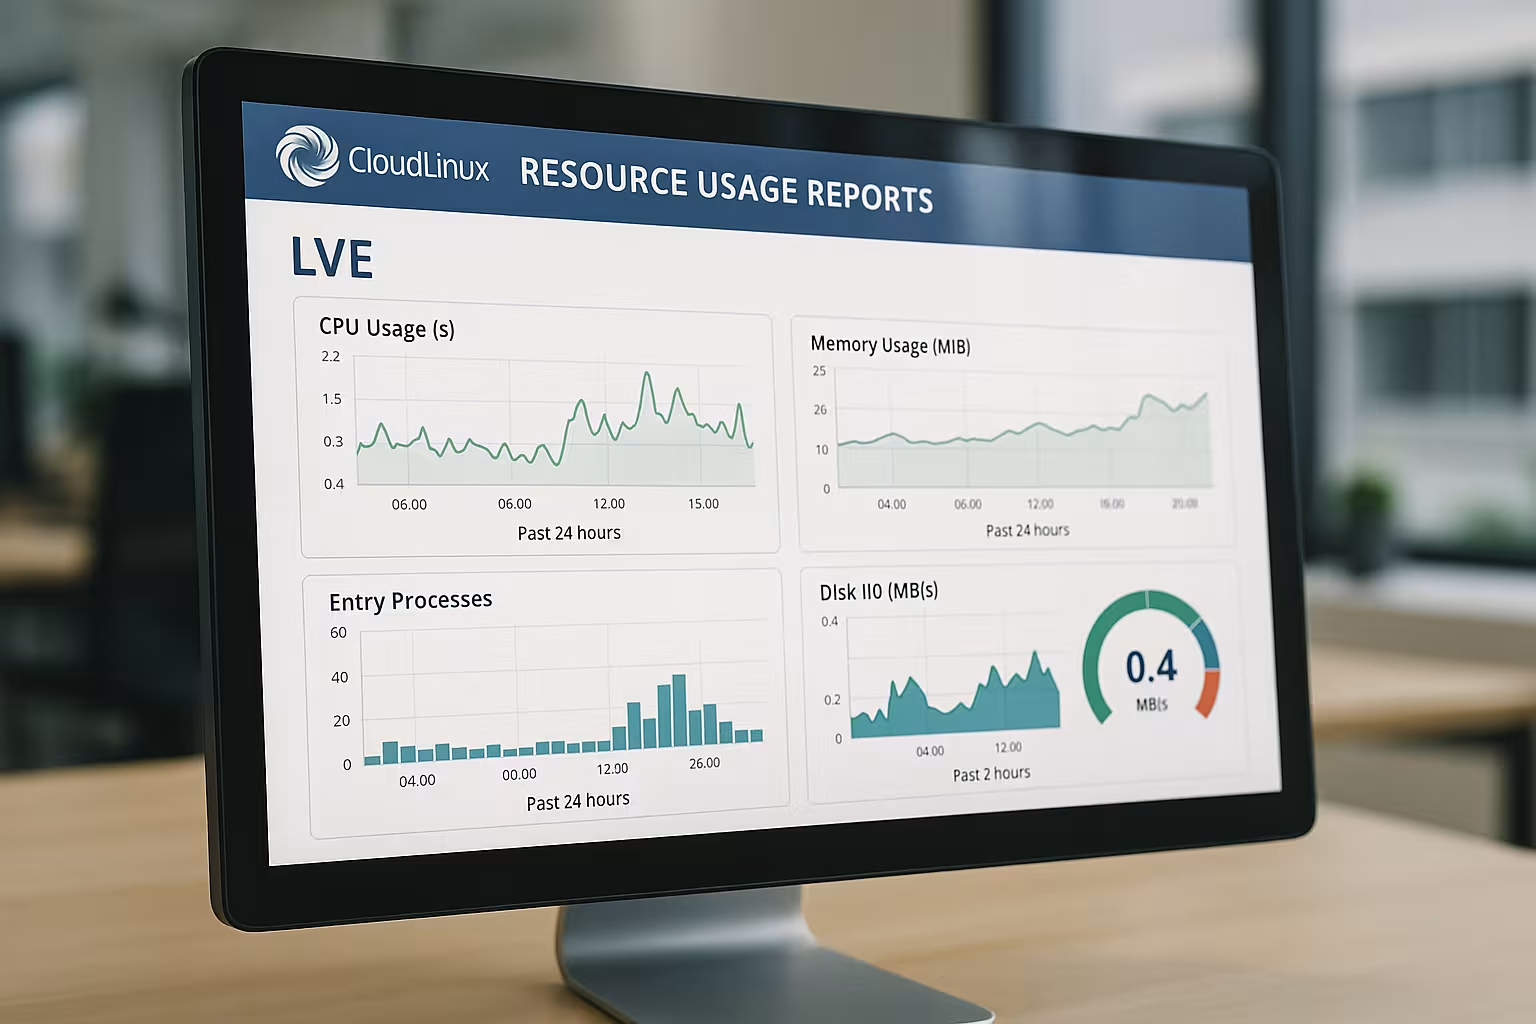
Do analiz doraźnych korzystam z Dane na żywo w menedżerze LVE oraz w lvetop w powłoce. Widok „Current Usage” pokazuje mi w czasie rzeczywistym, jak działają procesor, pamięć RAM, operacje wejścia/wyjścia, IOPS, procesy oraz procesy wejściowe. Podczas skoków obciążenia obserwuję, czy jako pierwsze osiągną limit EP czy SPEED, ponieważ ma to wpływ na kolejne kroki. lvetop nadaje się do natychmiastowego wyfiltrowania kont generujących największe obciążenie oraz, w razie potrzeby, do ich ograniczenia lub optymalizacji. Kto chce zagłębić się w interfejs, może precyzyjnie dostosować limity i widoki – ja chętnie korzystam w tym celu z tego przewodnika: Konfiguracja programu LVE Manager.
Analiza historyczna: lveinfo, lvechart i cloudlinux-statistics
Trendy rozpoznaję dzięki Przebieg oraz historię błędów, a nie tylko migawki. Dzięki lveinfo wyznaczam przedziały czasowe i widzę, kiedy dokładnie zadziałały limity oraz jak często to miało miejsce. lvechart dostarcza mi wizualne wykresy szczytów w ujęciu godzinowym lub dziennym, dzięki czemu widoczne stają się wzorce występujące w ciągu dnia. cloudlinux-statistics uzupełnia analizę, gdy potrzebuję dłuższych szeregów czasowych dla poszczególnych kont. Dzięki połączeniu tych narzędzi uzyskuję odpowiedzi na pytania „kiedy“, „jak często“ i „w jakich warunkach“ pojawiają się obciążenia.
Zrozumienie i ustalenie priorytetów błędów
Słowo „Fault” oznacza: To Limit została osiągnięta, a CloudLinux ograniczył przepustowość. Dlatego sortuję błędy najpierw według częstotliwości, a następnie według rodzaju zasobów i pory dnia. Codzienne błędy EP pojawiające się w porze obiadowej często wskazują na szczyty ruchu lub boty, podczas gdy nocne błędy pamięci RAM są raczej związane z zadaniami cron i tworzeniem kopii zapasowych. Jeśli pojawia się wiele błędów związanych z procesorem, szukam nieefektywnych procedur PHP, uszkodzonych pamięci podręcznych lub zadań, które nie zostały zatrzymane. Taka klasyfikacja pozwala zaoszczędzić czas, ponieważ mogę wprowadzać optymalizacje dokładnie tam, gdzie użytkownicy odczuwają wyraźne ograniczenia.
Wnioskowanie o przyczynach: typowe schematy i środki zaradcze
Na podstawie doświadczenia klasyfikuję Próbka szybko wskazuje konkretne przyczyny. Trwale wysokie wartości EP wskazują na zbyt dużą liczbę jednoczesnych żądań lub brak buforowania brzegowego. Utrzymujące się wysokie zużycie pamięci RAM często wskazuje na wtyczki, motywy lub procesy powodujące wyciek pamięci. Szczyty wartości IO i IOPS wskazują na zadania wymagające intensywnego przetwarzania danych, zapytania bez indeksowania lub dużą liczbę operacji na małych plikach. Aby uniknąć błędnych interpretacji, równolegle sprawdzam wskaźniki kondycji systemu – szybki wgląd zapewniają Kontrole stanu systemu CloudLinux.
Rozpoznawanie zadań cron, kopii zapasowych i botów
Wiele seriali z gatunku „Fault” można wyjaśnić, przyglądając się Punkty w czasie i zadania. Jeśli ograniczenie przepustowości pojawia się zawsze tuż po pełnej godzinie, często oznacza to, że zadania cronowe działają równolegle i konkurują z użytkownikami. Powtarzające się szczyty w nocy często wskazują na tworzenie kopii zapasowych, które maksymalnie obciążają operacje wejścia/wyjścia (I/O) i IOPS. Rzucające się w oczy błędy EP bez odpowiadającego im ruchu w narzędziach analitycznych często wskazują na boty lub programy scraperujące, które omijają treści statyczne. W takich przypadkach ustalam limity szybkości, przenoszę zadania na spokojniejsze przedziały czasowe i konsekwentnie aktywuję pamięć podręczną brzegową lub pamięć podręczną strony.
Analiza danych według sprzedawcy i konta
W większych konfiguracjach oddzielam Poziomy przejrzyście: dystrybutorzy, ich klienci oraz poszczególne konta. Menedżer LVE zapewnia właśnie taki wgląd i pokazuje mi, która podstruktura wpływa na limity. Dzięki temu mogę rozpoznać, czy to pojedynczy klient budzi wątpliwości, czy też na limity jednocześnie wpływają liczne projekty w ramach struktury dystrybutora. W przypadku procesów wsparcia technicznego zaznaczam odpowiednie konta i definiuję działania, dzięki czemu powtarzające się zgłoszenia są rozwiązywane szybciej. Ta przejrzystość pomaga w sprawiedliwym rozdzielaniu zasobów i zapewnieniu przejrzystości kosztów dla poszczególnych klientów.
Prawidłowe ustalenie wartości granicznych i dostosowanie taryf
To ja wyznaczam granice Realistyczny, a nie na maksimum. Zbyt wąskie granice EP powodują błędy 503, podczas gdy zbyt niskie wartości SPEED opóźniają każdą odpowiedź PHP. Kto regularnie napotyka błędy, powinien najpierw sprawdzić możliwości optymalizacji, a dopiero potem taryfy. Gdy projekty stają się kluczowe dla działalności, warto wybrać wyższy profil, który wygładza szczyty i zapewnia stabilność. Dokumentuję efekty na wykresach historycznych, aby decyzja była zrozumiała.
Projekty oparte na bazach danych: optymalizacja operacji wejścia/wyjścia (I/O) i IOPS
W przypadku stron opartych na bazach danych sprawdzam IOPS a operacje wejścia/wyjścia (IO) zawsze idą w parze z jakością zapytań. Wiele małych zapytań bez indeksów generuje wysoką liczbę operacji IOPS i wydłuża czas odpowiedzi. Z doświadczenia wynika, że pamięć podręczna obiektów, buforowanie zapytań i dostosowane indeksy znacznie ograniczają tę lawinę zapytań. W celu analizy trendów dodatkowo przeglądam raporty bazy danych i porównuję je z przebiegami LVE. Solidne wprowadzenie do tematu zapewnia mi ten przewodnik dotyczący Raporty MySQL Governor, aby prawidłowo sklasyfikować obciążenie bazy danych.
Podręcznik monitorowania: od alarmu do działania
Na podstawie odczytów tworzę Podręcznik taktyczny, który jasno przedstawia każdy przypadek eskalacji. Krok 1: Sprawdzić w czasie rzeczywistym, czy obecnie obowiązują limity i który zasób ulegnie wyczerpaniu jako pierwszy. Krok 2: Otworzyć historię, dopasować przedział czasowy i zaznaczyć powtórzenia. Krok 3: Zlokalizuj przyczynę – ścieżka kodu, pamięć podręczna, baza danych, cron, bot – i zdefiniuj środek zaradczy wraz z kryterium testowym. Krok 4: Po podjęciu działań ponownie sprawdź w środowisku produkcyjnym i w historii, czy liczba błędów i opóźnienia uległy zmniejszeniu. Ta ustalona kolejność pozwala uniknąć działanie pod wpływem emocji i zapewnia powtarzalne wyniki.
Prawidłowa interpretacja wzajemnych zależności między limitami
W praktyce limity rzadko działają w izolacji. Dlatego oceniam Wzajemne oddziaływania między EP, SPEED, MEM i IO/IOPS: jeśli EP i SPEED rosną jednocześnie, ograniczeniem jest zazwyczaj procesor na żądanie; jeśli w takiej sytuacji pomocna jest pamięć podręczna strony lub krawędziowa, oba wskaźniki spadają jednocześnie. Jeśli obserwuję wzrost EP przy stałym, niskim poziomie SPEED, oznacza to, że żądania gromadzą się na serwerze WWW, często z powodu niedoboru procesów roboczych, konfiguracji Keep-Alive lub blokujących wywołań zewnętrznych (np. API, poczta). Błędy MEM przy umiarkowanej wartości SPEED wskazują na niewielką liczbę procesów, które jednak zużywają dużo pamięci (np. konwersja obrazów, duże eksporty). Szczyty IO/IOPS bez znaczącego obciążenia procesora wskazują na intensywny dostęp do plików lub baz danych. Wykorzystuję te korelacje do pierwsza hipoteza zanim przejdę do bardziej szczegółowych informacji dotyczących kodu lub serwera.
W praktyce: efektywne korzystanie z lvetop, lveinfo i cloudlinux-statistics
Aby zapewnić szybkie wyniki badań, pracuję z przejrzystymi Zapytania oraz filtrowanie. lvetop pozwala mi co sekundę sprawdzać największych konsumentów zasobów i przełączać się między sortowaniem według CPU, pamięci (MEM) lub operacji wejścia/wyjścia (IO). Za pomocą lveinfo wyznaczam okna czasowe 1 godz., 24 godz. i 7 dni, aby wyświetlić momenty wystąpienia błędów, wartości szczytowe oraz zasoby, których dotyczy problem, dla każdego konta. cloudlinux-statistics dostarcza mi dłuższe szeregi czasowe i nadaje się do dokumentowania efektów podjętych działań (przed i po). Po każdej interwencji zawsze dokumentuję: okres, konta, których dotyczyła, maksymalne wartości dla poszczególnych zasobów, liczbę awarii oraz czasy odpowiedzi z monitoringu aplikacji lub sieci. Dzięki temu mogę udokumentować optymalizacje i zapobiec rozluźnianiu limitów „na oko“.
Subtelności stosu technologicznego: moduły obsługi PHP, procesy robocze i OPcache
Dużą siłą napędową jest Wykonanie kodu PHP: Liczba procesów roboczych PHP na konto, ich limit pamięci RAM (memory_limit) oraz OPcache. Zbyt duża liczba procesów roboczych bez pamięci podręcznej powoduje wzrost wartości EP/PNO i MEM, natomiast zbyt mała liczba procesów roboczych powoduje zatory w żądaniach (wzrasta wartość EP, wydłuża się czas odpowiedzi). Dlatego ustalam optymalny punkt: tyle procesów, ile trzeba, a jak najmniej to możliwe. OPcache musi być odpowiednio zwymiarowany (pamięć i interned strings), w przeciwnym razie PHP będzie nieustannie dokonywać ponownej kompilacji, co negatywnie wpływa na wskaźnik SPEED. Dodatkowo sprawdzam, czy zasoby statyczne są rzeczywiście obsługiwane przez serwer WWW (a nie przez PHP) oraz czy Keep-Alive i multipleksowanie HTTP/2 działają prawidłowo. Celem jest dynamiczne żądania do zmniejszać się oraz szybko uporać się z pozostałymi.
Konsekwentne stosowanie strategii buforowania
Wyróżniam trzy poziomy: Pamięć podręczna Edge/CDN na rzecz globalnego odciążenia, Pamięć podręczna HTTP/strony bezpośrednio przed PHP i Pamięć podręczna obiektów w ramach aplikacji. Pamięć podręczna Edge radykalnie obniża EP i IO dla zasobów statycznych. Pamięć podręczna stron zmniejsza liczbę dynamicznych trafień i ma bezpośredni wpływ na EP/SPEED. Pamięć podręczna obiektów (np. do częstych wyszukiwań w bazie danych) obniża IOPS i obciążenie procesora. Ważna jest stabilna Klucz pamięci podręcznej (np. brak zbędnych plików cookie) oraz odpowiednie wartości TTL dla poszczególnych typów stron. W obszarach administracyjnych lub koszyku planuję wprowadzić wyjątki, natomiast wszędzie indziej dążę do jak najwyższego wskaźnika wykorzystania pamięci podręcznej. Po aktywacji obserwuję: czy występują błędy EP? Czy zmniejsza się mediana czasu odpowiedzi?
Zarządzanie pamięcią RAM: memory_limit, procesy i wycieki pamięci
Usterki MEM często powstają, ponieważ pamięć_limit jest dość szeroko oszacowana, a procesy równoległe przekraczają tę sumę. Dlatego dokonuję kalibracji: ile pamięci RAM potrzebuje typowe żądanie? Na tej podstawie ustalam maksymalną rozsądną liczbę procesów roboczych. Ponadto dbam o oszczędne wykorzystanie bibliotek PHP i wtyczek, usuwam nieużywane rozszerzenia oraz sprawdzam skrypty długotrwałe (eksporty, importy, przetwarzanie obrazów) pod kątem wycieków pamięci. OPcache zmniejsza obciążenie pamięci RAM, buforując skompilowane dane, ale sam nie może być zbyt mały. W przypadku powtarzających się szczytów obciążenia izoluję za pomocą profilowania „kosztowne“ ścieżki i podejmuję ukierunkowane działania – to częściej pozwala zaoszczędzić pamięć RAM niż ogólne zwiększanie limitów.
Celowe ograniczanie operacji we/wy i IOPS
Szczytowe wartości IO/IOPS wynikają z wielu niewielkich operacji dostępu do plików lub baz danych. Tam, gdzie to możliwe, grupuję obciążenia: generowanie miniatur w trybie wsadowym zamiast na żądanie, minimalizacja zasobów podczas kompilacji zamiast przy każdym żądaniu, pamięć sesji i pamięć tymczasowa w jednym Pamięć podręczna obiektów przenoszę dane, aby zmniejszyć liczbę operacji dostępu do plików. W bazie danych nadaję priorytet indeksom dla często występujących klauzul WHERE i JOIN oraz eliminuję zapytania typu N+1. Równolegle porównuję przebiegi LVE z raportami bazy danych z MySQL Governor, aby zidentyfikować punkty newralgiczne. Celem jest przekształcenie wielu małych operacji IOPS w kilka wydajnych operacji dostępu – to wygładza szczyty obciążenia i zmniejsza prawdopodobieństwo wystąpienia awarii.
Łagodzenie błędów EP: kolejkowanie i przepływy odwiedzających
EP ogranicza liczbę jednoczesnych dostępów. Jeśli pojawi się wiele żądań, a pamięć podręczna jest prawie pusta, szybko dochodzi do błędów EP. Zapobiegam temu poprzez Kolejki zanim wprowadzę PHP (krótkie kolejki żądań na serwerze WWW), odpowiednio skonfiguruję Keep-Alive i konsekwentnie będę buforować dynamiczne ścieżki, które nie są spersonalizowane. W przypadku botów definiuję limity częstotliwości i wcześnie blokuję oczywistych „złych graczy”. Dodatkowo sprawdzam wywołania stron trzecich w ścieżce żądania – blokujące usługi zewnętrzne wydłużają czas trwania każdego żądania, zużywając w ten sposób EP. Tam, gdzie to możliwe, przenoszę integracje zewnętrzne do zadań/kolejek.
Planowanie zadań cron i kopii zapasowych z uwzględnieniem oszczędzania zasobów
Zadania cykliczne oddzielam od godzin szczytu i reguluję ich wykonywanie: rozkładam harmonogramy Cron (przesuwając je o kilka minut), zapobiegam równoległemu uruchamianiu za pomocą plików blokujących oraz reguluję obciążenie za pomocą Nicing oraz wielkość partii. Kopie zapasowe planuję w przedziałach czasowych o niewielkim natężeniu ruchu i dbam o stosowanie metod przyrostowych, aby wskaźniki IO/IOPS pozostały w rozsądnych granicach. W przypadku wymagających zadań wykonywanych w aplikacji ustalam limity liczby jednoczesnych procesów roboczych, aby wartości MEM i SPEED nie wzrastały gwałtownie. W trakcie działania sprawdzam efekty: czy zmniejsza się liczba nocnych błędów, czy spadają skoki obciążenia po pełnej godzinie?
CageFS – przegląd systemu plików i i-węzłów
Oprócz limitów LVE wpływają Czynniki związane z systemem plików Wydajność: miliony małych plików (np. fragmentów pamięci podręcznej) zwiększają liczbę operacji dostępu do metadanych i podnoszą wskaźnik IOPS. Dbam o porządek w katalogach pamięci podręcznej, ograniczam nadmiar plików poprzez sensowne agregowanie pamięci podręcznej oraz sprawdzam obciążenie i-węzłów. CageFS zapewnia izolację, jednak nieprawidłowo umieszczone pliki tymczasowe (np. w katalogu głównym serwisu zamiast w katalogu tmp) niepotrzebnie zwiększają obciążenie operacji wejścia/wyjścia. Okresowa kontrola stanu tych obszarów zapobiega błędnej interpretacji wąskich gardeł we/wy jako problemów związanych wyłącznie z procesorem lub pamięcią RAM.
Przejrzystość i komunikacja w kontekście sprzedaży detalicznej
W środowiskach resellerskich dokumentuję Załaduj sterownik dla każdego podsystemu i rejestruję podejmowane działania: jakie limity zostały ustalone? Jakie optymalizacje są planowane? Jak wyglądają wykresy „przed” i „po”? Taka przejrzystość przyspiesza udzielanie odpowiedzi przez dział wsparcia i zwiększa akceptację dla zmiany taryfy, gdy potencjał optymalizacji zostanie wyczerpany. Ustalam wartości progowe, powyżej których podejmujemy działania (np. powtarzające się awarie > N/dzień lub mediana czasu odpowiedzi > X ms), i wiążę je z jasnymi ścieżkami postępowania – dzięki temu nie powstają niekończące się pętle w systemie zgłoszeń.
Jak uniknąć częstych błędów w interpretacji
Regularnie zauważam kilka schematów: rosnące obciążenie procesora to nie automatycznie pojawia się komunikat o „niewystarczającej mocy procesora“ – często pamięci podręczne nie działają lub zapytania są nieefektywne. Duża liczba błędów EP niekoniecznie oznacza „większy ruch“ – przyczyną mogą być boty, nieprawidłowo skonfigurowane narzędzia monitorujące lub sygnały kontrolne. Błędów MEM nie zawsze da się rozwiązać poprzez zwiększenie wartości memory_limit – często wynika to z zbyt dużej liczby procesów uruchomionych jednocześnie. Szczyty IO/IOPS nie zależą wyłącznie od pamięci masowej – wywołują je wzorce działania aplikacji. Dlatego zawsze weryfikuję hipotezy za pomocą skorelowanych wykresów i, jeśli to możliwe, krótkich testów porównawczych (np. włączam pamięć podręczną dla podsekcji i ponownie sprawdzam przebieg).
Testowanie, pomiary, ponowne ostrzenie
Każdą zmianę oceniam na wyraźnych punktów pomiarowych: przed/po aktywacji pamięci podręcznej strony, przed/po uzupełnieniu indeksu, przed/po dostosowaniu liczby procesów roboczych. W tym celu korzystam z historii LVE, wskaźników czasu odpowiedzi oraz wskaźników błędów (5xx/4xx). Tam, gdzie to możliwe, przeprowadzam testy A/B w godzinach poza szczytem, aby wyodrębnić skutki uboczne. Jeśli błędy nadal występują, powtarzam proces: precyzyjnie dostosowuję kombinacje limitów, profiluję kolejne ścieżki o dużym obciążeniu, dostosowuję rozmiary partii zadań. Doświadczenie pokazuje, że dwie do trzech ukierunkowanych iteracji dają znacznie lepsze wyniki niż jedno duże, ogólne działanie.
Podsumowanie: Jak efektywnie analizować raporty dotyczące wykorzystania zasobów w systemie CloudLinux
Oceniam CloudLinux- Dane zawsze w trzech poziomach: na żywo, historia, błędy. Wskaźniki SPEED, MEM, IO, IOPS, PNO i EP dostarczają mi mapę przyczyn i skutków. Dzięki lvetop od razu widzę, kto generuje obciążenie; za pomocą lveinfo i lvechart identyfikuję wzorce zachowań na przestrzeni dni. Na podstawie powtarzających się błędów (Faults) wyznaczam działania związane z buforowaniem, optymalizacją zapytań, dostosowaniem limitów lub zmianą taryfy. Metoda ta zmniejsza nakłady na wsparcie techniczne, zwiększa niezawodność reakcji i zapewnia przejrzystość wydajności hostingu.


