Przejdź do treści

Klasy pamięci masowej Kopia zapasowa określa szybkość tworzenia kopii zapasowych i przywracania danych: NVMe często skraca czas tworzenia kopii zapasowych o kilka minut na 100 GB w porównaniu do dysków SSD SATA, w zależności od przepustowości i opóźnień. Ten artykuł pokazuje, jak NVMe oraz SSD wpływ na czas tworzenia kopii zapasowych, które wąskie gardła naprawdę się liczą i jak mogę na tej podstawie opracować niezawodną strategię hostowania kopii zapasowych.
Punkty centralne
- Przewaga NVMeWyższa przepustowość, mniejsze opóźnienia, znacznie krótszy czas tworzenia kopii zapasowych i przywracania danych
- Typ kopii zapasowejPełne, przyrostowe i różnicowe wykorzystanie NVMe w różnym stopniu
- Klasy w chmurzeStandard S3 dla szybkości, IA/Archiwum dla kontroli kosztów
- RAID/FSUkład i system plików wpływają na rzeczywistą szybkość transferu
- RTO/RPOTesty i monitorowanie zapewniają niezawodne czasy restartu
NVMe vs SATA SSD: Dlaczego kopie zapasowe są tak korzystne?
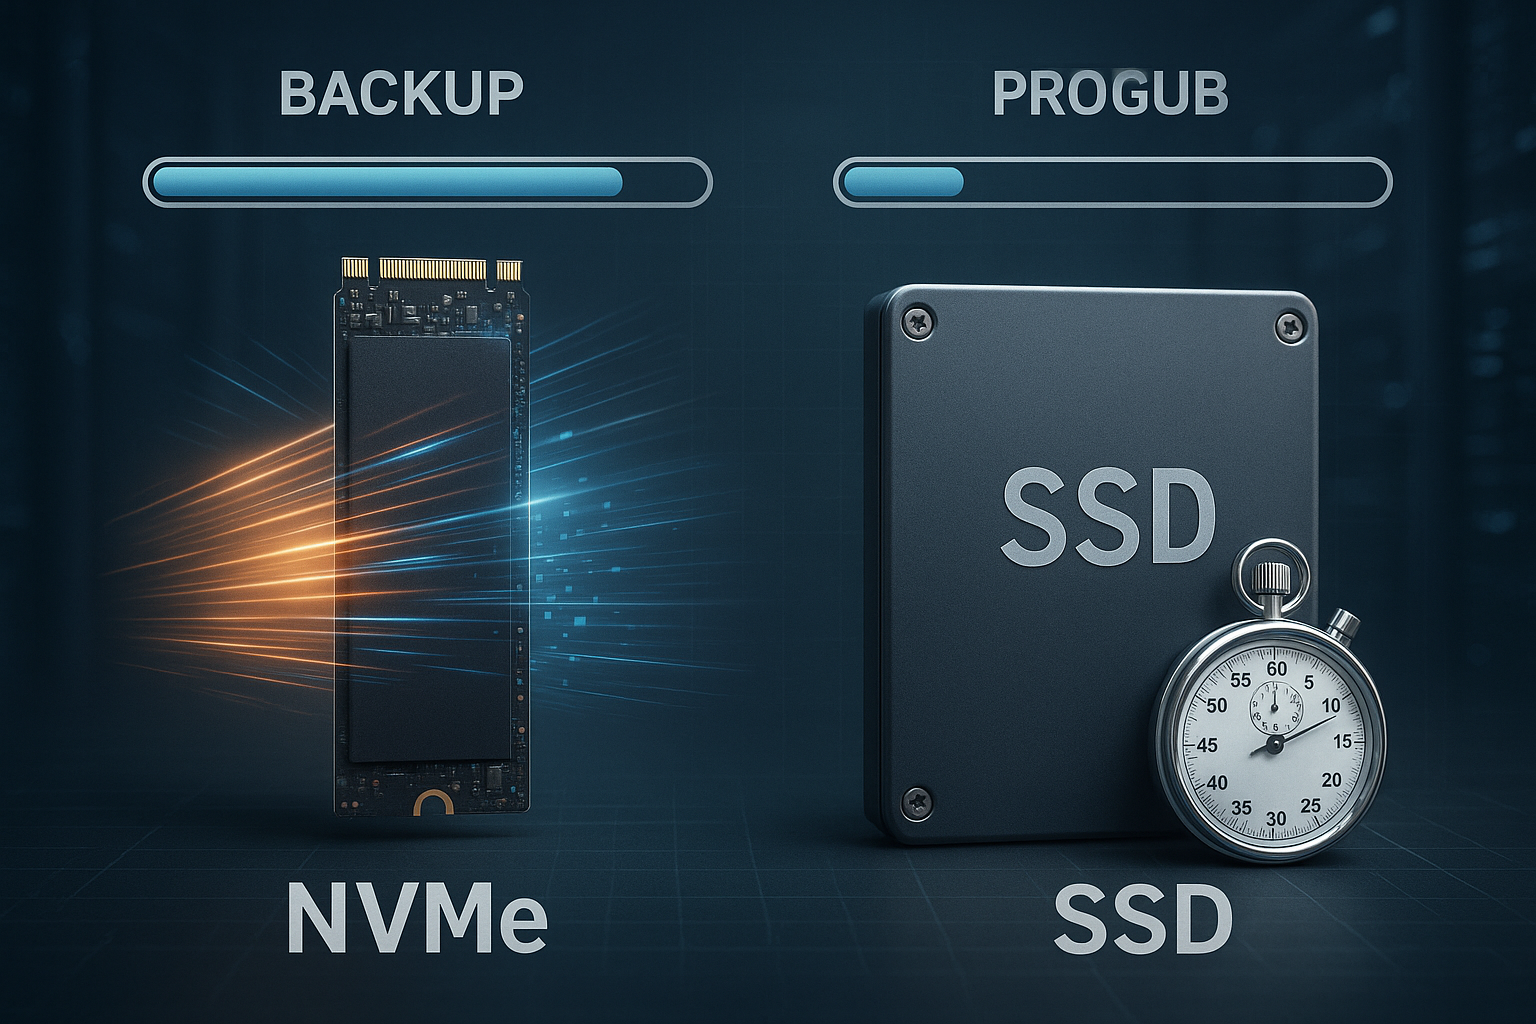
NVMe korzysta z pasów PCIe i uproszczonego protokołu, co zwiększa Przepustowość i IOPS, a opóźnienia znacznie spadają w porównaniu do dysków SSD SATA. Dyski SSD SATA osiągają zazwyczaj 520-550 MB/s, podczas gdy PCIe 4.0 NVMe osiąga do 7000 MB/s, a PCIe 5.0 NVMe ponad 10 000 MB/s, co znacznie przyspiesza tworzenie pełnych kopii zapasowych. Dla 100 GB oznacza to w prostych słowach: SATA-SSD zajmuje około 3-5 minut, PCIe-4.0-NVMe 15-30 sekund, w zależności od kompresji, szyfrowania i mieszanki plików. Zadania przyrostowe również korzystają z niskiego Opóźnienie, ponieważ wiele małych losowych odczytów/zapisów działa szybciej. Jeśli chcesz dokonać głębszego porównania, możesz znaleźć praktyczne różnice w Porównanie NVMe/SSD/HDD, który porównuje wydajność i koszty.
Typy kopii zapasowych i ich interakcja z klasą pamięci masowej
Pełne kopie zapasowe zapisują duże bloki danych sekwencyjnie, dlatego też prędkość tworzenia kopii zapasowych niemal liniowo z surową przepustowością klasy pamięci masowej. Przyrostowe kopie zapasowe zapisują delty od ostatniego uruchomienia; niskie opóźnienia NVMe i wysoka wydajność IOPS przy wielu małych plikach są tutaj szczególnie ważne. Różnicowe kopie zapasowe znajdują się pomiędzy nimi i w praktyce korzystają z szybkich odczytów podczas montażu łańcucha przywracania. W przypadku hostingu kopii zapasowych minimalizuję RTO i RPO w ten sposób: mniejsza delta, szybkie nośniki, czyste planowanie. Łączę metody i rzadziej uruchamiam pełne kopie zapasowe, podczas gdy zadania przyrostowe są zaplanowane na NVMe rotować codziennie lub częściej.

Przepustowość, IOPS i opóźnienie w kontekście tworzenia kopii zapasowych
Aby uzyskać realistyczne czasy tworzenia kopii zapasowych, patrzę na trzy kluczowe liczby: sekwencyjne Przepustowość, losowy IOPS i opóźnienie na operację. Przepustowość sekwencyjna określa czas trwania pełnej kopii zapasowej, IOPS i opóźnienie napędzają zadania przyrostowe, wiele małych plików i metadanych. Kompresja i szyfrowanie mogą ograniczyć surowe wartości, jeśli procesor nie nadąża za szybkością przesyłania danych. Dlatego mierzę zarówno wydajność pamięci masowej, jak i wykorzystanie procesora podczas tworzenia kopii zapasowej. Poniższa tabela przedstawia typowe rozmiary dla zadań 100 GB w optymalnych warunkach bez wąskiego gardła sieci:
| Typ pamięci masowej | Maks. odczyt | Max. Zapis | Zwykły czas tworzenia kopii zapasowej (100 GB) | Opóźnienie |
|---|---|---|---|---|
| SATA SSD | 550 MB/s | 520 MB/s | 3-5 minut | 80-100 µs |
| PCIe 3.0 NVMe | 3 400 MB/s | 3000 MB/s | 30-60 sekund | ~25 µs |
| PCIe 4.0 NVMe | 7000 MB/s | 6 800 MB/s | 15-30 sekund | 10-15 µs |
| PCIe 5.0 NVMe | 12 000 MB/s | 11 000 MB/s | < 15 sekund | 5-10 µs |
W praktyce wartości te są często niższe, ponieważ rozmiary plików, sumy kontrolne, migawki i obciążenie procesora spowalniają działanie funkcji NVMe pozostaje wyraźnie widoczna. NVMe jest szczególnie korzystna w przypadku zadań równoległych, ponieważ kilka kolejek jest przetwarzanych na rdzeń. W przypadku wielu małych plików, IOPS i opóźnienia liczą się bardziej niż czysta specyfikacja MB/s. Dlatego planuję bufory: 20-30% nadwyżki nad oczekiwaną szybkością, aby kopie zapasowe nie wymknęły się z okna czasowego podczas faz wąskiego gardła. Ta rezerwa opłaca się podczas nocnych przejazdów i wąskich gardeł w sieci.
Klasy pamięci masowej w chmurze w zestawie kopii zapasowych
Dla kopii zewnętrznych używam klas kompatybilnych z S3, przy czym Standard to najlepszy wybór do szybkiego odzyskiwania danych. Rzadki dostęp oszczędza koszty bieżące, ale wymaga dłuższego czasu odzyskiwania i prawdopodobnie opłat za odzyskiwanie. Klasy archiwalne są odpowiednie do legalnego przechowywania danych, a nie do przywracania danych o krytycznym znaczeniu czasowym. Łączę lokalne migawki NVMe ze standardem S3 dla świeżych kopii i przenoszę starsze wersje do bardziej korzystnych klas. Dobre wprowadzenie do tych koncepcji zapewnia Obiektowa pamięć masowa w hostingu, który jasno wyjaśnia zalety i wady.
RAID i systemy plików: szybkość i ochrona
Układy RAID wpływają na efektywną Szybkość tworzenia kopii zapasowych ponieważ rozmiar paska i równoległość spełniają lub nie wzorce zapisu oprogramowania. RAID 10 zapewnia wysoki IOPS i solidną wydajność zapisu, RAID 5/6 oferuje większą pojemność, ale słabsze losowe zapisy. Nowoczesne systemy plików, takie jak XFS lub ZFS, wydajnie przetwarzają strumienie równoległe i ułatwiają tworzenie migawek, co może skrócić okna tworzenia kopii zapasowych. W przypadku hostów z systemem Linux sprawdzam określone obciążenia, a następnie wybieram system plików. Krótką pomoc w podjęciu decyzji zapewnia ext4, XFS lub ZFS z uwagami dotyczącymi wydajności dla typowych scenariuszy.
Praktyczny przykład: 100 GB obliczone w liczbach
Załóżmy, że tworzę kopię zapasową 100 GB nieskompresowanych danych z prędkością 2000 MB/s netto do NVMe, wtedy czas trwania wynosi około 50 sekund. Na dysku SSD SATA o przepustowości 500 MB/s potrzebuję około 3,3 minuty, plus narzut na sumy kontrolne i metadane. Jeśli używam kompresji 2:1, a procesor utrzymuje prędkość, wymagany czas jest często o połowę krótszy. Sytuacja robi się napięta, gdy procesor lub sieć nie nadążają: Łącze 10 GbE ogranicza się do 1000-1200 MB/s netto, bez względu na to, jak szybki jest dysk. Właśnie dlatego testuję kompleksowo, a nie w izolacji, aby określić rzeczywisty czas transferu danych. Czas tworzenia kopii zapasowej bezpiecznie planować.
Sieć i oprogramowanie: często pomijany hamulec
Oprogramowanie do tworzenia kopii zapasowych decyduje o tym, jak dobrze mogę wykorzystać zalety NVMe w ogóle. Jednowątkowe potoki z trudem nasycają szybkie nośniki, a wielostrumieniowe i asynchroniczne wejścia/wyjścia znacznie zwiększają szybkość. Deduplikacja oszczędza transmisję i pamięć, ale kosztuje procesor i losowe IOP, co szybko wykorzystuje niedrogie dyski SSD. Szyfrowanie TLS chroni dane, ale również wymaga mocy obliczeniowej; AES-NI i odciążenie sprzętowe pomagają tutaj. Dlatego sprawdzam równolegle: strumienie, kompresję, deduplikację i szyfrowanie - i dostosowuję potok do docelowego medium zamiast ślepo przyjmować wartości domyślne.
Kontrola kosztów: euro za zaoszczędzoną minutę
Lubię kalkulować wstecz: jeśli NVMe oszczędza średnio 2,5 minuty dziennie w porównaniu do SATA SSD przy 100 GB, to daje to około 75 minut miesięcznie i 15,6 godziny rocznie, w przeliczeniu na Serwer. Przy stawce godzinowej w wysokości 50 euro za czas operacyjny lub koszty alternatywne, daje to 780 euro rocznie; w wielu konfiguracjach korzyści znacznie przekraczają dodatkowy koszt rozwiązania NVMe. Krytyczne systemy z małymi oknami kopii zapasowych odnoszą szczególne korzyści, ponieważ opóźnienia natychmiast zamieniają się w ryzyko RTO. Każdy, kto przechowuje archiwa, może dodać ekonomiczne klasy obiektowej pamięci masowej, a tym samym obniżyć koszty nośników. Takie spojrzenie pomaga w ekonomicznym podejmowaniu decyzji wykraczających poza same wartości MB/s.
Korzystanie z funkcji zabezpieczeń bez utraty prędkości
Niezmienne kopie zapasowe z Blokada obiektu chronią przed manipulacją, oprogramowaniem ransomware i przypadkowym usunięciem. Tworzę migawki na źródłach NVMe, eksportuję je dedykowane i przesyłam z ograniczaniem, aby nie spowalniać produkcyjnego IO. Wersjonowanie w S3 umożliwia precyzyjne punkty przywracania, które starzeję za pomocą reguł cyklu życia. Szyfrowanie w spoczynku i podczas przesyłania pozostaje obowiązkowe; mierzę jednak koszty procesora i wybieram parametry, które są zgodne z oknami kopii zapasowych. W ten sposób bezpieczeństwo nie jest hamulcem, ale częścią planowanej rutyny.

Strategia migracji bez ryzyka przestojów
Podczas przełączania z dysku SSD SATA na NVMe Najpierw tworzę kopię zapasową stanu obecnego, tworzę przebiegi testowe i mierzę czasy od końca do końca. Następnie migruję obciążenia na bieżąco, zaczynając od największych okien kopii zapasowych, aby efekty były natychmiast widoczne. Migawki i replikacja skracają czas przełączania; planuję nakładanie się, aż nowe zadania będą działać stabilnie. Strategie Backoff zapobiegają generowaniu szczytów przez kilka dużych zadań w tym samym czasie. Dokumentacja i krótka ścieżka wycofania zapewniają działanie, jeśli kilka pierwszych nocy będzie odbiegać od normy.
Konfiguracja zapewniająca szybkość
Ustawiłem głębokość kolejki i równoległość tak, aby Kolejki IO dyski NVMe są wykorzystywane, ale nie przepełnione. Większe rozmiary bloków pomagają w wykonywaniu pełnych kopii zapasowych, a małe bloki i większa liczba strumieni przyspieszają wykonywanie operacji przyrostowych. Pamięć podręczna typu write-through vs. write-back i interwały spłukiwania wpływają na opóźnienia i spójność; liczy się tutaj zamierzone zastosowanie. Monitorowanie czasów oczekiwania I/O, kradzieży CPU i buforów sieciowych ujawnia wąskie gardła na wczesnym etapie. Używam tych sygnałów do stopniowego wyostrzania potoku, zamiast ryzykować duże skoki.
Prawidłowe wdrożenie spójności aplikacji i migawek
Szybkie nośniki są mało pomocne, jeśli dane są niespójne. Spójne z aplikacją kopie zapasowe uzyskuję poprzez stabilizację baz danych i usług przed wykonaniem migawki: haki pre/post dla zamrażanie/rozmrażanie, krótkie interwały spłukiwania i zapisy w dzienniku pozwalają uniknąć brudnych stron. Pod Linuksem używam migawek LVM lub ZFS, a w razie potrzeby XFS. xfs_freeze, pod Windows VSS. W przypadku baz danych obowiązują następujące zasady: tworzenie kopii zapasowych dzienników zapisu i dokumentowanie łańcucha odzyskiwania. Maszyny wirtualne otrzymują migawki w trybie quiesced z agentami gościa; dzięki temu system plików i stan aplikacji są spójne. Rezultat: mniej niespodzianek związanych z przywracaniem i niezawodne RPO bez niepotrzebnego wydłużania okna tworzenia kopii zapasowych.
Ćwiczenia weryfikujące i przywracające: zaufanie powstaje w drodze powrotnej
Systematycznie sprawdzam, czy kopie zapasowe są czytelne i kompletne. Obejmuje to kompleksowe sumy kontrolne, sprawdzanie katalogów/manifestów i losowe przywracanie do odizolowanego środowiska docelowego. Comiesięczne ćwiczenia przywracania dla krytycznych usług mierzą rzeczywiste RTO i wykrywają błędy schematu lub autoryzacji. Regularne skanowanie integralności jest obowiązkowe w przypadku deduplikacji repozytoriów. ETag-porównania i okresowe czyszczenie. Wyniki trafiają do runbooka: Jakie kroki, jaki cel, jaki czas trwania. W ten sposób odzyskiwanie danych z wyjątkowego przypadku staje się rutyną - a inwestycje w NVMe pokazują swoje korzyści w chwili prawdy.
Szczegóły sprzętowe: typ NAND, TBW, PLP i efekty termiczne
Nie wszystkie NVMe są takie same: modele TLC utrzymują wysokie prędkości zapisu dłużej niż QLC, których pamięć podręczna SLC jest szybciej wyczerpywana przy ciągłym obciążeniu. W przypadku kopii zapasowych z długimi sekwencyjnymi zapisami może to zmniejszyć szybkość netto o połowę, gdy tylko zacznie się dławienie termiczne. Zwracam uwagę na wystarczające chłodzenie, radiatory i przepływ powietrza, aby uniknąć dławienia. Dyski klasy korporacyjnej z ochroną przed utratą zasilania (PLP) zabezpieczają dane w przypadku awarii zasilania i zapewniają bardziej spójne opóźnienia. Ustawiam kluczową wartość TBW (Total Bytes Written) w odniesieniu do dziennego wolumenu kopii zapasowych, aby zachować możliwość obliczenia zużycia. Dzięki temu potok jest stabilny - nie tylko w benchmarku, ale także noc po nocy.

Skalowanie potoku kopii zapasowych
Wraz ze wzrostem liczby hostów kluczowa staje się orkiestracja. Rozkładam godziny rozpoczęcia, ograniczam jednoczesne pełne kopie zapasowe i rezerwuję przedziały czasowe dla każdego klienta. Obsługiwany przez NVMe Strefa lądowania-Pamięć podręczna na serwerze kopii zapasowych buforuje wysokie wartości szczytowe i asynchronicznie umieszcza dane w obiektowej pamięci masowej. Algorytmy sprawiedliwego podziału i limity szybkości operacji we/wy zapobiegają wykorzystaniu wszystkich zasobów przez pojedyncze zadanie. Zwiększam liczbę równoległych strumieni tylko w takim stopniu, w jakim źródło, cel i sieć mogą nadążyć; po przekroczeniu nasycenia opóźnienie wzrasta, a szybkość netto spada. Celem jest płynna krzywa wykorzystania zamiast nocnych szczytów - w ten sposób utrzymuję umowy SLA, nawet jeśli nieoczekiwanie interweniuje przywracanie.
Strojenie sieci i systemu operacyjnego pod kątem wysokich prędkości
Dla 10-25 GbE optymalizuję MTU (ramki jumbo, jeśli to możliwe), bufor TCP, skalowanie po stronie odbiorczej i powinowactwo IRQ. Nowoczesne stosy korzystają z io_uring lub asynchroniczne I/O; zmniejsza to narzut wywołań systemowych i zwiększa równoległość. Wybieram metodę kontroli przeciążenia TCP, która odpowiada moim opóźnieniom i używam wielu strumieni, aby wykorzystać trasy o wysokim BDP. Po stronie procesora, AES-NI i ewentualnie poziomy kompresji, które pasują do zegara rdzenia, pomagają (np. średnie poziomy są często najlepszym stosunkiem przepustowości i współczynnika). Ważne: Nie należy optymalizować na jednym końcu i tworzyć wąskich gardeł na drugim - pomiar end-to-end pozostaje wytyczną.
Uwagi dotyczące obciążeń: Bazy danych, maszyny wirtualne i kontenery
Tworzę kopie zapasowe baz danych na podstawie dziennika i w ściśle określonych momentach: podstawowa kopia zapasowa plus ciągłe rejestrowanie dziennika zmniejsza RPO prawie do zera i przyspiesza przywracanie. W przypadku maszyn wirtualnych śledzenie bloków zmian i metody wygaszania oparte na agentach są na wagę złota, ponieważ precyzyjnie wychwytują przyrostowe zmiany wolumenu. W środowiskach kontenerowych oddzielam dane płaszczyzny sterowania (np. metadane klastra) od trwałych woluminów; migawki za pośrednictwem sterowników CSI na backendach NVMe zauważalnie skracają okna tworzenia kopii zapasowych. Wspólny mianownik: spójność aplikacji przed surową wydajnością. Tylko wtedy, gdy semantyka jest właściwa, warto wykorzystać pełny potencjał przepustowości i IOPS NVMe.
Zasady i zgodność: 3-2-1-1-0 w praktyce
Operacyjnie ustalam zasadę 3-2-1-1-0: trzy kopie, dwa typy nośników, jedna poza siedzibą firmy, jedna niezmienna, zero niesprawdzonych błędów. Konkretnie oznacza to: lokalną kopię migawkową NVMe, kopię dodatkową na oddzielnej pamięci masowej (inny RAID/inna strefa dostępności) i poza siedzibą firmy w S3 z blokadą obiektu. Zasady cyklu życia mapują okresy przechowywania, a prawne mandaty pozostają nienaruszone przez operacje usuwania. Regularne sumy kontrolne i przywracanie testowe zapewniają „0“. Dzięki temu środki techniczne są zgodne z przepisami i możliwe do skontrolowania - bez przekraczania okien tworzenia kopii zapasowych.
Benchmarking bez błędów pomiarowych
Prawidłowy pomiar oznacza powtarzalny pomiar. Wybieram rozmiary bloków i głębokości kolejek, aby dopasować je do celu (np. 1-4 MB dla sekwencyjnych pełnych kopii zapasowych, 4-64 KB z wyższą równoległością dla przyrostów). Uwzględniam pamięć podręczną i warunki wstępne w celu wizualizacji efektów pamięci podręcznej SLC. Rozgrzewki, Test „dd“, jednolity czas trwania testu i ocena opóźnień P99 pokazują, czy skoki są nieuchronne. "dd" z pamięcią podręczną systemu operacyjnego zapewnia wartości pozorne; asynchroniczne wzorce we / wy, które są podobne do oprogramowania do tworzenia kopii zapasowych, są znaczące. Równolegle rejestruję CPU, IO wait i sieć, aby przyczyna była jasna - nie tylko objaw.
Planowanie wydajności i kosztów w czasie
Kopie zapasowe rosną stopniowo: nowi klienci, większe bazy danych, więcej plików. Pojemność planuję w trzech wymiarach: Przepustowość (MB/s na okno), IOPS/opóźnienia (dla metadanych i małych plików) oraz wymagania dotyczące pamięci masowej (primary, offsite, immutable). W przypadku NVMe rezerwuję 20-30% na szczyty, w S3 biorę pod uwagę koszty odzyskiwania i potencjalną replikację między regionami w przypadku awarii. Strefa docelowa obsługiwana przez NVMe umożliwia agresywną deduplikację/kompresję w następstwie i zmniejsza koszty przechowywania obiektów. Ważne: Sprawdzaj trendy co miesiąc i definiuj wartości progowe, które uruchamiają modernizację sprzętu lub sieci w odpowiednim czasie.
Która platforma odpowiada moim celom?
W przypadku produktywnych środowisk hostingowych sprawdzam, czy dostawca NVMe RAID, migawki i połączenie S3. Decydujące szczegóły to generacja PCIe, dostępne pasy, przepustowość sieci i niezawodne cele offsite. Porównanie aktualnych ofert szybko pokazuje, czy reklamowane stawki są realistycznie osiągalne, czy też są to tylko wartości szczytowe. Jeśli chcesz się zorientować, możesz porównać kluczowe dane z praktycznymi pomiarami i ocenić testowe kopie zapasowe. W ten sposób unikam złych inwestycji i nadaję priorytet komponentom, które faktycznie skracają czas tworzenia kopii zapasowych.
Plan do zabrania
Po pierwsze, mierzę rzeczywisty czas na zadanie i zapisuję RTO i wymagania RPO dla każdej usługi. Następnie identyfikuję wąskie gardło: pamięć masową, procesor, sieć lub potok oprogramowania. Następnie dokonuję ukierunkowanych aktualizacji: NVMe dla danych podstawowych i zapasowej pamięci podręcznej, 10-25 GbE w rdzeniu, wielostrumieniowość i kompresja w zależności od procesora. Po tym następują testy przywracania, które powtarzam co miesiąc, oraz plan cyklu życia kopii zewnętrznych. Aby uzyskać więcej informacji kontekstowych, warto zapoznać się z kompaktowym przeglądem NVMe/SSD/HDD, który krótko porównuje wydajność, koszty i obszary zastosowań.
Krótkie podsumowanie
NVMe w skrócie Czasy tworzenia kopii zapasowych zauważalne: większa przepustowość, znacznie więcej IOPS, znacznie mniejsze opóźnienia. Pełne kopie zapasowe zyskują na szybkości sekwencyjnej, a przyrostowe na szybkim dostępie losowym. Klasy w chmurze uzupełniają lokalne migawki NVMe, jeśli chcę zachować równowagę RTO i kosztów. Układ RAID, system plików, sieć i oprogramowanie decydują o tym, czy sprzęt pokazuje swój potencjał. Systematyczne pomiary, eliminacja wąskich gardeł i dostosowanie potoku pozwalają uzyskać niezawodne kopie zapasowe klasy pamięci masowej z przewidywalnymi oknami czasowymi.