 Saltar para o conteúdo

Vou explicar, de forma sucinta e fundamentada, como Evento MPM que utiliza a fila de eventos do Apache para gerir de forma eficiente muitas ligações HTTP simultâneas. Neste artigo, apresento os conceitos básicos, o ciclo de eventos, as filas internas e medidas concretas de otimização para uma eficaz Configuração.
Pontos centrais
- Ciclo de eventos separa a gestão de ligações do processamento de pedidos
- Manter em permanência já não bloqueia tópicos
- Fila de eventos ordena os sockets por estado
- Parâmetros Como ajustar o valor de MaxRequestWorkers de forma específica
- Monitorização garante um planeamento fiável da capacidade
Como o Event MPM controla as ligações
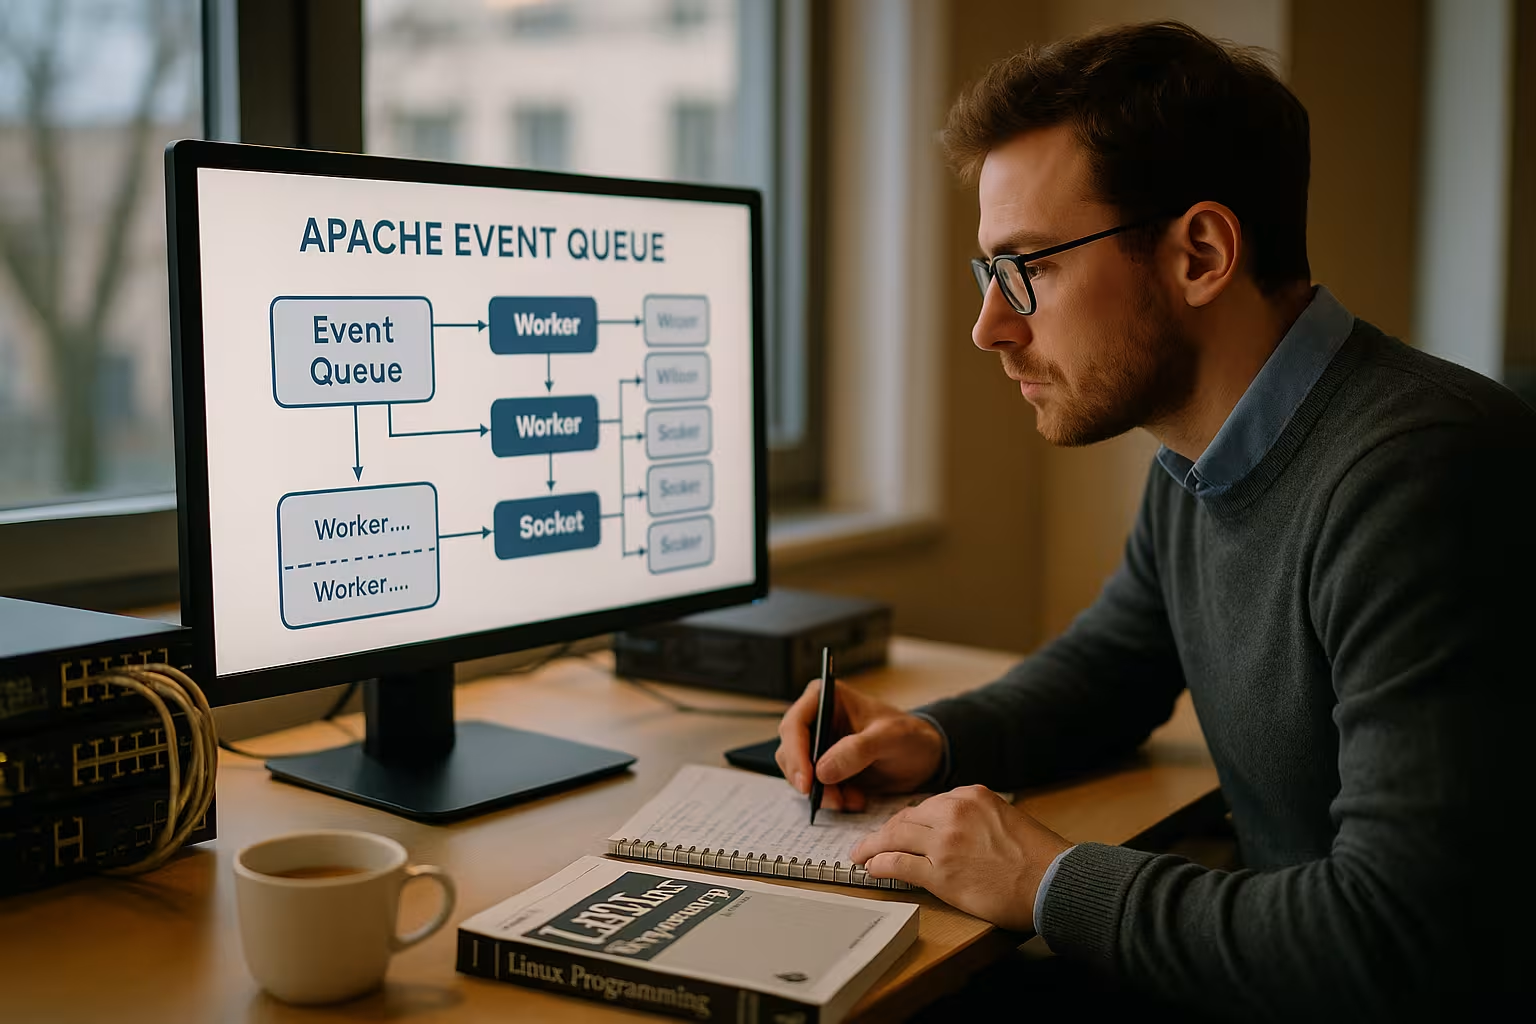
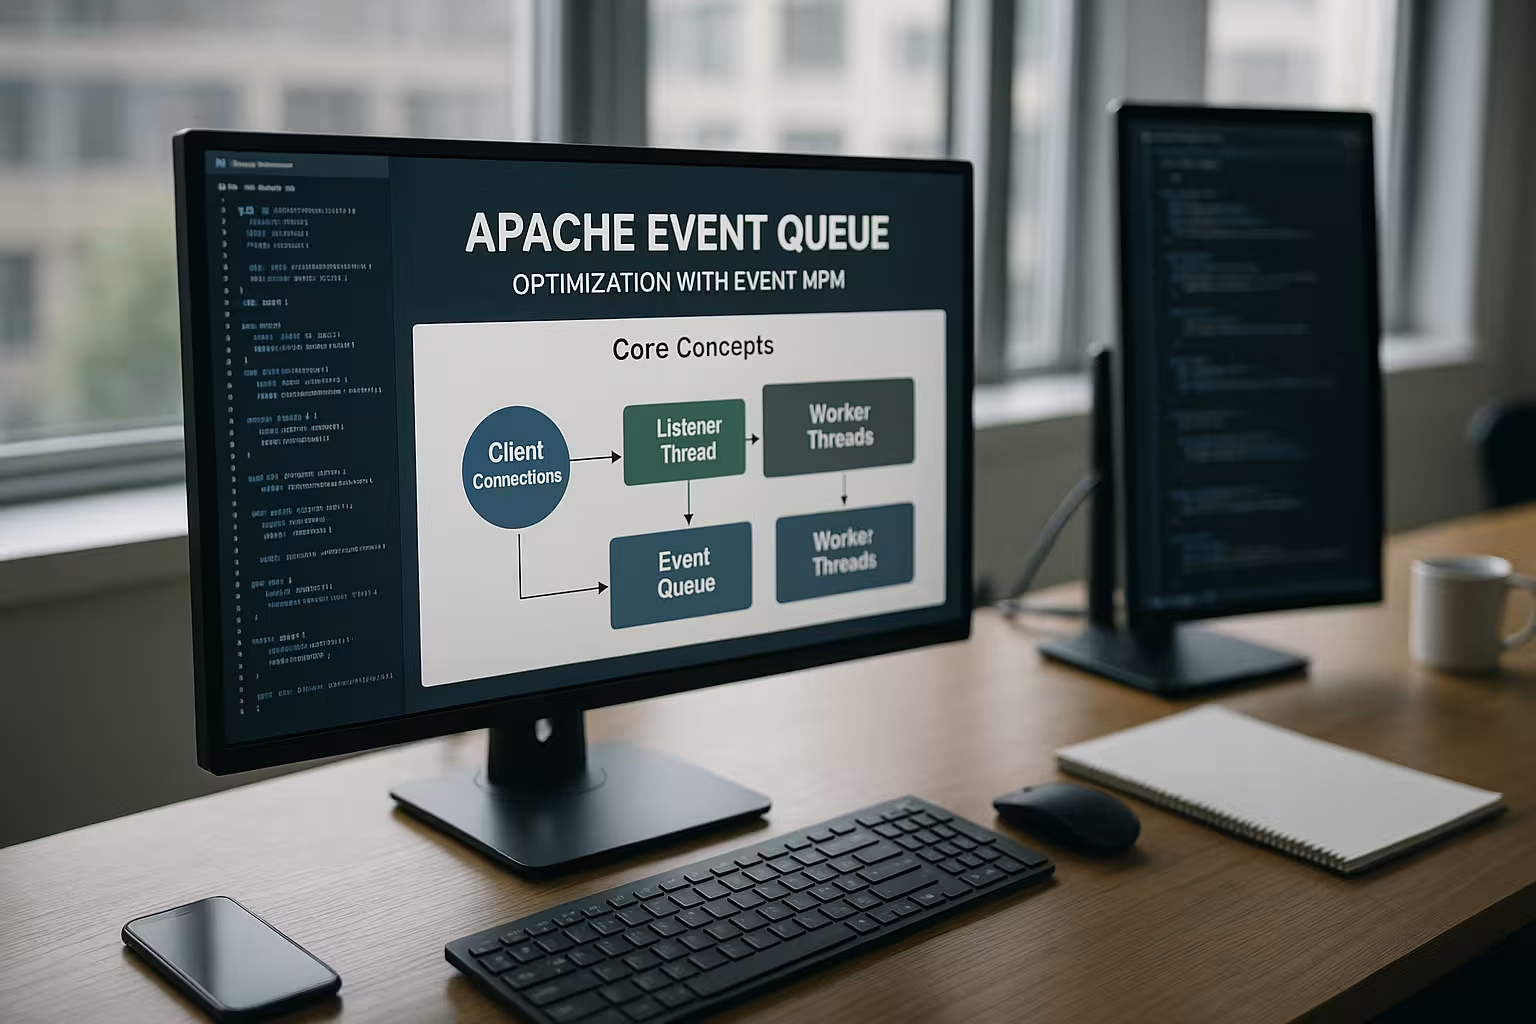
Começo por perguntar como é que o Apache funciona em Carga gere tantas ligações. O Event MPM combina processos e threads, mas dá prioridade aos eventos através de um ciclo de eventos. As threads de escuta aceitam novos sockets e monitorizam as ligações existentes sem bloquear imediatamente um thread de trabalho. Só quando os dados estiverem prontos para leitura ou escrita é que a camada de eventos transfere o socket para uma thread de trabalho disponível. Desta forma, evito que marcha lenta- As ligações ocupam threads e desperdiçam memória.
Esta separação reduz sensivelmente a carga na RAM. Os threads realizam principalmente „trabalho efetivo“, como a análise de pedidos, a geração de respostas ou a função de proxy. O ciclo de eventos restabelece depois os sockets ao estado adequado, por exemplo, de volta ao «Keep-Alive» ou à fase de encerramento. Na prática, observo filas mais curtas durante os picos de carga, porque as threads livres ficam novamente disponíveis mais rapidamente. A arquitetura proporciona uma clara escalável Capacidade de resposta para cargas de trabalho típicas de HTTP/1.1 e HTTP/2.
A fila de eventos do Apache em pormenor
A fila de eventos atribui um estado a cada ligação, e é precisamente aqui que reside o Lucro em comparação com os MPMs clássicos. As novas ligações entram primeiro numa fila que verifica a legibilidade. Quando os dados chegam, o ciclo de eventos move o socket para uma fila „legível“ e atribui-o a um trabalhador. Após o processamento, o estado determina novamente o que fazer: concluir a gravação, colocar o Keep-Alive em espera ou encerrar. Este ciclo mantém-se eficiente, uma vez que a gestão das filas é realizada de forma económica através do epoll ou do kqueue.
Vejo frequentemente mal-entendidos: a fila de eventos não substitui os workers, mas coordena o seu Utilização mais eficiente. Os threads continuam a processar os pedidos, mas apenas quando há realmente um fluxo de bytes. Isto poupa a CPU e a memória em cenários com muitas ligações „inativas“ de tipo Keep-Alive. Quanto mais bem concebidos forem o timeout e o buffer, menor será o risco de as ligações permanecerem desnecessariamente por muito tempo em estados dispendiosos. Desta forma, é possível manter o tempo de resposta constante, mesmo com milhares de sockets abertos.
Problema do «Keep-Alive» nos MPMs clássicos
No HTTP/1.1, as ligações permanecem frequentemente abertas para enviar várias pedidos sem necessidade de um novo handshake, o que Latência economiza. No entanto, o Prefork ou o Worker reservam para isso processos ou threads que ficam apenas à espera. Em picos de carga, muitas ligações Keep-Alive bloqueiam recursos de execução valiosos. Isso aumenta o consumo de RAM e limita o número de clientes em paralelo. O MPM Event resolve este problema, mantendo os sockets inativos sem thread numa posição de espera otimizada na fila de eventos.
Assim, coloco várias ligações em espera e só inicio o processamento quando há necessidade efetiva. Isto altera o modelo de capacidade: em vez de «threads = ligações», utilizo «threads = trabalho ativo». Em cenários de benchmark, isto permite-me admitir um número significativamente maior de ligações abertas, sem que haja quebras no Tempo de resposta. Para back-ends de API, alojamento WordPress e sites com grande volume de conteúdo, isto significa uma carga de trabalho significativamente mais uniforme. As vantagens do Keep-Alive mantêm-se, sem que os threads fiquem bloqueados.
MPM de evento vs. MPM de trabalhador
Vou resumir as diferenças de forma concisa numa Tabela em conjunto. O objetivo é oferecer uma visão rápida sobre a gestão, os recursos necessários e os campos de aplicação típicos. Ambas as variantes baseiam-se em processos com vários threads, mas o Event associa o Keep-Alive com menos frequência a um thread. O Worker mantém-se sólido para cargas moderadas, enquanto o Event destaca-se com muitas ligações paralelas. Esta classificação ajuda a tomar decisões coerentes para o seu próprio ambiente. Apresento uma comparação mais aprofundada em Evento vs. Trabalhador.
| MPM | Gestão do Keep-Alive | Threads/Processos | Requisitos de RAM | Adequado para |
|---|---|---|---|---|
| Pré-forquilha | Processo bloqueia em marcha lenta | Apenas processos | Elevado | PHP antigo sem segurança de threads |
| Trabalhador | Tópico fica frequentemente preso | Processos + Threads | Médio | Carga moderada, configurações simples |
| Evento | Ciclo de eventos estaciona sockets inativos | Processos + Threads | Baixo a médio | Muitos clientes, fases de keep-alive prolongadas |
Cenários de aplicação típicos
Utilizo o Event MPM quando há muitos processos paralelos Clientes solicitar cargas úteis de pequena a média dimensão. Os blogues com elevado tráfego, as lojas com cache, os recursos estáticos e os pontos finais de API beneficiam de forma significativa. O mesmo se aplica a configurações de alojamento com muitos sites por servidor, nas quais predominam as ligações Keep-Alive. A fila de eventos mantém baixo o número de threads ativos e distribui o trabalho de forma uniforme. Quem utiliza o HTTP/2 beneficia ainda mais, uma vez que uma ligação pode transportar vários fluxos, enquanto a camada de eventos coordena os estados de forma organizada.
O Event também demonstra os seus pontos fortes em topologias de proxy reverso. Deixo que o Apache trate da autenticação SSL, faça o armazenamento em cache e encaminhe os pedidos para uma camada de aplicações. Ao fazê-lo, a gestão das ligações mantém-se leve, o que atenua os pontos de estrangulamento. Mesmo em picos de tráfego, os tempos de resposta permanecem controláveis, desde que os limites sejam definidos de forma inteligente. Isso reduz o risco de Fila de espera- Congestionamento e tempos limite.
Configuração: diretivas-chave
Para uma avaliação sólida, verifico primeiro ServerLimit, StartServers, ThreadsPerChild e MaxRequestWorkers. A regra geral: ServerLimit × ThreadsPerChild deve aproximar-se do valor de MaxRequestWorkers, com uma margem para manutenção e crescimento. Um valor demasiado baixo limita o paralelismo; um valor demasiado alto aumenta excessivamente a necessidade de RAM. Defino o KeepAlive como «On», mas defino o KeepAliveTimeout de forma moderada, para que a inatividade não se torne excessiva. Valores entre alguns segundos e valores baixos na casa das dezenas de segundos funcionam frequentemente bem, dependendo do perfil de tráfego.
Além disso, tenho em conta os tempos de espera para leitura, escrita e proxies. Valores mais curtos protegem contra back-ends que ficam bloqueados, enquanto valores mais longos ajudam no caso de clientes com resposta lenta, o que Compensações é necessário. No caso de ficheiros estáticos, vale a pena enviá-los em blocos maiores e utilizar cadeias de filtros eficientes. No PHP via FPM ou balanceadores de proxy, dimensiono os trabalhadores de backend de acordo com o paralelismo do frontend. Documento cada alteração e avalio o impacto antes de prosseguir.
Otimização da fila de eventos: passo a passo
Começo com uma clara perfil de carga: ligações simultâneas, pedidos por segundo, tamanhos das respostas, percentagem de Keep-Alive. Em seguida, defino o MaxRequestWorkers de forma a que a CPU não fique ociosa, mas a RAM seja suficiente para um bom desempenho. Ajusto o «ThreadsPerChild» até que os picos de carga sejam processados sem tempos de espera. Calibro o «KeepAliveTimeout» para obter um bom equilíbrio entre a experiência do utilizador e a poupança de recursos. Quem quiser compreender mais profundamente o comportamento das filas de espera, encontrará noções básicas em Enfileiramento de servidores Web.
Realizo testes iterativos com ferramentas como ab, wrk ou k6 e analiso as latências nos percentis P50, P95 e P99. Ao fazê-lo, observo quando as ligações permanecem em Keep-Alive e quando se fecham. Um ligeiro excesso de provisionamento de threads ajuda a absorver picos curtos sem sobrecarregar a máquina. Ao mesmo tempo, verifico os registos de erros em busca de mensagens como „server reached MaxRequestWorkers“. Assim, obtenho um harmonioso Interação entre a fila de eventos e o conjunto de trabalhadores.
Monitorização e métricas
Boas métricas garantem uma análise fiável Capacidade. Ativo o mod_status e acompanho os workers ativos, inativos e em espera. O painel de controlo mostra se há pedidos em espera ou se há recursos disponíveis. Além disso, medo o número de processos e threads, a utilização da RAM e a E/S de rede. Uma análise visual ajuda a identificar tendências e pontos de viragem. Mais detalhes são fornecidos pelo Apache Scoreboard.
Correlaciono estes valores com os registos de acesso e os códigos de erro. Se as taxas de erros 5xx aumentarem em simultâneo com uma carga máxima, os limites estão frequentemente demasiado baixos. Se os tempos de espera aumentarem, verifico os serviços de backend, a resolução de DNS e os percursos de rede. Também analiso os backlogs de TCP e as retransmissões SYN em situações de carga elevada. Desta forma, consigo determinar se o Causa no servidor Web, no backend ou na rede.
HTTP/2, proxy inverso e módulos
O HTTP/2 agrupa vários fluxos numa única ligação, o que reduz o Evento- arquitetura de forma ideal. Presto atenção ao equilíbrio entre os limites de fluxos e o conjunto de threads, para que muitos fluxos pequenos não fiquem em filas de espera. Como proxy reverso, o Apache beneficia de tempos de espera reduzidos e de ligações fiáveis ao backend. No entanto, os módulos que funcionam de forma fortemente bloqueante podem ocupar threads e diminuir essas vantagens. Por isso, verifico a compatibilidade e substituo componentes desatualizados caso estes provoquem picos de latência.
Os módulos de cache e a compressão aumentam a eficiência, desde que os perfis da CPU sejam adequados. A otimização TLS com algoritmos de encriptação modernos e a priorização do HTTP/2 contribuem para uma entrega mais rápida. Utilizo a retomada de sessão e observo os custos do handshake sob carga. Para recursos estáticos, as abordagens «zero-copy» e «sendfile» funcionam bem. A Arte reside em manter a cadeia composta por TLS, fila de eventos, worker e backend o mais simples possível.
Fluxo interno e estados no evento MPM
Para compreender os processos internos, penso em condições: aceitar → legível → em processamento → gravável → manter ativo → fechar. Os threads de escuta monitorizam os sockets através de mecanismos eficientes do kernel (epoll/kqueue) e só ativam os threads de trabalho quando ocorre um evento. Após o processamento de um pedido, a camada de eventos decide se a ligação deve ser colocada em „keep-alive“, encerrada diretamente ou submetida a um encerramento semelhante a um „lingering close“, para que os pacotes TCP tardios sejam processados de forma adequada. Este autómato de estados evita a «espera ativa» e minimiza as mudanças de contexto.
O importante aqui é a separação entre Tempo de espera de E/S e trabalho da CPU: a análise da solicitação, os pipelines de filtragem (por exemplo, compressão) e a geração da resposta são executados em threads de trabalho. A simples espera pela disponibilidade de leitura/gravação permanece no ciclo de eventos. Desta forma, o Apache aproveita melhor as threads existentes e reduz a Densidade dos fios por ligação aberta, de forma drástica.
Tenho também em conta o comportamento do Scoreboard: no mod_status, é possível observar fases como „R“ (Reading), „W“ (Sending Reply), „K“ (Keepalive) e „G“ (Gracefully finishing). Uma elevada proporção de „K“, em simultâneo com workers livres, indica que a fila de eventos está a ser gerida corretamente e que não há desperdício de threads. Se os tempos de „R“ aumentarem significativamente, isso pode indicar que existem clientes lentos ou tempos limite de leitura demasiado restritivos, o que sugere que há potencial para otimização.
Planeamento de recursos: exemplo de cálculo e valores predefinidos adequados
Calculo o Paralelismo composto por CPU, RAM e carga de trabalho. Um exemplo: 8 vCPU, 16 GB de RAM, conteúdos principalmente em cache e PHP-FPM no backend. Começo com MaxRequestWorkers entre 512 e 768, ThreadsPerChild entre 32 e 64 e, consequentemente, ServerLimit entre 8 e 12. Prevejo 1–3 MB de sobrecarga do Apache, mais os módulos, por cada worker ativo, aos quais se somam os buffers de resposta, a sobrecarga do TLS e os sockets do backend. De forma realista, reservo 4–8 GB para processos/threads do Apache, 2–4 GB para a cache do SO e o restante para os backends. Tenho o cuidado de garantir que ServerLimit × ThreadsPerChild nunca seja inferior a MaxRequestWorkers; é aconselhável manter alguma margem.
Visão geral das diretrizes úteis: – MinSpareThreads/MaxSpareThreads: Mantém a reserva de forma a que os picos de carga sejam absorvidos sem necessidade de um „arranque a frio“, mas sem que demasiados threads inativos ocupem memória. – MaxConnectionsPerChild (também conhecido como MaxRequestsPerChild): Um ciclo de vida finito por processo ajuda a evitar a fragmentação da memória e fugas de memória em funcionamento prolongado (por exemplo, 5k–20k). – Máximo de pedidos mantidos ativos: Limita o número de pedidos por ligação; valores moderados protegem contra sessões „infinitas“, sem comprometer os benefícios do Keep-Alive (por exemplo, 100–1000). – Tempo limite, Tempos limite de leitura/gravação e ProxyTimeout: Evitar bloqueios; defino valores diferenciados por contexto, em vez de ser demasiado conservador a nível global.
Para ficheiros estáticos, utilizo EnableSendfile e Ativar MMAP De forma consciente: nos discos locais, ambas as opções podem trazer vantagens; em volumes NFS/na nuvem, desativo frequentemente o sendfile para evitar casos extremos. Em percursos TLS, o sendfile tem, por natureza, menos efeito, uma vez que os dados passam por canais de encriptação; aqui, o que conta acima de tudo é uma eficiente Cadeia de filtros.
Limites do sistema operativo e da rede
A melhor arquitetura de eventos serve de pouco se os limites do sistema operativo a travarem. Verifico: – Descritores de ficheiros (ulimit -n): O valor deve ser bastante superior ao número máximo de ligações simultâneas mais os sockets do backend; várias dezenas de milhares são comuns em hosts muito ativos. – OuvirBacklog: Uma fila de aceitação (Accept-Backlog) suficientemente grande evita que os SYNs sejam rejeitados nos picos de tráfego. – Backlogs do kernel (por exemplo, somaxconn) e filas SYN: têm de corresponder à taxa de „burst“ prevista. – Buffer de rede (rmem/wmem): Não exagerar, mas dimensionar de forma a que as ligações com RTT elevado ou com elevada largura de banda não entrem em colapso.
Distribuo a carga de aceitação por meio de vários threads de escuta e, normalmente, deixo que a plataforma escolha o mecanismo de aceitação (AcceptMutex auto). Em sistemas que suportem essa funcionalidade, é possível SO_REUSEPORT (dependendo da plataforma, através da opção de lista) suavizar os percursos de aceitação. É importante evitar situações do tipo «Thundering Herd», em que muitos threads disputam a mesma aceitação.
Também Portas efémeras TCP (ip_local_port_range) e o comportamento do TIME-WAIT têm de corresponder ao número de ligações proxy paralelas. Evito ajustes agressivos, mas faço testes realistas e asseguro-me de que os backends utilizam o Keep-Alive, para que as ligações possam ser reutilizadas e haja menos mudanças de porta.
Subtilezas do proxy reverso: conjuntos de ligações e back-ends
Como proxy reverso, o desempenho global depende fortemente da estabilidade das ligações ao backend. Eu garanto que Ligações por proxy Mantenha a persistência (Keep-Alive para o backend) e dimensione os conjuntos de backends de forma a acompanharem o paralelismo do frontend. Conjuntos demasiado pequenos causam congestionamento no frontend; conjuntos demasiado grandes geram uma carga desnecessária na aplicação.
Medidas práticas: – ProxyTimeout: Mais curto para percursos não críticos, mais longo para pontos finais „dispendiosos“ – diferenciar, não generalizar de forma global. – Equilibrador-Configurações (no mod_proxy_balancer): pesos, número máximo de ligações por backend, intervalos de repetição sensíveis ao estado de funcionamento. – mod_proxy_fcgi para o PHP-FPM: O FPM-pm.*- Os valores (pm.max_children, pm.start_servers, etc.) têm de estar em consonância com a paralelização do Apache, para evitar picos de erros 502/504.
Certifico-me de que os erros do backend são escalados de forma clara e rápida, em vez de sobrecarregarem os threads do frontend. As verificações de integridade, uma política de novas tentativas cautelosa e padrões semelhantes aos circuit breakers mantêm as latências estáveis. Sempre que possível, garanto que Cache de respostas nos locais adequados, para que o Event MPM possa enviar, sobretudo, respostas curtas e sucintas.
Ajuste fino do HTTP/2 no Event
Para o HTTP/2, além do TLS, otimizo sobretudo Limites de transmissão e atribuição de workers. Muitos pequenos fluxos por ligação podem reduzir a latência, mas aumentar a carga dos threads. Defino o número máximo de fluxos por sessão de forma a que a multiplexação funcione, mas sem que se crie um substituto do „head-of-line“. Além disso, aumentei o número de workers de forma conservadora, para que as fases de pico sejam amortecidas sem esgotar a RAM.
Tenho notado que, muitas vezes, os streams ficam em espera, apesar de haver threads disponíveis. Quando isso acontece, na maioria das vezes são os limites dos streams ou os tamanhos dos buffers que restringem o débito. Um Definição de prioridades A otimização de recursos críticos (por exemplo, CSS/JS através de prioridades HTTP/2) contribui diretamente para o desempenho percebido. No que diz respeito ao TLS, a retomada de sessão, mecanismos semelhantes ao 0-RTT (desde que seguros e disponíveis) e algoritmos de encriptação modernos reduzem os custos do handshake.
Robustez: tempos de espera, proteção contra Slowloris e encerramento gradual
Eu ativo mod_reqtimeout, para mitigar padrões semelhantes aos do «slow loris». Os tempos limite de leitura impedem que os clientes enviem bytes a um ritmo extremamente lento, ocupando assim recursos. Os tempos limite de escrita protegem contra ligações lentas em direção ao cliente. Estes valores devem ser selecionados em função do contexto – as APIs requerem perfis diferentes dos necessários para o download de ficheiros de grande dimensão.
Para implementações e reinícios, aposto em Gracioso-Processos. Com um „graceful timeout“ adequado, os processos antigos são encerrados de forma controlada, enquanto os novos processos assumem o controlo. Desta forma, as ligações „keep-alive“ permanecem estáveis e a fila de eventos processa a carga remanescente sem interrupções abruptas. Registos rotativos, baixo nível de detalhe nos registos durante os picos (por exemplo, «info» em vez de «debug») e, opcionalmente, BufferedLogs reduzem significativamente a carga de E/S.
Detecção de falhas sob carga: identificar padrões
Sintomas típicos e abordagens: – Elevada P95/P99- Latências com workers livres: na maioria das vezes, tempos de espera do backend ou da rede; verificar os timeouts do proxy e de leitura, bem como os pools do backend. – „server reached MaxRequestWorkers“: paralelismo insuficiente – aumente o valor de MaxRequestWorkers e/ou ThreadsPerChild; verifique a pegada de RAM. – Muitos Manter em permanência- Ligações, poucos threads ativos, mas mesmo assim lento: módulos/filtros que frequentemente bloqueiam ou estrangulamentos no backend; analisar a cadeia de filtros, verificar a saturação da CPU e as E/S. – Picos de erros 5xx com carga TLS correlacionada: handshakes limitados pela CPU – otimizar os algoritmos de encriptação, a retoma de sessão e, se necessário, o offload.
Identifico os pontos de estrangulamento ao longo da cadeia: aceitação de sockets (backlog), loop de eventos (estados de espera), workers (limitados pela CPU), filtros (limitados pela E/S), proxy (limitado pelo backend). Este modelo de pensamento impede que eu altere o valor de `MaxRequestWorkers`, quando, na verdade, o problema está no backend.
Lista de verificação prática e obstáculos típicos
Trabalho com uma curta Lista de controlo: versão atual do Apache, MPM Event ativo, limites bem dimensionados, tempos de espera adequados. Em seguida, verifico as taxas de Keep-Alive e a relação entre ligações e threads ativos. Verifico se os módulos são seguros em termos de threads e se os filtros não causam bloqueios prolongados. Para o PHP via FPM, certifico-me de que os workers do FPM se adequam ao paralelismo do front-end. Da mesma forma, calibro os limites do sistema operativo, tais como descritores de ficheiros, backlog TCP e parâmetros do kernel para os buffers de rede, para que o Condutas não pare.
Reconheço rapidamente os obstáculos mais comuns: KeepAliveTimeouts demasiado elevados, MaxRequestWorkers demasiado reduzidos, ThreadsPerChild baixos ou registo inadequado. Um registo excessivamente detalhado consome I/O e atrasa as respostas. Um tamanho de pool do backend do proxy demasiado pequeno anula o ajuste do frontend. Configurações incorretas do TLS prolongam desnecessariamente os handshakes. Quem resolver bem estes pontos consegue criar uma fiável Base para latências constantes.
Resumo para os responsáveis pela área técnica
O Event MPM separa claramente a gestão de ligações da execução e aposta numa Fila de eventos, que gestiona de forma eficiente as ligações inativas. Desta forma, o Apache consegue escalar com muitos clientes simultâneos, sem deixar threads pendentes. A combinação certa entre MaxRequestWorkers, ThreadsPerChild e tempos de espera bem definidos mantém a latência e o consumo de RAM sob controlo. Com monitorização contínua, testes de desempenho e alguns ajustes específicos, cria-se um sistema que absorve picos de tráfego e responde de forma consistente. Quem seguir estes princípios tirará o máximo partido do seu Apache- A instalação oferece muito mais funcionalidades, mantendo-se, ao mesmo tempo, compatível com as aplicações e protocolos mais comuns.


