 Saltar para o conteúdo

O «Adaptive Flushing» no MariaDB controla a velocidade a que eu Páginas sujas escreva do buffer pool para o suporte de dados, para que o redo log nunca se torne um gargalo. Quando otimizo o Adaptive Flushing do MariaDB, os picos de latência diminuem, o Ponto de controlo- O progresso mantém-se estável e a carga de escrita continua a ser previsível.
Pontos centrais
- Valores medidos Em primeiro lugar: nível de preenchimento do Redo Log, percentagem de páginas sujas, idade do ponto de verificação
- Capacidade de E/S determinar com precisão, não estimar
- Valores de limiar Configurar de forma adequada: adaptive_flushing_lwm e Dirty-Page-LWM
- E/S em segundo plano dosagem: io_capacity e io_capacity_max
- Registos de repetição dimensionar adequadamente para garantir um fluxo uniforme
Como funciona o Adaptive Flushing no MariaDB
Ativo a lógica dinâmica através de innodb_adaptive_flushing e orienta o comportamento de alerta precoce com innodb_adaptive_flushing_lwm. Quanto mais cheio estiver o Redo Log e quanto mais rapidamente crescer, mais agressivamente o InnoDB efetua o flush, para evitar que surja um estrangulamento. Esta regra vincula a taxa de flush ao débito real de alterações, o que faz com que os picos curtos de E/S ocorram com menos frequência. De acordo com a documentação do MariaDB, a intensidade é orientada pelo progresso do ponto de verificação, para evitar tempos de espera nas operações de gravação no disco. Tenho sempre em mente que o Adaptive Flushing distribui o trabalho, mas não compensa um desempenho de memória insuficiente.
Compreender os indicadores-chave: Redo-Log, páginas sujas e pontos de verificação
Primeiro, observo o nível de enchimento, em percentagem, do Registos de reversão, a taxa de páginas sujas no buffer pool e a idade do checkpoint. Estes três parâmetros indicam-me se o servidor consegue efetuar o flushing atempadamente e de forma uniforme ou se o trabalho se acumula. Se a idade do ponto de verificação aumentar demasiado depressa, o Adaptive Flushing entra em ação, mas, nesse caso, verifico também a latência do armazenamento. Para questões mais detalhadas sobre a estratégia de E/S, ajuda-me dar uma vista de olhos nos Métodos de limpeza, porque determinam a eficiência com que o kernel processa os comandos de escrita. Associo estes sinais à capacidade de E/S medida, para poder efetuar alterações nos valores-limite de forma direcionada e garantir que o sistema como um todo se mantém coerente.
Ajustar corretamente os parafusos de regulação
Começo por innodb_io_capacity e defina o valor próximo da potência contínua real do acumulador, e não dos máximos teóricos. No que diz respeito aos picos, considero que innodb_io_capacity_max significativamente mais elevado, para que o InnoDB consiga acelerar momentaneamente em situações de carga elevada, sem sobrecarregar a CPU. O valor limite innodb_adaptive_flushing_lwm Configurei de forma a que o servidor comece o preflushing bem antes de o Redo Log ficar cheio. Além disso, defino innodb_max_dirty_pages_pct_lwm de forma a que o InnoDB tome medidas corretivas atempadamente à medida que a proporção de páginas sujas aumenta, evitando assim a ocorrência de congestionamentos. Altero apenas um parâmetro por ciclo, registo meticulosamente o efeito e dou ao sistema tempo para passar por várias fases de carga antes de prosseguir com a otimização.
Medir concretamente a capacidade de E/S
Medei o desempenho contínuo de gravação durante a carga de produção, porque os testes sintéticos de pico muitas vezes criam falsas expectativas e o Uniformidade ocultar. O que é significativo são as médias e os percentis a médio e longo prazo, que resistem a suavizações de curto prazo. Analiso os Write-IOPS, o Write-Throughput, as latências e a distribuição dos tempos de resposta, para não me limitar apenas ao valor médio. Quem se baseia apenas no valor máximo corre o risco de fases de flush agressivas, enquanto as transações propriamente ditas ficam mais lentas. Tiro conclusões para innodb_io_capacity com base no comportamento a longo prazo observado, e não em recordes de curta duração.
Visão geral dos valores iniciais e dos valores-limite
Utilizo os valores iniciais como ponto de partida, nunca como dogma, e comparo-os com a carga de trabalho real, o tamanho do buffer pool e o crescimento do Registos de reversão. Os sistemas SSD e NVMe apresentam valores claramente mais elevados do que os HDDs, mas defino as taxas apenas ao nível necessário para que os acessos de leitura não fiquem na fila. Para sistemas com elevada carga, aumento gradualmente a capacidade e observo em conjunto a latência, a idade dos pontos de verificação e o consumo da CPU. Se a taxa de páginas sujas diminuir de forma constante e os picos no nível de preenchimento do registo de repetição se reduzirem, considero que estou numa margem de segurança saudável. Para mim, continua a ser fundamental que eu Dicas controlar, em vez de as sobrepor com E/S em segundo plano excessiva.
| Variável | Efeito | Valor inicial típico do HDD | Valor inicial típico do SSD | Valor inicial típico do NVMe | Em que é que presto atenção |
|---|---|---|---|---|---|
| innodb_adaptive_flushing | Ativa a limpeza dinâmica | ON | ON | ON | Compensação de picos |
| innodb_adaptive_flushing_lwm | Pré-lavagem precoce | 20–30% | 20-40% | 30–50% | Nível de preenchimento do registo de repetição |
| innodb_io_capacity | Taxa de lavagem de base | 100-300 | 800–2000 | 2000–8000 | IOPS de gravação contínua |
| innodb_io_capacity_max | Limite de emergência | 400–800 | 2000-6000 | 6000–20000 | Remover as pontas |
| innodb_max_dirty_pages_pct_lwm | Página suja - Nível baixo de água | 5–10% | 5–15% | 5–15% | Medidas corretivas precoces |
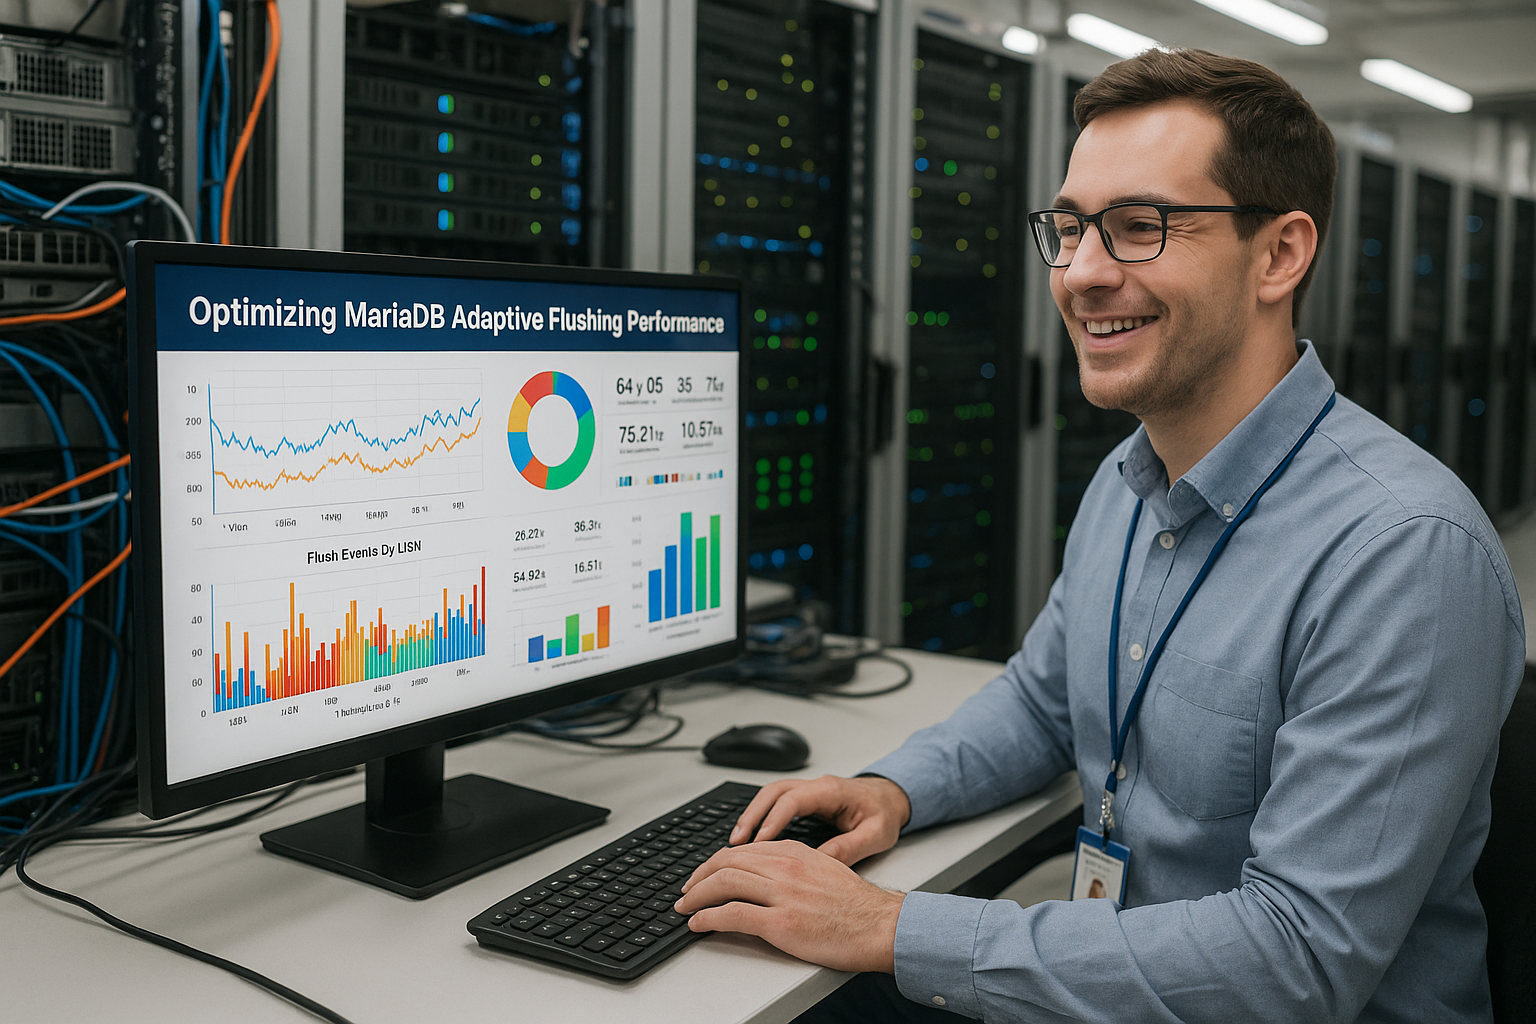
Identificar casos problemáticos e sintomas
Quando eu Descarga-Quando vejo picos, verifico primeiro o valor de I/O: se estiver demasiado baixo, as páginas sujas acumulam-se e o sistema tem de as limpar rapidamente. Se o valor estiver demasiado alto, o I/O em segundo plano sobreponha-se à carga de trabalho ativa e obriga as leituras a entrarem em tempos de espera. Uma «Checkpoint Age» lenta, que de repente dispara, indica-me que o servidor está a reagir com atraso. Ao mesmo tempo, um nível de preenchimento do «Redo Log» em rápido crescimento sinaliza que o lado da gravação não está a acompanhar o ritmo ou que o log tem dimensões insuficientes. Analiso estes padrões em conjunto, porque um único número raramente explica por si só o comportamento do «Adaptive Flushing».
Dimensionar o Redo-Log para uma carga uniforme
Escolho o tamanho do Registos de reversão de forma a garantir margem suficiente para picos de carga, sem que os pontos de verificação fiquem demasiado longos. Um registo maior dá à função «Adaptive Flushing» mais margem para distribuir o trabalho, mas tenho em atenção os tempos de recuperação e o orçamento de memória. Se o registo estiver a crescer a cada segundo em direção ao limite, um aumento moderado alivia a pressão e suaviza a curva de limpeza. Se o aumento não trouxer alívio, o problema reside, na maioria das vezes, numa capacidade de E/S inadequada ou numa latência de armazenamento variável. Só decido se devo aumentar novamente o tamanho do registo após períodos de observação, e não com base em instantâneos.
Page Cleaner: Threads e paralelismo
Estou a verificar o número de threads do Page Cleaner, porque representam o processamento paralelo Descarga- Controlar o desempenho das instâncias do buffer pool. Em caso de cargas de escrita elevadas, um maior paralelismo proporciona mais rendimento, mas acompanho de perto a fila de armazenamento. Se o disco perder a sua eficácia devido a filas sobrecarregadas, reduzo o número de threads ou limito a capacidade de E/S. Para compreender melhor este mecanismo, a visão geral ajuda-me a Threads do Page Cleaner, para que eu consiga manter o equilíbrio entre pressão e justiça. Tomo decisões de forma pragmática: tantos tópicos quantos forem necessários, mas o mínimo possível, para que as leituras não fiquem para trás.
Buffer de gravação dupla: segurança vs. velocidade de gravação
Tenho em conta o Doublewrite-O buffer, uma vez que protege contra erros parciais de gravação, mas implica um custo adicional em termos de E/S. Em sistemas NVMe fiáveis, esse custo adicional tem um impacto menor, enquanto que em armazenamento mais lento é mais percetível. Medei o impacto real nas latências e na taxa de esvaziamento de páginas antes de ajustar esta configuração. Para uma avaliação fundamentada, recorro a informações mais aprofundadas sobre o Buffer de gravação dupla e analiso se existe outro perfil de risco e de desempenho que se adapte melhor. Nunca tomo decisões de ânimo leve, porque a segurança dos dados e o débito estão aqui em interação direta.
Monitorização e métricas na prática
Analiso a percentagem de páginas sujas, a relação entre a taxa de flush e a taxa de alteração e a evolução da Ponto de controlo-Age. Além disso, observo a percentagem de utilização do Redo Log ao longo do tempo, pois um aumento linear indica que se estão a aproximar de valores-limite. Acompanho as latências de E/S juntamente com as estatísticas do InnoDB, para poder atribuir com precisão a causa e o efeito. Após cada alteração de parâmetro, comparo janelas de carga idênticas; caso contrário, tiro conclusões erradas. Documento as curvas, porque uma imagem revela mais do que um único ponto de medição e, assim, consigo identificar com segurança quebras de tendência.
Plano de afinação passo a passo
Começo por fazer uma avaliação realista da Taxa de escrita e, a partir disso, defino o valor de `innodb_io_capacity`. Em seguida, defino `innodb_io_capacity_max` como uma solução provisória para situações de pressão, mantendo uma margem suficiente em relação ao valor base. Em seguida, verifico o parâmetro `innodb_adaptive_flushing_lwm` e reduzo o seu valor se a idade do ponto de verificação (Checkpoint-Age) demorar a diminuir. Depois, defino o parâmetro `innodb_max_dirty_pages_pct_lwm` de forma a que o pré-flushing comece atempadamente e os picos sejam atenuados rapidamente. Por fim, ajusto o tamanho do redo log, observo novamente vários ciclos de carga e documento cada alteração antes de avançar para o próximo passo.
Mecanismo Flush por baixo do capô
Distingo duas motivações principais para escrever: a Limpeza da lista de flushes (impulsionado pelo progresso no Checkpoint) e o Limpeza da LRU (devido à falta de páginas livres na lista). Se o buffer pool ficar cheio e faltar páginas livres, o LRU-Flushing obriga-me a efetuar gravações imediatas, o que gera picos de latência. O Adaptive Flushing visa evitar estas situações de emergência através da limpeza contínua da lista de flush. Para que isso resulte, mantenho a proporção de páginas livres estável e monitorizo valores como a profundidade de varredura LRU e a carga por instância do buffer pool. Quanto mais uniformemente a lista de limpeza for processada, menos frequentemente terei de esperar por páginas livres em primeiro plano.
Neste contexto, tenho em conta a relação entre innodb_buffer_pool_instances, innodb_page_cleaners e da capacidade física de E/S. Um maior número de instâncias e threads de limpeza aumenta o paralelismo, mas apenas na medida em que as filas de armazenamento não fiquem sobrecarregadas. Se as operações de flush atingirem comprimentos de fila elevados, isso é um sinal de que eu deveria ter efetuado o flush mais cedo e de forma mais gradual — é precisamente isso que resolvo através do `innodb_adaptive_flushing_lwm` e das capacidades mínima e máxima.
Confirmação da transação, redo e binlog no contexto
Analiso os percursos de commit e as garantias de durabilidade no contexto do alisamento de flush. innodb_flush_log_at_trx_commit e a sincronização do Binlog influenciam a frequência com que o sistema executa fsyncs e a intensidade dos picos de curta duração. As minhas diretrizes:
- 1: Máxima durabilidade (execução do Redo em cada commit no suporte de dados). Seguro, mas exige muitos fsync e pode ser mais instável.
- 2: O Redo é atualizado a cada segundo, enquanto o Commit apenas grava na cache do SO. Os picos são menores, mas, em contrapartida, corro o risco de perder dados em caso de falha do SO ou do host.
- 0: Semelhante ao 2, mas com um armazenamento em cache ainda mais agressivo. Para sistemas de produção, utilizar apenas com precaução.
Em conjunto com a sincronização Binlog (sincronizar_binlog) e os efeitos do Group Commit, consigo agrupar commits e reduzir o número de sincronizações rígidas. É importante que eu não abuse destas ferramentas como substituto de um ajuste adequado do Adaptive Flushing. Avalio sempre em conjunto o risco, os requisitos de conformidade e o perfil de latência pretendido, e faço ajustes apenas na medida em que as regras de negócio o permitirem.
Purge-Threads, comprimento do histórico e processos de longa duração
Eu tenho a InnoDB-Purge A ter em conta: muitas linhas eliminadas ou atualizadas geram dados de «Undo» que são limpos de forma assíncrona. Se a Duração do histórico Se for intenso, o consumo de recursos em segundo plano aumenta e entra em concorrência com os «page cleaners» pela E/S. Isso pode, indiretamente, abrandar o «Adaptive Flushing». As soluções consistem em definir um valor adequado para a paralelização da purga e evitar transações de longa duração que mantenham o histórico artificialmente aberto. Além disso, planeio as operações em lote de forma a controlar o volume de Redo e Undo, em vez de alterar milhões de linhas em lotes num curto espaço de tempo.
Fases do Change Buffer e da fusão
Tenho em conta o Alterar buffer durante atualizações intensivas de índices secundários. Reduz as E/S aleatórias em tempo de execução, mas transfere parte do trabalho para fases de fusão posteriores. Estas fusões podem gerar uma carga adicional de flush, caso coincidam de forma desfavorável com picos de produção. Por isso, monitorizo o tamanho e a atividade do buffer de alterações, limito-o quando necessário e distribuo as alterações em massa de forma a que as fases de fusão não coincidam com os horários de pico. Desta forma, a taxa de esvaziamento torna-se mais previsível e uniforme.
Métodos de flush e influências do sistema de ficheiros
Decido conscientemente sobre a Método Flush e as opções do sistema de ficheiros. O_DIRECT evita a duplicação de caches e, com isso, muitas vezes suaviza as latências de gravação, enquanto as vias AIO e Fsync têm as suas próprias características. Mido o impacto destes métodos na distribuição da latência e na estabilidade do progresso do ponto de verificação e, para questões mais detalhadas, remeto para as notas sobre Métodos de limpeza. Além disso, verifico as opções de montagem do sistema de ficheiros e as rotinas de manutenção (por exemplo, estratégias consistentes de TRIM/Discard em SSDs), para garantir que a infraestrutura não introduza jitter sem que isso seja detetado.
Diagnóstico: interpretar corretamente as mensagens de estado
Eu vou MOSTRAR O ESTADO DO MOTOR INNODB para avaliar a idade do ponto de verificação e o progresso do flush. De Número de sequência do registo, Registo esvaziado até e Último ponto de verificação em Determino qual é a diferença entre as alterações geradas e as que foram persistidas. Se essa diferença aumentar continuamente a um ritmo superior ao permitido pelo tamanho do Redo Log, significa que o meu flush em segundo plano é demasiado lento ou que a latência de E/S é demasiado elevada. Comparo estes valores com as métricas do InnoDB relativas às páginas sujas, à taxa de flush e à atividade do Page Cleaner, para que possa ajustar os parâmetros adequados de forma direcionada, em vez de tratar apenas os sintomas.
Cenários operacionais: Bulk, DDL e janelas de manutenção
Estou a planear Cargas a granel e abrangentes DDL-Operações de forma a não sobrepor a função «Adaptive Flushing». Para janelas de manutenção programáveis, aumentei temporariamente innodb_io_capacity_max, para processar de forma controlada as gravações pendentes, e, em seguida, volto a reduzi-lo ao nível normal. Em importações de grande dimensão, modero as frequências de commit, para que o crescimento do redo e o avanço dos checkpoints acompanhem o ritmo. Entretanto, observo continuamente o nível de preenchimento do registo de redo, a taxa de páginas sujas e os percentis de latência, para poder tomar medidas corretivas imediatas em caso de desvios.
Equívocos comuns e anti-padrões
Não vou cair nessa armadilha, innodb_io_capacity_max utilizar como estado permanente. Um valor máximo demasiado elevado pode sobrecarregar as filas de memória e abrandar os acessos de leitura em tempo real. Da mesma forma, não „escondo“ memória fraca atrás de um registo de repetição (redo log) gigantesco – os registos maiores suavizam o tráfego, mas não criam reservas de E/S. E não aceito os picos de latência como um dado adquirido: muitas vezes são o resultado de um preflushing tardio ou de uma carga em segundo plano altamente variável, que posso atenuar através de limiares de LWM mais baixos e valores de capacidade realistas. Por fim, evito alterar vários parâmetros ao mesmo tempo; caso contrário, perco a causalidade e não consigo tornar as melhorias reproduzíveis.
Brevemente resumido
Eu uso Adaptativo Flushing, para distribuir uniformemente as operações de escrita ao longo do tempo e, assim, evitar picos de latência. O maior impacto é obtido através de uma definição precisa do parâmetro innodb_io_capacity e de uma relação adequada com o parâmetro innodb_io_capacity_max. Limites de ação precoce para o nível de preenchimento do redo log e a proporção de páginas sujas ajudam-me a manter as filas de espera pequenas. Com redo logs adequados, um paralelismo razoável dos threads do Page Cleaner e uma monitorização atenta, consigo criar rotinas de gravação mais fiáveis. De acordo com a documentação do MariaDB sobre variáveis de sistema e limpeza de páginas, estes parâmetros atuam em conjunto — ajusto-os gradualmente e acompanho o efeito até que o sistema funcione de forma estável e previsível.


