 Saltar para o conteúdo

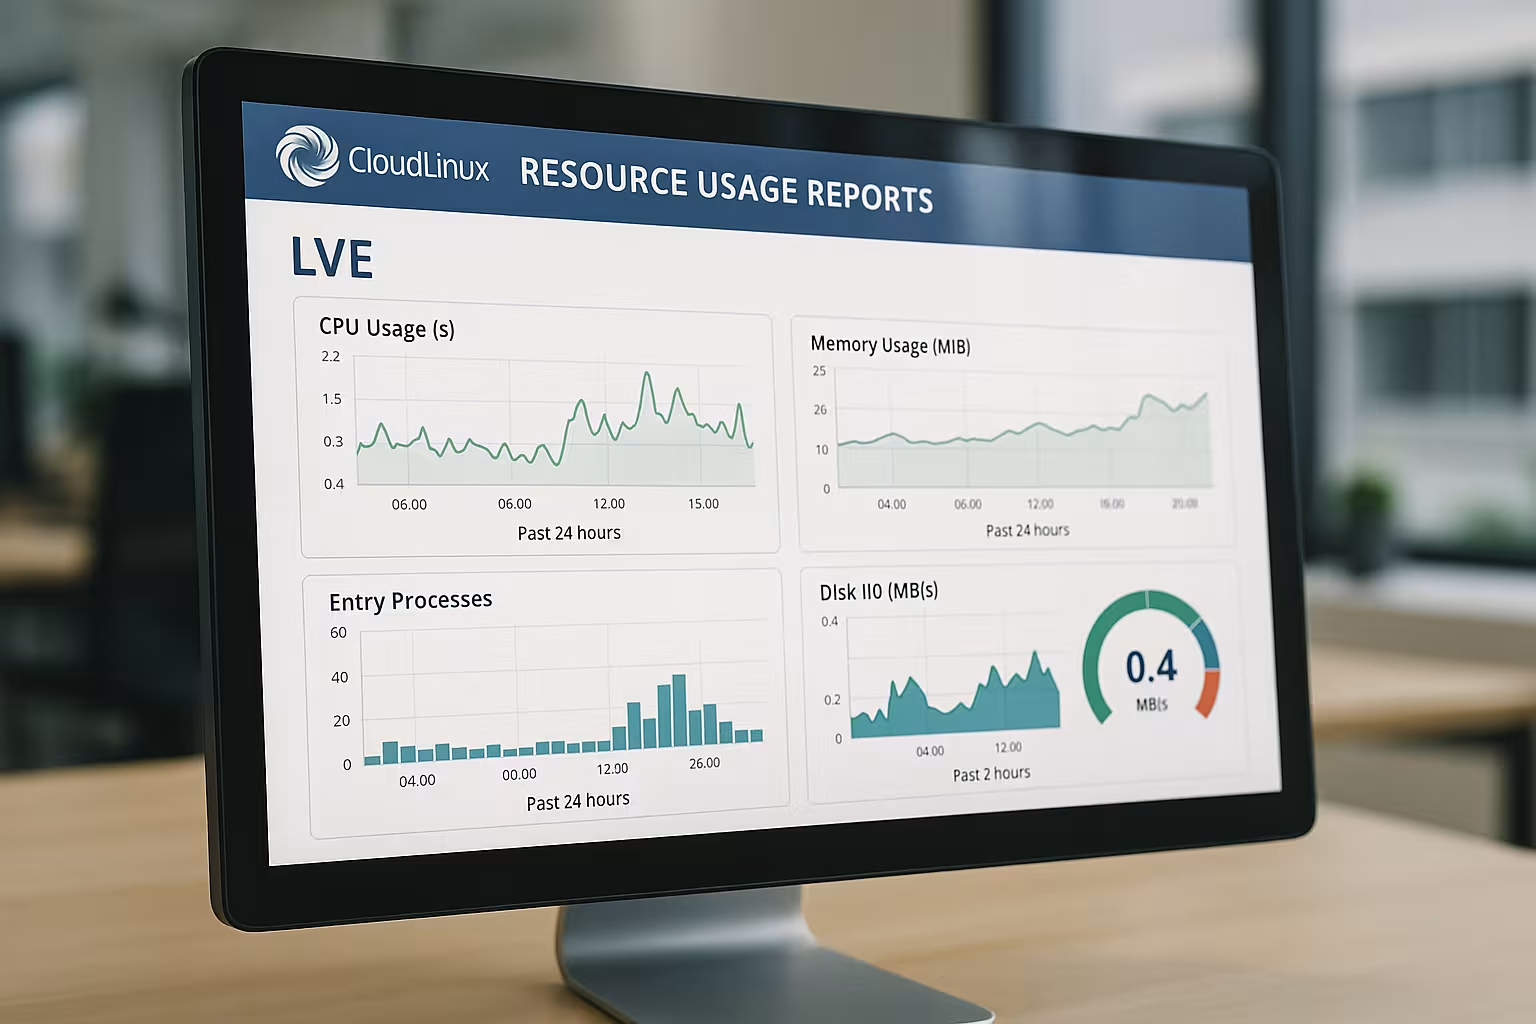
Relatórios do CloudLinux mostram-me claramente quais os limites de LVE que afetam cada conta e onde a CPU, a memória, a E/S ou os processos de entrada estão efetivamente a causar atrasos. Analiso estes dados de forma específica para identificar falhas recorrentes, padrões diários e estrangulamentos agudos e, a partir daí, definir otimizações concretas.
Pontos centrais
Vou resumir antecipadamente os pontos-chave que se seguem, para que possas iniciar a análise de forma focada.
- Indicadores LVE leia corretamente: SPEED, MEM, IO, IOPS, PNO, EP
- Dados em tempo real verificar com o LVE Manager e o lvetop
- Histórico via lveinfo, lvechart, cloudlinux-statistics
- Falhas priorizar: frequência, momento, causa
- Medidas calcular para CPU, RAM, E/S e EP
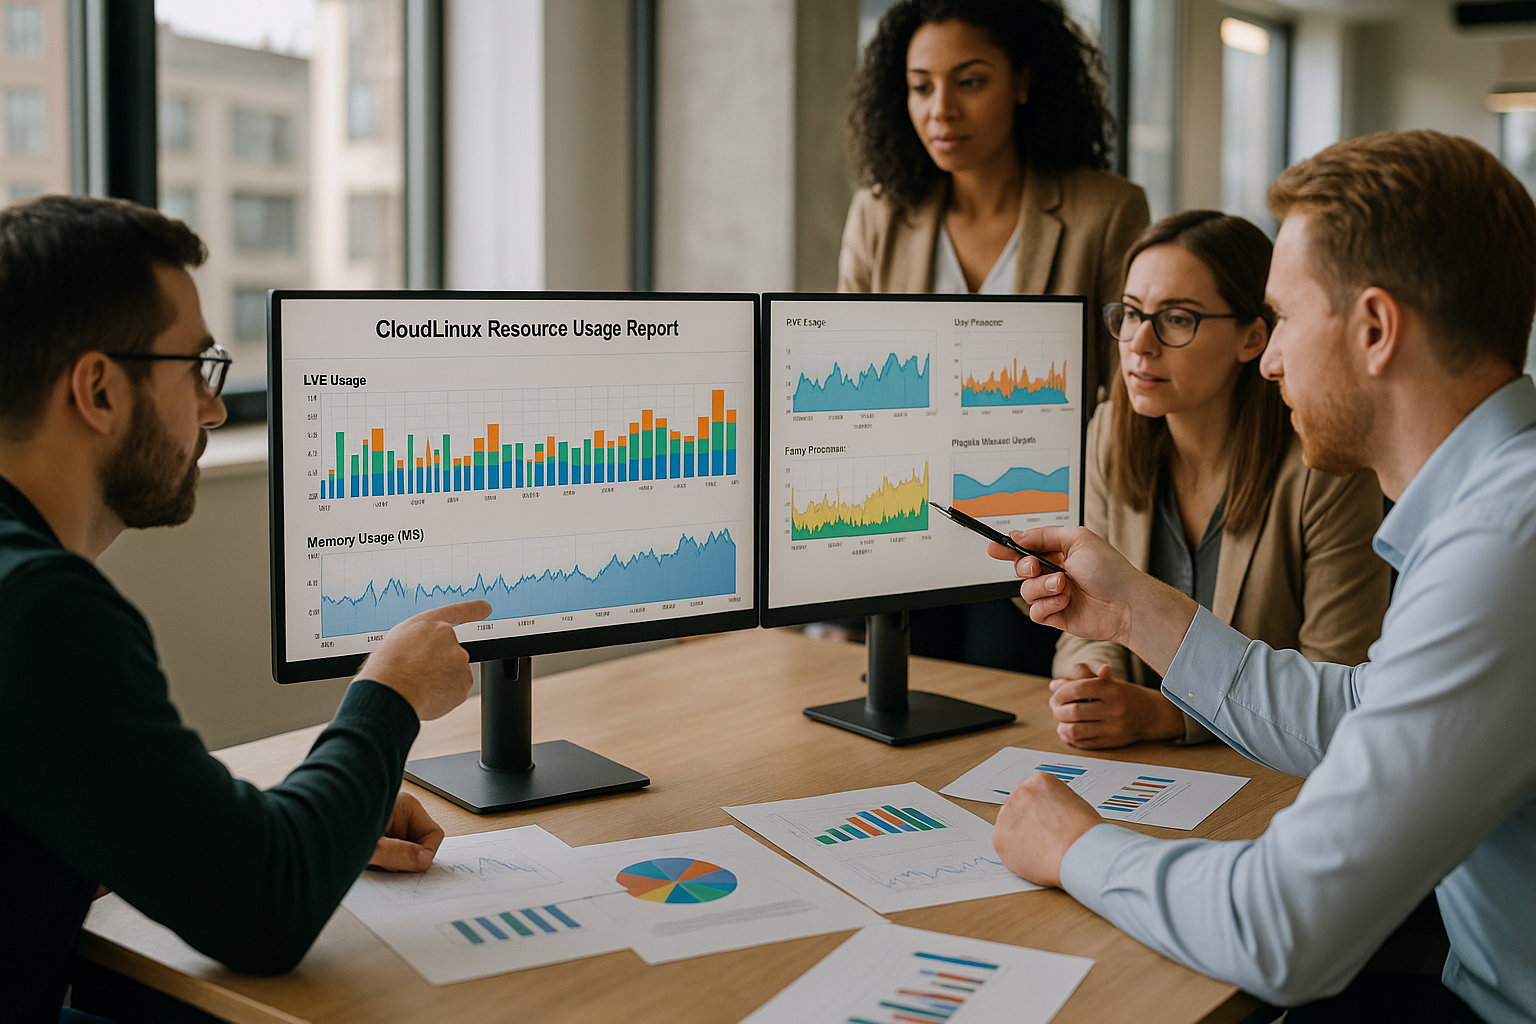
Como interpretar os indicadores certos: SPEED, MEM, IO, IOPS, PNO, EP
Começo todas as análises com os Números-chave, que o CloudLinux apresenta no contexto do LVE. SPEED descreve a potência de cálculo da CPU atribuída, MEM representa o consumo de RAM, IO a taxa de transferência de dados e IOPS o número de operações de E/S. PNO indica o número total de processos em execução, EP os processos de entrada simultâneos que limitam os acessos à Web. Quem observa valores elevados de forma persistente não tem, na maioria das vezes, um problema pontual de picos, mas sim um perfil de carga estrutural. Nesse contexto, verifico sempre se os limites são atingidos de forma contínua ou se ocorrem apenas picos isolados, que se explicam sem necessidade de limitação.
| Índice | Significado | Sintomas típicos | Primeiras verificações |
|---|---|---|---|
| VELOCIDADE | Desempenho da CPU (percentagem/limite) | Tempos de execução prolongados do PHP, tempos de espera | Verificar perfis PHP, cache de opcode e cache |
| MEM | Memória de trabalho por conta | Mortes por OOM, erro 500 sob carga | Verificar o `memory_limit` do PHP, os plugins e as consultas |
| IO | Taxa de transferência em MB/s | Transferências de ficheiros lentas (downloads/uploads) | Cache estático, compressão de ficheiros multimédia, armazenamento |
| IOPS | Número de operações de E/S | Acessos lentos à base de dados/ficheiros | Índices, plano de consulta, cache de objetos |
| PNO | Processos globais | Aumento da carga do servidor | Excessos de daemons/cron, limites de workers |
| EP | Acessos simultâneos à Web | Erro 503 no Peaks | Verificar a cache HTTP, os limites de taxa e os bots |
Monitorização em tempo real com o LVE Manager e o lvetop
Para análises imediatas, utilizo a Dados em tempo real no LVE Manager e no lvetop na linha de comandos. A vista «Current Usage» mostra-me em tempo real como estão a funcionar a CPU, a RAM, a E/S, os IOPS, os processos e os Entry Processes. Em picos de carga, observo se são os EP ou o SPEED que atingem primeiro o limite, pois isso influencia os próximos passos. O lvetop é ideal para filtrar imediatamente as contas que mais consumem recursos e, se necessário, limitá-las ou otimizá-las. Quem quiser aprofundar-se na interface pode ajustar limites e visualizações de forma específica – para isso, gosto de utilizar este guia: Configurar o LVE Manager.
Análise histórica: lveinfo, lvechart e cloudlinux-statistics
Reconheço as tendências através de Histórico e o histórico de falhas, não apenas através de instantâneos. Com o lveinfo, defino intervalos de tempo e vejo exatamente quando os limites foram acionados e com que frequência isso aconteceu. O lvechart apresenta-me picos visuais ao longo de horas ou dias, tornando visíveis os padrões ao longo do dia. O cloudlinux-statistics complementa a análise quando preciso de séries temporais mais longas por conta. A partir desta combinação, obtenho respostas às perguntas „quando“, „com que frequência“ e „em que condições“ surgem os picos de carga.
Compreender e priorizar as falhas
Um «Fault» significa: O Limite foi detetada e o CloudLinux limitou o tráfego. Por isso, ordeno as falhas primeiro por frequência, depois por tipo de recurso e hora do dia. As falhas de EP diárias à hora do almoço indicam frequentemente picos de tráfego ou bots, enquanto as falhas de RAM noturnas estão mais relacionadas com tarefas cron e cópias de segurança. Se as falhas de CPU se acumularem, procuro rotinas PHP ineficientes, caches defeituosas ou tarefas sem restrições. Esta classificação poupa tempo, porque posso aplicar otimizações exatamente onde os utilizadores sentem restrições percetíveis.
Identificar as causas: padrões típicos e medidas a tomar
Com base na minha experiência, classifico Amostra identifica rapidamente as causas concretas. Valores de EP consistentemente elevados indicam um número excessivo de pedidos simultâneos ou a ausência de cache de borda. Um consumo elevado e persistente de RAM aponta frequentemente para plugins, temas ou processos com fugas de memória. Picos de IO e IOPS indicam tarefas com grande volume de dados, consultas não indexadas ou muitos acessos a ficheiros pequenos. Para evitar interpretações erradas, verifico em paralelo os indicadores de integridade do sistema – uma forma rápida de começar é através dos Verificações de estado do CloudLinux.
Identificar tarefas cron, cópias de segurança e bots
Uma análise de muitas séries de «Fault» explica Pontos no tempo e tarefas. Se a limitação ocorrer sempre pouco depois da hora em ponto, é frequente que haja tarefas cron a decorrer em paralelo e a competir com os visitantes. Picos recorrentes durante a noite indicam frequentemente que estão a ser efetuadas cópias de segurança que esgotam a I/O e as IOPS. Falhas EP suspeitas sem tráfego correspondente na análise indicam frequentemente a presença de bots ou scrapers que contornam conteúdos estáticos. Nesses casos, defino limites de taxa, transfiro tarefas para intervalos de menor tráfego e ativo consistentemente as caches de borda ou de página.
Analisar os dados por revendedor e por conta
Em configurações maiores, separo o Níveis Claro: revendedores, os seus clientes e contas individuais. O LVE Manager permite exatamente esta visão e mostra-me qual a subárvore que está a influenciar os limites. Assim, consigo identificar se um único cliente se destaca ou se vários projetos de uma estrutura de revendedores estão a exercer pressão em simultâneo. Para os processos de suporte, seleciono as contas afetadas e defino medidas, para que os tickets recorrentes sejam resolvidos mais rapidamente. Esta transparência ajuda a distribuir os recursos de forma justa e a manter os custos por cliente compreensíveis.
Dimensionar corretamente os limites e ajustar as tarifas
Sou eu que estabeleço os limites Realista, não ao máximo. Limites de EP demasiado restritos geram erros 503, enquanto valores de SPEED demasiado baixos atrasam todas as respostas PHP. Quem observa falhas com regularidade deve verificar primeiro as otimizações e, em seguida, os planos de tarifação. Quando os projetos se tornam críticos para o negócio, vale a pena optar por um plano superior, que atenue os picos e garanta estabilidade. Documento os efeitos nos gráficos de evolução, para que a decisão permaneça compreensível.
Projetos com grande volume de dados: otimizar a E/S e as IOPS
No caso de sites baseados em bases de dados, verifico IOPS e o IO está sempre relacionado com a qualidade das consultas. Muitas consultas pequenas sem índices geram um elevado número de IOPS e prejudicam o tempo de resposta. A experiência mostra que a cache de objetos, o armazenamento em cache de consultas e os índices personalizados reduzem significativamente este fluxo. Para análises de tendências, consulto adicionalmente os relatórios da base de dados e comparo-os com os históricos do LVE. Este guia fornece-me uma introdução fundamentada sobre Relatórios do MySQL Governor, para classificar corretamente a carga da base de dados.
Manual de monitorização: do alarme à ação
A partir dos valores medidos, calculo um Manual de estratégias, que ilustra claramente cada escalada. Passo 1: Verificar em tempo real se os limites estão atualmente em vigor e qual o recurso que entra em falha primeiro. Passo 2: Abrir o histórico, comparar os intervalos de tempo e assinalar as repetições. Passo 3: Localizar a causa — caminho do código, cache, base de dados, cron, bot — e definir uma contramedida com critérios de teste. Passo 4: Após a intervenção, verificar novamente em ambiente de produção e no histórico se as falhas e a latência diminuíram. Esta sequência fixa evita ações precipitadas e garante resultados reproduzíveis.
Interpretar corretamente as interdependências dos limites
Na prática, os limites raramente são aplicados isoladamente. Por isso, avalio o Interações entre EP, SPEED, MEM e IO/IOPS: se o EP e o SPEED aumentarem simultaneamente, a CPU é, na maioria das vezes, o fator limitante por pedido; se for utilizado um cache de página ou de borda, ambos os indicadores diminuem em conjunto. Se observar um aumento no EP com um SPEED constantemente baixo, significa que as solicitações estão a acumular-se no servidor web, frequentemente devido à escassez de workers, configurações de Keep-Alive ou chamadas externas bloqueantes (por exemplo, API, e-mail). Falhas de MEM com um SPEED moderado indicam poucos processos, mas que consomem muita memória (como conversão de imagens ou exportações de grande dimensão). Picos de IO/IOPS sem carga significativa na CPU indicam acessos a ficheiros ou bases de dados com grande volume de dados. Utilizo estas correlações para primeira hipótese antes de me aprofundar nos detalhes do código ou do servidor.
Na prática: utilizar de forma eficiente o lvetop, o lveinfo e o cloudlinux-statistics
Para obter resultados rápidos, trabalho com métodos claros Consultas e filtrar. O lvetop ajuda-me, a cada segundo, a ver os principais consumidores e a alternar entre a ordenação por CPU, MEM ou IO. Com o lveinfo, defino janelas de 1 hora, 24 horas e 7 dias para listar os momentos de falha, os valores de pico e os recursos afetados por cada conta. O cloudlinux-statistics fornece-me séries temporais mais longas e é adequado para comprovar medidas (antes/depois). Documento sempre, por cada intervenção: o período, as contas afetadas, os valores máximos por recurso, o número de falhas, bem como os tempos de resposta provenientes da monitorização de aplicações ou da Web. Desta forma, consigo comprovar as otimizações e evitar que os limites sejam aliviados „por suspeita“.
Detalhes da pilha web: handlers PHP, workers e OPcache
Um importante fator de influência reside na Execução de PHP: Número de workers PHP por conta, o seu limite de RAM (memory_limit) e o OPcache. Um número excessivo de workers sem cache aumenta os valores de EP/PNO e MEM; um número insuficiente de workers provoca um congestionamento de pedidos (o EP aumenta e o tempo de resposta aumenta). Por isso, procuro encontrar um ponto ideal: tantos workers quantos forem necessários, mas o mínimo possível. O OPcache tem de ter dimensões suficientes (memória e strings internadas); caso contrário, o PHP compila constantemente de novo e prejudica a VELOCIDADE. Além disso, verifico se os recursos estáticos são realmente servidos pelo servidor web (e não pelo PHP) e se o Keep-Alive e o multiplexing HTTP/2 estão a funcionar corretamente. O objetivo é que as solicitações dinâmicas sejam reduzir e dar rapidamente seguimento aos restantes.
Aplicar de forma consistente as estratégias de cache
Distingo três níveis: Cache Edge/CDN para o alívio global, Cache HTTP/de páginas imediatamente antes do PHP e Cache de objectos dentro da aplicação. A cache de borda reduz drasticamente o EP e o IO para recursos estáticos. A cache de página reduz os acessos dinâmicos e tem um impacto direto no EP/SPEED. A cache de objetos (por exemplo, para consultas frequentes à base de dados) reduz o IOPS e a utilização da CPU. É importante que haja uma Chave de cache (por exemplo, sem cookies desnecessários), bem como TTLs adequados para cada tipo de página. Para as áreas de administração ou do carrinho de compras, prevejo exceções; em todas as outras áreas, procuro atingir a maior taxa de cache possível. Após a ativação, verifico: ocorrem erros EP? Os tempos de resposta medianos diminuem?
Gestão da RAM: memory_limit, processos e fugas de memória
As falhas MEM ocorrem frequentemente porque memory_limit é definido de forma generosa e os processos paralelos ultrapassam o limite. Por isso, faço um cálculo: de quanta RAM necessita um pedido típico? A partir daí, deduzo o número máximo razoável de workers. Além disso, mantenho as bibliotecas e os plugins PHP enxutos, removo extensões não utilizadas e verifico se os scripts de longa duração (exportações, importações, processamento de imagens) apresentam fugas de memória. O OPcache reduz a pressão sobre a RAM ao armazenar compilações em cache, mas não deve ser dimensionado de forma demasiado reduzida. Em caso de picos recorrentes, isolo os percursos „onerosos“ através da análise de desempenho e intervenho de forma direcionada — isto poupa mais RAM do que aumentos generalizados dos limites.
Reduzir de forma seletiva as operações de E/S e as IOPS
Os picos de IO/IOPS resultam de muitos pequenos acessos a ficheiros ou bases de dados. Agrupo as cargas de trabalho sempre que possível: geração de miniaturas em lote, em vez de a pedido; minimização de recursos durante a compilação, em vez de em cada pedido; e armazenamento de sessão e temporário num único Cache de objectos externalizar, para que haja menos acessos a ficheiros. Na base de dados, dou prioridade aos índices para cláusulas WHERE/JOIN frequentes e elimino as consultas N+1. Paralelamente, comparo os históricos do LVE com os relatórios da base de dados do MySQL Governor para identificar pontos críticos. O objetivo é transformar muitas pequenas IOPS em poucos acessos eficientes – o que suaviza os picos e reduz a probabilidade de falhas.
Minimizar erros de EP: enfileiramento e fluxos de visitantes
O EP limita os acessos simultâneos. Se houver muitas solicitações com caches escassas, as falhas do EP manifestam-se rapidamente. Evito isso ao Filas de espera antes de introduzir o PHP (filas de pedidos curtas no servidor web), definir o Keep-Alive de forma adequada e garantir que os caminhos dinâmicos que não são personalizados sejam sempre armazenados em cache. Para os bots, defino limites de taxa e bloqueio precocemente os «bad actors» evidentes. Além disso, verifico as chamadas de terceiros no caminho do pedido — os serviços externos que causam bloqueios aumentam o tempo de permanência por pedido e, consequentemente, consomem EP. Sempre que possível, transfiro as integrações externas para tarefas/filas.
Planear tarefas cron e cópias de segurança de forma a poupar recursos
Desvinculo as tarefas recorrentes dos horários de pico e regulo-as: desfaso as tabelas Cron (deslocando-as em minutos), evito execuções paralelas com ficheiros de bloqueio e regulo a carga através de Nicing e tamanhos de lote. Planeio as cópias de segurança para intervalos horários com pouco tráfego e procuro utilizar métodos incrementais, para que o IO/IOPS se mantenham dentro dos limites. Para tarefas complexas executadas na aplicação, defino limites para o número de trabalhadores simultâneos, para que a MEM e a SPEED não aumentem de forma brusca. Verifico o impacto ao longo do processo: as falhas noturnas diminuem? Os picos de carga reduzem-se ao fim de cada hora?
CageFS: uma visão geral do sistema de ficheiros e dos inodes
Para além dos limites LVE, influenciam Fatores relacionados com o sistema de ficheiros O desempenho: milhões de pequenos ficheiros (como fragmentos de cache) aumentam os acessos aos metadados e elevam as IOPS. Mantenho os diretórios de cache organizados, limito o excesso de ficheiros através de caches agregados de forma sensata e verifico a utilização dos inodes. O CageFS garante o isolamento, mas ficheiros temporários colocados incorretamente (por exemplo, na raiz do site em vez do diretório «tmp») aumentam desnecessariamente a E/S. Uma verificação periódica do estado destas áreas evita que os estrangulamentos de E/S sejam erroneamente interpretados como problemas exclusivamente relacionados com a CPU ou a RAM.
Transparência e comunicação no contexto dos revendedores
Em ambientes de revenda, eu documento Condutor de carga por serviço e registo as medidas: Que limites foram definidos? Que otimizações estão previstas? Como se apresentam os gráficos «antes/depois»? Esta transparência acelera as respostas do apoio técnico e cria aceitação para a mudança de plano, quando o potencial de otimização for esgotado. Estabeleço valores-limite a partir dos quais passamos a agir (por exemplo, falhas recorrentes > N/dia ou tempo de resposta mediano > X ms) e associo-os a procedimentos claros – assim, evitam-se ciclos intermináveis no sistema de tickets.
Evitar interpretações erradas frequentes
Há alguns padrões que vejo regularmente: o aumento da utilização da CPU é não uma indicação automática de „CPU insuficiente“ – muitas vezes, as caches não funcionam ou as consultas são ineficientes. Muitas falhas EP não significam necessariamente „mais tráfego“ – bots, ferramentas de monitorização mal configuradas ou heartbeats podem ser a causa. As falhas MEM nem sempre podem ser resolvidas aumentando o `memory_limit` – muitas vezes, a causa é o excesso de processos simultâneos. Os picos de IO/IOPS não dependem exclusivamente do armazenamento – são desencadeados por padrões de aplicação. Por isso, verifico sempre as hipóteses com gráficos correlacionados e, se possível, com pequenos testes de verificação (por exemplo, ativar a cache para uma subárea e verificar novamente o histórico).
Testar, medir, afiar
Avalio cada alteração com pontos de medição claros: antes/depois da ativação da cache de páginas, antes/depois da atualização do índice, antes/depois do ajuste dos workers. Para tal, utilizo o histórico do LVE, métricas de tempo de resposta e taxas de erro (5xx/4xx). Sempre que possível, realizo comparações A/B em horários de menor movimento, para isolar os efeitos colaterais. Se as falhas persistirem, repito o processo: ajusto com precisão a combinação de limites, analiso outros hotpaths e adapto os tamanhos dos lotes dos trabalhos. A experiência mostra que duas a três iterações específicas proporcionam resultados significativamente melhores do que uma única medida abrangente e genérica.
Resumo: Como ler de forma eficiente os relatórios de utilização de recursos do CloudLinux
Eu avalio CloudLinux- Os dados são sempre apresentados em três níveis: em tempo real, histórico e erros. Os indicadores SPEED, MEM, IO, IOPS, PNO e EP fornecem-me o panorama geral das causas e efeitos. Com o lvetop, vejo imediatamente quem está a causar a sobrecarga; com o lveinfo e o lvechart, identifico padrões ao longo de vários dias. A partir de erros recorrentes, deduzo medidas relacionadas com o cache, o otimização de consultas, ajustes de limites ou mudanças de tarifa. Este método reduz o esforço de suporte, aumenta a capacidade de resposta e torna o desempenho da hospedagem transparente.


