 Hoppa till innehåll

Adaptiv spolning i MariaDB styr hur snabbt jag Smutsiga sidor skriver från buffertpoolen till lagringsmediet, så att redo-loggen aldrig blir en flaskhals. När jag optimerar MariaDB Adaptive Flushing minskar latensspikarna, vilket Kontrollpunkt-Framstegen förblir stabila och skrivbelastningen förblir förutsägbar.
Centrala punkter
- Uppmätta värden Först: Redo-loggens fyllnadsgrad, andelen smutsiga sidor, checkpoint-ålder
- I/O-kapacitet fastställa exakt, inte uppskatta
- Tröskelvärden Använd på rätt sätt: adaptive_flushing_lwm och Dirty-Page-LWM
- Bakgrunds-I/O dosering: io_capacity och io_capacity_max
- Redo-loggar dimensionera på rätt sätt för ett jämnt flöde
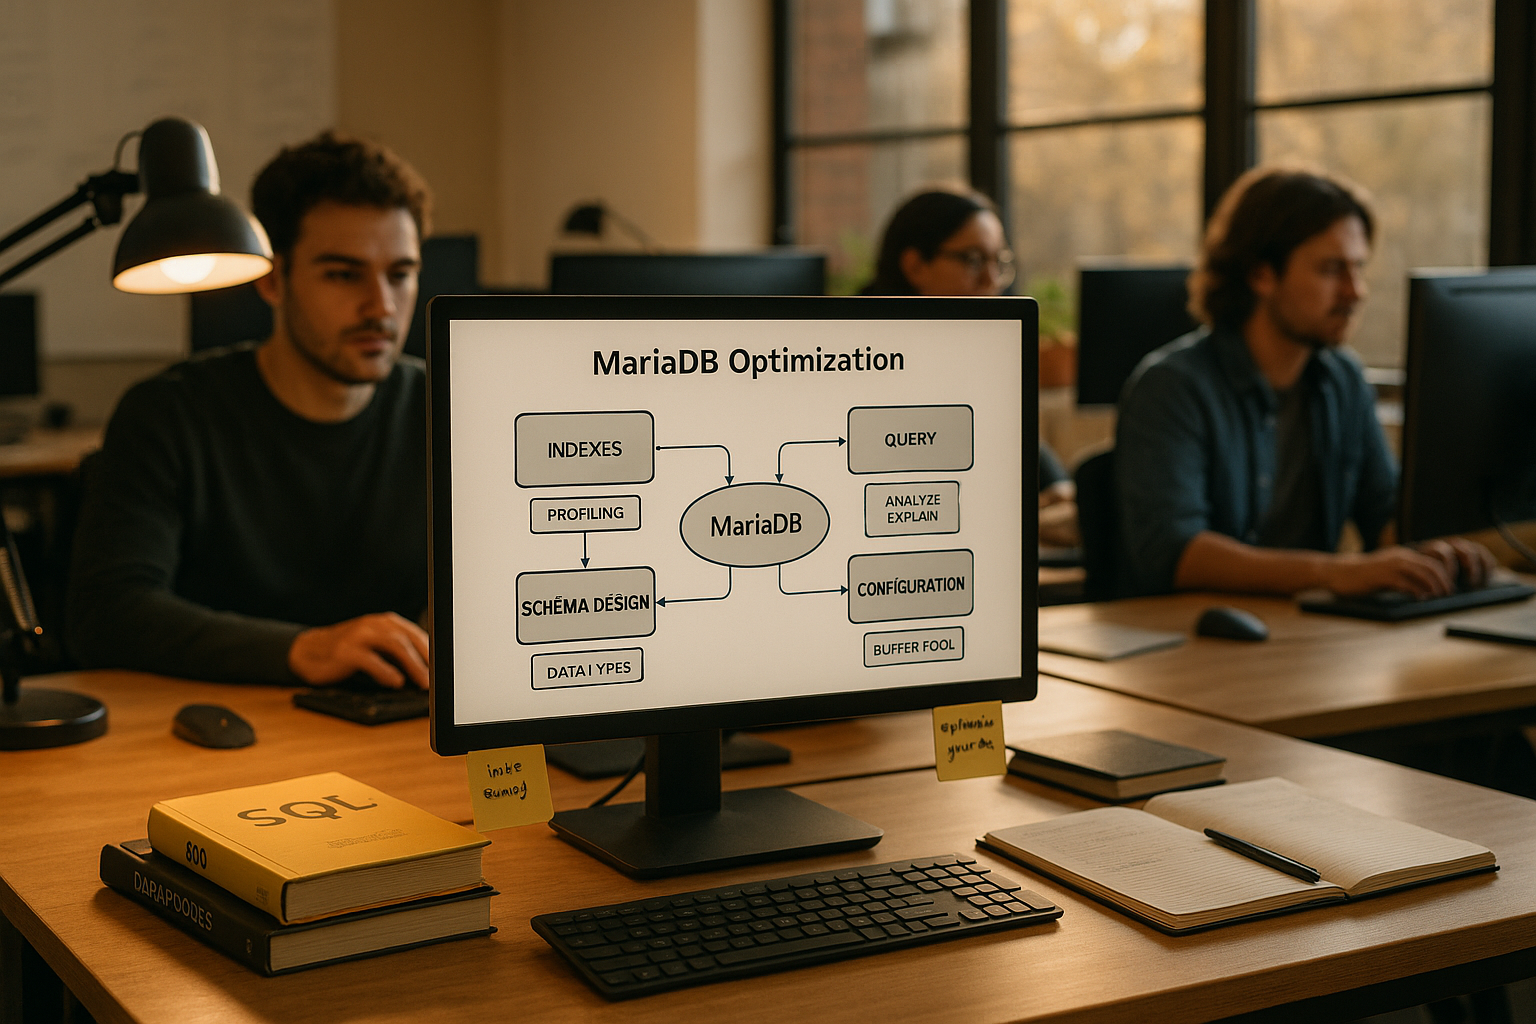
Hur Adaptive Flushing fungerar i MariaDB
Jag aktiverar den dynamiska logiken via innodb_adaptive_flushing och styra beteendet vid tidig varning genom att innodb_adaptive_flushing_lwm. Ju mer redo-loggen är fylld och ju snabbare den växer, desto mer aggressivt tömmer InnoDB den för att undvika flaskhalsar. Denna regel kopplar tömningsfrekvensen till den faktiska ändringsgenomströmningen, vilket gör att korta I/O-toppar uppstår mindre ofta. Enligt MariaDB:s dokumentation anpassas intensiteten efter checkpoint-förloppet för att undvika väntetider vid skrivoperationer till disken. Jag är medveten om att Adaptive Flushing fördelar arbetsbelastningen, men inte kompenserar för otillräcklig lagringsprestanda.
Att förstå nyckeltal: Redo-log, smutsiga sidor och kontrollpunkter
Först tittar jag på den procentuella fyllnadsgraden för Redo-loggar, andelen ”Dirty Pages” i buffertpoolen och checkpoint-åldern. Dessa tre värden visar mig om servern kan tömma bufferten i tid och jämnt eller om arbetet hopar sig. Om checkpoint-åldern ökar för snabbt aktiveras adaptiv tömning, men då kontrollerar jag dessutom lagringslatensen. För detaljerade frågor om I/O-strategin hjälper det mig att titta på de relevanta Flush-metoder, eftersom de avgör hur effektivt kärnan hanterar skrivkommandona. Jag kopplar samman dessa signaler med den uppmätta I/O-kapaciteten så att jag kan göra målinriktade ändringar av tröskelvärdena och se till att hela systemet förblir konsekvent.
Ställa in justeringsskruvarna på rätt sätt
Jag börjar med innodb_io_capacity och sätt värdet nära lagringsenhetens faktiska kontinuerliga effekt, inte nära teoretiska maximivärden. När det gäller toppbelastningar anser jag att innodb_io_capacity_max betydligt högre, så att InnoDB kan öka prestandan tillfälligt vid hög belastning utan att överbelasta processorn. Tröskelvärdet innodb_adaptive_flushing_lwm Jag ställer in det så att servern påbörjar preflushing i god tid innan redo-loggen blir full. Dessutom ställer jag in innodb_max_dirty_pages_pct_lwm så att InnoDB vidtar åtgärder i ett tidigt skede när andelen smutsiga sidor ökar och det inte uppstår några flaskhalsar. Jag ändrar bara en parameter per cykel, dokumenterar effekten noggrant och ger systemet tid att genomgå flera belastningsfaser innan jag fortsätter med optimeringen.
Konkret mätning av I/O-kapacitet
Jag mäter den kontinuerliga skrivprestandan under produktionsbelastning, eftersom syntetiska topptest ofta väcker falska förhoppningar och Jämnhet dölja. Det som är meningsfullt är medel- till långsiktiga medelvärden och percentiler som klarar korta utjämningar. Jag tittar på skriv-IOPS, skrivgenomströmning, latenser och fördelningen av svarstiderna, så att jag inte bara tittar på medelvärdet. Den som endast utgår från maximivärdet riskerar aggressiva tömningsfaser, samtidigt som de faktiska transaktionerna blir långsammare. Jag drar slutsatser för innodb_io_capacity utifrån det observerade långsiktiga beteendet, inte utifrån kortvariga toppresultat.
Översikt över startvärden och gränsvärden
Jag använder standardvärden som utgångspunkt, aldrig som ett dogm, och jämför dem med den faktiska arbetsbelastningen, storleken på buffertpoolen och tillväxten av Redo-loggar. SSD- och NVMe-system uppvisar klart högre värden än HDD-enheter, men jag ställer in hastigheterna bara så högt att läsåtkomster inte hamnar i kö. För system med hög belastning ökar jag kapaciteten gradvis och övervakar samtidigt latens, checkpoint-ålder och CPU-användning. Om andelen smutsiga sidor sjunker jämnt och svängningarna i redo-loggens fyllnadsgrad minskar, har jag nått en sund säkerhetsmarginal. Det som förblir kritiskt för mig är att jag Tips kontrollera dem, istället för att överdriva med bakgrunds-I/O.
| Variabel | Effekt | Typiskt startvärde för HDD | Typiskt startvärde för SSD | Typiskt startvärde för NVMe | Vad jag uppmärksammar |
|---|---|---|---|---|---|
| innodb_adaptive_flushing | Aktivera dynamisk tömning | ON | ON | ON | Utjämning av burstar |
| innodb_adaptive_flushing_lwm | Tidig försköljning | 20–30% | 20-40% | 30–50% | Redo-logg-nivå |
| innodb_io_capacity | Grundläggande flödeshastighet | 100-300 | 800–2000 | 2000–8000 | Kontinuerliga skriv-IOPS |
| innodb_io_capacity_max | Nödgräns | 400–800 | 2000-6000 | 6000–20000 | Slipa bort spetsarna |
| innodb_max_dirty_pages_pct_lwm | Dirty Page – Låg vattennivå | 5–10% | 5–15% | 5–15% | Tidiga motåtgärder |
Att upptäcka problemfall och symtom
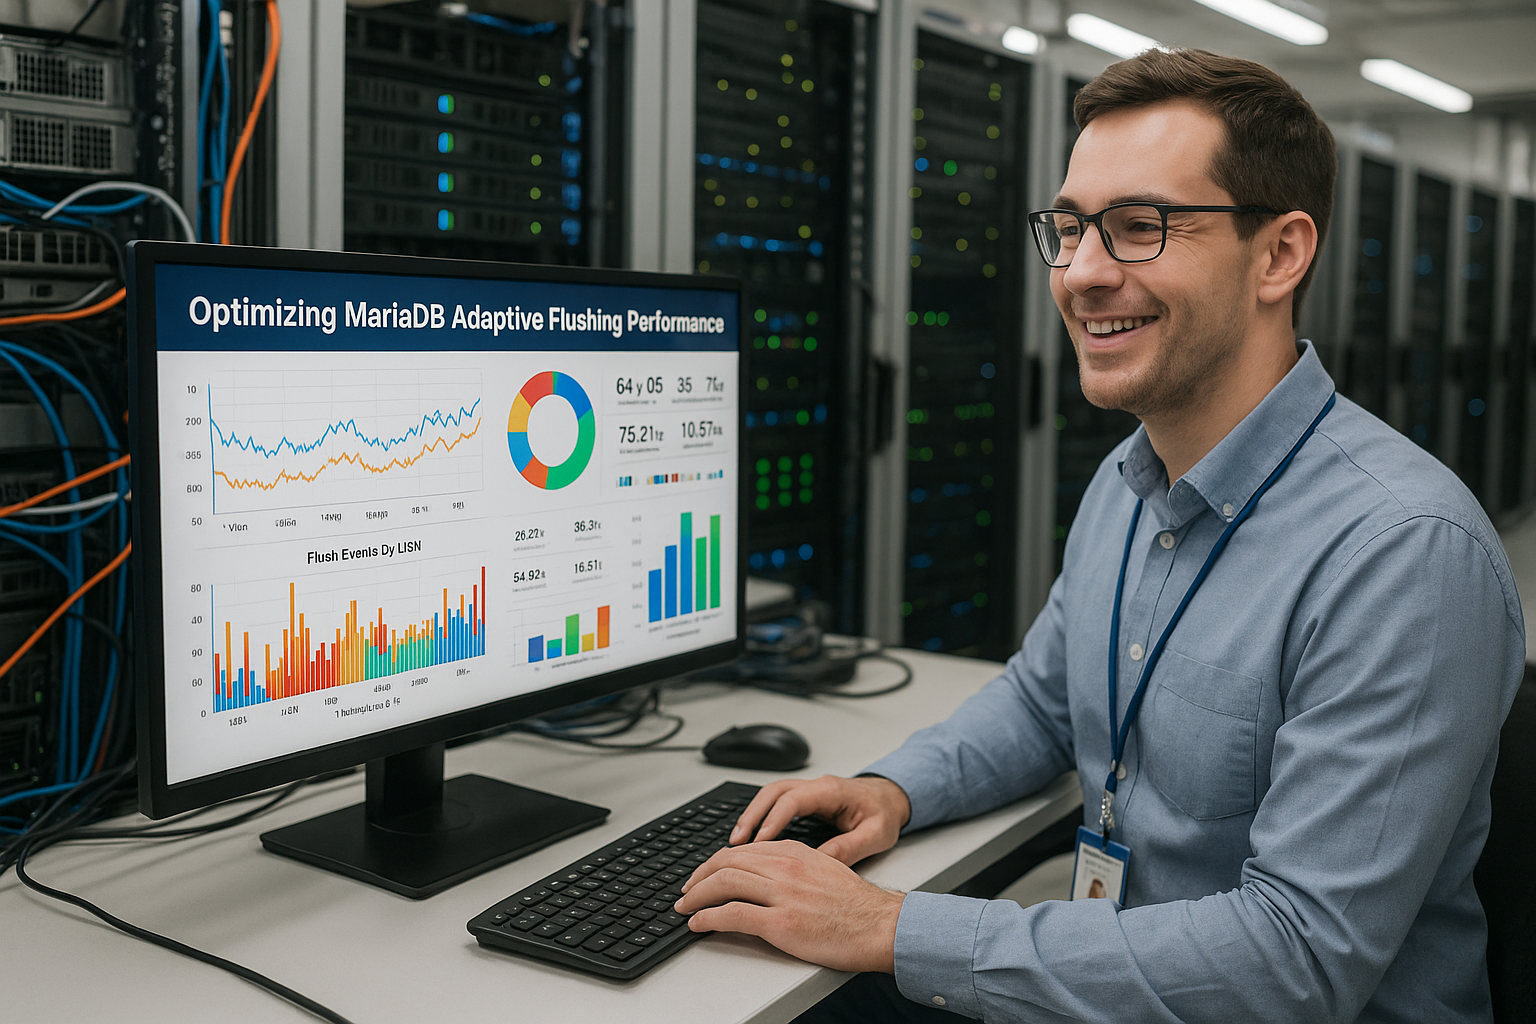
När jag Spola-När jag ser toppar kontrollerar jag först I/O-värdet: om det är för lågt hopar sig ”dirty pages” och systemet måste skynda sig att rensa upp. Om värdet är för högt överskuggar bakgrunds-I/O den aktiva arbetsbelastningen och tvingar läsoperationer att vänta. En trög checkpoint-ålder som plötsligt skjuter i höjden avslöjar att servern reagerar för sent. Samtidigt signalerar en snabbt växande redo-logg-nivå att skrivsidan inte hinner med eller att loggen är underdimensionerad. Jag tolkar dessa mönster tillsammans, eftersom en enskild siffra sällan fullständigt förklarar beteendet hos Adaptive Flushing.
Dimensionera redo-loggen för jämn belastning
Jag väljer storleken på Redo-loggar så att det finns tillräckligt med utrymme för belastningsvågor utan att kontrollpunkterna blir för långa. En större logg ger Adaptive Flushing mer utrymme att fördela arbetet, men jag håller koll på återställningstider och lagringsbudget. Om loggen växer i sekundtakt mot gränsen minskar en försiktig ökning trycket och jämnar ut flush-kurvan. Om förstoring inte ger någon avlastning ligger problemet oftast i olämplig I/O-kapacitet eller varierande lagringslatens. Jag beslutar först efter observationsperioder, inte utifrån ögonblicksbilder, om jag ska öka loggstorleken ytterligare.
Page Cleaner-trådar och parallellitet
Jag tittar på antalet Page Cleaner-trådar, eftersom de visar den parallella Spola-Styra prestandan hos bufferpoolinstanserna. Vid hög skrivbelastning ger ökad parallellitet högre genomströmning, men jag övervakar lagringskön noggrant. Om lagringsenheten tappar i prestanda på grund av överfyllda köer minskar jag antalet trådar eller begränsar I/O-kapaciteten. För att förstå bakgrunden till denna mekanism hjälper översikten över Page Cleaner-trådar, så att jag kan upprätthålla balansen mellan press och rättvisa. Jag fattar beslut utifrån pragmatiska överväganden: så många trådar som behövs, så få som är rimligt, så att läsningarna inte hamnar i bakgrunden.
Doublewrite-buffert: säkerhet kontra skrivhastighet
Jag tar hänsyn till Doublewrite-Buffert, eftersom den skyddar mot partiella skrivfel, men medför extra I/O. På tillförlitliga NVMe-system är den extra belastningen mindre kännbar, medan den märks tydligare på långsammare lagringsenheter. Jag mäter den faktiska effekten på latenser och sidutläsningshastighet innan jag justerar denna inställning. För att kunna göra en välgrundad bedömning använder jag mer ingående information om Doublewrite-buffert och undersöker om en annan risk- och avkastningsprofil passar bättre. Jag fattar aldrig beslut lättvindigt, eftersom datasäkerhet och genomströmning står i direkt samspel här.
Övervakning och mätvärden i praktiken
Jag utvärderar andelen ”Dirty Pages”, förhållandet mellan flush-frekvens och ändringsfrekvens samt utvecklingen av Kontrollpunkt-Age. Dessutom övervakar jag den procentuella utnyttjandegraden för redo-loggen över tid, eftersom en linjär ökning tyder på att tröskelvärdena snart kommer att nås. Jag håller koll på I/O-fördröjningarna tillsammans med InnoDB-statistiken, så att jag tydligt kan koppla samman orsak och verkan. Efter varje parameterändring jämför jag identiska belastningsfönster, annars drar jag felaktiga slutsatser. Jag dokumenterar kurvorna, eftersom en bild säger mer än en enskild mätpunkt och jag på så sätt säkert kan upptäcka trendbrott.
Steg-för-steg-inställningsplan
Jag börjar med en realistisk bedömning av Skrivhastighet och fastställer utifrån detta värdet för innodb_io_capacity. Därefter definierar jag innodb_io_capacity_max som en nödlösning för pressade situationer, med tillräckligt stort avstånd till basvärdet. Därefter kontrollerar jag innodb_adaptive_flushing_lwm och sänker värdet om Checkpoint-Age sjunker för sent. Därefter ställer jag in innodb_max_dirty_pages_pct_lwm så att preflushing startar i tid och toppar avtar tidigt. Till sist justerar jag storleken på redo-loggen, observerar återigen flera belastningscykler och dokumenterar varje förändring innan jag vågar ta nästa steg.
Flush-mekanism under huven
Jag skiljer mellan två huvudsakliga drivkrafter för skrivandet: den Flush-List-Flushing (drivet av framstegen i Checkpoint) och LRU-spolning (på grund av brist på lediga sidor). Om buffertpoolen blir full och det saknas lediga sidor tvingar LRU-flushing mig att utföra omedelbara skrivningar, vilket orsakar latensspikar. Adaptiv flushing syftar till att undvika dessa problem genom kontinuerlig tömning av flush-listan. För att detta ska lyckas håller jag andelen lediga sidor stabil och övervakar värden som LRU-skanningsdjup och belastningen per buffertpoolinstans. Ju jämnare flushing-listan bearbetas, desto sällare behöver jag vänta på lediga sidor i förgrunden.
Jag beaktar då sambandet mellan innodb_buffer_pool_instances, innodb_page_cleaners och den fysiska I/O-kapaciteten. Fler instanser och Cleaner-trådar ökar parallelliteten, men bara i den mån det är meningsfullt, så länge lagringsköerna inte överbelastas. Om flush-operationerna når höga köer är det ett tecken på att jag borde ha flushat tidigare och långsammare – det är just detta jag hanterar med innodb_adaptive_flushing_lwm och bas-/maxkapaciteterna.
Transaktionsbekräftelse, redo och binlog i sammanhanget
Jag undersöker commit-vägar och hållbarhetsgarantier i samband med flush-utjämning. innodb_flush_log_at_trx_commit och Binlog-synkroniseringen påverkar hur ofta systemet utför fsync-kommandon och hur kraftiga de kortsiktiga topparna blir. Mina riktlinjer:
- 1: Maximal beständighet (Redo vid varje commit till lagringsmediet). Säkert, men kräver många fsync-kommandon och kan vara något ryckigare.
- 2: Redo spolas varje sekund, medan Commit endast skriver till operativsystemets cache. Det ger lägre toppbelastningar, men i gengäld riskerar jag dataförlust vid ett operativsystem- eller värdfel.
- 0: Liknar 2, men med ännu mer aggressiv cachelagring. Bör endast användas med försiktighet i produktionssystem.
Tillsammans med Binlog-synkroniseringen (sync_binlog) och Group-Commit-effekter kan jag samla ihop commit och minska antalet hårda synkroniseringar. Det är viktigt att jag inte missbrukar dessa verktyg som ersättning för korrekt finjustering av adaptiv flushing. Jag utvärderar alltid risk, efterlevnadskrav och önskad latensprofil tillsammans och justerar endast i den utsträckning som affärsreglerna tillåter.
Rensa trådar, historiklängd och långvariga trådar
Jag har den InnoDB-rensning Att tänka på: Många rader som raderas eller uppdateras genererar ångra-data som rensas asynkront. Om Historikens längd Om belastningen ökar kraftigt ökar även bakgrundsbelastningen och konkurrerar med sidrensarna om I/O. Detta kan indirekt bromsa Adaptive Flushing. Åtgärder för att motverka detta är att ställa in ett lämpligt värde för parallelliteten vid rensning och att undvika långvariga transaktioner som artificiellt håller historiken öppen. Jag planerar dessutom batchoperationer så att jag kontrollerar mängden redo- och undo-åtgärder, istället för att ändra miljoner rader i omgångar på kort tid.
Ändringsbuffert och sammanfogningsfaser
Jag tar hänsyn till Ändra buffert vid intensiva uppdateringar av sekundärindex. Den minskar slumpmässig I/O under körning, men flyttar en del av arbetet till senare sammanfogningsfaser. Dessa sammanfogningar kan skapa ytterligare flush-belastning om de sammanfaller med produktionstoppar på ett ogynnsamt sätt. Jag övervakar därför storleken och aktiviteten i ändringsbufferten, begränsar den vid behov och fördelar massändringar så att sammanfogningsfaserna inte kolliderar med rusningstider. På så sätt blir tömningsfrekvensen mer förutsägbar och jämnare.
Flush-metoder och faktorer som påverkar filsystemet
Jag fattar medvetna beslut om Flush-metoden och filsystemets alternativ. O_DIRECT undviker dubbla cacher och jämnar därmed ofta ut skrivfördröjningarna, medan AIO- och Fsync-vägar har sina egna egenskaper. Jag mäter hur dessa metoder påverkar latensfördelningen och stabiliteten i checkpoint-förloppet och hänvisar vid detaljerade frågor till anvisningarna om Flush-metoder. Dessutom kontrollerar jag filsystemets monteringsalternativ och underhållsrutiner (t.ex. konsekventa TRIM-/Discard-strategier för SSD-enheter) för att säkerställa att infrastrukturen inte orsakar jitter utan att man märker det.
Diagnos: Att tolka statusmeddelanden korrekt
Jag drar VISA STATUS FÖR INNODB-MOTORN för att bedöma Checkpoint-ålder och hur långt Flush-processen har kommit. Från Loggsekvensnummer, Logg rensad fram till och Senaste kontrollpunkt vid Jag undersöker hur stort avståndet är mellan genererade och lagrade ändringar. Om avståndet växer kontinuerligt snabbare än vad redo-loggens storlek tillåter, är min bakgrundsflush för svag eller så är I/O-latensen för hög. Jag jämför dessa värden med InnoDB-mätvärdena för smutsiga sidor, flush-hastighet och Page Cleaner-aktivitet, så att jag kan justera rätt inställningar på ett målinriktat sätt istället för att bara behandla symptomen.
Driftscenarier: Bulk, DDL och underhållsfönster
Jag planerar att Masslast och omfattande DDL-operationer så att Adaptive Flushing inte förbigås. Vid planerade underhållsfönster höjer jag tillfälligt innodb_io_capacity_max, för att på ett kontrollerat sätt hantera kommande skrivningar, och sänker den därefter tillbaka till normal nivå. Vid stora importer anpassar jag commit-frekvensen så att redo-loggens tillväxt och checkpoint-processen håller jämna steg. Under tiden övervakar jag kontinuerligt redo-loggens fyllnadsgrad, andelen smutsiga sidor och latenspercentilerna för att omedelbart kunna vidta motåtgärder vid avvikelser.
Vanliga felaktiga antaganden och antimönster
Jag går inte i fällan, innodb_io_capacity_max att använda som ett permanent tillstånd. Ett för högt max-värde kan överbelasta minnesköerna och bromsa realtidsläsningar. Jag „gömmer“ inte heller svagt minne bakom en enorm redo-logg – större loggar utjämnar belastningen, men skapar inga I/O-reserver. Och jag accepterar inte latensspikar som ett faktum: ofta är de ett resultat av för sen preflushing eller kraftigt varierande bakgrundsbelastning, vilket jag kan mildra genom lägre LWM-trösklar och realistiska kapacitetsvärden. Slutligen undviker jag att justera flera inställningar samtidigt; annars tappar jag orsakssambandet och kan inte göra förbättringarna reproducerbara.
Kortfattat sammanfattat
Jag använder Adaptiv Flushing för att fördela skrivoperationer jämnt över tiden och därmed undvika latensspikar. Den största påverkansfaktorn är en korrekt inställning av innodb_io_capacity och ett rimligt förhållande till innodb_io_capacity_max. Tröskelvärden som aktiveras tidigt för redo-loggens fyllnadsgrad och andelen smutsiga sidor hjälper mig att hålla köerna korta. Med lämpliga redo-loggar, rimlig parallellitet hos Page Cleaner-trådarna och noggrann övervakning skapar jag mer tillförlitliga skrivrutiner. Enligt MariaDB:s dokumentation om systemvariabler och sidspolning samverkar dessa inställningsmöjligheter – jag justerar dem stegvis och håller koll på effekten tills systemet fungerar stabilt och förutsägbart.


