 Hoppa till innehåll

Apache Scoreboard visar mig i realtid hur många arbetare som just nu läser förfrågningar, skickar svar eller väntar i viloläge, och med hjälp av det utvärderar jag Serverbelastning utan gissningar. Via mod_status får jag strukturerad tillgång till statusdata, tolkar symboler, mäter genomströmningen och drar därav konkreta Steg för att trimma bilen från.
Centrala punkter
- Status i realtid alla medarbetare ska förstå och snabbt upptäcka flaskhalsar.
- mod_status Ställa in säkerheten och använda ExtendedStatus på ett meningsfullt sätt.
- Nyckeltal systematiskt utvärdera värden som Req/s, Busy/Idle och CPU.
- Symboler tolka uppgifterna på resultattavlan och vidta riktade åtgärder.
- Övervakning automatisera och ställa in larm utifrån data.
Vad är Apache Scoreboard?
I resultattavlan lagrar Apache en aktuell status för varje worker, till exempel ”Läser”, ”Skickar” eller ”Inaktiv”, och därmed kan jag se Arbetsfördelning av processerna. Uppgifterna finns internt och skickas via mod_status till gränssnittet, antingen som HTML eller i maskinläsbart format. Där kontrollerar jag upptagna och inaktiva arbetare, CPU-belastning, drifttid samt antal åtkomstförfrågningar och dataförbrukning. Jag tycker att den detaljerade översikten över enskilda arbetare är särskilt användbar, eftersom jag kan se bearbetningstid och aktiv värd. På så sätt kan jag fatta välgrundade beslut om det saknas kapacitet, om förfrågningar tar för lång tid eller om Keep-Alive-slots är blockerade; dessa Öppenhet sparar tid vid orsaksanalysen.
Så här får jag åtkomst via mod_status
Med /server-status öppnar jag en överskådlig HTML-sida; med /server-status?auto får jag en kortfattad textutskrift för Övervakning och skript. I produktiva miljöer aktiverar jag ExtendedStatus On, eftersom ytterligare mätvärden per arbetare ger mig den nödvändiga kontexten. Jag begränsar åtkomsten strikt till administratörsnätverk eller enskilda värddatorer och låter inte sidan vara offentlig. För en manuell granskning räcker det med en kort webbläsarsession, men vid kontinuerlig övervakning integrerar jag den automatiska vyn i ett övervakningssystem. På så sätt håller jag overheadkostnaderna nere och säkerställer statusdata på ett meningsfullt sätt.
Utvärdera säker konfiguration och overhead
Jag övervakar /server-status noggrant och väljer beroende på situationen mellan IP-godkännanden, autentisering eller en intern admin-VHost. ExtendedStatus orsakar mätbar, men i praktiken obetydlig Overhead; jag aktiverar den permanent om jag även använder uppgifterna i övervakningen, eller bara tillfälligt vid ad hoc-analyser. En tydlig exempelkonfiguration hjälper mig att undvika fel:
Aktivera #
ExtendedStatus On

Endast tillhandahålla #-status internt

  SetHandler server-status

  # Alternativ 1: IP-baserat
  Require ip 10.0.0.0/8 192.168.0.0/16 ::1

  # Alternativ 2: Basic-autentisering (t.ex. utöver IP)
  #AuthType Basic
  #AuthName "Server Status"
  #AuthUserFile "/etc/httpd/conf/.htpasswd"
  #Require valid-user
Jag ser till att sidan är tillgänglig även utanför produktions-VHosts (t.ex. via en intern adress), så att inga omskrivningsregler eller proxyrutter stör. När jag avslutar felsökningsfaserna kontrollerar jag att endast nödvändiga uppgifter publiceras.
Att snabbt tolka symbolerna på resultattavlan
Vid störningar tittar jag först på symbolerna, eftersom ett tätt mönster av R och W tyder på akut belastning och många _ signalerar lugn; dessa Kodning påskyndar diagnosen. K visar mig också öppna Keep-Alive-anslutningar som binder arbetare vid olämplig timeout. Om D är i fokus tyder det på DNS-uppslag som fördröjer svaren. Frekventa L-poster pekar på blockerande loggning och lagringssubsystem. Med några snabba blickar kan jag på så sätt identifiera den dominerande flaskhalsen och inleda målinriktade Åtgärder.
| Symbol | Betydelse | Snabbinformation |
|---|---|---|
| _ | Arbetare i viloläge | Tillräcklig Kapacitet finns |
| R | Begäran om läsning | Kontrollera nätverksfördröjningen eller Klient |
| W | Skickar svar | Backend-tid och utdatastorlek analysera |
| K | Keep-Alive | Timeouts och slot-bindning kontrollera |
| D | DNS-uppslagning | Inaktivera omvänd DNS eller cache |
| L | Loggning | Asynkron loggning och I/O kontroll |
| C | Avslutning | Vanligt anslutningsslut, kort synlig |
| G | En elegant avslutning | Avslutad förfrågan, arbetare röjer på |
| I | Rensning vid inaktivitet | Okritisk, arbetare justerad |
| . | Passiv | Lugn fas, resurser fri |
Identifiera avancerade mönster och attackprofiler
Jag utvärderar inte bara enskilda tillstånd, utan även Varaktighet och symbolernas fördelning. Många långvariga R-tillstånd i kombination med låg nätverksbandbredd tyder på långsamma klienter eller Slowloris-mönster; i sådana fall begränsar jag lästiderna per förfrågan (t.ex. med RequestReadTimeout) och ställer in realistiska minsta hastigheter. Om W-tillstånd med högt antal byte per förfrågan dominerar, är det snarare bandbredden eller lagringsutrymmet som är begränsande. Om D- och L-tillstånd förekommer samtidigt prioriterar jag namnupplösning och logg-I/O. Avgörande är om mönstren bred (alla medarbetare) eller lokal (endast en VHost eller sökväg) – på så sätt hittar jag hotspots i applikationen snabbare.
Nyckeltal för analys av webbservrar
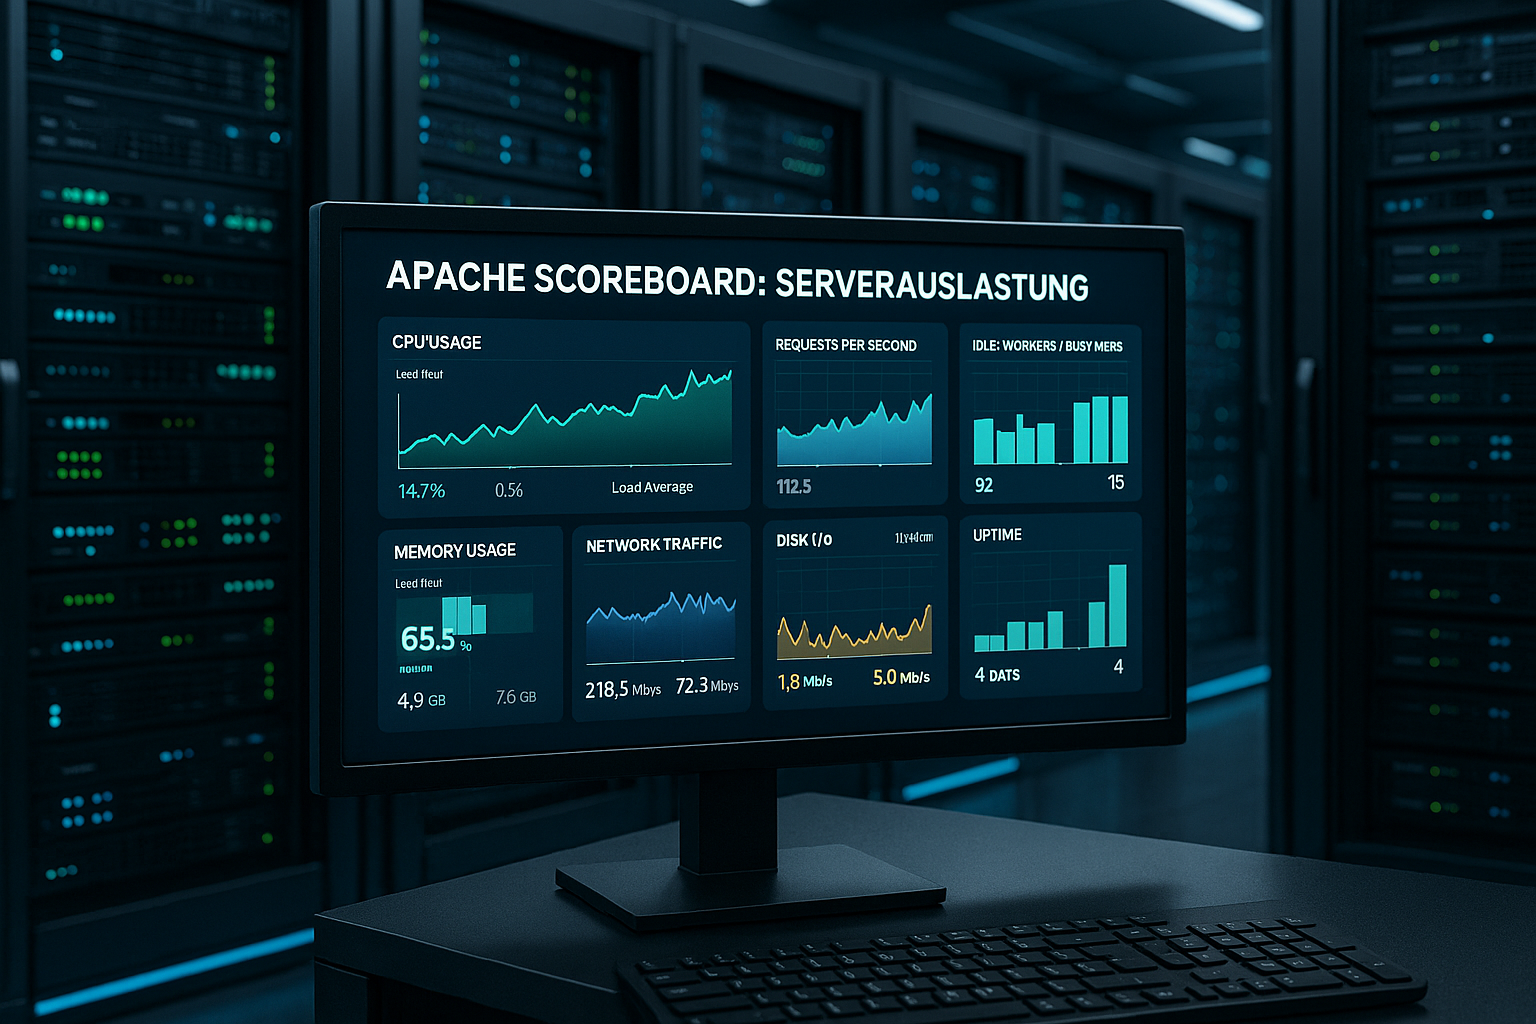
Antalet förfrågningar per sekund visar mig genomströmningen, men jag utvärderar samtidigt antalet byte per sekund och antalet byte per förfrågan för nyttolast. Förhållandet mellan aktiv och inaktiv tid avslöjar om det saknas slottar eller om inställningarna är för konservativa. Jag korrelerar CPU-utnyttjandet med svarstiderna för att skilja CPU-bundna från I/O-bundna processer. Driftstiden hjälper till att skilja nyligen genomförda omstarter från verkliga trender. Utifrån denna kombination härleder jag konkreta optimeringsåtgärder för arbetare, keep-alive och Tidsfrister från.
Gränsvärden och larm i praktiken
Jag ställer inte in larm utifrån momentvärden, utan utifrån glidande medelvärden och Varaktighet. Följande heuristiker har t.ex. visat sig fungera väl: Idle 4:1 under samma tidsperiod tyder på mättnad. Req/s sjunker vid konstant trafik, medan Busy förblir konstant – då ligger ofta ett backend-problem bakom. K-andel > 50 % under primetime tyder på för generös Keep-Alive. Jag kompletterar tröskelvärdena med trendlarm (stigande svarstider vid oförändrad belastning) och Säsongsvariationer (Dags- och veckomönster), så att jag kan skilja på verkliga förändringar och normalt beteende.
Placera ScoreboardFile på rätt plats
På vissa plattformar skriver Apache statusdata till en scoreboard-fil, och jag placerar den i en snabb, säker katalog som /var/run/httpd; detta ökar tillförlitlighet. Jag förhindrar att flera instanser använder samma fil, annars riskerar man att värdena förvanskas. Vissa verktyg läser direkt från filen, vilket gör HTTP-ändpunkten överflödig. Detta är fördelaktigt för säkerhet och prestanda, förutsatt att behörigheterna stämmer. Jag dokumenterar sökväg och åtkomst så att underhåll och Övervakning förbli konsekvent.
Särdrag hos operativsystem och containrar
Jag ser till att gränserna för filbeskrivare, backloggar och tillfälliga sökvägar passar arbetsbelastningen. I systemd kontrollerar jag om PrivateTmp eller ReadOnlyPaths påverkar Scoreboard-sökvägen. I containrar planerar jag lagringsbehovet per process/tråd konservativt och placerar Scoreboard-sökvägen i en skrivbar Körningskatalog. För toppbelastning justerar jag kärnparametrarna:
# Exempel på sysctl-värden (testa och dokumentera systemomfattande)
net.core.somaxconn = 4096
net.ipv4.tcp_max_syn_backlog = 4096
fs.file-max = 1048576
Dessutom kalibrerar jag `ulimit -n` för Apache-tjänsten så att den når det maximala samtidighet passar (tumregel: öppna FD:er ≈ 2–3 × MaxRequestWorkers i proxyintensiva konfigurationer). Efter ändringar tittar jag på resultattavlan igen för att bekräfta effekterna.
Typiska användningsfall: Identifiera överbelastade arbetare
Om nästan alla platser är upptagna med R eller W och det knappt dyker upp några _‑-poster, går servern på sin Begränsa. Sedan kontrollerar jag MaxRequestWorkers, svarstider och blockerande backends. Om fler arbetare inte hjälper ligger flaskhalsen ofta i applikationen, databasen eller lagringssystemet. Med /server-status?auto följer jag utvecklingen i intervaller istället för att bara titta på ögonblicksbilder. På så sätt avgör jag om jag ska justera inställningarna, förbättra cachelagringen eller Skalning planera.
Resursmodell och kapacitetsformler
Jag beräknar kapaciteten i förväg för att undvika minnesbrist. För Prefork gäller: Minne ≈ antal processer × RSS per process. För Worker/Event: Minne ≈ antal processer × (RSS per process) + trådar × trådöverhead. Jag mäter den faktiska RSS med systemets verktyg och lägger till säkerhetsmarginaler. Ett litet exempel: 20 processer × 50 MB + 500 trådar × 1 MB ger ≈ 1,5 GB, plus cache och operativsystemets buffertar. Utifrån detta beräknar jag MaxRequestWorkers, ServerLimit och ThreadsPerChild. Jag tar dessutom hänsyn till att moduler som SSL, PHP eller omvänd proxyservering påverkar minnesanvändningen per Tråd kan öka; därför testar jag med verklig last, inte bara i tomgång.
Tolka köer och latens
Om förfrågningar förblir länge i tillståndet ”Accept” eller ”Skriv”, ökar den upplevda latensen, och jag tittar då på köernas längd samt ”Accept-backlog”; resultattavlan ger värdefull information om detta Indikatorer. Den här artikeln ger mig en mer ingående förklaring av köer, latenser och hantering av förfrågningar: Köer och latens. Utifrån dessa utgångspunkter bedömer jag om flaskhalsarna uppstår före, i eller efter Apache. Jag tolererar korta toppar, men åtgärdar ihållande överbelastningar genom att justera kapaciteten eller arkitekturen. På så sätt förhindrar jag att timeouts eskalerar och att klienter avbryta.
Upprätta anslutning till backend och proxy
I miljöer med stor användning av proxyservrar kan jag utifrån W-faserna avgöra om arbetare befinner sig på Uppströms Vänta. ExtendedStatus visar mig VHost och den begärda resursen; med hjälp av detta kan jag koppla ihop sökvägar med långsamma backend-servrar. Jag ställer in realistiska tidsgränser (TimeOut, ProxyTimeout) och kontrollerar anslutningspoolningen så att trådar inte blockeras i onödan. Om pipelinen blir överbelastad vid uppladdningar reglerar jag läshastigheten per klient och skyddar mig mot långsamma avsändare. Om många stora svar genereras använder jag komprimering, chunking och Caching övervägs för att förkorta W-tiderna.
Ställa in Keep-Alive på ett målinriktat sätt
Många K-poster tyder på klienter som lämnar anslutningar öppna; detta påskyndar efterföljande förfrågningar, men kan ta upp slots binda. Jag ställer in timeouts så att äkta upprepningar gynnas, samtidigt som inaktivitet inte blockeras för länge. På välbesökta webbplatser hjälper en uppströms proxy mig, som effektivt sammanför Keep-Alive-förfrågningar. För detaljer om finjusteringen använder jag den här guiden: Ställa in tidsgränsen för Keep-Alive. Med en lämplig timeout minskar slot-bindningen, och servern klarar belastningen lyhörd.
HTTP/2, TLS och MPM i samverkan
Med HTTP/2 ser jag i regel färre K-bindningar per klient, eftersom flera strömmar delar en anslutning dela. Event-MPM visar här sina styrkor: Keep-Alive hanteras mer effektivt, medan det aktiva arbetet förbehålls trådarna. TLS ökar CPU-behovet per anslutning; jag observerar om höga W-andelar korrelerar med hög CPU-användning och optimerar krypteringssviter samt återupptagning av sessioner. I statusöversikterna ser jag per VHost om HTTP/2- eller TLS-termineringsvägar dominerar och anpassar kapaciteten därefter (t.ex. fler trådar istället för fler processer om kontextbyten är kostsamma).
Full kontroll över DNS-uppslag och loggning
Om D dyker upp ofta i resultattavlan kontrollerar jag omvänd DNS och aktiverar en lokal cache eller stänger av sökningar; det minskar Fördröjning. Om jag ser många L-poster bromsar loggningen bearbetningen, så därför fördelar jag loggfiler, använder snabbare lagring eller asynkrona pipeliner. Roterande loggar konfigurerar jag så att det inte uppstår toppar i flushingen. Samtidigt mäter jag skriv-I/O och fillåsningar för att bryta blockerande mönster. På så sätt vinner jag tillbaka bearbetningstid och avlastar Arbetare.
Integration i övervakningssystem
Jag hämtar /server-status?auto med jämna mellanrum, sparar värdena som en tidsserie och visualiserar ”Busy vs Idle”, Req/s, Bytes/s och CPU-belastning på Instrumentpaneler. Larm definierar tröskelvärden för kontinuerligt fulla slots, ökande svarstider eller ovanliga trafikmönster. Med anteckningar markerar jag distributioner så att jag omedelbart kan se effekterna. Denna historik skiljer engångstoppar från verkliga trender. På så sätt kan jag styra kapaciteten på ett planerat sätt och förhindra Överraskningar.
Automatiserad datainsamling med skript
För snabba kontroller räcker det för mig med ett enkelt skript som analyserar Auto-vyn och endast visar nyckeltalen. Jag håller avfrågningsintervallen på en rimlig nivå (t.ex. 10–30 sekunder) för att minimera belastningen och märker varje prov med värd, virtuell värd och miljö.
#!/bin/sh
URL="http://127.0.0.1/server-status?auto"
curl -s "$URL" | awk -F': ' '
  /BusyWorkers/ {busy=$2}
  /IdleWorkers/ {idle=$2}
  /ReqPerSec/   {rps=$2}
  /BytesPerSec/ {bps=$2}
  END { printf("busy=%s idle=%s rps=%.2f bps=%.0f\n", busy, idle, rps, bps) }
'
I större miljöer aggregerar jag dessutom tiderna per arbetare, tilldelar dem till VHosts och beräknar Kvantil för svarstider. På så sätt kan jag se om det bara är en del av användarna som upplever problem eller om majoriteten är drabbad.
MPM och kapacitetsplanering
MPM avgör hur Apache hanterar anslutningar; Scoreboard-data visar mig om det är processer eller trådar som utgör den begränsande faktorn Faktor är. När det gäller val och finjustering jämför jag händelser och arbetare, mäter vilotider, keep-alive-bindning och kontextbyten. Den här artikeln ger en översiktlig jämförelse: Event vs. Worker MPM. Efter ändringarna kontrollerar jag återigen Busy/Idle och Req/s för att belägga effekterna. På så sätt fattar jag beslut baserade på data och ökar Effektivitet.
Graceful Restart, rullande driftsättningar och underhåll
Vid driftsättningar eller konfigurationsändringar föredrar jag att utlösa en graciös Omstart avslutad. I resultattavlan ser jag detta på de många G-tillstånden, medan nya processer startar och gamla avslutas smidigt. Jag planerar rullande ändringar så att det finns tillräckligt med ledig kapacitet kvar: först minskar jag belastningen, sedan laddar jag om smidigt och därefter de återstående noderna. Långvariga G-faser är ett tecken på att gamla processer väntar på långsamma förfrågningar – då kontrollerar jag timeouts och keep-alive för att förkorta omkopplingstiden.
Steg för steg mot en välgrundad analys
Jag aktiverar mod_status, säkrar åtkomsten och aktiverar ExtendedStatus så att jag kan se alla Detaljer får. Därefter kontrollerar jag HTML-sidan i webbläsaren och lär mig symbolernas beteende i realtid. I nästa steg integrerar jag /server-status?auto i min övervakning och validerar mätvärdena. Sedan optimerar jag följande i tur och ordning: antal arbetare, keep-alive, timeouts, caching och applikationsvägar. Jag mäter varje ändring på nytt tills Req/s, svarstid och Busy/Idle återigen ligger inom Grönområde lögn.
Sammanfattning: Apache Scoreboard som kompass
Apache Scoreboard ger mig en tydlig och omedelbart användbar översikt över belastning, flaskhalsar och beteendet hos Arbetare. Med mod_status, ExtendedStatus och väl genomtänkt övervakning omvandlar jag rådata till välgrundade beslut. Indikatorer och mätvärden visar om jag ska utöka kapaciteten, justera tidsgränserna eller ta itu med själva applikationen. En liten ändring av Keep-Alive eller MPM kan ha stor effekt om dataunderlaget stämmer. Den som tolkar tecknen rätt håller Apache igång även under hög belastning lyhörd och planeringsbar.


