 Hoppa till innehåll

CloudLinux-rapporter visar mig tydligt vilka LVE-gränser som gäller för enskilda konton och var CPU, minne, I/O eller entry-processer faktiskt bromsar upp systemet. Jag granskar dessa data noggrant för att upptäcka återkommande fel, dagliga mönster och akuta flaskhalsar och utifrån detta utforma konkreta optimeringar.
Centrala punkter
Jag sammanfattar följande punkter i förväg så att du kan sätta igång med analysen på ett fokuserat sätt.
- LVE-nyckeltal Läs rätt: SPEED, MEM, IO, IOPS, PNO, EP
- Realtidsdata Kontrollera med LVE Manager och lvetop
- Förlopp via lveinfo, lvechart, cloudlinux-statistics
- Fel prioritera: frekvens, tidpunkt, orsak
- Åtgärder härleda för CPU, RAM, I/O och EP
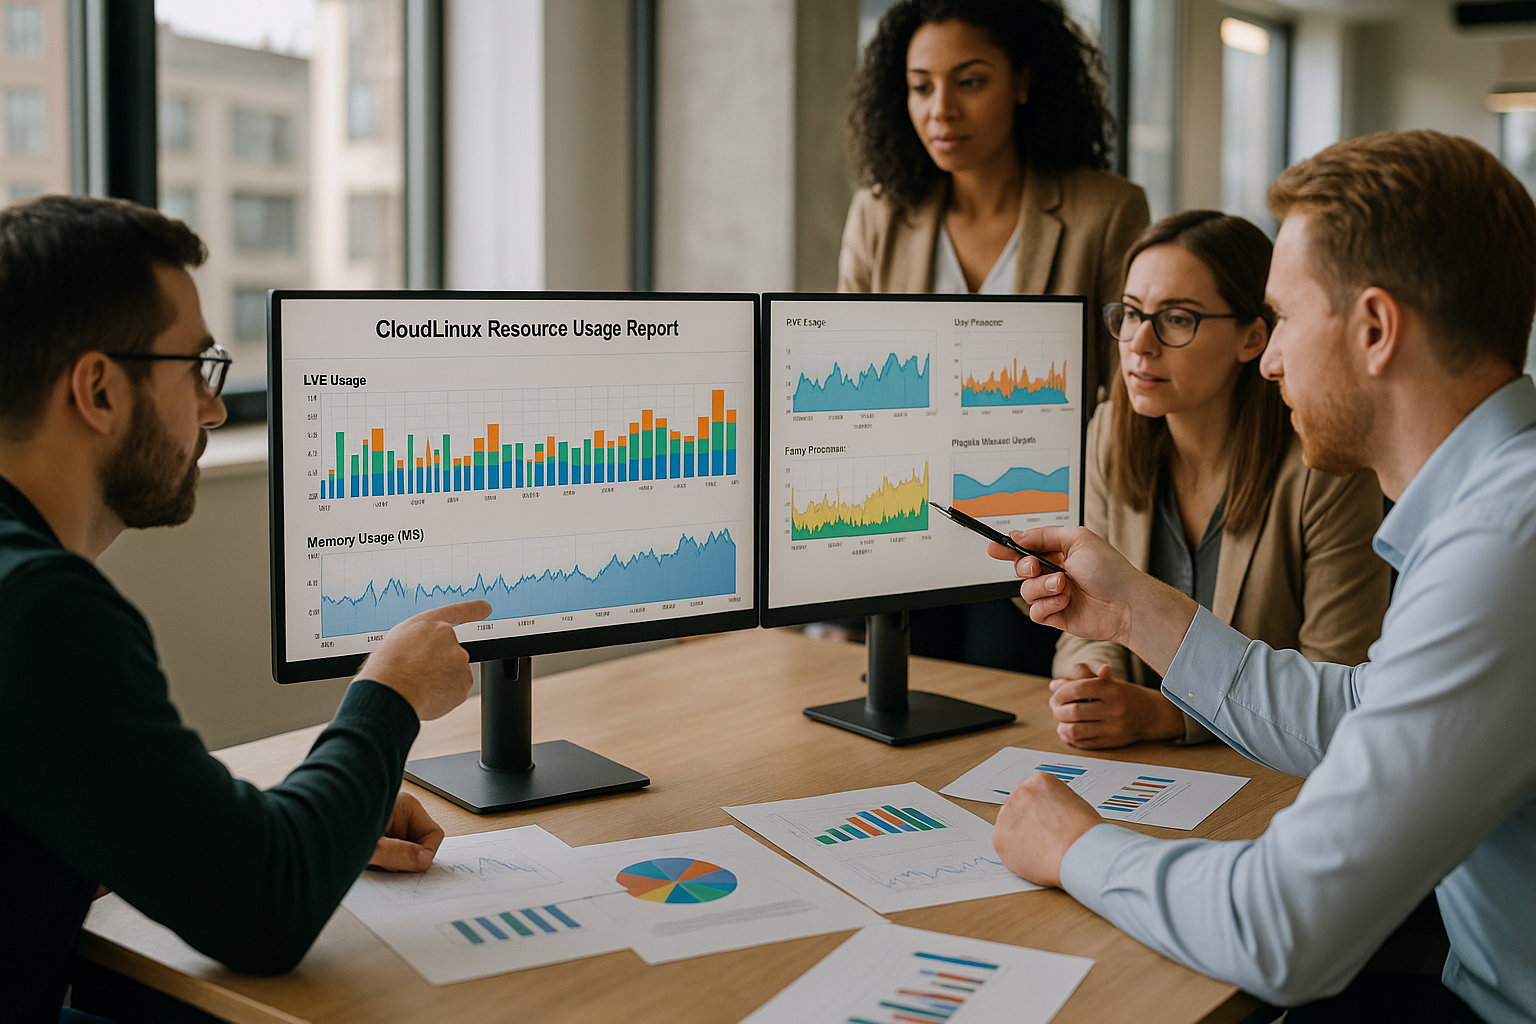
Att tolka rätt nyckeltal: SPEED, MEM, IO, IOPS, PNO, EP
Jag inleder varje analys med Nyckeltal, som CloudLinux redovisar i LVE-sammanhang. SPEED beskriver den tilldelade CPU-kapaciteten, MEM står för RAM-användningen, IO för datagenomströmning och IOPS för antalet I/O-operationer. PNO visar det totala antalet aktiva processer, EP de samtidiga Entry Processes som begränsar webbåtkomsten. Den som ser konstant höga värden har oftast inte ett kortvarigt toppproblem, utan ett strukturellt belastningsmönster. Jag kontrollerar alltid om gränserna nås kontinuerligt eller om det bara förekommer enstaka toppar som kan förklaras utan begränsning.
| Nyckeltal | Betydelse | Typiska symtom | Första kontrollerna |
|---|---|---|---|
| SPEED | CPU-prestanda (andel/gräns) | Långa PHP-körningstider, tidsgränser | Kontrollera PHP-profiler, opkodscache och caching |
| MEM | Arbetsminne per konto | OOM-avbrott, 500-fel under belastning | Granska PHP:s memory_limit, plugins och frågor |
| IO | Genomströmning i MB/s | Långsamma nedladdningar/uppladdningar | Statisk cache, mediekomprimering, lagring |
| IOPS | Antal I/O-operationer | Tröga DB-/filåtkomstoperationer | Index, frågeplan, objektcache |
| PNO | Övergripande processer | Ökad serverbelastning | Daemon-/Cron-överskridanden, gränser för arbetare |
| EP | Samtidiga inloggningar på webben | 503-fel vid Peaks | Kontrollera HTTP-cache, hastighetsbegränsningar och bots |
Liveövervakning med LVE Manager och lvetop
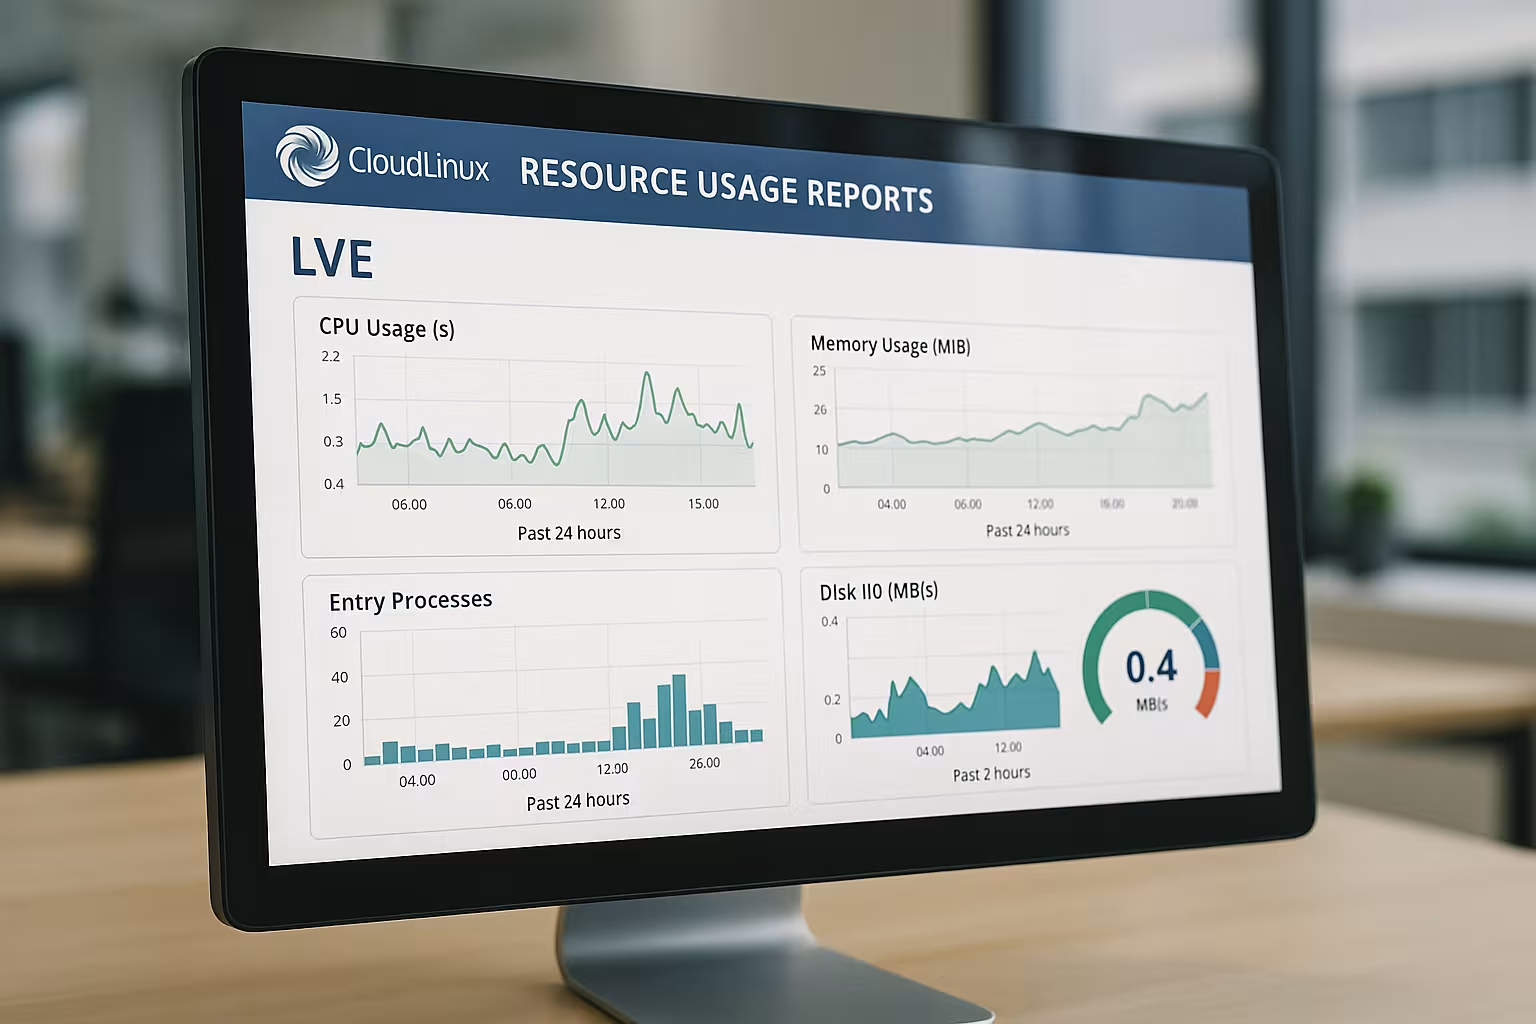
För snabbanalyser använder jag Realtidsdata i LVE Manager och lvetop i kommandotolken. Vyn ”Current Usage” visar mig i realtid hur CPU, RAM, I/O, IOPS, processer och Entry Processes fungerar. Vid belastningstoppar observerar jag om EP eller SPEED når gränsen först, eftersom det påverkar nästa steg. lvetop är lämpligt för att omedelbart filtrera bort de mest resurskrävande kontona och, om det behövs, strypa eller optimera dem. Den som vill fördjupa sig i gränssnittet kan anpassa gränsvärden och vyer på ett målinriktat sätt – jag använder gärna den här guiden för det: Konfigurera LVE Manager.
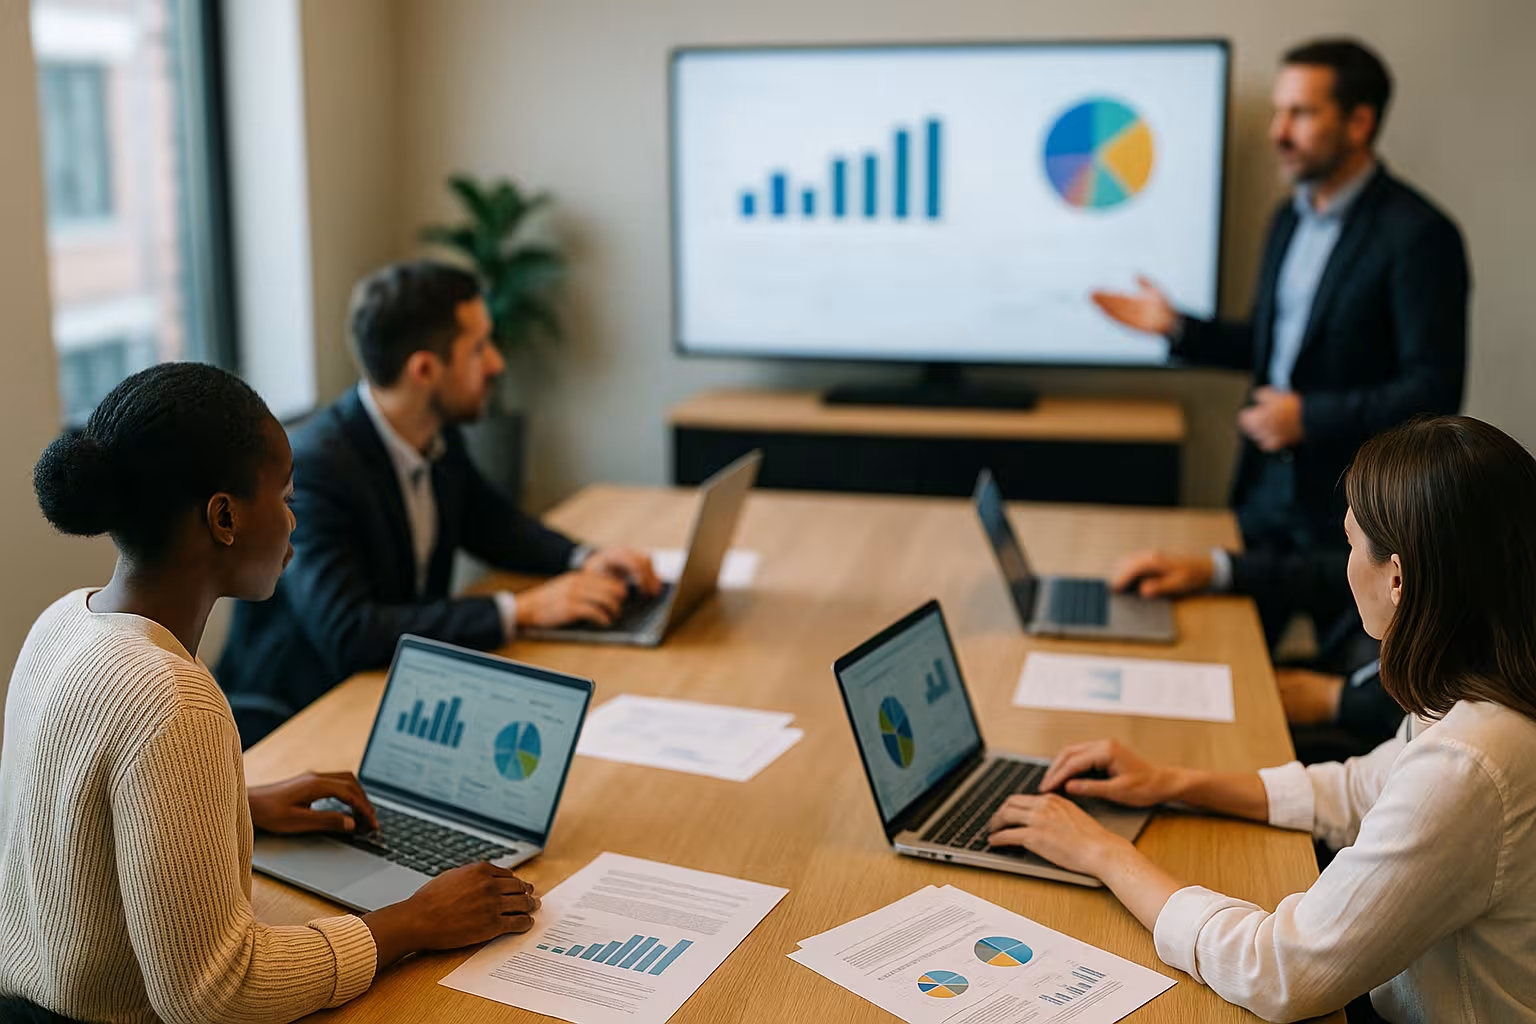
Historisk analys: lveinfo, lvechart och cloudlinux-statistics
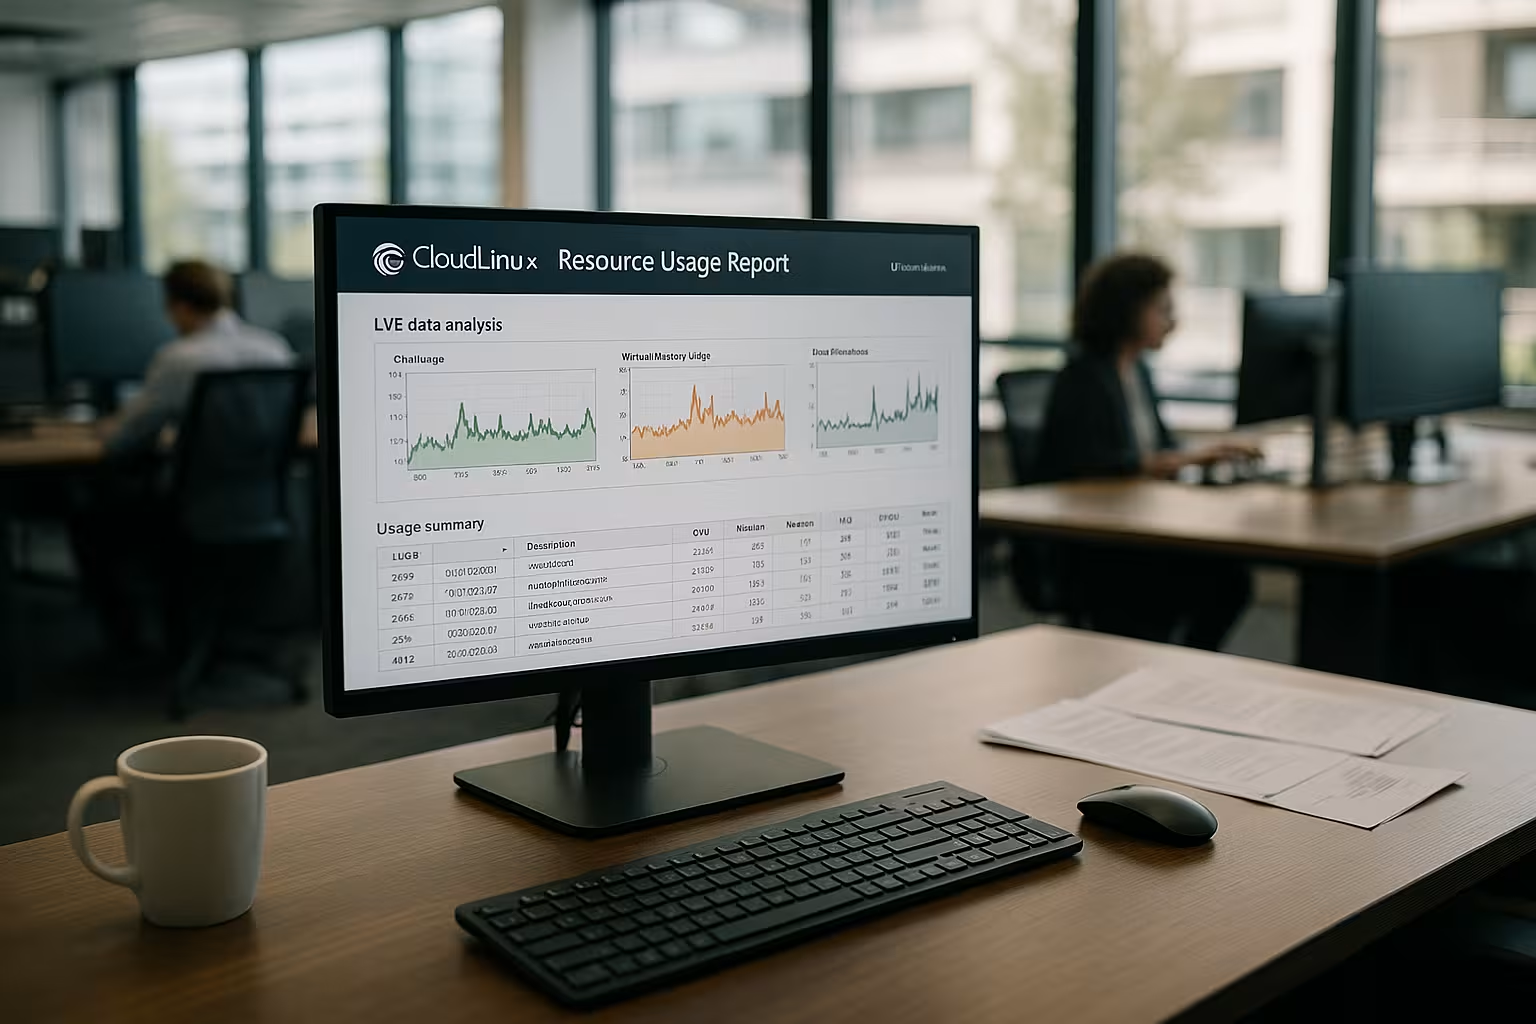
Jag upptäcker trender genom Förlopp och felhistorik, inte bara ögonblicksbilder. Med lveinfo drar jag tidsfönster och ser exakt när gränsvärdena utlöstes och hur ofta det hände. lvechart ger mig visuella toppar över timmar eller dagar, vilket gör att mönster över dygnet blir synliga. cloudlinux-statistics kompletterar analysen när jag behöver längre tidsserier per konto. Genom denna kombination får jag svar på frågorna „när“, „hur ofta“ och „under vilka förhållanden“ belastningarna uppstår.
Att förstå och prioritera fel
Ett ”Fault” betyder: Det Begränsa har inträffat, och CloudLinux har begränsat kapaciteten. Jag sorterar därför felrapporterna först efter frekvens, sedan efter resurstyp och tid på dygnet. Dagliga EP-fel vid lunchtid tyder ofta på trafiktoppar eller botar, medan RAM-fel på natten oftast har att göra med cron-jobb och säkerhetskopieringar. Om CPU-fel hopar sig letar jag efter ineffektiva PHP-rutiner, defekta cacher eller obegränsade uppgifter. Denna klassificering sparar tid eftersom jag kan genomföra optimeringar precis där användarna märker begränsningar.
Identifiera orsaker: typiska mönster och motåtgärder
Utifrån min erfarenhet sorterar jag Prov snabbt identifiera konkreta orsaker. Varaktigt höga EP-värden tyder på för många samtidiga förfrågningar eller bristande edge-caching. En ihållande hög RAM-användning pekar ofta på plugins, teman eller läckande processer. IO- och IOPS-toppar tyder på dataintensiva uppgifter, icke-indexerade sökningar eller många små filåtkomster. För att undvika felaktiga tolkningar kontrollerar jag parallellt systemhälsoindikatorer – en snabb start får man med CloudLinux hälsokontroller.
Identifiera cron-jobb, säkerhetskopior och botar
En titt på förklarar många ”Fault”-serier Tidpunkter i tiden och uppgifter. Om begränsningen alltid inträffar strax efter hel timme körs ofta cron-jobb parallellt och konkurrerar med besökarna. Återkommande toppar på natten tyder ofta på säkerhetskopieringar som utnyttjar I/O och IOPS till max. Iögonfallande EP-fel utan motsvarande trafik i Analytics tyder ofta på bots eller scrapers som kringgår statiskt innehåll. I sådana fall sätter jag hastighetsbegränsningar, flyttar jobb till lugnare tidsfönster och aktiverar konsekvent edge- eller sidcacher.
Analysera data per återförsäljare och konto
I större installationer separerar jag Nivåer överskådligt: Återförsäljare, deras kunder och enskilda konton. LVE Manager ger just denna översikt och visar mig vilken del av trädstrukturen som driver gränserna. På så sätt kan jag se om en enskild kund sticker ut eller om flera projekt inom en återförsäljarstruktur samtidigt belastar systemet. För supportprocesser markerar jag berörda konton och lägger in åtgärder så att återkommande ärenden kan lösas snabbare. Denna transparens hjälper till att fördela resurserna rättvist och hålla kostnaderna per kund överskådliga.
Dimensionera gränsvärdena korrekt och anpassa tarifferna
Jag sätter gränser Realistisk, inte maximalt. För snäva EP-gränser orsakar 503-fel, medan för låga SPEED-värden fördröjer varje PHP-svar. Den som regelbundet ser fel bör först kontrollera optimeringarna och därefter prisplanerna. När projekt blir affärskritiska lönar det sig att välja en högre profil som jämnar ut topparna och ger stabilitet. Jag dokumenterar effekterna i förloppsdiagrammen så att beslutet förblir spårbart.
Databasintensiva projekt: Optimera I/O och IOPS
När det gäller databasbaserade webbplatser kontrollerar jag IOPS och IO går alltid hand i hand med sökkvaliteten. Många små sökningar utan index genererar höga IOPS-värden och försämrar svarstiden. Erfarenhetsmässigt minskar objektcache, sökcaching och anpassade index denna flod av förfrågningar avsevärt. För trendanalyser läser jag dessutom databasrapporterna och jämför dem med LVE-förloppen. Denna guide ger mig en gedigen introduktion till MySQL Governor-rapporter, för att korrekt klassificera databasbelastningen.
Handbok för övervakning: Från larm till åtgärd
Utifrån mätvärdena skapar jag en Spelguide, som tydligt visar varje eskalering. Steg 1: Kontrollera i realtid om gränserna för närvarande gäller och vilken resurs som slutar fungera först. Steg 2: Öppna historiken, jämför tidsfönstren och markera upprepningar. Steg 3: Lokalisera orsaken – kodväg, cache, databas, cron, bot – och definiera en motåtgärd med testkriterium. Steg 4: Efter ingreppet, kontrollera på nytt både i realtid och historiskt om fel och latens minskar. Denna fasta ordning undviker panikåtgärder och skapar reproducerbara resultat.
Att tolka gränsernas inbördes beroenden på rätt sätt
I praktiken tillämpas gränsvärden sällan isolerat. Därför bedömer jag Interaktioner mellan EP, SPEED, MEM och IO/IOPS: Om EP och SPEED ökar samtidigt är det oftast CPU:n som begränsar per begäran; om en sid- eller kantcache hjälper, sjunker båda värdena samtidigt. Om jag ser ett ökat EP-värde med konstant lågt SPEED-värde, så stockas förfrågningarna i webbservern, ofta på grund av brist på arbetare, Keep-Alive-konfigurationer eller blockerande externa anrop (t.ex. API, e-post). MEM-fel vid måttlig SPEED tyder på få, men minneskrävande processer (t.ex. bildkonvertering, stora exportuppdrag). IO-/IOPS-toppar utan nämnvärd CPU-belastning pekar på dataintensiva fil- eller databasåtkomst. Dessa samband använder jag för att första hypotesen innan jag går in på detaljerna kring koden eller servern.
Praktisk tillämpning: Effektiv användning av lvetop, lveinfo och cloudlinux-statistics
För snabba resultat arbetar jag med tydliga Frågor och filtrera. lvetop hjälper mig att varje sekund se de största resursförbrukarna och växla mellan sortering efter CPU, MEM eller IO. Med lveinfo skapar jag 1-timmars-, 24-timmars- och 7-dagarsfönster för att lista felögonblick, toppvärden och berörda resurser per konto. cloudlinux-statistics ger mig längre tidsserier och lämpar sig för att dokumentera åtgärder (före/efter). För varje ingrepp dokumenterar jag alltid: tidsperiod, berörda konton, maximivärden per resurs, antal fel samt svarstider från applikations- eller webbövervakningen. På så sätt kan jag belägga optimeringar och förhindra att gränsvärden sänks „på en gissning“.
Webstack-detaljer: PHP-hanterare, arbetare och OPcache
En viktig faktor ligger i PHP-körning: Antalet PHP-arbetare per konto, deras RAM-budget (memory_limit) och OPcache. För många arbetare utan cache ökar EP/PNO och MEM, för få arbetare orsakar köer av förfrågningar (EP ökar, svarstiden blir längre). Jag försöker därför hitta en optimal balans: så många arbetsprocesser som behövs, så få som möjligt. OPcache måste vara tillräckligt dimensionerad (minne och internerade strängar), annars kompilerar PHP om hela tiden och driver upp SPEED. Dessutom kontrollerar jag om statiska resurser verkligen hanteras av webbservern (och inte av PHP) och om Keep-Alive/HTTP/2-multiplexing fungerar som det ska. Målet är att dynamiska förfrågningar ska minska och att snabbt beta av de återstående.
Använda cachingstrategier konsekvent
Jag skiljer mellan tre nivåer: Edge/CDN-cache för global avlastning, HTTP-/sidcache direkt före PHP och Cache för objekt inom applikationen. Edge-cachen minskar EP och IO för statiska tillgångar avsevärt. Sidcachen minskar antalet dynamiska träffar och påverkar EP/SPEED direkt. Objektcachen (t.ex. för frekventa databassökningar) minskar IOPS och CPU-användningen. Det är viktigt med en stabil Cache-nyckel (t.ex. inga onödiga cookies) samt rimliga TTL-värden per sidtyp. För admin- eller varukorgsområden planerar jag undantag, i övrigt strävar jag efter en så hög cacheandel som möjligt. Efter aktivering observerar jag: Uppstår det EP-fel? Minskar medianvärdet för svarstiderna?
RAM-hantering: memory_limit, processer och minnesläckor
MEM-fel uppstår ofta på grund av att memory_limit är generöst beräknat och parallella processer spränger summan. Därför gör jag en uppskattning: hur mycket RAM behöver en typisk förfrågan? Utifrån det räknar jag ut det maximala rimliga antalet arbetare. Dessutom håller jag PHP-bibliotek och plugins smidiga, tar bort oanvända tillägg och kontrollerar långkörande skript (exporter, importer, bildbehandling) för minnesläckor. OPcache minskar belastningen på RAM-minnet genom att cacha kompilerade data, men får inte själv vara för liten. Vid återkommande toppar isolerar jag de „kostsamma“ vägarna med hjälp av profilering och vidtar riktade åtgärder – det sparar oftare RAM-minne än generella gränshöjningar.
Minska I/O och IOPS på ett målinriktat sätt
IO/IOPS-toppar uppstår till följd av många små fil- eller databasåtkomster. Jag samlar ihop arbetsbelastningar där det är möjligt: generering av miniatyrbilder som batch istället för på begäran, minimering av tillgångar i byggprocessen istället för vid varje begäran, sessions- och tillfälligt minne i ett Cache för objekt flytta ut, så att antalet filåtkomster minskar. I databasen prioriterar jag index för vanliga WHERE-/JOIN-satser och eliminerar N+1-frågor. Parallellt jämför jag LVE-förlopp med databasrapporterna från MySQL Governor för att identifiera flaskhalsar. Målet är att omvandla många små IOPS till ett fåtal effektiva åtkomsthändelser – detta jämnar ut toppar och minskar risken för fel.
Hantera EP-fel: köhantering och besökarströmmar
EP begränsar antalet samtidiga åtkomstförsök. Om många förfrågningar stöter på tomma cacher uppstår EP-fel snabbt. Jag förhindrar detta genom att Köer innan jag inför PHP (korta begäranköer på webbservern), ställer in Keep-Alive på ett lämpligt sätt och konsekvent låter dynamiska sökvägar som inte är personaliserade cachelagras. För bots definierar jag hastighetsbegränsningar och blockerar uppenbara ”bad actors” tidigt. Dessutom kontrollerar jag anrop till tredjepartstjänster i begärandevägen – blockerande externa tjänster ökar uppehållstiden per begäran och förbrukar därmed EP. Där det är möjligt flyttar jag externa integrationer till jobb/köer.
Planera cronjobb och säkerhetskopieringar på ett resurssnålt sätt
Jag avkopplar återkommande uppgifter från rusningstider och reglerar dem: Jag jämnar ut cron-scheman (förskjuter dem med några minuter), förhindrar parallella körningar med låsfiler och reglerar belastningen genom Nicing och batchstorlekar. Jag planerar säkerhetskopieringar till tidsfönster med låg trafik och ser till att använda inkrementella metoder så att IO/IOPS håller sig inom rimliga gränser. För resurskrävande jobb i appen sätter jag gränser för antalet samtidiga arbetare, så att MEM och SPEED inte stiger plötsligt. Jag kontrollerar effekten löpande: minskar antalet fel under natten, avtar belastningstopparna efter varje hel timme?
CageFS – en översikt över filsystemet och inoderna
Förutom LVE-gränserna påverkar Faktorer som rör filsystemet Prestanda: Miljontals små filer (t.ex. cachefragment) ökar antalet åtkomsthändelser till metadata och driver upp IOPS. Jag håller cachekatalogerna ordnade, begränsar filflödet genom väl genomtänkta sammanslagningar av cacher och kontrollerar inod-utnyttjandet. CageFS säkerställer isolering, men felplacerade temporära filer (t.ex. i webbrotkatalogen istället för i tmp-katalogen) ökar I/O-belastningen i onödan. En regelbunden hälsokontroll av dessa områden förhindrar att I/O-flaskhalsar felaktigt tolkas som rena CPU- eller RAM-problem.
Öppenhet och kommunikation i återförsäljarsammanhang
I återförsäljarmiljöer dokumenterar jag Ladda föraren för varje delområde och dokumentera åtgärder: Vilka gränsvärden har fastställts? Vilka optimeringar planeras? Hur ser före- och efterdiagrammen ut? Denna transparens påskyndar supportens svar och skapar acceptans för prisändringar när optimeringspotentialen är uttömd. Jag fastställer tröskelvärden vid vilka vi vidtar åtgärder (t.ex. återkommande fel > N/dag eller median svarstid > X ms) och kopplar dem till tydliga handlingsplaner – på så sätt undviks ändlösa loopar i ärendehanteringen.
Undvika vanliga missuppfattningar
Det finns några mönster som jag ser regelbundet: En stigande CPU-användning är inte automatiskt en varning om „för lite CPU“ – ofta fungerar inte cachen eller så är sökningarna ineffektiva. Många EP-fel betyder inte nödvändigtvis „mer trafik“ – bots, felkonfigurerade övervakningsverktyg eller heartbeats kan vara orsaken. MEM-fel kan inte alltid lösas genom att höja memory_limit – ofta beror det på för många samtidiga processer. IO-/IOPS-toppar beror inte uteslutande på lagringen – de utlöses av applikationsmönster. Jag verifierar därför alltid hypoteser med korrelerade diagram och, om möjligt, med korta motkontroller (t.ex. aktivera cache för delområdet och kontrollera förloppet på nytt).
Testa, mäta, slipa om
Jag betygsätter varje ändring med tydliga mätpunkter: före/efter aktivering av sidcachen, före/efter indexuppdatering, före/efter justering av arbetare. För detta använder jag LVE-historik, svarstidsmått och felfrekvenser (5xx/4xx). När det är möjligt genomför jag A/B-jämförelser under lågtrafik för att isolera återverkningar. Om fel kvarstår upprepar jag processen: finjusterar gränsvärdeskombinationer, profilerar ytterligare hotpaths och justerar batchstorlekarna för jobben. Erfarenheten visar att två till tre riktade iterationer ger betydligt bättre resultat än en stor, generell åtgärd.
Sammanfattning: Så här läser jag CloudLinux-rapporter om resursanvändning på ett effektivt sätt
Jag betygsätter CloudLinux-Data presenteras alltid i tre nivåer: Live, historik, fel. Nyckeltalen SPEED, MEM, IO, IOPS, PNO och EP ger mig en översikt över orsak och verkan. Med lvetop ser jag omedelbart vad som belastar systemet; med lveinfo och lvechart kartlägger jag mönster över flera dagar. Utifrån återkommande Faults drar jag slutsatser om caching, optimering av sökfrågor, justering av gränsvärden eller byte av prisplan. Denna metod minskar supportbehovet, ökar reaktionsförmågan och gör hostingprestandan transparent.


