Videre til indhold

DPDK kann die Paketverarbeitung im Userspace beschleunigen, wenn hohe Paketraten oder gleichmäßige Latenzen den gewöhnlichen Netzwerkpfad begrenzen. Dafür pollt die Anwendung NIC-Queues direkt und übernimmt Planung für Kerne, Speicher, Queues und Gerätezugriff. Das umgeht jedoch keine Hardware- oder Sicherheitsgrenzen und erhöht den Betriebsaufwand erheblich. Prüfe deshalb das genaue NIC-Modell und den passenden PMD, Speicher- und NUMA-Planung, die erforderliche Geräteanbindung sowie einen vom Datenpfad unabhängigen Management-Zugang vor einem Pilotbetrieb.
DPDK-Grundprinzip und korrekte Einordnung
DPDK ist ein Framework für Anwendungen, die Netzwerkpakete mit möglichst wenig Overhead im Userspace verarbeiten müssen. Statt den üblichen Weg über Kernel-Netzwerkstack, Sockets und dessen Paketstrukturen zu nutzen, kann eine Anwendung ausgewählte Netzwerkkarten unmittelbar für ihren eigenen Datenpfad verwenden. Das zielt vor allem auf hohe Paketraten, niedrige Latenzen und gut planbare Verarbeitung bei vielen kleinen Paketen.
Die Formulierung „ohne Kernel-Limits“ ist dabei verkürzt. Der Linux-Kernel bleibt für Betriebssystem, Speicherverwaltung, Prozesse, Sicherheit und zahlreiche Verwaltungsaufgaben vorhanden. DPDK ersetzt auch weder Grenzen der Netzwerkkarte noch PCIe-, Speicherbandbreiten- oder CPU-Grenzen. Es umgeht für gebundene Schnittstellen vor allem den gewöhnlichen Kernel-Datenpfad und verlagert die Paketarbeit in eine spezialisierte Anwendung.
Im regulären Linux-Netzwerkpfad wirken Netzwerktreiber, NAPI, Paketverwaltung und Socket-Schicht zusammen. Dieser Pfad ist nicht pauschal rein interruptbasiert. Ein DPDK-Poll Mode Driver fragt Empfangswarteschlangen direkt aus dem Userspace ab. Die Anwendung nimmt Pakete in Gruppen entgegen, prüft oder verändert sie und übergibt sie anschließend an eine Sendewarteschlange oder weitere Verarbeitungsstufe.
Das ist kein allgemeines Kernel-Tuning und für eine gewöhnliche Webanwendung mit wenigen TCP-Verbindungen meist nicht die erste Maßnahme. Erst wenn der Paketdatenpfad selbst nachweisbar limitiert, etwa bei L4-Lastverteilung, Filterung oder Tunnelendpunkten, rechtfertigt der mögliche Gewinn den zusätzlichen Betriebsaufwand. Versionsabhängige Eigenschaften müssen gegen die Dokumentation des konkret eingesetzten Release-Tags geprüft werden; ein Release Candidate ist dabei nicht mit einem produktiv eingesetzten Release gleichzusetzen.
Wie der Userspace-Paketpfad arbeitet
Am Eingang konfiguriert die Anwendung eine oder mehrere Rx-Queues der Netzwerkkarte. Ein zugewiesener Ausführungskern fragt eine Queue in einer Schleife ab und erhält einen Burst verfügbarer Pakete. Diese Burst-Verarbeitung reduziert Funktionsaufrufe und Verwaltungsaufwand pro Paket. Nach Klassifikation, Weiterleitung oder Änderung legt die Anwendung die Pakete gesammelt in einer Tx-Queue ab.
Polling vermeidet viele Interrupt-Wechsel im stark ausgelasteten Datenpfad und macht die Arbeit eines Kerns besser vorhersehbar. Der Preis ist eine fortlaufend aktive CPU: Auch bei leerer Queue prüft der lcore weiter auf neue Pakete. Deshalb passt dieses Modell zu konstant hoher Last eher als zu Schnittstellen mit seltenem oder stark schwankendem Verkehr.
Paketdaten und Metadaten liegen in rte_mbuf-Objekten. Diese stammen aus einem vorab angelegten Mempool und enthalten beispielsweise Paketlänge, Eingangsport, Offload-Informationen und gegebenenfalls einen RSS-Hash. Vorab reservierte Pools, eine feste Queue-Kern-Zuordnung und kurze Verarbeitungspfade fördern Cache-placering und vermeiden unnötige gemeinsame Datenstrukturen.
Zero Copy ist jedoch keine automatische DPDK-Eigenschaft. Ob und wo Daten kopiert werden, hängt von NIC, Treiber, Offloads und Anwendungslogik ab. Große oder segmentierte Frames können aus mehreren verknüpften mbufs bestehen; das ist etwa bei Jumbo Frames relevant. Wer Paketdaten umformt, zusammenführt oder zwischen inkompatiblen Puffern überträgt, muss mögliche Speicherbewegungen im eigenen Datenpfad berücksichtigen.
Architektur, Ressourcen und harte Grenzen
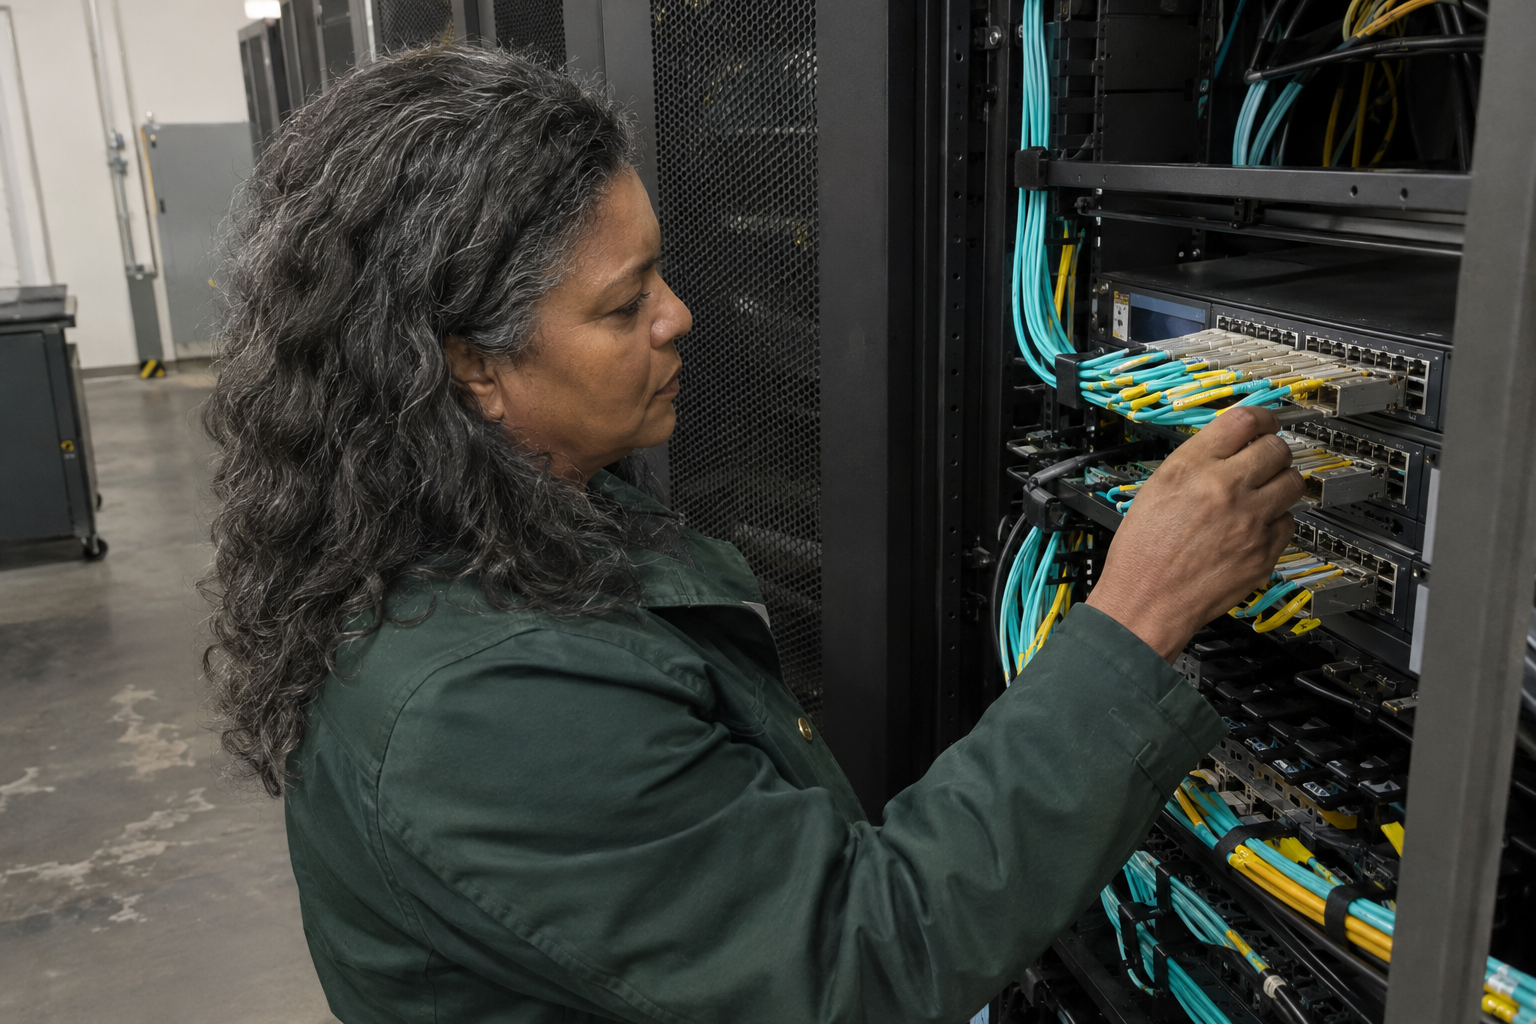
Die Environment Abstraction Layer, kurz EAL, initialisiert DPDK und stellt unter anderem Speicherreservierung, Gerätezugriff, Timer sowie die Zuordnung logischer Kerne bereit. Auf dieser Grundlage richtet die Anwendung Ethernet-Queues, Mempools und ihre Verarbeitung ein. Ein lcore ist dabei ein für DPDK eingeplanter logischer Kern, nicht einfach ein beliebig wandernder Anwendungsthread. Diese grundlegenden EAL-Eigenschaften sind hier mit der Dokumentation von DPDK 25.07 belegt; versionsabhängige Details müssen zusätzlich für den eingesetzten Release-Tag geprüft werden.
Für einen geradlinigen Datenpfad verarbeitet häufig ein Kern ein Paket vollständig: vom Empfang über die Entscheidung bis zum Senden. Dieses Run-to-completion-Modell vermeidet Übergaben zwischen Kernen. Eine Pipeline trennt dagegen beispielsweise Parser, Flow-Suche und Weiterleitung in Stufen. Sie kann Zuständigkeiten ordnen, fügt aber Ringe, Synchronisation und potenziell schlechtere Speicherlokalität zwischen den Stufen hinzu.
Die Planung muss auch NUMA beachten. Queue, lcore und Paketpools sollten nach Möglichkeit am selben NUMA-Knoten liegen, damit der Datenpfad nicht regelmäßig auf Speicher eines anderen CPU-Sockels zugreift. Die erreichbare Leistung bleibt außerdem von NIC-Funktionen, PCIe-Anbindung, Speicherbandbreite, CPU-Takt, Paketgröße und der Komplexität jeder Paketentscheidung abhängig.
Ein L4-Load-Balancer kann mit DPDK IP- und Portinformationen schnell auswerten, Flows zuordnen und Pakete weiterleiten. TLS-Terminierung, aufwendige NAT-Zustände, Logging, Health Checks oder langsame Backends werden dadurch aber nicht automatisch schneller. Ebenso braucht die Control Plane verfügbare CPU-Zeit für Konfiguration, Telemetrie und Fehlerbehandlung. DPDK beschleunigt folglich einen klar abgegrenzten Datenpfad, nicht zwangsläufig den gesamten Dienst.
Auch die Größe und Lebensdauer der Paketpuffer sind Teil der Architektur. Mempools begrenzen, wie viele Puffer gleichzeitig bereitstehen, während die Anwendung Eigentumswechsel korrekt verwalten muss. Zu knapp dimensionierte Pools können unter Last erschöpfen; übergroße Reservierungen binden Speicher. Die sinnvolle Größe ergibt sich aus Warteschlangen, Burst-Größen, Paketpfad und erwarteten Lastspitzen, nicht aus einer universellen Vorgabe.
Voraussetzungen vor dem DPDK-Einsatz prüfen
DPDK wird erst dann planbar, wenn Hardware, Speicher und CPU-Zuordnung zusammenpassen. Eine Installation allein schafft keinen leistungsfähigen Datenpfad: Der PMD muss das konkrete NIC-Modell unterstützen, und Ressourcen müssen für die Anwendung reservierbar sein. Die folgende Prüfung trennt technische Mindestvoraussetzungen von Annahmen, die erst für das tatsächlich eingesetzte Gerät gelten.

| Forudsætning | Betydning | Konkrete Prüffrage |
|---|---|---|
| NIC und PMD | Ein PMD stellt den DPDK-Zugriff auf die Netzwerkkarte bereit; Funktionen sind modell- und treiberabhängig. | Ist das genaue NIC-Modell in der unterstützten Treiberübersicht enthalten, und sind benötigte Funktionen dokumentiert? |
| Speicherplanung und Hugepages | Hugepages sind der reguläre, für große Paketpools leistungsfähige Betriebsweg; DPDK kennt mit –no-huge auch einen Sondermodus mit eigenen Eignungs- und Treibergrenzen. | Sind für den vorgesehenen Datenpfad ausreichend Hugepages reserviert, oder ist der Einsatz ohne Hugepages bewusst geprüft und begründet? |
| IOMMU und VFIO | Für viele PMDs werden Geräte vom regulären Kernel-Treiber gelöst und über VFIO bereitgestellt; bifurkierte PMDs folgen einem anderen Modell. | Welchen Bindungsweg verlangt der konkrete PMD, und ist bei VFIO die vorgesehene IOMMU-Konfiguration verfügbar? |
| CPU-pinning | Dedizierte Kerne vermeiden Scheduler-Konkurrenz im Polling-Datenpfad. | Welche logischen Kerne sind für lcores reserviert, ohne Systemdienste zu verdrängen? |
| NUMA | Lokaler Speicherzugriff reduziert unnötige Zugriffe über NUMA-Knoten hinweg. | Liegen NIC, lcores und Mempools auf demselben NUMA-Knoten? |
| Queue-Planung | Rx- und Tx-Queues bestimmen, wie Arbeit auf Kerne verteilt wird. | Gibt es pro Datenpfad eine eindeutige Queue-Zuordnung ohne unnötiges Sharing? |
| Overvågning | Paketverluste und Ressourcenengpässe müssen im Betrieb sichtbar bleiben. | Welche Zähler für NIC, Queues, Pools und Anwendung werden überwacht? |
Hugepages sind für umfangreiche Paketpools der übliche Weg, aber keine ausnahmslose Bedingung jeder DPDK-Anwendung. Die EAL unterstützt auch –no-huge. Dieser Sondermodus ist keine gleichwertige Standardempfehlung: Eignung, Speicherverwaltung und Treibergrenzen sind vor dem Pilotbetrieb zu prüfen. Die hier verwendeten System- und EAL-Grundlagen dokumentieren DPDK 25.07; gleiche die Optionen zusätzlich mit dem tatsächlich installierten Release ab.
Besonders kritisch ist die Gerätebindung. Viele PMDs setzen voraus, dass die betreffende NIC vom regulären Kernel-Treiber gelöst und beispielsweise an vfio-pci gebunden wird. Das Interface steht dem normalen Linux-Netzwerkstack dann nicht mehr regulär zur Verfügung. Die konkrete Vorgehensweise muss jedoch zum PMD passen und darf nicht pauschal auf jede unterstützte Netzwerkkarte übertragen werden.
Eine wichtige Ausnahme bilden bifurkierte PMDs. Die Treiberdokumentation weist darauf hin, dass solche PMDs nicht vom zugehörigen Kernel-Treiber gelöst werden sollen. Dabei kann der Kernel-Treiber gebunden bleiben, während ein Userspace-Datenpfad bestimmte Ressourcen nutzt. Die verlinkte unversionierte Dokumentation zeigt den Entwicklungsstand 26.11.0-rc1 und ist keine versionsgebundene Anleitung für 26.07. Prüfe Geräteunterstützung und verfügbare Kernelwerkzeuge im Handbuch des konkret eingesetzten PMD.
Vor jeder Änderung liefert die folgende Statusabfrage eine Inventur der PCI-Geräte und ihrer aktuellen Treiberbindung. Sie ändert selbst keine Bindung. Führe sie auf dem Zielsystem mit dem Pfad aus, der zur installierten DPDK-Quell- oder Werkzeugstruktur passt.
Plane Management-Zugang und Produktivdatenpfad getrennt, selbst wenn der gewählte PMD den Kernel-Treiber nicht ablöst. Die SSH- oder Konsolen-Erreichbarkeit darf nicht von einer Schnittstelle abhängen, deren Bindung oder Verkehrsaufteilung im Pilotbetrieb verändert wird. Ein separates Management-Interface, Out-of-Band-Zugang oder ein vorab geprüfter lokaler Rettungsweg begrenzt das Risiko einer Fehlkonfiguration.
DPDK, AF_XDP und Kernelstack vergleichen
Die Wahl des Datenpfads ist keine Rangliste, sondern eine Betriebsentscheidung. Linux-Kernelstack, AF_XDP und DPDK verschieben jeweils Aufwand, Gerätezugriff und CPU-Verbrauch. Die passende Option richtet sich danach, ob tatsächlich die Paketrate oder Latenz im Netzwerkpfad begrenzt – oder ob Anwendung, Verschlüsselung und Backends den Engpass bilden.
| Fremgangsmåde | Datasti | Gerätebesitz | CPU-Verhalten | Typiske anvendelser | Wichtigste Grenze |
|---|---|---|---|---|---|
| Linux-Kernelstack | Regulärer Kernel-Netzwerkstack mit Sockets und Kernel-Funktionen. | NIC bleibt reguläres Kernel-Interface. | Interrupts zur Ereignismeldung, unter Last NAPI-Polling; Verarbeitung und Anwendungen unterliegen der Kernel-/Scheduler-Steuerung. | Allgemeine Serverdienste, Routing und Anwendungen mit vorhandenen Linux-Werkzeugen. | Paketverarbeitung kann bei sehr hoher Paketrate zum Engpass werden. |
| AF_XDP | XDP mit Userspace-Sockets; je nach Treiber Copy- oder Zero-Copy-Modus. | Integration bleibt am XDP- und Socket-Modell orientiert. | Abhängig von Modus, Treiber und Queue-Zuordnung. | Gezielte Beschleunigung einzelner Queues bei weiterem Kernelbezug. | Zero Copy ist nicht auf jedem Treiber verfügbar. |
| DPDK | PMDs pollen Rx- und Tx-Deskriptoren direkt im Userspace. | Viele PMDs verlangen eine Bindung außerhalb des regulären Kernel-Netzwerkpfads; bifurkierte PMDs lassen den Kernel-Treiber dagegen gebunden. | Polling beansprucht reservierte Kerne auch bei geringer Last. | Hohe Paketraten, spezialisierte Filter, Load Balancer und NFV. | Mehr Ressourcenplanung; Kernelintegration und Verkehrsaufteilung hängen vom konkreten PMD-Modell ab. |
AF_XDP ist eine Zwischenoption für Teams, die Pakete früh behandeln und dennoch nahe am Linux-Netzwerkmodell bleiben möchten. Der Kernel beschreibt einen Copy-Modus sowie Zero Copy, das Treiberunterstützung voraussetzt. Wird Zero Copy ausdrücklich verlangt, kann die Socket-Erstellung fehlschlagen, falls der Treiber diese Fähigkeit nicht anbietet. Für die Einordnung der XDP-Ebene hilft der Beitrag XDP und eXpress Data Path.
DPDK nutzt dagegen Poll Mode Drivers und verarbeitet Warteschlangen direkt aus der Anwendung heraus. Das kann Socket- und Interrupt-Anteile für den DPDK-Datenpfad umgehen, verlangt aber Verantwortung für Speicher, Queues und Kernzuordnung. Zero Copy ist dabei weder ein allgemeines Leistungsversprechen noch eine automatische Eigenschaft eines beliebigen DPDK-Pfads; Kopien hängen von Anwendung, Offloads und Speicherübergaben ab.
Wähle den Kernelstack, wenn Routing, Firewalling, Observability und einfacher Betrieb wichtiger sind als ein spezialisierter Paketpfad. Prüfe AF_XDP bei gezielter Beschleunigung mit Kernelanbindung. DPDK lohnt sich erst bei belegtem Bedarf an hoher Paketrate oder gleichmäßiger Latenz, vorhandener NIC-Unterstützung und einem Team, das die zusätzliche Betriebsverantwortung dauerhaft tragen kann.
Queues, CPU-Pinning und NUMA sinnvoll planen
Eine belastbare Queue-Zuordnung beginnt mit der Nähe zwischen NIC, CPU und Speicher. Die EAL unterstützt die Auswahl logischer Kerne, Speicherreservierung und Gerätezuschnitt. Für einen einfachen Datenpfad ist es meist sinnvoll, eine Rx-Queue einem lcore fest zuzuordnen, den zugehörigen Mempool am lokalen NUMA-Knoten anzulegen und die Verarbeitung anschließend an eine passende Tx-Queue zu übergeben. Diese grundlegenden EAL-Angaben sind mit der Dokumentation von DPDK 25.07 belegt und müssen für versionsabhängige Optionen gegen den eingesetzten Release-Tag geprüft werden.
Ein nicht produktspezifisches Beispiel für einen Host mit zwei NUMA-Knoten wäre: Die NIC an Knoten 0 erhält zwei Rx-Queues; je ein lcore an Knoten 0 bearbeitet eine Queue vollständig. Die Paketpuffer liegen ebenfalls auf Knoten 0. Ein weiterer, nicht pollender Kern bleibt für Verwaltungsaufgaben frei, während Knoten 1 für andere Dienste oder klar getrennte Datenpfade vorgesehen wird.
- Datenpfad: je Queue ein fest zugeordneter lcore, lokale Mempools und klar benannte Rx-/Tx-Paare.
- Verwaltung: CPU-Kapazität für Telemetrie, Steuerlogik, Ereignisse und Betriebssystemdienste freihalten.
- Reserve: Kapazität für Lastspitzen, Fehlersuche und geplante Erweiterungen einplanen, statt alle Kerne dauerhaft zu verplanen.
Teile eine Rx-Queue nicht zwischen mehreren lcores. Der PMD-Leitfaden rät vom Teilen von Rx- und Tx-Queues ab, weil dafür nötige globale Sperren die Leistung stark beeinträchtigen können. Gleichzeitiger Zugriff mehrerer lcores auf eine Tx-Queue ist nur dann als dokumentierte Ausnahme vorgesehen, wenn der Treiber die Fähigkeit RTE_ETH_TX_OFFLOAD_MT_LOCKFREE meldet. Prüfe diese Capability für die konkrete NIC-/PMD-Kombination; leite sie weder aus der Portgeschwindigkeit noch aus einem allgemeinen Offload-Schalter ab.
Eine Pipeline mit getrennten Parser-, Klassifizierungs- und Sendestufen kann Zuständigkeiten klarer machen. Der dokumentierte Pipeline-Ansatz übergibt Pakete über Ringe an weitere Kerne; dadurch entstehen zusätzliche Speicherzugriffe und Übergaben. Für einfache Filter oder L4-Weiterleitung ist Run-to-completion pro Queue häufig leichter zu planen. Mehrere Stufen sollten nur eingesetzt werden, wenn die Arbeitsteilung ihren Mehraufwand im konkreten Lastprofil rechtfertigt.
Også Hardware-Offloads dürfen nicht in die Planung hineingelesen werden. Welche Checksum-, Segmentierungs-, RSS- oder Flow-Funktionen verfügbar sind, ergibt sich aus den Fähigkeiten des konkreten Ethernet-Geräts und seines PMD. Prüfe sie vor dem Entwurf und behandle einen fehlenden Offload als normalen Planungsfall, nicht als Ausnahme.
DPDK im Betrieb sicher beobachten
Der Betrieb eines DPDK-Datenpfads braucht Metriken, die Paketverarbeitung und Ressourcen zusammen betrachten. Erfasse mindestens verarbeitete, verworfene und fehlerhafte Pakete sowie anwendungseigene Werte für Verarbeitungsraten, Mempool-Reserven und Latenzverteilung statt nur eines Mittelwerts. Welche zusätzlichen Port-, Queue- oder Treiberzähler verfügbar sind, hängt vom konkreten PMD, der NIC und der Anwendung ab und muss für die eingesetzte Kombination geprüft werden.
Polling ist ein bewusster Zielkonflikt. Ein lcore fragt seine Rx-Queue fortlaufend ab, damit Pakete ohne den regulären Interruptpfad verarbeitet werden können. Bei wenig oder keinem Traffic bleibt die Pollschleife dennoch aktiv. Plane deshalb neben Datenpfad-lcores CPU-Kapazität für Steuerlogik, Telemetrie und Betriebssystem ein. Die ergänzend verwendete EAL-Dokumentation bezieht sich auf DPDK 25.07; releaseabhängige Funktionen sind im installierten Stand zu prüfen.

Für die Ursachenanalyse ist eine zeitliche Korrelation wichtig. Tritt Paketverlust zugleich mit Fehlerzählern, sinkenden Mempool-Reserven oder einem ausgelasteten Datenpfad-lcore auf, sind dies zunächst prüfbare Hinweise und noch kein eindeutiger Ursachennachweis. Schwankende Antwortzeiten können unter anderem mit NUMA-fernem Speicher, konkurrierenden Aufgaben oder Pipeline-Übergaben zusammenhängen. Vergleiche solche Hypothesen jeweils mit Kernzuordnung, Queue-Verteilung und Messwerten desselben Zeitfensters.
Schnelle Erfassung am Interface ist nicht gleichbedeutend mit vollständiger, dauerhaft verlustfreier Paketaufzeichnung. Für Flow-Statistiken oder Header-Auswertung können wenige Metadaten genügen. Soll jedes Paket gespeichert werden, begrenzen zusätzlich Speicherbandbreite, Puffervolumen, Schreibdurchsatz und das gewählte Speichermedium den Aufbau. Datenschutz und Aufbewahrungsregeln sind dabei unabhängige Anforderungen, die der Netzwerkdurchsatz nicht löst.
Plane virtuelle Maschinen und Container als eigene Integrationsaufgabe. Kläre für die konkrete Plattform, wie Gerätezugriff, Speicher, CPU-Zuordnung und erforderliche Rechte bereitgestellt werden. Prüfe diese Kombination mit dem eingesetzten PMD, statt Beispielparameter pauschal zu übernehmen. Der verlinkte Linux-Leitfaden gehört aktuell zum Entwicklungsstand 26.11.0-rc1; für einen Produktivaufbau ist die Dokumentation des tatsächlich installierten Releases maßgeblich.
Typische Fehlerbilder systematisch prüfen
Eine Fehlersuche sollte zuerst beobachtbare Symptome von möglichen Ursachen trennen. Ändere nicht gleichzeitig Treiberbindung, Queue-Zahl und Speicherparameter, weil der Auslöser dann nicht mehr nachvollziehbar ist. Nicht-destruktive Zähler, Konfigurationseinblicke und ein Vergleich zwischen betroffener und unbetroffener Queue liefern vor Eingriffen meist die belastbareren Hinweise.
| Symptom | Zu prüfende Hypothesen | Nicht-destruktive Prüfung |
|---|---|---|
| Pakketab | Der verarbeitende lcore hält möglicherweise nicht Schritt, Paketpuffer werden knapp oder der PMD meldet Empfangsfehler. | Anwendungs-, Port- und verfügbare Treiberzähler, Mempool-Reserven und CPU-Auslastung im selben Zeitfenster vergleichen. |
| Unregelmäßige Latenz | NUMA-ferner Speicher, konkurrierende Aufgaben oder zusätzliche Pipeline-Übergaben können beteiligt sein. | CPU- und Speicherzuordnung sowie Queue-Eigentümer prüfen; Latenzausreißer getrennt nach Datenpfad erfassen. |
| Hohe CPU-Last bei wenig Traffic | Die Pollschleife läuft auch bei leerer Empfangsqueue weiter. | Auslastung des pollenden lcores gegen die tatsächliche Paketrate stellen und reservierte Kerne dokumentieren. |
| Host nicht erreichbar | Eine Management-Schnittstelle könnte umgebunden oder ihre Verkehrsführung verändert worden sein. | PCI-Geräte- und Bindungsstatus über einen getrennten Management- oder Konsolenzugang prüfen. |
| Offload fehlt | NIC-Modell, PMD oder Konfiguration stellt die gewünschte Fähigkeit möglicherweise nicht bereit. | Feature-Matrix und gemeldete Gerätefähigkeiten für das konkrete NIC-Modell abgleichen. |
Bei auffälligem Queue-Verhalten prüfst du Queue-Eigentümer und den NUMA-Knoten des Mempools. Im Run-to-completion-Modell verarbeitet der zugeordnete lcore Empfang, Verarbeitung und Senden; eine Pipeline übergibt Pakete an weitere Kerne. Teile die Rx-Queue trotzdem nicht zwischen lcores. Gleichzeitiger Zugriff auf eine Tx-Queue ist nur bei gemeldeter RTE_ETH_TX_OFFLOAD_MT_LOCKFREE-Fähigkeit als Ausnahme vorgesehen. Eine selbst ergänzte Sperre macht Queue-Sharing nicht zur empfohlenen Skalierungsstrategie.
Bei fehlenden Hardware-Offloads ist die richtige Frage nicht allein, welcher Schalter gesetzt wurde, sondern welche Fähigkeit Gerät und PMD tatsächlich bereitstellen. Eine Anwendung kann eine gewünschte Funktion einplanen, ohne dass sie für dieses Modell verfügbar ist. Vergleiche die Unterstützung für die konkrete NIC mit den zur Laufzeit gemeldeten Fähigkeiten, bevor du den Datenpfad von diesem Offload abhängig machst.
Ergebnisse von testpmd sind als Baseline oder Funktionsprüfung einzuordnen, nicht als Leistungsnachweis der späteren Anwendung. Im io-Forwarding-Modus werden Pakete unverändert weitergeleitet, ohne ihre Inhalte für fachliche Verarbeitung auszuwerten. Parser, Flow-Tabellen, NAT, Verschlüsselung und Protokollzustand bildet dieser Modus nicht ab. Die verlinkte unversionierte Dokumentation gehört zu 26.11.0-rc1; prüfe das Verhalten im Handbuch des installierten Releases. Halte Forwarding-Modus, Paketgröße, Rx-/Tx-Queue-Zahl und Forwarding-Kerne fest und wiederhole den Vergleich mit realer Verarbeitungslogik.
Rollout, Versionspflege und Einsatzentscheidung
Beginne mit einem isolierten Test und einem dokumentierten lastprofil: Paketgrößen, Spitzenlast, Flussanzahl und benötigte Verarbeitungsschritte. Prüfe die konkrete NIC samt passendem Poll Mode Driver und benötigten Funktionen anhand der offiziellen Hardwareübersicht und Treibermatrix. Ein gelisteter Hersteller allein bestätigt weder jede Karte noch sämtliche Offloads. Teste anschließend mit realer Anwendungslogik, nicht ausschließlich mit einem Weiterleitungsbeispiel.
Halte DPDK-Version, Firmware, Treiber, Kernel und Konfiguration für jeden Versuch fest. Lies vor einem Update die Release Notes des exakt vorgesehenen Release-Tags und dokumentiere, welche Änderungen für den eigenen Datenpfad relevant sind. Release-Notes unterschiedlicher Versionen sind kein Ersatz für diese Zuordnung, weil sich Funktionen und Einschränkungen zwischen Releases ändern können.
Ein konkreter Prüfpunkt aus den Release Notes zu DPDK 26.07 ist der geänderte Flush-/Refill-Algorithmus des Mempool-Caches: Seine effektive Größe entspricht seitdem der konfigurierten Größe; zuvor war sie 50 Prozent größer. Nur wenn jeder lcore an einem Mempool ausschließlich Objekte entnimmt oder ausschließlich zurückgibt, empfehlen die Release Notes eine Verdopplung der konfigurierten Cachegröße, um eine mögliche Verdopplung der Cache-Miss-Rate zu vermeiden. Das betrifft etwa Pipelines mit getrennten Rx- und Tx-lcores, nicht pauschal Run-to-completion. Die Änderung betrifft Release 26.07; die verlinkte historische Release-Seite steht inzwischen innerhalb der Dokumentation zu 26.11.0-rc1.
Beginne mit einem begrenzten Pilot und festen Abbruchkriterien. Vergleiche Durchsatz, hohe Latenzperzentile, Paketverluste und CPU-Bedarf unter gleichen Bedingungen mit dem bisherigen Betrieb. Prüfe Überwachung, Neustarts und Rückfall auf die vorherige Konfiguration. Berücksichtige den Betriebsaufwand; eine allgemeine Durchsatzgarantie lässt sich daraus nicht ableiten.
DPDK lohnt sich als Einsatzentscheidung vor allem dann, wenn der gemessene Nutzen den zusätzlichen Pflegeaufwand rechtfertigt. Für die Einordnung der umgebenden Systemplattform ergänzt der Beitrag Linux-Kernel im Hostingbetrieb die Planung. Behalte für gewöhnliche Hostingdienste auch den bestehenden Netzwerkpfad als Vergleichsbasis im Test.
Kilder og den aktuelle videnskabelige viden
Status for undersøgelsen:
Fachstand: 25. Oktober 2026. Konkret als stabiler Funktionsstand benannte Angaben beziehen sich auf DPDK 26.07.0. Die Quellen S4 und S5 dokumentieren grundlegende System- und EAL-Eigenschaften anhand von DPDK 25.07; versionsabhängige Optionen sind deshalb zusätzlich im eingesetzten Release zu prüfen. S6 und S12 verweisen im Quellenregister auf den unversionierten Dokumentationszweig und werden nicht als eigenständiger Nachweis für DPDK 26.07 behandelt. S13 enthält die release-spezifischen Angaben zu 26.07, besitzt im Register jedoch ebenfalls eine unversionierte Dokumentations-URL.
https://doc.dpdk.org/guides-26.03/prog_guide/ethdev/ethdev.html
https://core.dpdk.org/supported/nics/
https://doc.dpdk.org/guides-25.07/prog_guide/env_abstraction_layer.html
https://doc.dpdk.org/guides-26.07/prog_guide/mbuf_lib.html
https://doc.dpdk.org/guides-25.07/linux_gsg/sys_reqs.html
https://doc.dpdk.org/guides/linux_gsg/linux_drivers.html
https://docs.kernel.org/networking/af_xdp.html
https://doc.dpdk.org/guides/linux_gsg/
https://doc.dpdk.org/guides/testpmd_app_ug/testpmd_funcs.html
https://doc.dpdk.org/guides/rel_notes/release_26_07.html