 Videre til indhold

CloudLinux-rapporter viser mig tydeligt, hvilke LVE-grænser de enkelte konti rammer, og hvor CPU, hukommelse, I/O eller entry-processer rent faktisk udgør en flaskehals. Jeg gennemgår disse data målrettet for at identificere tilbagevendende fejl, daglige mønstre og akutte flaskehalse og ud fra dette udlede konkrete optimeringer.
Centrale punkter
Jeg vil først sammenfatte følgende punkter, så du kan gå målrettet i gang med analysen.
- LVE-nøgletal Læs korrekt: SPEED, MEM, IO, IOPS, PNO, EP
- Live-data Kontroller med LVE Manager og lvetop
- Forløb via lveinfo, lvechart, cloudlinux-statistics
- Fejl Prioritering: hyppighed, tidspunkt, årsag
- Foranstaltninger udlede for CPU, RAM, I/O og EP
Sådan tolkes de rigtige nøgletal: SPEED, MEM, IO, IOPS, PNO, EP
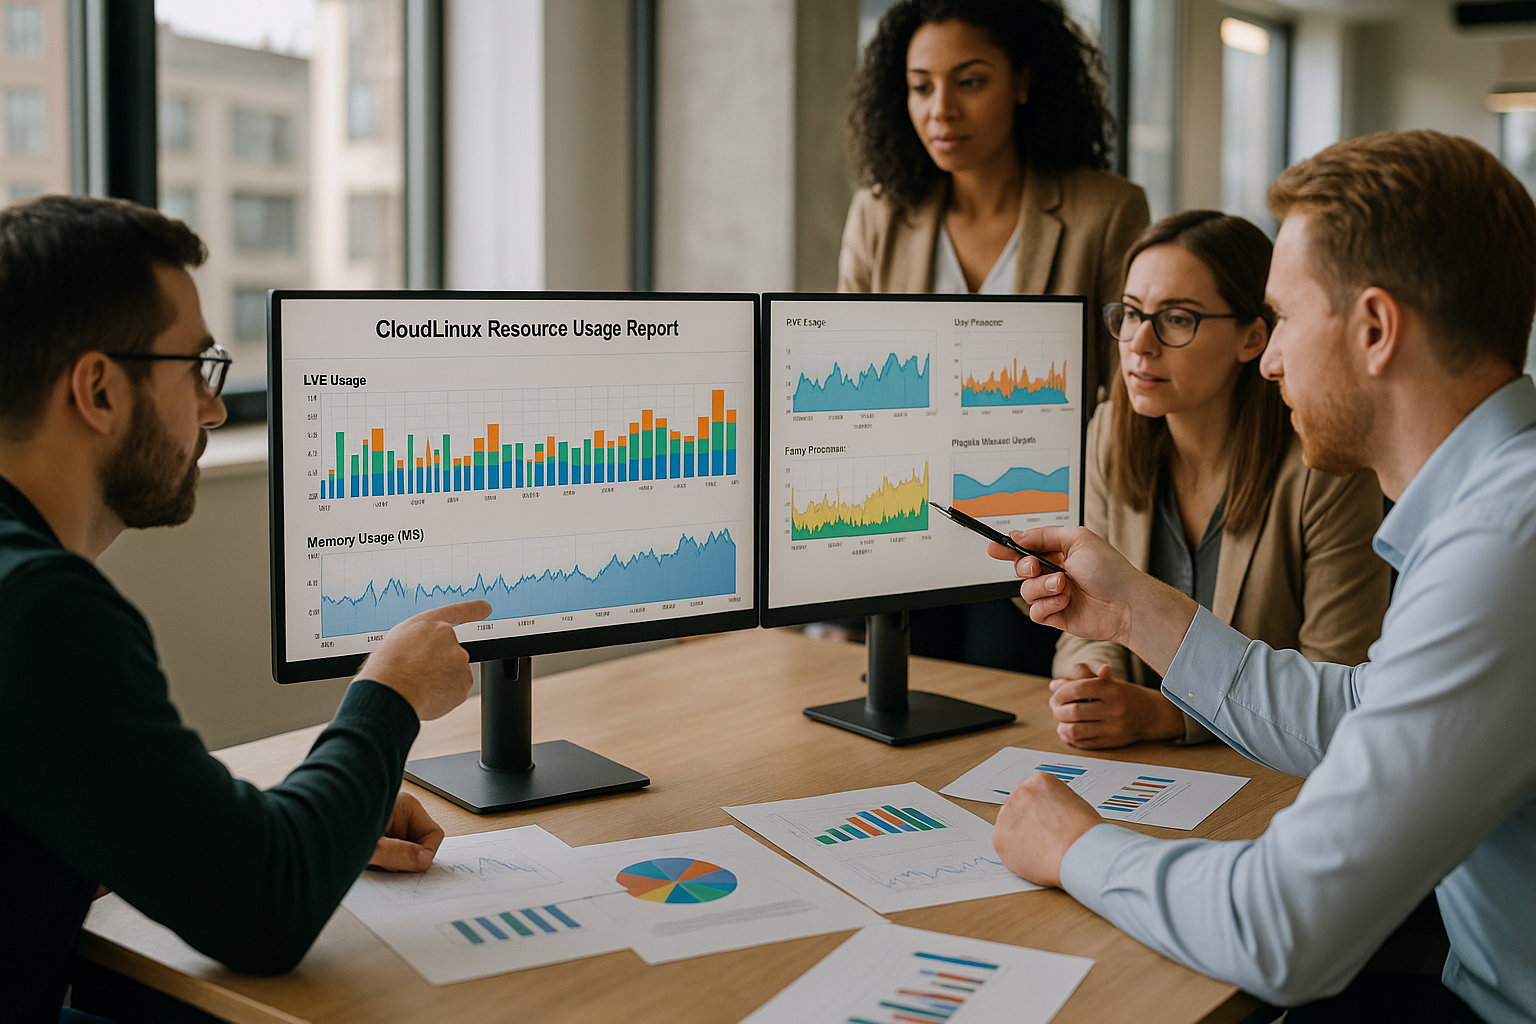
Jeg starter hver analyse med Nøgletal, som CloudLinux angiver i LVE-sammenhæng. SPEED beskriver den tildelte CPU-regnekraft, MEM står for RAM-forbruget, IO for datagennemstrømning og IOPS for antallet af I/O-operationer. PNO viser det samlede antal kørende processer, EP de samtidige Entry Processes, der begrænser webadgangen. Hvis man konstant ser høje værdier, er der som regel ikke tale om et kortvarigt spidsbelastningsproblem, men om et strukturelt belastningsmønster. Jeg tjekker altid, om grænserne konstant bliver nået, eller om der kun forekommer enkelte udsving, der kan forklares uden begrænsninger.
| Nøgletal | Betydning | Typiske symptomer | Første kontroller |
|---|---|---|---|
| SPEED | CPU-ydeevne (andel/grænse) | Lange PHP-kørselstider, timeouts | Kontroller PHP-profiler, opcode-cache og caching |
| MEM | Arbejdshukommelse pr. konto | OOM-nedbrud, 500-fejl under belastning | Gennemgang af PHP memory_limit, plugins og forespørgsler |
| IO | Gennemstrømning i MB/s | Langsomme downloads/uploads | Statisk cache, mediekomprimering, lagring |
| IOPS | Antal I/O-operationer | Træg DB/filadgang | Indekser, forespørgselsplan, objektcache |
| PNO | Overordnede processer | Øget serverbelastning | Daemon-/Cron-overskridelser, worker-begrænsninger |
| EP | Samtidige web-tilgange | 503-fejl ved Peaks | HTTP-cache, hastighedsbegrænsninger, kontrol af bots |
Live-overvågning med LVE Manager og lvetop
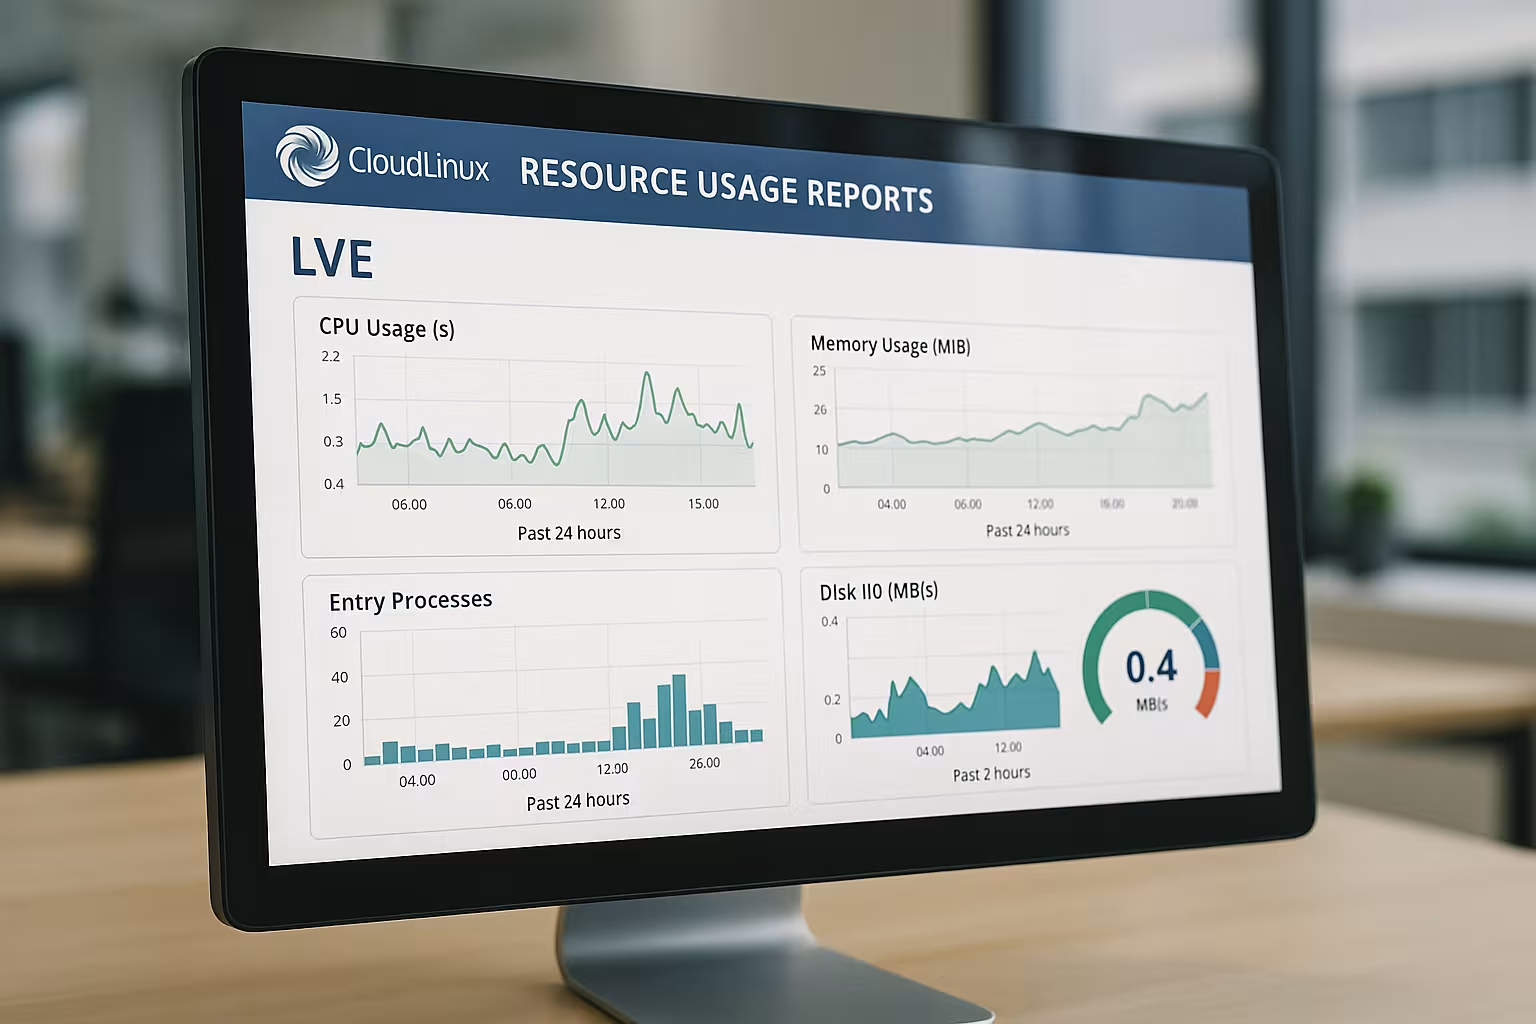
Til hurtige analyser bruger jeg Live-data i LVE Manager og lvetop i shellen. Visningen »Current Usage« viser mig i realtid, hvordan CPU, RAM, I/O, IOPS, processer og entry-processer kører. Ved belastningsspidser holder jeg øje med, om det er EP eller SPEED, der først når grænsen, da det har indflydelse på de næste skridt. lvetop er velegnet til straks at udvælge de mest ressourcekrævende konti og i værste fald at begrænse eller optimere dem. Hvis man ønsker at dykke dybere ned i grænsefladen, kan man målrettet tilpasse grænser og visninger – jeg bruger gerne denne vejledning til det: Konfigurer LVE Manager.
Historisk analyse: lveinfo, lvechart og cloudlinux-statistics
Jeg genkender tendenser gennem Forløb og fejlhistorik, ikke kun øjebliksbilleder. Med lveinfo trækker jeg tidsvinduer og kan se, hvornår grænserne præcist blev udløst, og hvor ofte det skete. lvechart giver mig visuelle spidsbelastninger over timer eller dage, hvilket gør mønstre i løbet af døgnet synlige. cloudlinux-statistics supplerer analysen, når jeg har brug for længere tidsserier pr. konto. Ved at kombinere disse værktøjer får jeg svar på spørgsmålene „hvornår“, „hvor ofte“ og „under hvilke betingelser“ der opstår belastninger.
At forstå og prioritere fejl
Et »Fault« betyder: Det Grænse blev registreret, og CloudLinux har begrænset båndbredden. Derfor sorterer jeg fejl først efter hyppighed, derefter efter ressourcetype og tidspunkt på døgnet. Daglige EP-fejl omkring middagstid tyder ofte på trafikspidser eller bots, mens RAM-fejl om natten snarere har at gøre med cron-jobs og sikkerhedskopieringer. Hvis der er mange CPU-fejl, leder jeg efter ineffektive PHP-rutiner, defekte cacher eller opgaver, der kører uhindret. Denne inddeling sparer tid, fordi jeg kan optimere præcis der, hvor brugerne mærker en mærkbar begrænsning.
Afdækning af årsager: typiske mønstre og modforanstaltninger
Ud fra min erfaring sorterer jeg Prøve hurtigt finde de konkrete årsager. Vedvarende høje EP-værdier tyder på for mange samtidige forespørgsler eller manglende edge-caching. Vedvarende højt RAM-forbrug skyldes ofte plugins, temaer eller processer med hukommelsestab. IO- og IOPS-spidser tyder på datakrævende opgaver, uindekserede forespørgsler eller mange små filadgange. For at undgå fejltolkninger tjekker jeg samtidig systemhelbredsindikatorer – man kan hurtigt komme i gang med CloudLinux-tilstandstjek.
Genkendelse af cronjobs, sikkerhedskopier og bots
Et kig på forklarer mange fejlserier Punkter i tiden og opgaver. Hvis begrænsningen altid opstår kort efter den fulde time, kører der ofte cron-jobs parallelt, som konkurrerer med besøgende. Tilbagevendende spidsbelastninger om natten tyder ofte på sikkerhedskopieringer, der udnytter I/O og IOPS fuldt ud. Mærkelige EP-fejl uden tilsvarende trafik i Analytics tyder ofte på bots eller scrapere, der omgår statisk indhold. I sådanne tilfælde indstiller jeg hastighedsbegrænsninger, flytter jobs til roligere tidsvinduer og aktiverer konsekvent edge- eller side-caches.
Analyse af data pr. forhandler og konto
I større opsætninger adskiller jeg Niveauer Overskueligt: Forhandlere, deres kunder og enkelte konti. LVE Manager giver netop dette overblik og viser mig, hvilken delstruktur der udløser grænseværdier. På den måde kan jeg se, om en enkelt kunde skiller sig ud, eller om flere projekter inden for en forhandlerstruktur samtidig udgør en belastning. I forbindelse med supportprocesser markerer jeg de berørte konti og angiver foranstaltninger, så tilbagevendende supportanmodninger kan løses hurtigere. Denne gennemsigtighed hjælper med at fordele ressourcerne retfærdigt og holde omkostningerne pr. kunde overskuelige.
Dimensionering af grænseværdier og tilpasning af takster
Jeg sætter grænser Realistisk, ikke maksimalt. For snævre EP-grænser forårsager 503-fejl, mens for lave SPEED-værdier forsinker hvert eneste PHP-svar. Hvis du regelmæssigt ser fejl, skal du først tjekke optimeringerne og derefter taksterne. Når projekter bliver forretningskritiske, kan det betale sig at vælge en højere profil, der udjævner spidsbelastninger og sikrer stabilitet. Jeg dokumenterer effekterne i forløbsgraferne, så beslutningen forbliver gennemsigtig.
Databasetunge projekter: Optimering af I/O og IOPS
Når det gælder databasebaserede hjemmesider, tjekker jeg IOPS og IO går altid hånd i hånd med forespørgselens kvalitet. Mange små forespørgsler uden indekser genererer høje IOPS-værdier og forlænger responstiden. Erfaringen viser, at objektcache, forespørgselscaching og tilpassede indekser reducerer denne strøm markant. Til trendanalyser læser jeg desuden databaserapporterne og sammenligner dem med LVE-forløb. Denne vejledning giver mig et grundigt indblik i MySQL Governor-rapporter, for at kunne klassificere DB-belastningen korrekt.
Overvågningshåndbog: Fra alarm til handling
Ud fra måleværdierne udarbejder jeg en Playbook, der tydeligt viser enhver eskalering. Trin 1: Kontroller i realtid, om grænseværdierne i øjeblikket er i kraft, og hvilken ressource der først går ned. Trin 2: Åbn historikken, sammenlign tidsvinduerne og markér gentagelser. Trin 3: Lokalisere årsagen – kodesti, cache, database, cron, bot – og definere modforanstaltninger med testkriterier. Trin 4: Efter indgrebet skal man igen kontrollere live og i historikken, om fejl og latenstid falder. Denne faste rækkefølge undgår impulsive handlinger og skaber reproducerbare resultater.
At fortolke sammenhængene mellem grænseværdierne korrekt
I praksis virker begrænsninger sjældent isoleret. Derfor vurderer jeg Interaktioner mellem EP, SPEED, MEM og IO/IOPS: Hvis EP og SPEED stiger samtidigt, er det som regel CPU’en, der sætter grænsen pr. anmodning; hvis en side- eller edge-cache hjælper, falder begge nøgletal samtidig. Hvis jeg ser en forhøjet EP med konstant lav SPEED, hober anmodningerne sig op på webserveren, ofte på grund af for få workers, Keep-Alive-konfigurationer eller blokerende eksterne opkald (f.eks. API, e-mail). MEM-fejl ved moderat SPEED tyder på få, men hukommelseskrævende processer (f.eks. billedkonvertering, store eksportopgaver). IO/IOPS-toppe uden nævneværdig CPU-belastning tyder på datakrævende fil- eller databaseadgange. Disse sammenhænge bruger jeg til at første hypotese før jeg går nærmere ind på detaljer om koden eller serveren.
Praksis: Effektiv brug af lvetop, lveinfo og cloudlinux-statistics
For at få hurtige resultater arbejder jeg med klare Forespørgsler og filtrere. lvetop hjælper mig med at se de største ressourceforbrugere hvert sekund og skifte mellem sortering efter CPU, MEM eller IO. Med lveinfo opretter jeg vinduer på 1 time, 24 timer og 7 dage for at liste fejltidspunkter, spidsværdier og berørte ressourcer pr. konto. cloudlinux-statistics leverer længere tidsserier og er velegnet til at dokumentere tiltag (før/efter). For hver indgriben dokumenterer jeg altid: tidsperiode, berørte konti, maksimumsværdier pr. ressource, antal fejl samt responstider fra applikations- eller webmonitorering. På den måde kan jeg dokumentere optimeringer og forhindre, at grænser lempes „på mavefornemmelse“.
Webstack-detaljer: PHP-handlere, workere og OPcache
En vigtig drivkraft ligger i PHP-udførelse: Antallet af PHP-workere pr. konto, deres RAM-budget (memory_limit) og OPcache. For mange workere uden cache øger EP/PNO og MEM, mens for få workere skaber en ophobning af anmodninger (EP stiger, svartiden øges). Derfor finder jeg et optimalt punkt: så mange arbejdsprocesser som nødvendigt, så få som muligt. OPcache skal være tilstrækkeligt dimensioneret (hukommelse og interne strenge), ellers kompilerer PHP konstant på ny og øger SPEED. Derudover tjekker jeg, om statiske ressourcer virkelig betjenes af webserveren (og ikke af PHP), og om Keep-Alive/HTTP/2-multiplexing fungerer korrekt. Målet er at dynamiske anmodninger til reducere og hurtigt at få de resterende opgaver ud af vejen.
Anvend caching-strategier konsekvent
Jeg skelner mellem tre niveauer: Edge/CDN-cache for global aflastning, HTTP-/sidecache lige før PHP og Objekt-cache inden for applikationen. Edge-cache sænker EP og IO for statiske ressourcer drastisk. Page-cache reducerer dynamiske hits og har en direkte indvirkning på EP/SPEED. Objekt-cache (f.eks. til hyppige DB-opslag) sænker IOPS og CPU. Det er vigtigt med en stabil Cache-nøgle (f.eks. ingen unødvendige cookies) samt fornuftige TTL-værdier pr. sidetype. For administrations- eller indkøbskurvsområder planlægger jeg undtagelser, mens jeg alle andre steder tilstræber en så høj cache-andel som muligt. Efter aktivering observerer jeg: Opstår der EP-fejl? Reduceres median-svarstiderne?
RAM-styring: memory_limit, processer og lækager
MEM-fejl opstår ofte, fordi memory_limit er sat generøst, og parallelle processer sprænger grænsen. Derfor foretager jeg en kalibrering: hvor meget RAM kræver en typisk anmodning? Ud fra det udleder jeg det maksimalt fornuftige antal arbejdsprocesser. Derudover holder jeg PHP-biblioteker og plugins slanke, fjerner ubrugte udvidelser og tjekker langvarige scripts (eksport, import, billedbehandling) for lækager. OPcache reducerer belastningen på RAM ved at cache kompilerede data, men må ikke selv være for lille. Ved tilbagevendende spidsbelastninger isolerer jeg de „dyre“ stier ved hjælp af profilering og griber målrettet ind – det sparer oftere RAM end generelle forhøjelser af grænserne.
Målrettet reduktion af I/O og IOPS
IO/IOPS-spidsbelastninger opstår som følge af mange små fil- eller databaseadgange. Jeg samler arbejdsbelastninger, hvor det er muligt: Generering af miniaturer som batch i stedet for on-demand, minimering af assets i build-fasen i stedet for ved hver anmodning, session- og transient-hukommelse i én Objekt-cache outsource, så der sker færre filadgange. I databasen prioriterer jeg indekser til hyppige WHERE-/JOIN-klausuler og eliminerer N+1-forespørgsler. Sideløbende sammenligner jeg LVE-forløb med DB-rapporterne fra MySQL Governor for at identificere hotspots. Målet er at omdanne mange små IOPS til få, effektive adgangshandlinger – det udjævner spidsbelastninger og mindsker risikoen for fejl.
Afbøde EP-fejl: Køhåndtering og besøgsstrømme
EP begrænser antallet af samtidige adgange. Hvis der kommer mange anmodninger til cacher med begrænset kapacitet, opstår der hurtigt EP-fejl. Jeg forhindrer dette ved at Køer før jeg implementerer PHP (korte anmodningskøer på webserveren), indstiller Keep-Alive hensigtsmæssigt og sørger for, at dynamiske stier, der ikke er personaliserede, konsekvent caches. For bots definerer jeg rate-limits og blokerer åbenlyse bad actors tidligt. Derudover tjekker jeg tredjepartsopkald i anmodningsstien – blokerende eksterne tjenester øger opholdstiden pr. anmodning og forbruger dermed EP. Hvor det er muligt, flytter jeg eksterne integrationer til jobs/køer.
Planlægning af cronjobs og sikkerhedskopieringer på en ressourcebesparende måde
Jeg adskiller tilbagevendende opgaver fra spidsbelastningsperioder og regulerer dem: Jeg justerer cron-tabellerne (forskyder dem med et antal minutter), forhindrer parallelle kørsler ved hjælp af lock-filer, og jeg regulerer belastningen via Nicing og batchstørrelser. Jeg planlægger sikkerhedskopieringer til tidsvinduer med lav trafik og sørger for at anvende inkrementelle metoder, så IO/IOPS holdes inden for rimelige grænser. For ressourcekrævende opgaver i appen sætter jeg begrænsninger for antallet af samtidige arbejdsprocesser, så MEM og SPEED ikke stiger pludseligt. Jeg overvåger effekten undervejs: falder antallet af fejl om natten, og mindskes belastningsspidserne ved hver fulde time?
CageFS, filsystemet og inoder i fokus
Ud over LVE-grænserne påvirker Faktorer vedrørende filsystemet Ydeevnen: Millioner af små filer (f.eks. cache-fragmenter) øger antallet af metadatahentninger og øger IOPS. Jeg holder cache-mapperne ryddelige, begrænser filstrømmen ved hjælp af fornuftigt aggregerede cacher og overvåger inode-udnyttelsen. CageFS sørger for isolering, men forkert placerede midlertidige filer (f.eks. i webrooten i stedet for i tmp-mappen) øger IO unødigt. En periodisk sundhedstjek af disse områder forhindrer, at I/O-flaskehalse fejlagtigt tolkes som rene CPU- eller RAM-problemer.
Gennemsigtighed og kommunikation i forbindelse med forhandlere
I forhandlermiljøer dokumenterer jeg Indlæs driver for hvert underområde og fastlægger foranstaltninger: Hvilke grænseværdier er der fastsat? Hvilke optimeringer er planlagt? Hvordan ser før-og-efter-graferne ud? Denne gennemsigtighed fremskynder support-svar og skaber accept for takstskift, når optimeringspotentialet er udtømt. Jeg fastlægger grænseværdier, hvorfra vi griber ind (f.eks. tilbagevendende fejl > N/dag eller median svarstid > X ms), og knytter dem til klare handlingsforløb – så undgår vi endeløse sløjfer i ticket-systemet.
Undgå almindelige fejltolkninger
Der er et par mønstre, jeg ser jævnligt: Stigende CPU-belastning er ikke En automatisk advarsel om „for lidt CPU“ – ofte fungerer cacherne ikke, eller forespørgslerne er ineffektive. Mange EP-fejl betyder ikke nødvendigvis „mere trafik“ – bots, forkert konfigurerede overvågningsværktøjer eller heartbeats kan være årsagen. MEM-fejl kan ikke altid løses ved at øge memory_limit – ofte er der for mange samtidige processer. IO/IOPS-toppe afhænger ikke udelukkende af lagringen – de udløses af applikationsmønstre. Jeg verificerer derfor altid hypoteser med korrelerede diagrammer og, hvis muligt, med korte modtests (f.eks. aktivere cache for et delområde og kontrollere forløbet igen).
Test, måling, efterslibning
Jeg vurderer hver ændring med klare målepunkter: før/efter aktivering af sidecachen, før/efter indeksopdatering, før/efter justering af arbejdsprocesser. Til dette bruger jeg LVE-historik, responstidsmålinger og fejlprocenter (5xx/4xx). Hvor det er muligt, foretager jeg A/B-sammenligninger i lavtrafikperioder for at isolere afledte effekter. Hvis der stadig opstår fejl, gentager jeg processen: finjustering af limitkombinationer, profilering af yderligere hotpaths, tilpasning af jobbenes batchstørrelser. Erfaringen viser, at to til tre målrettede gentagelser giver betydeligt bedre resultater end én stor, generel foranstaltning.
Resumé: Sådan læser jeg CloudLinux-ressourceforbrugsrapporter effektivt
Jeg vurderer CloudLinux-Dataene er altid opdelt i tre niveauer: Live, historik, fejl. Nøgletallene SPEED, MEM, IO, IOPS, PNO og EP giver mig et overblik over årsager og virkninger. Med lvetop kan jeg straks se, hvad der belaster systemet; med lveinfo og lvechart dokumenterer jeg mønstre over flere dage. Ud fra tilbagevendende fejl udleder jeg behov for caching, optimering af forespørgsler, justering af begrænsninger eller ændring af takstplan. Denne metode reducerer supportomkostningerne, øger reaktionssikkerheden og gør hosting-ydeevnen gennemsigtig.


