 Ir al contenido

Agrupación de Redis En PHP, reduce la sobrecarga de las conexiones, disminuye la latencia y garantiza que Redis no se convierta en un cuello de botella cuando la carga es elevada. Te mostraré cómo configuro los grupos de conexiones con phpredis y PHP-FPM para que las sesiones, las cachés y las colas respondan de forma notablemente más rápida.
Puntos centrales
Voy a resumir los aspectos más importantes de forma breve y clara para que puedas activar correctamente el «pooling» sin rodeos. agrupación Influye en los costes de transporte, en los errores y en la planificación de la capacidad, por lo que merece la pena llevar a cabo una implementación estructurada. Me centro en phpredis, PHP-FPM y entornos asíncronos, porque es ahí donde se producen los mayores efectos. Unos valores predeterminados bien fundamentados ayudan a evitar riesgos como las conexiones „contaminadas“ y a lograr tiempos de respuesta constantemente cortos. Al final, conocerás los parámetros con los que podrás ajustar tu Conexiones lo controles.
- Utilizar pconnect en lugar de «connect» para sockets reutilizables
- Límites INI para el tamaño del pool, comprobaciones de actividad y patrones
- Votación sobre el FPM Comparativa con el parámetro «maxclients» de Redis
- Tiempos muertos Ser conciso y probar las rutas de error
- Condición Limpiarlo antes de devolverlo al fondo común
La lista recoge las prioridades que me he marcado para conseguir resultados rápidos sin tener que modificar el código a lo loco. Persistente Las conexiones solo aportan beneficios cuando los límites del servidor y de los procesos están bien sincronizados. Evito los errores típicos estableciendo límites estrictos y aplicando reglas de limpieza bien definidas. De este modo, la latencia se mantiene baja y Redis gestiona de forma fiable incluso los picos de carga. Quien realiza mediciones específicas, detecta rápidamente dónde hay potencial y cuánto margen de seguridad tiene el Infraestructura tiene.
Cómo el agrupamiento de conexiones reduce la latencia y ahorra recursos
Cada nuevo «handshake» de TCP lleva tiempo y sobrecarga innecesariamente el sistema operativo, por lo que reutilizo Conexiones De forma sistemática. Con los sockets persistentes evito los handshakes TLS repetidos, lo que tiene un gran impacto en muchas operaciones breves como GET/SET. Los pools evitan que se creen miles de sockets de corta duración que se quedan atascados en TIME_WAIT. Mantengo bajo el número de sockets simultáneos y, aun así, acelero el procesamiento. De este modo, aumentan el rendimiento y la capacidad de respuesta sin necesidad de realizar cambios complejos en la lógica del código de la aplicación.
El pooling resulta especialmente eficaz en configuraciones de PHP-FPM, ya que cada proceso de trabajo tiene su propio piscina gestionadas. Esto evita que Redis tenga que hacer frente a una avalancha de conexiones en los picos de carga. En el caso de las sesiones, las cachés y las colas, noto los beneficios de inmediato, ya que estas cargas de trabajo generan muchas operaciones breves. Quien quiera profundizar en el tema de las sesiones, encontrará en Sesiones de Redis en PHP el inicio adecuado. Ajusto los parámetros de tal forma que los errores de red se detecten rápidamente y que, en caso necesario, la aplicación cambie a soluciones alternativas.
En la práctica, desaparece gran parte de la latencia „fría“, ya que la conexión ya está establecida y no se produce ninguna sobrecarga de DNS ni de TLS. LivenessLas comprobaciones garantizan que los sockets defectuosos ni siquiera aparezcan en la siguiente solicitud. De este modo, la tasa de errores se mantiene baja y la interacción con el usuario resulta notablemente más ágil. Sigo unos pasos pequeños y lógicos: activo pconnect, establezco límites y activo Liveness. A continuación, compruebo cómo evolucionan las métricas y si la carga de Redis, el número de procesos de FPM y el comportamiento de la aplicación concuerdan entre sí.
phpredis: connect frente a pconnect: ¿qué ocurre realmente?
Con phpredis Distingo claramente entre `connect()` y `pconnect()`. `connect()` abre una conexión temporal por cada solicitud y la cierra al finalizar. `pconnect()` crea sockets persistentes que el trabajador FPM mantiene a lo largo de muchas solicitudes. phpredis asigna las conexiones persistentes a un grupo en función del host, el puerto, la autenticación y un persistent_id opcional. De este modo, mi código utiliza una conexión ya existente en cada llamada, en lugar de iniciar una nueva cada vez.
La siguiente tabla me ayuda a evaluar rápidamente las diferencias y a tomar la decisión correcta. Visión general Me ahorra tiempo a la hora de depurar y planificar los límites. Lo combino con mediciones para ver los efectos en mi propia pila. Sobre todo con TLS, pconnect ofrece ventajas notables. Cuanto más corta sea la operación, mayor será el beneficio que aportan los handshakes ahorrados.
| Aspecto | connect() | pconnect() |
|---|---|---|
| Vida útil | Solo la solicitud actual | Hasta que finalice el proceso FPM-Worker |
| Gastos generales del protocolo de enlace | Por solicitud, nuevo | Una sola vez, luego reutilización |
| agrupación | Sin piscina | Pool interno por trabajador |
| Imagen de error | Muchos enchufes cortos | Pocos zócalos de larga duración |
| Recomendación | Casos especiales, pruebas | Funcionamiento diario |
Sigo trabajando en la planta de producción de pconnect y utilizo „connect“ solo para el diagnóstico o en casos extremos. Los sockets persistentes se comportan de forma más estable a lo largo de numerosas solicitudes. Al mismo tiempo, me aseguro de no dejar ningún «estado» que pueda provocar problemas más adelante. Esto se aplica sobre todo a las transacciones y opciones, que limpio tras cada uso. De este modo, la siguiente solicitud obtiene una conexión limpia y la aplicación sigue siendo predecible.
Parámetros INI importantes para una gestión eficaz de los grupos de recursos
Los ajustes adecuados del archivo INI determinan lo generoso que es tu piscina gestiona las conexiones. Establezco redis.pconnect.pooling_enabled en 1 para que el pooling permanezca activo. Con redis.pconnect.connection_limit limito el número de conexiones por grupo, por ejemplo, a 32. redis.pconnect.echo_check_liveness comprueba los sockets reutilizables y descarta los que están defectuosos. Un pool_pattern coherente garantiza que phpredis agrupe las conexiones correctamente.
Una configuración inicial compacta tiene este aspecto: Límite 32, «Pooling» activado, «Liveness» activado. De este modo, el número de sockets TIME_WAIT se reduce notablemente. Superviso los clientes y las latencias, y voy ajustando paso a paso. Si se producen tiempos de espera, puedo aumentar los límites o ajustar el número de trabajadores de FPM. De este modo, me acerco a un estado que funciona correctamente incluso bajo carga.
redis.pconnect.pooling_enabled = 1
redis.pconnect.connection_limit = 32
redis.pconnect.echo_check_liveness = 1
Nunca elijo valores „a ciegas“, sino que primero mido el Tiempos de respuesta. A continuación, ajusto los límites máximos hasta que Redis, FPM y la aplicación funcionen a la perfección juntos. Los pools grandes resultan tentadores, pero aumentan el riesgo de superar el límite de «maxclients». Los pools pequeños y bien aprovechados suelen ofrecer un mejor rendimiento. Esto ahorra RAM en ambos lados y da lugar a tiempos de respuesta uniformes.
Sincronizar correctamente PHP-FPM y Redis
Primero determino cuántos Trabajador funcionan según pm.max_children. Cada worker puede mantener varios sockets de Redis, por lo que no multiplico los límites de conexión a ciegas. El propio Redis tiene un límite de maxclients que no supero. Hago el cálculo: trabajadores FPM × conexiones por grupo × aplicaciones, y lo comparo con maxclients. Si quedan reservas para los clientes de administración o supervisión, no me salgo de la curva bajo carga.
Los tiempos de espera también forman parte del ajuste fino. Tiempos muertos Las consultas típicas a la caché se realizan en un intervalo de entre 0,5 y 1,5 segundos, lo que permite detectar rápidamente cualquier fallo. Establezco los valores de `connect_timeout` y `read_timeout` de forma conservadora y registro los errores con todo detalle. Así puedo ver si hay un problema en la red o si Redis está saturado. Si se producen reinicios o tiempos de espera con frecuencia, ajusto los límites, los tiempos de espera y el número de trabajadores poco a poco.
Distingo claramente entre los errores de las aplicaciones y los errores de caché. Fallbacks No deben bloquear la solicitud si Redis sufre un pequeño fallo momentáneo. Esto mejora la experiencia general y mantiene la capacidad de respuesta de las interfaces de usuario. Unos buenos registros me indican si sufro sobrecarga o cortes de conexión. A partir de ahí, ajusto los trabajadores, el tamaño de los pools o el propio servidor Redis.
Un consejo concreto: empieza con „núcleos × 2“ como límite por trabajador y, a continuación, comprueba la carga de trabajo real. Valores medidos Confía en tu intuición en cualquier entorno. Sigue de cerca las métricas y ve aumentando poco a poco si hay solicitudes pendientes. Así aprovecharás el hardware de forma eficaz. Al mismo tiempo, el número de sockets abiertos se mantendrá bajo control.
Consulto regularmente las secciones «INFO clients» y «CLIENT LIST» para ver la información actualizada Carga . Estos valores indican si los pools funcionan o si se producen muchas conexiones nuevas. Si detecto patrones de picos, compruebo el DNS, el Keep-Alive y las comprobaciones de actividad. En caso de duda, realizo pruebas sin TLS para evaluar la influencia de los handshakes. A continuación, vuelvo a activar TLS con reanudación de sesión.
Uso seguro de conexiones persistentes
Los sockets persistentes conservan su Condición hasta que el worker finalice, por lo que limpio explícitamente. Cierro las transacciones correctamente con EXEC o DISCARD. Para cada solicitud, establezco de forma coherente la base de datos necesaria mediante SELECT y todas las opciones que requiere mi código. Antes de la devolución, no debe quedar abierto ningún canal ni MULTI. Solo así se mantiene la conexión del pool en buen estado para su uso.
Es obligatorio realizar comprobaciones de validez antes de reutilizar el código. Defectos Bloqueo los sockets inmediatamente y fuerzo una reconexión. Distingo claramente entre „servidor caído“ y „tiempo de espera agotado“, porque reacciono de forma diferente en cada caso. En caso de tiempo de espera agotado, recurro rápidamente a soluciones alternativas; en caso de interrupción de la conexión, prefiero volver a conectarme. De este modo, la aplicación sigue funcionando de forma predecible, incluso cuando la red da problemas.
Anoto qué opciones establece una conexión para que no haya sorpresas más adelante. Transacciones Lo anoto especialmente, porque es aquí donde suelen producirse errores. Para las bibliotecas, elijo variantes que transmitan correctamente pconnect. En las pruebas, simulo cortes de red, reinicios del servidor Redis y picos de retraso. Solo cuando la aplicación lo soporta sin problemas, la pongo en producción.
Un obstáculo habitual son los «global states» en las clases auxiliares. limpieza Después de cada uso, evita que los indicadores, los modos de solo lectura o los tiempos de espera „se queden fijados“. Mantengo la lógica de conexión de forma centralizada, por ejemplo, en una clase de servicio. Esto reduce la tasa de errores en todo el código. Además, facilita las pruebas con simulaciones o backends alternativos.
Quien cambia el pooling con poca frecuencia, olvida fácilmente las repercusiones que esto tiene en las pruebas, la interfaz de línea de comandos (CLI) o las tareas programadas (cronjobs). CLI-Los scripts también se benefician de pconnect cuando se ejecutan con frecuencia. Para los que se ejecutan durante mucho tiempo, adapto las comprobaciones de estado. Para los scripts que se ejecutan una sola vez, basta con connect con tiempos de espera cortos. Los valores predeterminados uniformes evitan sorpresas durante el funcionamiento.
Pooling en pilas asíncronas de PHP (Swoole y similares)
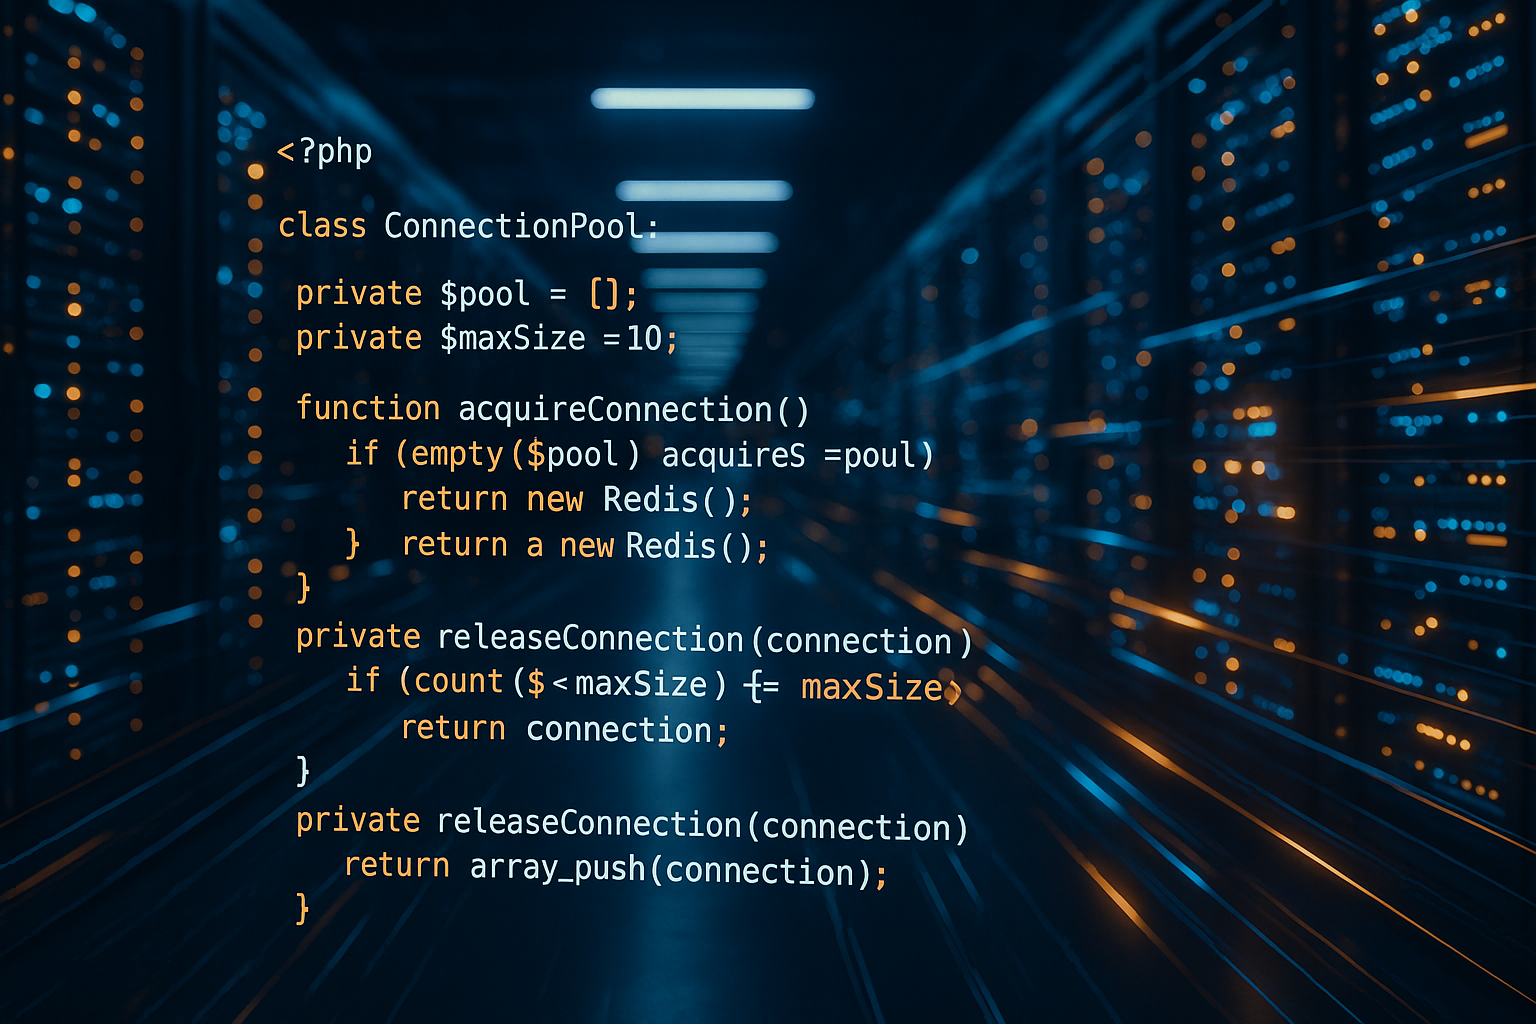
En entornos asíncronos como Swoole Los procesos PHP de larga duración funcionan con sus propios modelos de worker. Inicializo el pool de Redis al iniciar el worker o la primera vez que se necesita. Las corrutinas toman prestada una conexión y la devuelven tras su uso. El tamaño del pool puede crecer de forma dinámica, pero sigue estando limitado. De esta forma, distribuyo los sockets de manera eficiente entre los trabajos y las solicitudes.
Un objeto RedisPool abstraído aporta claridad al código de la aplicación. APIs Funciones como getConnection() y releaseConnection() encapsulan los detalles y evitan las fugas de memoria. Registro la duración de los préstamos, las tasas de error y los tiempos de espera en el pool. Si los tiempos de espera aumentan, amplío el tamaño del pool o el número de trabajadores. Esto evita la contrapresión y garantiza tiempos de respuesta cortos.
En este caso también se aplica lo siguiente: no dejar restos de estado en las conexiones. Transparencia El registro muestra si las comprobaciones de disponibilidad se activan a tiempo. Pruebo de forma específica las rutas de conmutación por error, incluyendo errores de DNS y pérdida de paquetes. Así puedo detectar a tiempo si las estrategias de reconexión funcionan correctamente. Esto resulta especialmente útil en las pruebas de carga.
Presto especial atención a la sobrecarga de TLS, ya que los sistemas asíncronos generan muchas operaciones paralelas. Reanudación Además, Keep-Alive reduce los costes por socket. El pipelining y las lecturas por lotes contribuyen también a reducir los viajes de ida y vuelta. La combinación con un serializador ligero ahorra aún más tiempo. Al final, lo que cuenta es la rapidez con la que el usuario ve el resultado.
Para las métricas, utilizo etiquetas por trabajador y por grupo. Rastreando A nivel de solicitud, permite ver cuándo un trabajo está a la espera de una conexión. Esto pone de manifiesto los cuellos de botella que no se detectan con una monitorización basada únicamente en Redis. Así consigo encontrar el equilibrio óptimo entre el tamaño del grupo y el número de trabajadores. A partir de ahí, el rendimiento se estabiliza de forma apreciable.
Redis como capa de caché en el alojamiento web
En entornos de alojamiento, utilizo Redis para las sesiones, la caché de páginas y la caché de objetos, por lo que agrupación Es obligatorio. Las consultas frecuentes y breves se benefician enormemente de las conexiones reutilizadas. En el caso de WordPress, tengo en cuenta las particularidades de la caché de objetos y compruebo su comportamiento bajo carga. Si quieres informarte sobre los obstáculos más habituales, consulta Caché de objetos en WordPress. Así evito los picos prolongados de TTFB y mantengo una visualización rápida de las páginas.
Almaceno las sesiones en Redis para que los trabajadores de PHP-FPM funcionen independientemente del Almacenamiento hacerlo. Con el pooling reduzco la sobrecarga de bloqueo en la solicitud y alivio la carga de E/S. Es importante separar claramente las claves de sesión, las claves de aplicación y las herramientas de administración. Así mantengo una visión general a la hora de planificar la capacidad. Para ello, documento los TTL para dejar que las entradas antiguas caduquen de forma controlada.
En entornos multitenant, segmento los grupos por `persistent_id` o por host, para que los clientes funcionen de forma claramente separada. Aislamiento Reduce el riesgo de que un cliente acapare las conexiones de los demás. Me aseguro de que los límites por cliente sean realistas. Además, preveo reservas para que las tareas de administración no se ralenticen. Esto garantiza una experiencia homogénea en todas las aplicaciones.
Para agilizar las implementaciones, dispongo de una configuración estándar que adapto con precisión a cada aplicación. Por defecto Incluyen pconnect, Liveness, límites moderados y tiempos de espera claros. A continuación, las pruebas de carga comprueban la escalabilidad. Si una prueba falla, ajusto los límites y el número de trabajadores de FPM poco a poco. De este modo, evito reacciones excesivas y mantengo la curva de aprendizaje plana.
Para cada aplicación, registro cuántas conexiones se necesitaron en los momentos de mayor tráfico. Planificación Al basarse en cifras reales, evita sorpresas en los picos de tráfico. Esto supone un ahorro de costes y tiempo en el funcionamiento. Al mismo tiempo, el servidor Redis funciona sin problemas. Y los usuarios obtienen respuestas más rápidas.
Agrupar correctamente Pub/Sub, comandos de bloqueo y colas
Los comandos Pub/Sub y de bloqueo, como BLPOP o XREAD, bloquean el socket. Estos Esquiador de fondo Nunca utilizo el grupo general. En su lugar, utilizo un cliente Redis independiente y dedicado por cada trabajador, exclusivamente para tareas de bloqueo o Pub/Sub. De este modo, el grupo habitual queda libre para llamadas GET/SET rápidas y la latencia de las solicitudes web se mantiene constantemente baja.
En el caso de los trabajadores BRPOP, determino el número de consumidores en paralelo y mantengo los tiempos de espera cortos, para que las reconexiones se produzcan rápidamente en caso de fallos. Para Pub/Sub, separo estrictamente las conexiones de lectura de las de escritura. Cierro las suscripciones de forma controlada antes de que se recicle el worker, para evitar sockets colgados. Esta práctica evita que los sockets del pool permanezcan „accidentalmente“ en modos bloqueantes.
Transacciones, WATCH/UNWATCH y scripts Lua
La puesta en común potencia los efectos de condiciones como MULTI/EXEC, WATCH o las cachés de scripts. Tras cada transacción, llamo sistemáticamente a EXEC o DISCARD y ejecuto UNWATCH si utilizo el bloqueo optimista. En el caso de los scripts de Lua, Redis almacena los scripts en caché por conexión; utilizo EVALSHA con un plan de contingencia a EVAL en caso de errores de NOSCRIPT, para que el código siga funcionando de forma robusta tras las reconexiones y los cambios de grupo.
function evalsha_safe(Redis $r, string $sha, array $keys = [], array $argv = []) {
  try {
    return $r->evalSha($sha, array_merge($keys, $argv), count($keys));
  } catch (RedisException $e) {
    // NOSCRIPT-Fallback
    if (str_contains($e->getMessage(), 'NOSCRIPT')) {
      // $script hier passend bereitstellen
      return $r->eval($GLOBALS['MY_SCRIPT'], array_merge($keys, $argv), count($keys));
    }
    throw $e;
  }
}
En mi bloque „finally“, también elimino el valor de UNWATCH en caso de que se haya establecido WATCH. De este modo, la conexión permanece «neutral» cuando vuelve al pool, y la siguiente solicitud puede funcionar sin condiciones previas ocultas.
Sockets de Unix, TLS y serializadores/compresión
Si PHP y Redis se ejecutan en el mismo servidor, prefiero utilizar Enchufes Unix. De este modo, se ahorra la sobrecarga de TCP y se reducen aún más las latencias. El «persistent_id» sigue siendo el mismo; solo cambia el punto final. En sistemas con múltiples usuarios, me aseguro de que los permisos de los sockets sean los adecuados.
$r = new Redis();
$r->pconnect('/var/run/redis/redis.sock', 0, 0.5, 'app_pool_unix');
$r->setOption(Redis::OPT_READ_TIMEOUT, 1.0);
Con TLS activo la reanudación de sesión, mantengo las cadenas de certificados reducidas y evito las nuevas resoluciones de DNS. Los tiempos de keep-alive cortos en el sistema operativo (tcp_keepalive) ayudan a detectar más rápidamente las rutas defectuosas, sin volver a conectarse de forma demasiado agresiva.
Optimizo el serializador para la transferencia de datos. igbinary Reduce notablemente el tamaño de las cargas útiles y el tiempo de CPU en comparación con la serialización de PHP. Cuando resulta conveniente, añado una compresión ligera.
$r->setOption(Redis::OPT_SERIALIZER, Redis::SERIALIZER_IGBINARY);
$r->setOption(Redis::OPT_COMPRESSION, Redis::COMPRESSION_LZF);
Utilizo el serializador y la compresión de forma selectiva: para valores muy pequeños no merece la pena, pero para objetos grandes en la caché de objetos, a menudo sí que vale la pena. Las mediciones en mi propia pila permiten aclararlo rápidamente.
Clústeres, centinelas y conmutación por error con grupos
En GrupoEn estas configuraciones, trabajo con RedisCluster y activo las conexiones persistentes. Cada nodo gestiona sus propios sockets en el worker. Superviso las redirecciones (MOVED/ASK) y compruebo si aumentan, lo que sería un indicio de reequilibrio o de una distribución inadecuada de las claves.
$rc = new RedisCluster('cluster', ['10.0.0.1:6379','10.0.0.2:6379'], 0.5, 1.0, true); // persistent
$rc->setOption(Redis::OPT_READ_TIMEOUT, 1.0);
Con Sentinel Un nivel adicional supervisa al servidor maestro. En caso de conmutación por error, descarto de forma selectiva del grupo todas las conexiones al antiguo servidor maestro y fuerzo un restablecimiento. Planifico tiempos de vida (TTL) cortos para el DNS o trabajo con Sentinel-Discovery directamente mediante una lista de direcciones IP, para que el cambio surta efecto rápidamente. Las comprobaciones de actividad detectan de forma fiable los sockets antiguos e inactivos.
Límites del servidor, expulsión y Keep-Alive
El pooling solo funciona si Redis está correctamente configurado. Creo que clientes máximos Con un búfer (10–20 %) por debajo del límite máximo calculado y teniendo en cuenta los clientes adicionales (administrador, supervisión). Configuro el «client-output-buffer-limit» para «normal/pubsub» de tal forma que los consumidores lentos no saturen la memoria. Utilizo `tcp-keepalive` de forma moderada para detectar conexiones inactivas sin generar una carga innecesaria de paquetes.
A plena carga, lo que determina es la Política de desalojo sobre el comportamiento y las latencias. Para las cachés, utilizo variantes «volatile» o «allkeys», dependiendo del diseño de las claves. Importante: las expulsiones se reflejan en las métricas; si aumentan considerablemente, significa que la caché es demasiado pequeña o que la estrategia de TTL no es adecuada. Realizo los ajustes necesarios antes de que aumenten los tiempos de espera.
Cálculo de la capacidad con un ejemplo
Un modelo de cálculo práctico evita los valores atípicos: supongamos que hay 12 trabajadores FPM y tres aplicaciones comparten el mismo Redis (sesiones, caché, cola). Por cada trabajador, preveo entre 2 y 3 sockets por aplicación (operaciones breves), lo que da un total de aproximadamente 12 × 3 × 3 = 108 sockets teóricos. Con límite_de_conexión 16 por grupo; sin embargo, en la práctica, con la carga real, solemos quedarnos muy por debajo de esa cifra (entre 60 y 80). Con un máximo de 1.000 clientes, queda una amplia reserva para los clientes de administración y supervisión, así como para tareas esporádicas de la interfaz de línea de comandos (CLI). Mido periódicamente los picos y reduzco los límites cuando nunca se alcanzan; de este modo, el consumo de memoria por conexión se mantiene bajo.
Backoff, Circuit Breaker y Graceful Reload
Cuando cometo errores, confío en retroceso exponencial con jitter, para evitar efectos de «Thundering Herd». Tras unos cuantos intentos fallidos, abro un «Circuit Breaker» y recurro temporalmente a soluciones alternativas, en lugar de saturar los pools con reintentos inútiles. Las operaciones que se realizan con éxito cierran el «Circuit» rápidamente.
En Recarga Utilizo PHP-FPM (modo «graceful») para dejar que los trabajadores se cierren de forma gradual. De este modo, las conexiones persistentes se liberan de forma ordenada. Observo si, tras una recarga, se producen temporalmente más conexiones nuevas y, si es necesario, ajusto la tasa de inicio de nuevos trabajadores. Así evito picos de conexiones durante las implementaciones.
Profundizar en la observabilidad
Registro métricas por trabajador, aplicación e ID de grupo. Además de la monitorización desde Redis, analizo los tiempos de espera para obtener una „conexión libre“. Si estos aumentan, significa que el grupo es demasiado pequeño o que hay operaciones bloqueantes que ocupan los sockets. Establezco sencillos Runbooks por ejemplo: „Si los tiempos de espera son > X, entonces…“, incluyendo la secuencia de pasos para el límite del pool, el número de trabajadores, el tiempo de espera de lectura y el análisis de CLIENT LIST. Estos guiones aceleran enormemente la resolución de incidencias.
Resumen y próximos pasos
Activo pconnect, establezco un `connection_limit` moderado, activo las comprobaciones de actividad (Liveness Checks) y ajusto los trabajadores de FPM con el parámetro `maxclients` de Redis. A continuación, defino tiempos de espera ajustados y limpio los estados de conexión antes de devolverlos al pool. Mediante la monitorización y pequeñas iteraciones, encuentro el punto óptimo para mi aplicación. Las sesiones, las cachés y las colas responden entonces con mayor rapidez y de forma más constante. De este modo, saco el máximo rendimiento del hardware disponible sin tener que modificar demasiado el código.
A continuación, compruebo el Límites mi entorno y mido los efectos del pooling bajo carga. Preveo reservas para los clientes de administración y supervisión. En el caso de WordPress, optimizo especialmente la caché de objetos y compruebo el TTFB. En las pilas asíncronas, garantizo la asignación y devolución de objetos del pool. Con estos pasos consigo tiempos de respuesta cortos, bajas tasas de error y servidores sin sobrecarga.


