 Ir al contenido

Explico de forma breve y detallada cómo Evento MPM que utiliza la cola de eventos de Apache para gestionar de forma eficiente un gran número de conexiones HTTP simultáneas. En este artículo explico los conceptos básicos, el bucle de eventos, las colas internas y los pasos concretos de optimización para una performante Configuración.
Puntos centrales
- Bucle de eventos separa la gestión de conexiones del procesamiento de solicitudes
- Keep-Alive Ya no bloquea hilos
- Cola de eventos ordena los sockets según su estado
- Parámetros Cómo ajustar «MaxRequestWorkers» de forma específica
- Monitoreo garantiza una planificación fiable de la capacidad
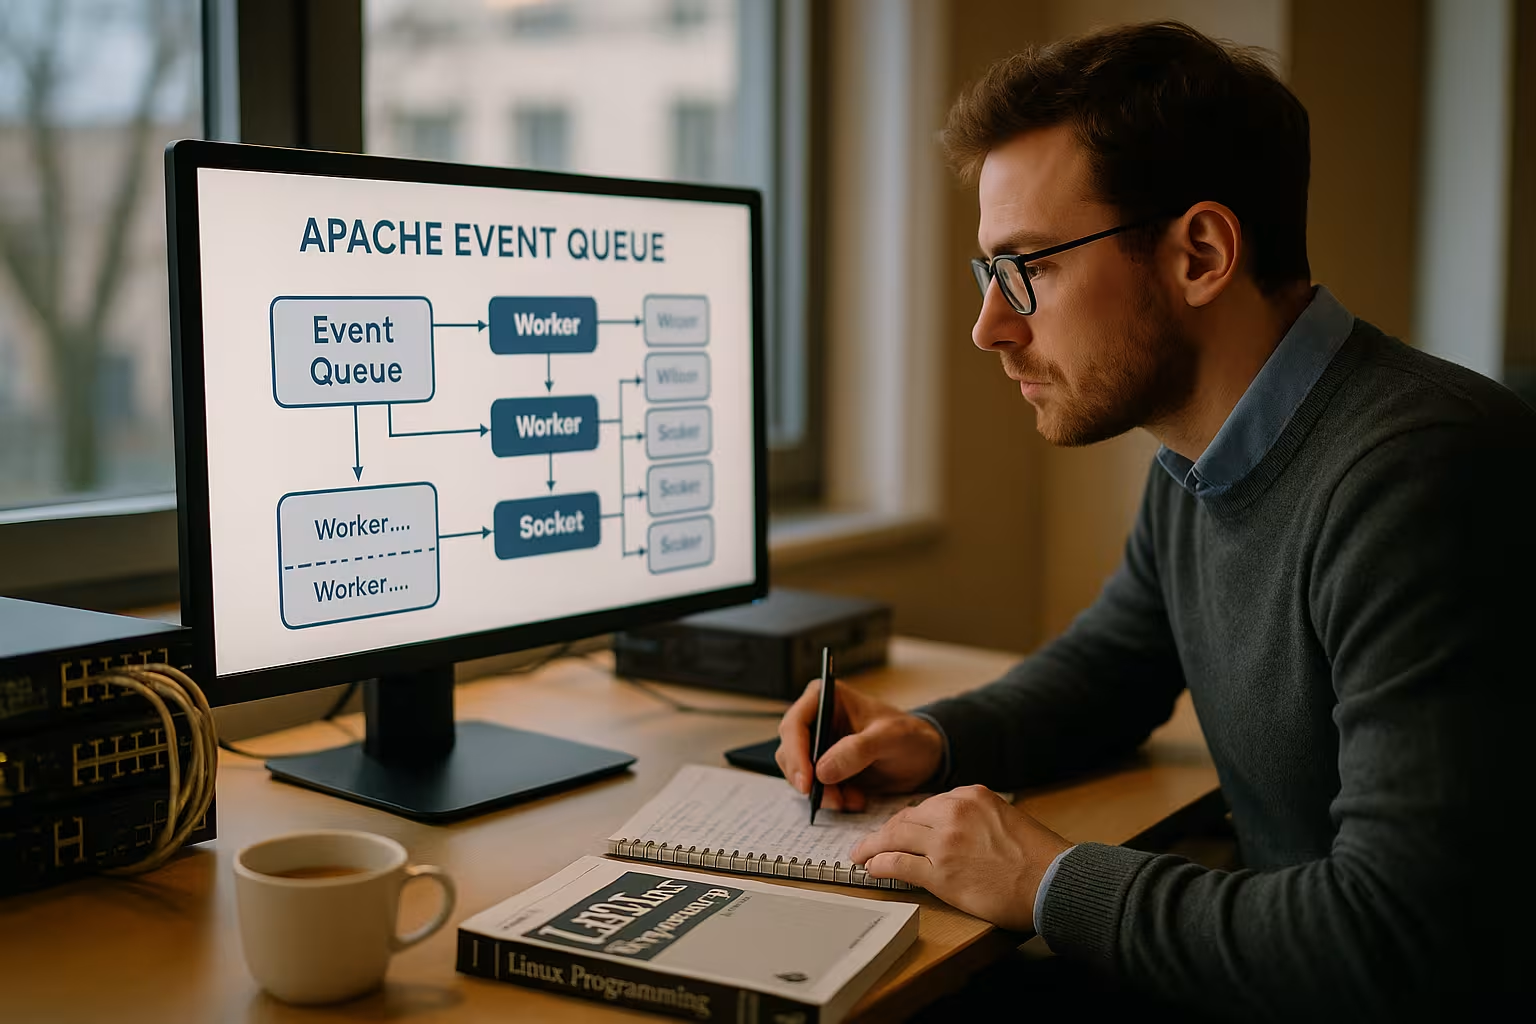
Cómo controla Event MPM las conexiones
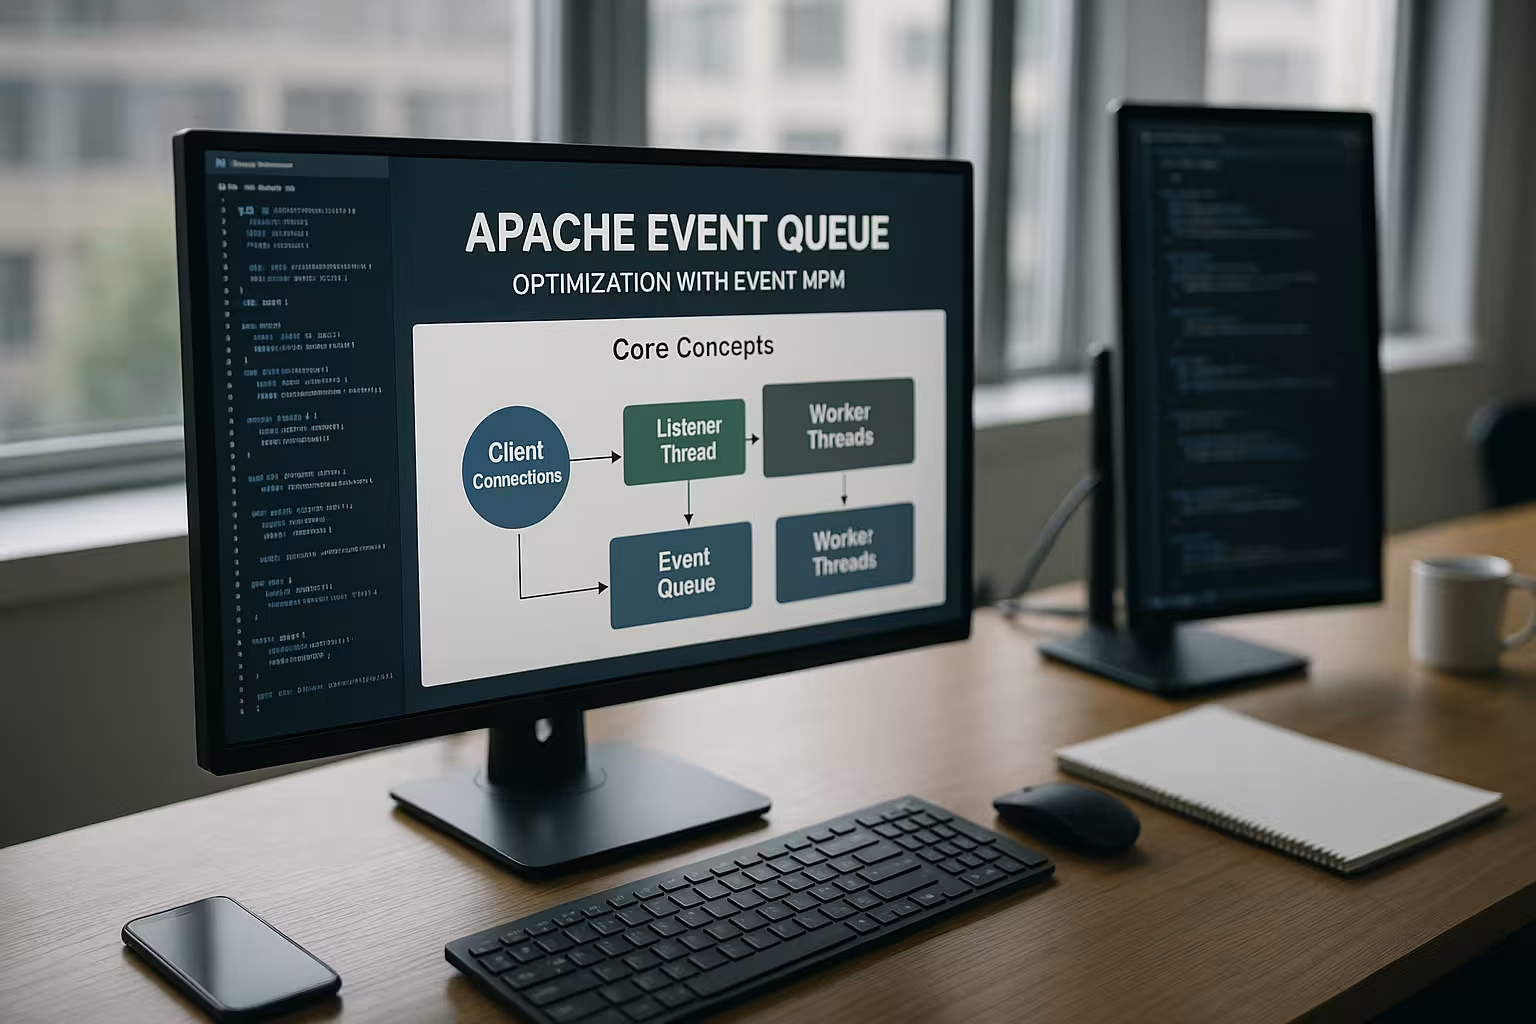
Empezaré preguntando cómo se ejecuta Apache en Carga gestiona tantas conexiones. Event MPM combina procesos y subprocesos, pero da prioridad a los eventos a través de un bucle de eventos. Los subprocesos de escucha aceptan nuevos sockets y supervisan las conexiones existentes sin bloquear inmediatamente a un trabajador. Solo cuando los datos están listos para ser leídos o escritos, la capa de eventos transfiere el socket a un hilo de trabajo libre. De este modo, evito que marcha en vacío- Las conexiones ocupan hilos y desperdician memoria.
Esta separación reduce notablemente la carga sobre la RAM. Los hilos se encargan principalmente del „trabajo real“, como el análisis de peticiones, la generación de respuestas o la gestión del proxy. A continuación, el bucle de eventos devuelve los sockets al estado adecuado, por ejemplo, de vuelta al modo «Keep-Alive» o a la fase de cierre. En la práctica, observo colas más cortas durante los picos de carga, ya que los hilos libres vuelven a estar disponibles más rápidamente. La arquitectura ofrece una clara escalable Capacidad de respuesta para cargas de trabajo típicas de HTTP/1.1 y HTTP/2.
La cola de eventos de Apache en detalle
La cola de eventos asigna un estado a cada conexión, y ahí es precisamente donde radica el Beneficios en comparación con los MPM clásicos. Las nuevas conexiones llegan primero a una cola que comprueba si son legibles. Cuando llegan datos, el bucle de eventos traslada el socket a una cola „legible“ y lo asigna a un trabajador. Tras el procesamiento, el estado vuelve a determinar la acción a seguir: finalizar la escritura, mantener la conexión activa o cerrarla. Este ciclo se mantiene ágil, ya que la gestión de colas se lleva a cabo de forma eficiente mediante epoll o kqueue.
A menudo veo malentendidos: la cola de eventos no sustituye a los trabajadores, sino que coordina su Utilice más eficiente. Los subprocesos siguen procesando las solicitudes, pero solo cuando realmente fluyen bytes. Esto ahorra recursos de la CPU y la memoria en situaciones con muchas conexiones „inactivas“ de tipo «keep-alive». Cuanto más limpio sea el diseño de los tiempos de espera y los búferes, menor será el riesgo de que las conexiones permanezcan innecesariamente durante mucho tiempo en estados costosos. De este modo, se puede mantener constante el tiempo de respuesta incluso con miles de sockets abiertos.
El problema del «keep-alive» en los MPM clásicos
En HTTP/1.1, las conexiones suelen permanecer abiertas para enviar varias solicitudes sin necesidad de un nuevo protocolo de enlace, lo que Latencia ahorra. Sin embargo, Prefork o Worker asignan para ello procesos o subprocesos que solo están a la espera. En los picos de carga, muchas conexiones «keep-alive» bloquean entonces valiosos recursos de ejecución. Esto aumenta el consumo de RAM y limita el número de clientes en paralelo. El MPM Event mitiga este problema manteniendo los sockets inactivos sin hilo en un estado de espera óptimo mediante la cola de eventos.
De este modo, dejo en espera numerosas conexiones y no inicio el procesamiento hasta que realmente es necesario. Esto modifica el modelo de capacidad: en lugar de «hilos = conexiones», utilizo «hilos = trabajo activo». En escenarios de pruebas de rendimiento, esto me permite admitir un número significativamente mayor de conexiones abiertas sin que se produzcan caídas en el Tiempo de respuesta. Para los backends de API, el alojamiento de WordPress y los sitios web con gran volumen de contenido, esto se traduce en una carga de trabajo mucho más uniforme. Se mantienen las ventajas del «keep-alive» sin que se bloqueen los hilos.
MPM de eventos frente a MPM de trabajadores
Resumo las diferencias de forma concisa en una Cuadro juntos. El objetivo es ofrecer una visión rápida sobre su manejo, los recursos que requiere y sus ámbitos de aplicación habituales. Ambas variantes se basan en procesos con varios hilos, pero Event vincula Keep-Alive con menos frecuencia a un hilo. Worker se mantiene sólido para cargas moderadas, mientras que Event destaca cuando hay muchas conexiones paralelas. Esta clasificación ayuda a tomar decisiones coherentes para el entorno de cada uno. Ofrezco una comparación más detallada en Evento frente a trabajador.
| MPM | Gestión de Keep-Alive | Hilos/procesos | Requisitos de RAM | Adecuado para |
|---|---|---|---|---|
| Prefork | Proceso Se bloquea al ralentí | Solo procesos | Alta | PHP heredado sin seguridad de subprocesos |
| Trabajador | Hilo a menudo permanece atado | Procesos + subprocesos | Medio | Carga moderada, configuraciones sencillas |
| Evento | Bucle de eventos aparca los sockets inactivos | Procesos + subprocesos | Bajo a medio | Muchos clientes, fases de keep-alive prolongadas |
Escenarios típicos de aplicación
Utilizo Event MPM cuando hay muchos procesos paralelos Clientes Solicitar cargas útiles pequeñas y medianas. Los blogs con mucho tráfico, las tiendas online con almacenamiento en caché, los recursos estáticos y los puntos finales de API se benefician notablemente. Lo mismo ocurre con las configuraciones de alojamiento que albergan muchos sitios web por servidor, en las que predominan las conexiones «keep-alive». La cola de eventos mantiene bajo el número de subprocesos activos y distribuye el trabajo de manera uniforme. Quienes utilizan HTTP/2 se benefician aún más, ya que una conexión puede transportar varios flujos, mientras que la capa de eventos coordina los estados de forma ordenada.
Event también demuestra sus puntos fuertes en las topologías de proxy inverso. Dejo que Apache se encargue de la terminación SSL, del almacenamiento en caché y del reenvío de las solicitudes a una capa de aplicaciones. De este modo, la gestión de conexiones sigue siendo ligera, lo que mitiga los cuellos de botella. Incluso en picos de tráfico, los tiempos de respuesta se mantienen bajo control, siempre que los límites se establezcan de forma inteligente. Esto reduce el riesgo de Cola-Atascos y tiempos de espera.
Configuración: directivas clave
Para llegar a una conclusión sólida, lo primero que compruebo es ServerLimit, StartServers, ThreadsPerChild y MaxRequestWorkers. La regla general: ServerLimit × ThreadsPerChild debería estar cerca de MaxRequestWorkers, dejando un margen para el mantenimiento y el crecimiento. Un valor demasiado pequeño limita el paralelismo, mientras que uno demasiado grande aumenta excesivamente el consumo de RAM. Yo configuro KeepAlive en «On», pero establezco un valor moderado para KeepAliveTimeout, para que la inactividad no se prolongue en exceso. Los valores que oscilan entre unos pocos segundos y unos pocos segundos de dos dígitos suelen funcionar bien, dependiendo del perfil de tráfico.
Además, tengo en cuenta los tiempos de espera para la lectura, la escritura y los proxies. Los valores más cortos protegen contra los backends bloqueados, mientras que los más largos ayudan cuando los clientes tardan en responder, lo que Compromisos es necesario. En el caso de los archivos estáticos, conviene enviarlos en bloques más grandes y utilizar cadenas de filtros eficientes. Cuando utilizo PHP a través de FPM o equilibradores de carga, adapto el número de trabajadores de backend al paralelismo del frontend. Documento cada cambio y mido su efecto antes de seguir adelante.
Optimización de la cola de eventos: paso a paso
Empiezo con una clara perfil de carga: conexiones simultáneas, solicitudes por segundo, tamaño de las respuestas, porcentaje de Keep-Alive. A continuación, configuro MaxRequestWorkers de tal forma que la CPU no se quede inactiva, pero que la memoria RAM sea más que suficiente. Ajusto «ThreadsPerChild» hasta que los picos de carga se procesen sin tiempos de espera. Calibro «KeepAliveTimeout» para lograr un buen equilibrio entre la experiencia de usuario y el ahorro de recursos. Quien quiera comprender más a fondo el comportamiento de las colas, encontrará conceptos básicos en Cola de servidores web.
Realizo pruebas iterativas con herramientas como ab, wrk o k6 y analizo las latencias en los percentiles P50, P95 y P99. Al hacerlo, observo cuándo las conexiones permanecen en Keep-Alive y cuándo se cierran. Un ligero exceso de provisión de subprocesos ayuda a absorber picos breves sin sobrecargar la máquina. Al mismo tiempo, reviso los registros de errores en busca de mensajes como „server reached MaxRequestWorkers“. De este modo obtengo un armonioso Interacción entre la cola de eventos y el grupo de trabajadores.
Seguimiento y métricas
Unas buenas métricas garantizan una Capacidad. Activo mod_status y realizo un seguimiento de los trabajadores activos, inactivos y en espera. El cuadro de mando muestra si hay solicitudes en espera o si hay recursos libres. Además, mido el número de procesos y subprocesos, la utilización de la RAM y las E/S de red. Un análisis visual ayuda a identificar tendencias y puntos de inflexión. Para más detalles, consulta el Apache Scoreboard.
Correlaciono estos valores con los registros de acceso y los códigos de error. Si las tasas de errores 5xx aumentan al mismo tiempo que la carga está al máximo, suele ser porque los límites son demasiado bajos. Si aumentan los tiempos de espera, compruebo los servicios de backend, la resolución de DNS y las rutas de red. También analizo los backlogs de TCP y las retransmisiones SYN en momentos de alta carga. Así puedo detectar si el Causa en el servidor web, en el backend o en la red.
HTTP/2, proxy inverso y módulos
HTTP/2 agrupa varios flujos en una sola conexión, lo que permite Evento-Se adapta perfectamente a la arquitectura. Me aseguro de mantener un equilibrio entre los límites de flujos y el grupo de subprocesos, para que los flujos pequeños no acaben en colas. Como proxy inverso, Apache se beneficia de tiempos de espera reducidos y de conexiones fiables con el backend. Sin embargo, los módulos que funcionan de forma muy bloqueante pueden ocupar hilos y mermar estas ventajas. Por ello, compruebo la compatibilidad y sustituyo los componentes obsoletos si generan picos de latencia.
Los módulos de caché y la compresión aumentan la eficiencia, siempre que los perfiles de CPU sean adecuados. La optimización de TLS con cifrados modernos y la priorización de HTTP/2 contribuyen a una entrega más rápida. Utilizo la reanudación de sesión y observo los costes del handshake bajo carga. Para los recursos estáticos, los enfoques «zero-copy» y «sendfile» funcionan bien. La Arte consiste en mantener ágil la cadena formada por TLS, la cola de eventos, el worker y el backend.
Flujo interno y estados en el evento MPM
Para comprender los procesos internos, pienso en condiciones: accept → readable → processing → writable → keep-alive → close. Los hilos de escucha supervisan los sockets mediante mecanismos eficientes del núcleo (epoll/kqueue) y solo activan a los hilos de trabajo cuando se produce un evento. Tras procesar una solicitud, la capa de eventos decide si la conexión se mantiene en modo „keep-alive“, se cierra directamente o se somete a un cierre similar al „lingering close“, para que los paquetes TCP tardíos se procesen correctamente. Este autómata de estados evita la «espera activa» y minimiza los cambios de contexto.
En este sentido, es importante distinguir entre Tiempo de espera de E/S y la carga de la CPU: el análisis de las solicitudes, las cadenas de filtros (por ejemplo, la compresión) y la generación de la respuesta se ejecutan en subprocesos de trabajo. La mera espera de que se pueda leer o escribir permanece en el bucle de eventos. De este modo, Apache aprovecha mejor los subprocesos disponibles y reduce la Densidad de hilos por cada conexión abierta, de forma drástica.
Además, tengo en cuenta el comportamiento del marcador: en mod_status se pueden consultar fases como „R“ (lectura), „W“ (envío de respuesta), „K“ (Keepalive) y „G“ (finalización correcta). Una alta proporción de „K“, junto con trabajadores libres, indica que la cola de eventos se gestiona correctamente y no desperdicia subprocesos. Si los tiempos de „R“ aumentan notablemente, esto apunta a que hay clientes lentos o tiempos de espera de lectura demasiado restrictivos, lo que indica que hay margen de optimización.
Planificación de recursos: ejemplo de cálculo y valores predeterminados recomendados
Calculo el Paralelismo compuesto por CPU, RAM y carga de trabajo. Un ejemplo: 8 vCPU, 16 GB de RAM, contenido almacenado principalmente en caché y PHP-FPM en el backend. Empiezo con MaxRequestWorkers entre 512 y 768, ThreadsPerChild entre 32 y 64, y ServerLimit entre 8 y 12, respectivamente. Preveo entre 1 y 3 MB de sobrecarga de Apache más los módulos por cada trabajador activo, a lo que hay que añadir los búferes de respuesta, la sobrecarga de TLS y los sockets del backend. De forma realista, reservo entre 4 y 8 GB para los procesos y subprocesos de Apache, entre 2 y 4 GB para la caché del sistema operativo y el resto para los backends. Me aseguro de que ServerLimit × ThreadsPerChild nunca sea menor que MaxRequestWorkers; conviene dejar un pequeño margen.
Resumen de las directrices útiles: – MinSpareThreads/MaxSpareThreads: Mantén la reserva de tal forma que se puedan absorber los picos de carga sin necesidad de un „arranque en frío“, pero sin que haya demasiados hilos inactivos que ocupen memoria. – MaxConnectionsPerChild (también conocido como MaxRequestsPerChild): Un ciclo de vida finito por proceso ayuda a evitar la fragmentación de la memoria y las fugas en el funcionamiento prolongado (por ejemplo, entre 5 000 y 20 000). – MaxKeepAliveRequests: Limita el número de solicitudes por conexión; unos valores moderados protegen contra las sesiones „infinitas“ sin mermar las ventajas de Keep-Alive (por ejemplo, entre 100 y 1000). – Tiempo de espera, Tiempos de espera de lectura/escritura y ProxyTimeout: Evitar los bloqueos; establezco valores diferenciados según el contexto, en lugar de ser demasiado conservador a nivel global.
Para los archivos estáticos utilizo EnableSendfile y Habilitar MMAP A propósito: en los discos locales, ambas opciones pueden aportar ventajas; en volúmenes NFS o en la nube, suelo desactivar «sendfile» para evitar casos extremos. En las rutas TLS, «sendfile» tiene menos efecto por su propia naturaleza, ya que los datos pasan por canales de cifrado; en este caso, lo que más cuenta es una eficiente Cadena de filtros.
Límites del sistema operativo y de la red
Ni siquiera la mejor arquitectura para eventos sirve de mucho si las limitaciones del sistema operativo la frenan. Compruebo: – Descriptores de archivos (ulimit -n): El valor debería ser bastante superior al número máximo de conexiones simultáneas más los sockets del backend; es habitual que haya varias decenas de miles en los servidores con mucho tráfico. – EscucharBacklog: Un backlog de aceptación suficientemente grande evita que se rechacen los SYN en momentos de pico. – Pendientes del núcleo (p. ej., somaxconn) y colas SYN: deben ajustarse a la tasa de „ráfagas“ prevista. – Búfer de red (rmem/wmem): No lo sobrecarifiques, pero dimensiona la memoria de tal forma que las rutas con un RTT elevado o un gran ancho de banda no se colapsen.
Distribuyo la carga de «Accept» entre varios subprocesos de escucha y, por regla general, dejo que la plataforma elija el mecanismo de «Accept» (AcceptMutex auto). En los sistemas que lo admiten, se puede SO_REUSEPORT (dependiendo de la plataforma, mediante la opción de lista) suavizar las rutas de aceptación. Es importante evitar situaciones de «thundering herd», en las que muchos hilos compiten por la misma aceptación.
También Puertos efímeros de TCP (ip_local_port_range) y el comportamiento TIME-WAIT deben ajustarse al número de conexiones proxy paralelas. Evito los ajustes agresivos; en su lugar, realizo pruebas realistas y me aseguro de que los backends utilicen Keep-Alive, para que las conexiones se puedan reutilizar y se produzcan menos cambios de puerto.
Nociones avanzadas sobre proxies inversos: grupos de conexiones y backends
Como proxy inverso, el rendimiento general depende en gran medida de que las conexiones con el backend sean estables. Me encargo de que Conexiones proxy Mantén la persistencia (Keep-Alive con el backend) y dimensiona los grupos de servidores del backend de manera que se adapten al paralelismo del frontend. Los grupos demasiado pequeños provocan atascos en el frontend, mientras que los demasiado grandes generan una carga innecesaria en la aplicación.
Medidas prácticas: – ProxyTimeout: Más cortas para las rutas no críticas, más largas para los puntos finales „costosos“: hay que diferenciar, no generalizar de forma global. – Equilibrador-Configuración (en mod_proxy_balancer): ponderaciones, número máximo de conexiones por servidor backend, intervalos de reintento en función del estado. – mod_proxy_fcgi Para PHP-FPM: El FPM-pm.*Los valores (pm.max_children, pm.start_servers, etc.) deben ajustarse al paralelismo de Apache para evitar picos de errores 502/504.
Me aseguro de que los errores del backend se escalen de forma clara y rápida, en lugar de bloquear los hilos del frontend. Las comprobaciones de estado, una política de reintentos prudente y patrones similares a los de los «circuit breakers» mantienen estables las latencias. Siempre que es posible, me encargo de Almacenamiento en caché de respuestas en los lugares adecuados, para que el evento MPM pueda enviar, sobre todo, respuestas breves y sencillas.
Ajuste fino de HTTP/2 en Event
Para HTTP/2, además de TLS, optimizo sobre todo Límites de transmisión y la asignación de trabajadores. Un gran número de flujos pequeños por conexión puede reducir la latencia, pero aumentar la carga de los hilos. Establezco el número máximo de flujos por sesión de tal forma que se active la multiplexación, pero sin que se produzca un efecto de „head-of-line“. Además, aumento el número de trabajadores de forma conservadora para amortiguar los picos de actividad sin saturar la RAM.
He observado que, a menudo, los flujos quedan en espera aunque haya subprocesos libres. Cuando esto ocurre, lo habitual es que los límites de los flujos o el tamaño de los búferes limiten el rendimiento. Una Priorización Los recursos críticos (por ejemplo, CSS/JS con prioridades HTTP/2) influyen directamente en el rendimiento percibido. En lo que respecta a TLS, la reanudación de sesión, los mecanismos similares a 0-RTT (siempre que sean seguros y estén disponibles) y los cifrados modernos reducen los costes del protocolo de establecimiento de conexión.
Robustez: tiempos de espera, protección contra Slowloris y apagado progresivo
Activo mod_reqtimeout, para mitigar los patrones similares a los del «slowloris». Los tiempos de espera de lectura evitan que los clientes envíen bytes a paso de tortuga y, por lo tanto, ocupen recursos. Los tiempos de espera de escritura protegen contra conexiones lentas hacia el cliente. Estos valores deben seleccionarse en función del contexto: las API requieren perfiles diferentes a los de las descargas de archivos de gran tamaño.
Para las implementaciones y los reinicios, apuesto por Agraciado-Procesos. Con un tiempo de espera (graceful timeout) adecuado, los procesos antiguos se vacían de forma controlada mientras los nuevos toman el relevo. De este modo, las conexiones „keep-alive“ se mantienen estables y la cola de eventos gestiona la carga residual sin interrupciones bruscas. Registros rotativos, un nivel de detalle reducido en los registros durante los picos de actividad (por ejemplo, „info“ en lugar de «debug») y, opcionalmente, Registros en búfer reducen notablemente la carga de E/S.
Detección de fallos bajo carga: identificación de patrones
Síntomas típicos y enfoques: – Elevada P95/P99-Latencias con trabajadores libres: en la mayoría de los casos, se trata de tiempos de espera del backend o de la red; comprueba los tiempos de espera del proxy y de lectura, así como los pools del backend. – „server reached MaxRequestWorkers“: la capacidad de paralelismo es insuficiente; aumenta MaxRequestWorkers y/o ThreadsPerChild, y comprueba el consumo de RAM. – Muchos Keep-Alive- Conexiones, pocos subprocesos activos y, aun así, lento: a menudo, módulos o filtros que provocan bloqueos o cuellos de botella en el backend; realizar un análisis de rendimiento de la cadena de filtros y comprobar la saturación de la CPU y las E/S. – Picos de 5xx con carga TLS correlacionada: handshakes limitados por la CPU; optimizar los cifrados, la reanudación de sesiones y, si procede, la descarga de carga.
Elimino los cuellos de botella a lo largo de la cadena: aceptación de sockets (backlog), bucle de eventos (estados de espera), trabajadores (limitados por la CPU), filtros (limitados por E/S) y proxy (limitado por el backend). Este modelo conceptual evita que modifique el valor de MaxRequestWorkers cuando, en realidad, el problema está en el backend.
Lista de comprobación práctica y dificultades habituales
Trabajo con una breve Lista de control: versión actual de Apache, MPM Event activado, límites correctamente configurados, tiempos de espera adecuados. A continuación, compruebo las tasas de Keep-Alive y la relación entre conexiones y subprocesos activos. Verifico si los módulos son seguros para subprocesos y si los filtros no provocan bloqueos prolongados. En el caso de PHP a través de FPM, me aseguro de que los trabajadores de FPM se adapten al paralelismo del front-end. Asimismo, ajusto los límites del sistema operativo, como los descriptores de archivo, el backlog de TCP y los parámetros del kernel para los búferes de red, de modo que la Tuberías no se atasque.
Detecto rápidamente los obstáculos más comunes: tiempos de espera de KeepAlive demasiado largos, valores de MaxRequestWorkers demasiado bajos, un número reducido de ThreadsPerChild o un registro de eventos inadecuado. Un registro de eventos excesivamente detallado consume recursos de E/S y ralentiza las respuestas. Un tamaño demasiado pequeño del grupo de backends del proxy resta valor al ajuste del frontend. Las configuraciones erróneas de TLS alargan innecesariamente los handshakes. Quien resuelva estos puntos adecuadamente, conseguirá una fiable La base para unas latencias constantes.
Resumen para los responsables técnicos
Event MPM separa claramente la gestión de conexiones de la ejecución y apuesta por una Cola de eventos, que gestiona de forma óptima las conexiones inactivas. De este modo, Apache se adapta a un gran número de clientes simultáneos sin dejar hilos colgados. La combinación adecuada de MaxRequestWorkers, ThreadsPerChild y tiempos de espera bien definidos mantiene a raya la latencia y el consumo de RAM. Con una supervisión continua, pruebas de rendimiento y unos pocos ajustes específicos, se consigue un sistema que absorbe los picos de tráfico y responde de forma constante. Quien siga estos principios sacará el máximo partido a su Apache-La instalación ofrece muchas más posibilidades y, al mismo tiempo, sigue siendo compatible con las aplicaciones y los protocolos más habituales.


