Ir al contenido

Servidores de bases de datos: La base de las infraestructuras informáticas modernas
Un servidor de bases de datos es un componente esencial de la infraestructura informática moderna. Almacena, gestiona y proporciona Datos de forma eficiente, lo que constituye la base de muchas aplicaciones y servicios que dependen de información estructurada.
Tareas de un servidor de bases de datos
El objetivo de un servidor de bases de datos es almacenar grandes cantidades de datos y proporcionar información de forma estructurada y rápida. Sirve de "eje" central en la red y garantiza la coherencia y fiabilidad de los datos, algo esencial para las aplicaciones y los procesos de toma de decisiones en las empresas.
Funcionalidad y eficacia
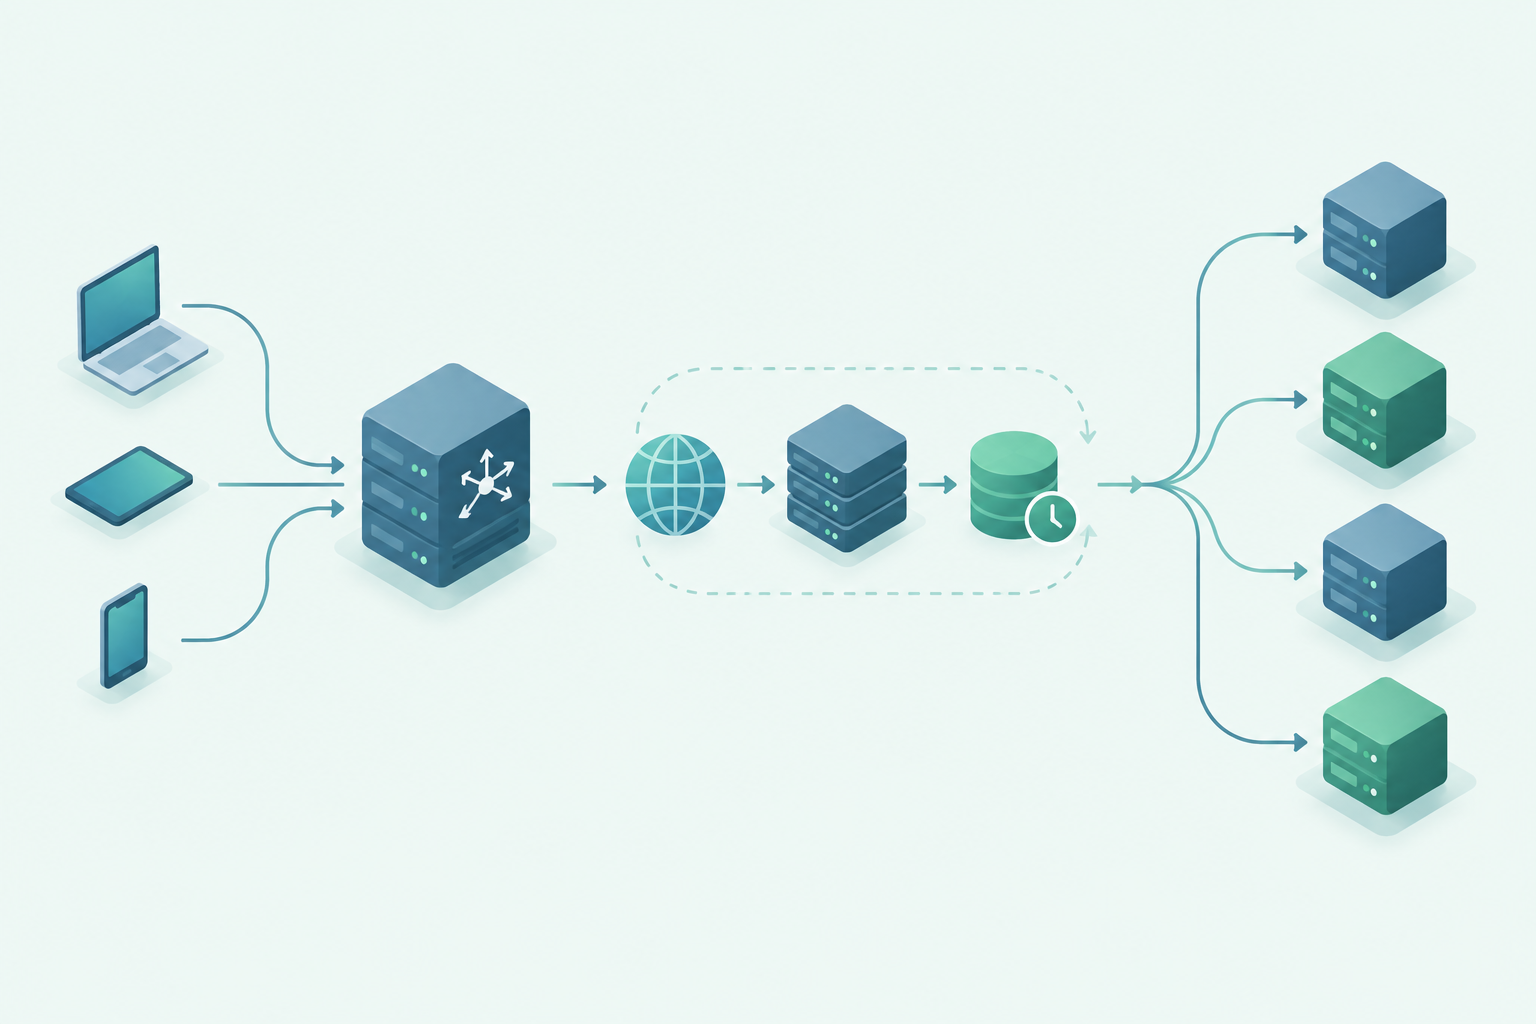
El funcionamiento de un servidor de bases de datos se basa en el modelo cliente/servidor. El servidor actúa como una interfaz central que recibe y procesa las peticiones de varios clientes. Se utilizan varios métodos: la "indexación" acelera las consultas de búsqueda, y la **gestión de transacciones** garantiza la integridad de los datos cuando varios usuarios acceden a ellos al mismo tiempo.
Tipos de sistemas de bases de datos
Existen varios tipos de bases de datos que difieren en función de su estructura y uso previsto:
- Bases de datos relacionales (SQL)**: Trabajo con datos en forma tabular. Los sistemas conocidos son MySQL y Microsoft SQL Server.
- Bases de datos NoSQL**: Especializadas para datos no estructurados o semiestructurados, como MongoDB o Redis.
- Bases de datos en memoria**: Almacenan datos en la memoria principal para tiempos de acceso rápidos, SAP HANA es un ejemplo.
- Bases de datos en la nube**: Proporcionan servicios de bases de datos a través de Internet; Amazon RDS y Google Cloud SQL son opciones muy conocidas.
Importancia de la informática empresarial
Los servidores de bases de datos son indispensables en el campo de la informática empresarial moderna. Apoyan el almacenamiento central de los datos de la empresa, promueven una organización eficiente de los datos y facilitan el acceso a la información. La escalabilidad de los servidores de bases de datos también debe poder seguir el ritmo del crecimiento de los volúmenes de datos y del tamaño de la empresa.
Retos y oportunidades
Con el aumento del procesamiento de datos en tiempo real y de las ciberamenazas, crece la demanda de precauciones de seguridad. Las herramientas de automatización pueden ayudar a gestionar la complejidad de los sistemas de datos.
Servidor de base de datos y éxito
Un servidor de bases de datos bien elegido y bien gestionado constituye la base para la utilización eficaz de los datos en una empresa. Las empresas que son conscientes de la importancia y la función de estos sistemas pueden beneficiarse de ellos a largo plazo y asegurarse ventajas competitivas.
A la hora de seleccionar un servidor de bases de datos, tenga en cuenta los requisitos específicos de su empresa, incluida la escalabilidad necesaria y las aplicaciones previstas.