 Ir al contenido

Informes de CloudLinux Me muestran claramente qué límites de LVE afectan a cada cuenta y dónde se producen realmente los cuellos de botella en la CPU, la memoria, las E/S o los procesos de entrada. Analizo estos datos de forma específica para detectar fallos recurrentes, patrones diarios y cuellos de botella agudos, y deducir a partir de ellos optimizaciones concretas.
Puntos centrales
A continuación resumo los puntos clave para que puedas empezar el análisis con claridad.
- Cifras clave de LVE Lee bien: SPEED, MEM, IO, IOPS, PNO, EP
- Datos en tiempo real Comprobar con LVE Manager y lvetop
- Historial a través de lveinfo, lvechart, cloudlinux-statistics
- Fallos Priorizar: frecuencia, momento, causa
- Medidas Calcular para CPU, RAM, E/S y EP
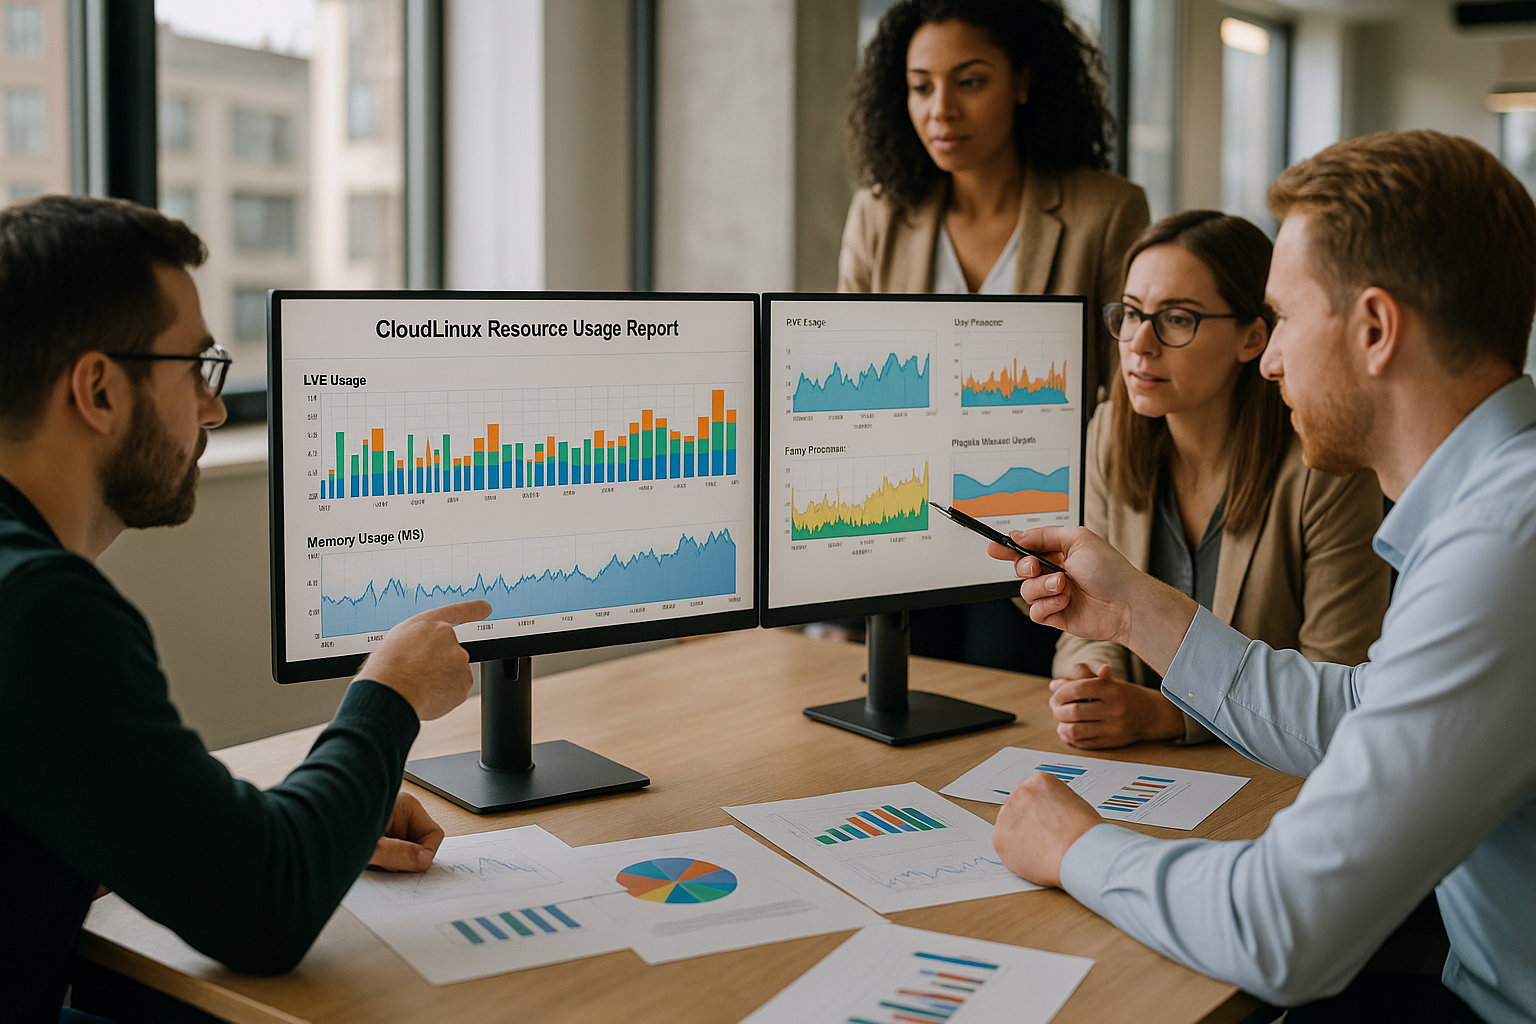
Cómo interpretar correctamente los indicadores clave: SPEED, MEM, IO, IOPS, PNO, EP
Empiezo cada análisis con los Cifras clave, que CloudLinux muestra en el contexto de LVE. SPEED describe la potencia de cálculo de la CPU asignada, MEM representa el consumo de RAM, IO el rendimiento de datos e IOPS el número de operaciones de E/S. PNO muestra el número total de procesos en ejecución, y EP los procesos de entrada simultáneos que limitan los accesos web. Si se observan valores elevados de forma permanente, normalmente no se trata de un problema puntual de picos, sino de un perfil de carga estructural. En estos casos, siempre compruebo si los límites se alcanzan de forma continua o si solo se producen picos aislados que pueden explicarse sin necesidad de limitación.
| Cifra clave | Significado | Síntomas típicos | Primeras comprobaciones |
|---|---|---|---|
| VELOCIDAD | Rendimiento de la CPU (porcentaje/límite) | Tiempos de ejecución prolongados en PHP, tiempos de espera | Comprobar los perfiles de PHP, la caché de opcodes y el almacenamiento en caché |
| MEM | Memoria RAM por cuenta | OOM-Kills, 500 de error bajo carga | Revisar el límite de memoria de PHP, los complementos y las consultas |
| IO | Ancho de banda en MB/s | Descargas y subidas lentas | Caché estática, compresión de archivos multimedia, almacenamiento |
| IOPS | Número de operaciones de E/S | Accesos lentos a la base de datos y a los archivos | Índices, plan de consulta, caché de objetos |
| PNO | Procesos generales | Aumento de la carga del servidor | Excesos de daemons/cron, límites de trabajadores |
| EP | Conexiones simultáneas a la web | Error 503 en Peaks | Comprobar la caché HTTP, los límites de velocidad y los bots |
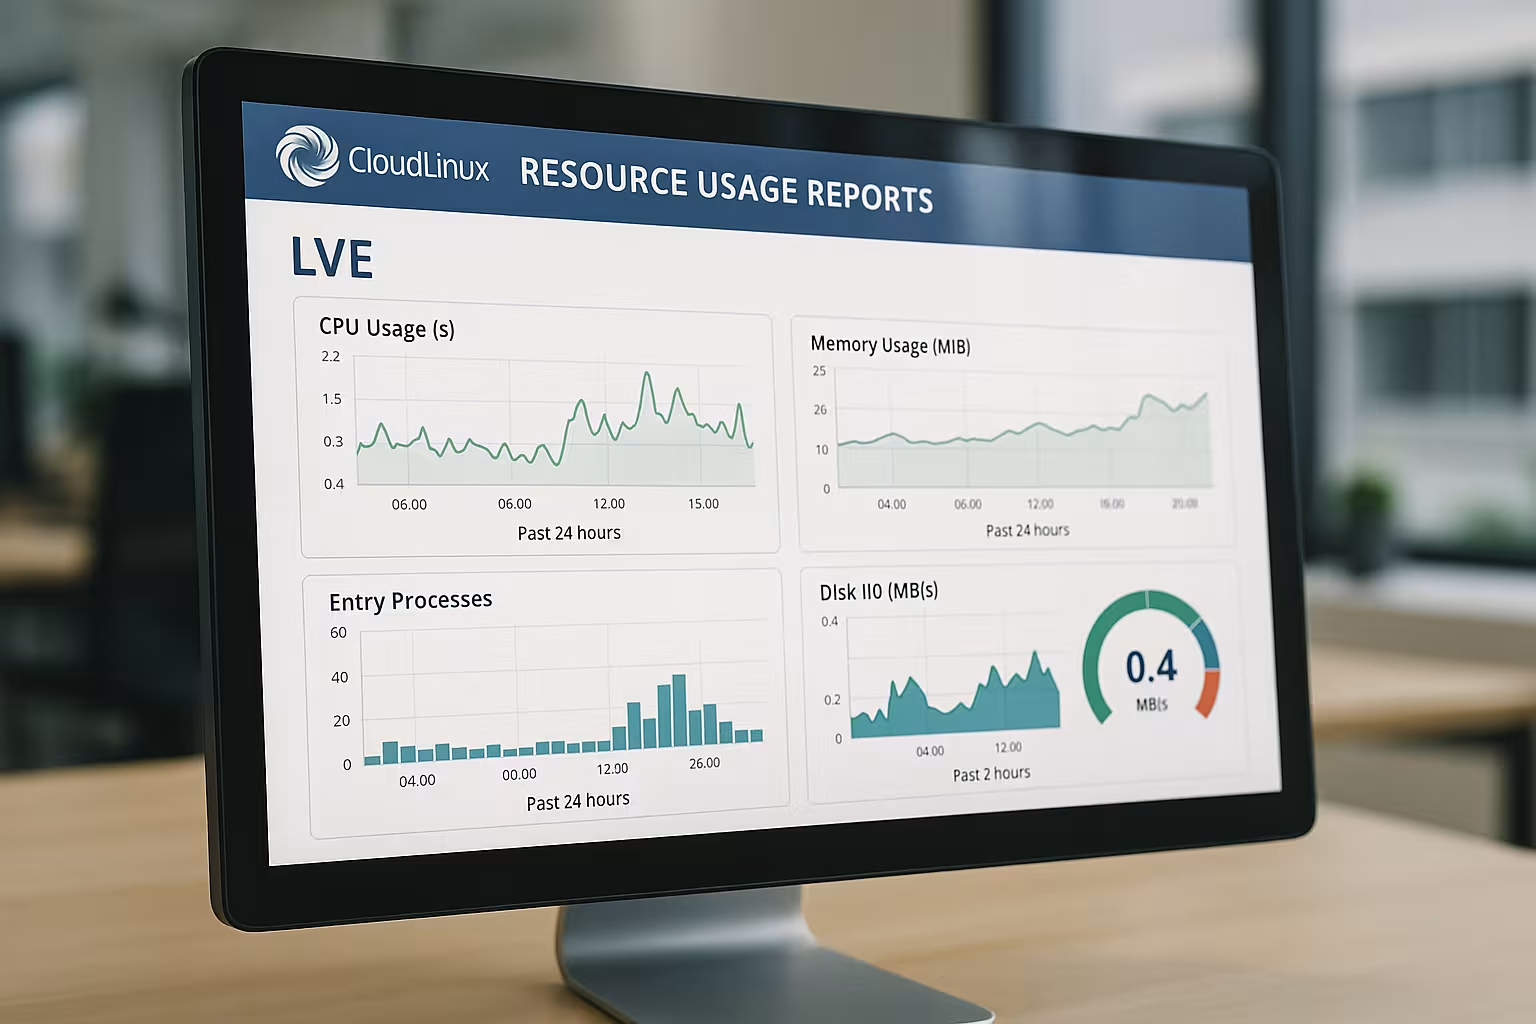
Supervisión en tiempo real con LVE Manager y lvetop
Para los análisis urgentes utilizo la Datos en tiempo real en el LVE Manager y en lvetop desde la línea de comandos. La vista «Current Usage» me muestra en tiempo real cómo funcionan la CPU, la RAM, la E/S, las IOPS, los procesos y los procesos de entrada. Ante picos de carga, observo si son los EP o los SPEED los que alcanzan primero el límite, ya que eso influye en los siguientes pasos. lvetop es ideal para filtrar inmediatamente las cuentas que más recursos consumen y, en caso necesario, limitarlas u optimizarlas. Quien quiera profundizar más en la interfaz puede ajustar los límites y las vistas de forma específica; para ello, me gusta utilizar esta guía: Configurar LVE Manager.
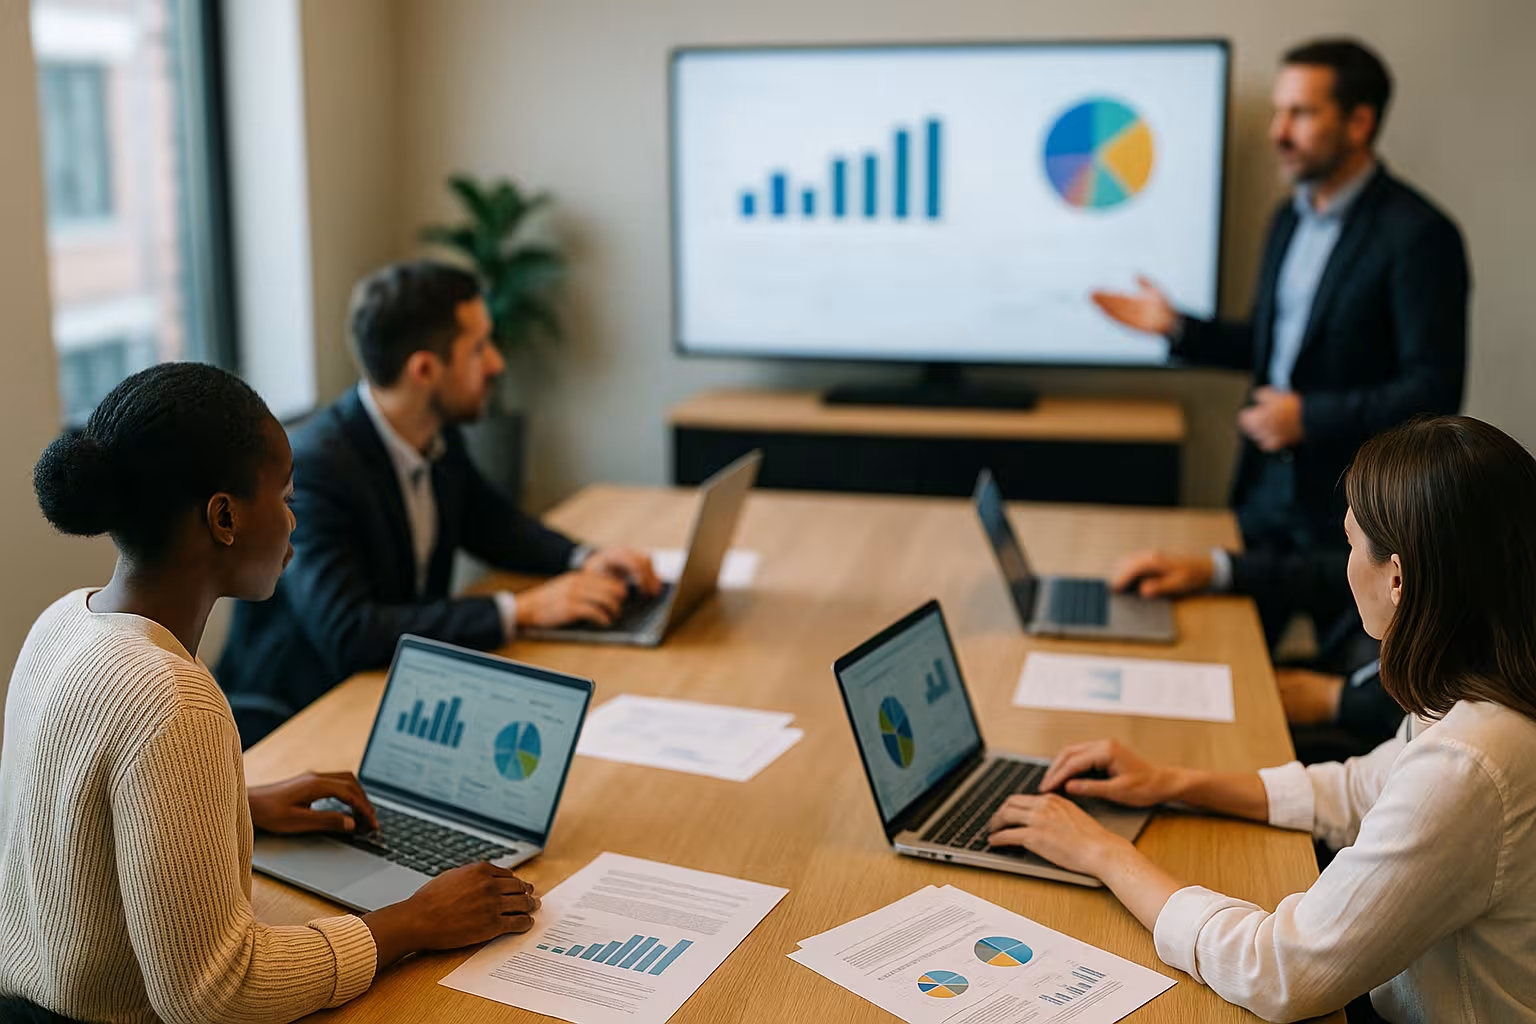
Análisis histórico: lveinfo, lvechart y cloudlinux-statistics
Detecto las tendencias a través de Historial y el historial de fallos, no solo a partir de instantáneas. Con lveinfo defino intervalos de tiempo y veo cuándo se han activado exactamente los límites y con qué frecuencia ha ocurrido. lvechart me ofrece picos visuales a lo largo de horas o días, lo que permite visualizar los patrones a lo largo del día. cloudlinux-statistics complementa el análisis cuando necesito series temporales más largas por cuenta. A partir de esta combinación, obtengo respuestas a las preguntas „cuándo“, „con qué frecuencia“ y „en qué condiciones“ se producen las cargas.
Comprender y priorizar los fallos
Un «Fault» significa: El Límite Se ha producido un error y CloudLinux ha limitado el ancho de banda. Por eso, ordeno los errores primero por frecuencia y, después, por tipo de recurso y hora del día. Los errores de EP diarios a la hora del almuerzo suelen indicar picos de tráfico o bots, mientras que los errores de RAM nocturnos suelen estar relacionados con las tareas cron y las copias de seguridad. Si se acumulan los fallos de CPU, busco rutinas PHP ineficientes, cachés defectuosas o tareas sin limitar. Esta clasificación me ahorra tiempo, ya que puedo aplicar las optimizaciones precisamente allí donde los usuarios notan una limitación perceptible.
Identificar las causas: patrones típicos y medidas correctoras
Basándome en mi experiencia, clasifico Muestra Identifica rápidamente las causas concretas. Unos valores de EP elevados de forma persistente indican un exceso de solicitudes simultáneas o la falta de almacenamiento en caché en el borde. Un consumo elevado y continuado de RAM suele deberse a plugins, temas o procesos con fugas de memoria. Los picos de E/S y IOPS indican tareas que consumen muchos datos, consultas sin indexar o numerosos accesos a archivos pequeños. Para evitar interpretaciones erróneas, compruebo al mismo tiempo los indicadores de estado del sistema; una forma rápida de empezar es con los Comprobaciones de estado de CloudLinux.
Detectar tareas programadas, copias de seguridad y bots
Para entender muchas de las series de «Fault», basta con echar un vistazo a Puntos en el tiempo y tareas. Si la limitación se produce siempre poco después de cada hora en punto, es frecuente que haya tareas programadas (cronjobs) ejecutándose en paralelo y compitiendo con los visitantes. Los picos recurrentes durante la noche suelen indicar que se están realizando copias de seguridad que agotan los recursos de E/S y las IOPS. Los EP-Faults llamativos sin tráfico correspondiente en Analytics suelen indicar la presencia de bots o scrapers que eluden el contenido estático. En tales casos, establezco límites de tasa, aplazo las tareas a franjas horarias más tranquilas y activo de forma sistemática las cachés de borde o de página.
Analizar los datos por distribuidor y cuenta
En configuraciones más grandes, separo el Niveles Claro: distribuidores, sus clientes y cuentas individuales. El LVE Manager me ofrece precisamente esta perspectiva y me muestra qué subárbol está superando los límites. Así puedo detectar si un cliente concreto llama la atención o si varios proyectos de una estructura de distribuidores están ejerciendo presión al mismo tiempo. Para los procesos de asistencia técnica, selecciono las cuentas afectadas y establezco medidas para que los tickets recurrentes se resuelvan más rápidamente. Esta transparencia ayuda a distribuir los recursos de forma equitativa y a mantener una trazabilidad de los costes por cliente.
Dimensionar correctamente los valores límite y ajustar las tarifas
Yo establezco los límites Realista, no al máximo. Unos límites de EP demasiado estrechos provocan errores 503, mientras que unos valores de SPEED demasiado bajos retrasan cada respuesta de PHP. Si se observan fallos con regularidad, lo primero es comprobar las optimizaciones y, después, las tarifas. Cuando los proyectos se vuelven críticos para el negocio, merece la pena optar por un perfil más alto, que absorba los picos y aporte estabilidad. Documento los efectos en los gráficos de evolución para que la decisión sea comprensible.
Proyectos con un uso intensivo de bases de datos: optimización de E/S e IOPS
En el caso de los sitios web basados en bases de datos, compruebo IOPS y las operaciones de E/S siempre van de la mano de la calidad de las consultas. Muchas consultas pequeñas sin índices generan un elevado número de IOPS y reducen el tiempo de respuesta. La experiencia demuestra que la caché de objetos, el almacenamiento en caché de consultas y los índices personalizados reducen considerablemente este aluvión. Para los análisis de tendencias, además, leo los informes de la base de datos y los comparo con las series temporales de LVE. Esta guía me ofrece una introducción bien fundamentada sobre Informes de MySQL Governor, para clasificar correctamente la carga de la base de datos.
Manual de monitorización: de la alarma a la acción
A partir de los valores medidos, elaboro un Manual de estrategias, que refleje claramente cada escalada. Paso 1: Comprobar en tiempo real si los límites están activos en ese momento y qué recurso falla primero. Paso 2: Abrir el historial, comparar los intervalos de tiempo y marcar las repeticiones. Paso 3: Localizar la causa —ruta de código, caché, base de datos, cron, bot— y definir una medida correctiva con criterios de prueba. Paso 4: Tras la intervención, comprobar de nuevo en producción y en el historial si se reducen los fallos y la latencia. Este orden fijo evita las medidas precipitadas y garantiza resultados reproducibles.
Interpretar correctamente las interdependencias de los límites
En la práctica, los límites rara vez se aplican de forma aislada. Por eso evalúo la Interacciones entre EP, SPEED, MEM e IO/IOPS: si EP y SPEED aumentan al mismo tiempo, suele ser la CPU la que limita el número de solicitudes; en ese caso, una caché de página o de borde puede ayudar, y ambos indicadores bajan al unísono. Si observo un aumento de EP con un SPEED constantemente bajo, las solicitudes se acumulan en el servidor web, a menudo debido a la escasez de trabajadores, a configuraciones de Keep-Alive o a llamadas externas que bloquean el sistema (por ejemplo, API, correo electrónico). Los errores de MEM con un SPEED moderado indican la presencia de pocos procesos, pero que consumen mucha memoria (como la conversión de imágenes o exportaciones de gran tamaño). Los picos de IO/IOPS sin una carga de CPU apreciable indican accesos a archivos o bases de datos con un uso intensivo de datos. Utilizo estas correlaciones para determinar la primera hipótesis antes de profundizar en los detalles del código o del servidor.
Práctica: cómo utilizar de forma eficiente lvetop, lveinfo y cloudlinux-statistics
Para obtener resultados rápidos, trabajo con imágenes nítidas Consultas y filtrar. lvetop me ayuda a ver cada segundo cuáles son los principales consumidores y a cambiar entre la ordenación por CPU, MEM o IO. Con lveinfo defino ventanas de 1 h, 24 h y 7 días para enumerar los momentos en que se produjeron fallos, los valores máximos y los recursos afectados por cada cuenta. cloudlinux-statistics me proporciona series temporales más largas y resulta útil para justificar las medidas tomadas (antes/después). Siempre documento por cada intervención: el periodo, las cuentas afectadas, los valores máximos por recurso, el número de fallos y los tiempos de respuesta del monitor de aplicaciones o del monitor web. De este modo, puedo justificar las optimizaciones y evitar que se relajen los límites „por intuición“.
Detalles del stack web: controladores PHP, workers y OPcache
Un factor clave es la Ejecución de PHP: Número de trabajadores PHP por cuenta, su presupuesto de RAM (memory_limit) y la OPcache. Un número excesivo de trabajadores sin caché aumenta los valores de EP/PNO y MEM, mientras que un número insuficiente de trabajadores provoca atascos en las solicitudes (el EP crece y el tiempo de respuesta aumenta). Por eso busco un punto óptimo: tantos trabajadores como sean necesarios, pero los menos posibles. La OPcache debe tener el tamaño adecuado (memoria y cadenas almacenadas), de lo contrario, PHP se compila constantemente y aumenta el SPEED. Además, compruebo si los recursos estáticos realmente son servidos por el servidor web (y no por PHP) y si el Keep-Alive y el multiplexado HTTP/2 funcionan correctamente. El objetivo es que las solicitudes dinámicas reducir y tramitar rápidamente los restantes.
Aplicar de forma sistemática las estrategias de almacenamiento en caché
Distingo tres niveles: Caché Edge/CDN para aliviar la presión a nivel mundial, Caché HTTP/de páginas justo antes de PHP y Caché de objetos dentro de la aplicación. La caché de borde reduce drásticamente el EP y las operaciones de E/S para los recursos estáticos. La caché de página reduce las visitas dinámicas y afecta directamente al EP y a la VELOCIDAD. La caché de objetos (por ejemplo, para consultas frecuentes a la base de datos) reduce las IOPS y la carga de la CPU. Es importante contar con una Clave de caché (por ejemplo, sin cookies innecesarias) y con tiempos de vida (TTL) adecuados para cada tipo de página. Para las secciones de administración o del carrito de la compra, preveo excepciones; en el resto de casos, mi objetivo es alcanzar la mayor tasa de caché posible. Tras la activación, compruebo: ¿se producen errores de EP? ¿Se reducen los tiempos de respuesta medianos?
Gestión de la RAM: memory_limit, procesos y fugas
Los errores MEM suelen producirse porque límite_de_memoria se ha fijado de forma generosa y los procesos paralelos superan el límite. Por eso realizo un ajuste: ¿cuánta RAM necesita una solicitud típica? A partir de ahí deduzco el número máximo razonable de trabajadores. Además, mantengo las bibliotecas y los plugins de PHP lo más ligeros posible, elimino las extensiones que no se utilizan y compruebo si hay fugas en los scripts de larga duración (exportaciones, importaciones, procesamiento de imágenes). El OPcache reduce la carga sobre la RAM al almacenar compilaciones en caché, pero su tamaño no debe ser demasiado reducido. En caso de picos recurrentes, utilizo el perfilado para aislar las rutas „costosas“ y actúo de forma específica; esto suele ahorrar más RAM que los aumentos generales de los límites.
Reducir de forma selectiva las operaciones de E/S y las IOPS
Los picos de IO/IOPS se deben a numerosos accesos pequeños a archivos o bases de datos. Agrupo las cargas de trabajo siempre que es posible: la generación de miniaturas por lotes en lugar de bajo demanda, la minificación de recursos durante la compilación en lugar de en cada solicitud, y el almacenamiento de sesiones y datos transitorios en un Caché de objetos Externalizarlo para reducir el número de accesos a los archivos. En la base de datos, doy prioridad a los índices para las cláusulas WHERE y JOIN más frecuentes y elimino las consultas N+1. Paralelamente, comparo las series temporales de LVE con los informes de la base de datos del MySQL Governor para identificar los puntos críticos. El objetivo es convertir muchas IOPS pequeñas en unos pocos accesos eficientes, lo que suaviza los picos y reduce la probabilidad de fallos.
Cómo mitigar los errores de la EP: colas y flujos de visitantes
EP limita las entradas simultáneas. Si hay muchas solicitudes y las cachés están vacías, los errores de EP se acumulan rápidamente. Lo evito haciendo lo siguiente: Colas antes de introducir PHP (colas de peticiones cortas en el servidor web), configuro «Keep-Alive» de forma adecuada y hago que se almacenen en caché de forma sistemática las rutas dinámicas que no estén personalizadas. Para los bots, defino límites de frecuencia y bloqueo desde el principio a los «bad actors» evidentes. Además, compruebo las llamadas a terceros en la ruta de la solicitud: los servicios externos que bloquean aumentan el tiempo de permanencia por solicitud y, por lo tanto, consumen EP. Siempre que sea posible, traslado las integraciones externas a tareas o colas.
Planificar las tareas programadas y las copias de seguridad de forma que se ahorren recursos
Desvinculo las tareas recurrentes de las horas punta y las regulo: desfaso las tablas Cron (desplazándolas unos minutos), evito que se ejecuten en paralelo mediante archivos de bloqueo y regulo la carga mediante Nicing y los tamaños de los lotes. Programo las copias de seguridad en franjas horarias con poco tráfico y me aseguro de utilizar métodos incrementales para que las E/S y las IOPS se mantengan dentro de unos límites razonables. Para las tareas complejas dentro de la aplicación, establezco límites para el número de trabajadores simultáneos, de modo que la memoria y la velocidad no aumenten de forma brusca. Compruebo el impacto a lo largo del proceso: ¿disminuyen los fallos nocturnos? ¿Se reducen los picos de carga al final de cada hora?
CageFS: una visión general del sistema de archivos y los inodos
Además de los límites de LVE, influyen Factores relacionados con el sistema de archivos El rendimiento: millones de archivos pequeños (como fragmentos de caché) aumentan los accesos a los metadatos y elevan las IOPS. Mantengo ordenados los directorios de caché, limito la avalancha de archivos mediante cachés agregadas de forma adecuada y compruebo la utilización de los inodos. CageFS garantiza el aislamiento, pero los archivos temporales colocados en lugares incorrectos (por ejemplo, en el directorio raíz web en lugar de en el directorio «tmp») aumentan innecesariamente las operaciones de E/S. Una comprobación periódica del estado de estas áreas evita que los cuellos de botella de E/S se interpreten erróneamente como problemas puros de CPU o RAM.
Transparencia y comunicación en el ámbito de la distribución
En entornos de revendedores, documento Conductor de carga por cada subsistema y registro las medidas: ¿Qué límites se han establecido? ¿Qué optimizaciones están previstas? ¿Cómo son los gráficos de «antes» y «después»? Esta transparencia agiliza las respuestas del servicio de asistencia y fomenta la aceptación de los cambios de tarifa cuando se ha agotado el potencial de optimización. Establezco umbrales a partir de los cuales actuamos (por ejemplo, fallos recurrentes > N al día o tiempo de respuesta mediano > X ms) y los vinculo a procedimientos de actuación claros, para evitar que se produzcan bucles interminables en el sistema de tickets.
Evitar las interpretaciones erróneas más comunes
Hay algunos patrones que observo con frecuencia: el aumento del uso de la CPU es no Esto suele indicar automáticamente que „falta CPU“; a menudo, las cachés no funcionan o las consultas son ineficientes. Un gran número de errores EP no significa necesariamente „más tráfico“: los bots, las herramientas de monitorización mal configuradas o los heartbeats pueden ser la causa. Los errores MEM no siempre se resuelven aumentando el valor de memory_limit; a menudo se deben a un exceso de procesos simultáneos. Los picos de E/S o IOPS no dependen exclusivamente del almacenamiento: son los patrones de las aplicaciones los que los provocan. Por eso, siempre verifico las hipótesis con gráficos correlacionados y, si es posible, con pequeñas pruebas de contraste (por ejemplo, activando la caché para un subconjunto y comprobando de nuevo la evolución).
Probar, medir, afilar
Evalúo cada cambio con puntos de medición claros: antes/después de la activación de la caché de páginas, antes/después de la actualización del índice, antes/después del ajuste de los trabajadores. Para ello, utilizo el historial de LVE, las métricas de tiempo de respuesta y las tasas de error (5xx/4xx). Siempre que es posible, realizo comparaciones A/B en horas de menor tráfico para aislar los efectos secundarios. Si persisten los fallos, repito el proceso: ajusto con precisión la combinación de límites, analizo otras rutas críticas y adapto los tamaños de los lotes de los trabajos. La experiencia demuestra que dos o tres iteraciones específicas ofrecen resultados claramente mejores que una única medida generalizada.
Resumen: Cómo leer de forma eficaz los informes de uso de recursos de CloudLinux
Tasa I CloudLinux- Los datos siempre se presentan en tres niveles: en tiempo real, histórico y de fallos. Los indicadores SPEED, MEM, IO, IOPS, PNO y EP me proporcionan una visión general de las causas y los efectos. Con lvetop veo al instante quién está generando la carga; con lveinfo y lvechart identifico patrones a lo largo de varios días. A partir de los Fallos recurrentes, deduzco medidas de almacenamiento en caché, optimización de consultas, ajustes de límites o cambios de tarifa. Este método reduce el esfuerzo de asistencia técnica, aumenta la capacidad de respuesta y aporta transparencia al rendimiento del alojamiento.


