 Vai al contenuto

Vi mostro come faccio a Offset Redis leggo e analizzo in modo mirato e per dati di alto livelloCoerenza . In questo modo riesco a individuare tempestivamente eventuali lacune nella replica, a valutare i rischi di failover e a mantenere i cluster produttivi sincronizzati in modo affidabile.
Punti centrali
I seguenti punti chiave forniscono un'introduzione mirata all'argomento, alla terminologia e all'applicazione pratica.
- Offset misura l'avanzamento del flusso di replica byte per byte.
- Lag è la differenza tra master_repl_offset e slave_repl_offset.
- ID+Offset Indica una versione precisa dei dati per gli allineamenti parziali.
- arretrato protegge dalle sincronizzazioni complete in caso di brevi interruzioni della connessione.
- Monitoraggio Con le metriche INFO/Cluster gestisce gli allarmi e il failover.
Che cosa significa "offset di replica" in Redis?
L'offset di replica è un contatore progressivo a 64 bit che, per ogni dato trasmesso, Flusso di byte tra il Primary e la Replica. Da questo dato deduco a che punto sia la replica e se una Replica abbia ancora del lavoro da svolgere. Il master_repl_offset sul primario aumenta con ogni byte appena generato, mentre la replica incrementa il proprio contatore non appena ha applicato i comandi. Le differenze determinano un ritardo in byte e indicano se la replica è in ritardo. Questa semantica semplice ma efficace rende l’offset il valore centrale per la sincronizzazione, l’analisi dei guasti e decisioni di failover accurate.
Lettura degli offset: come utilizzare correttamente INFO replication
Quasi sempre inizio la diagnosi con INFO replica, poiché il comando fornisce i campi rilevanti in forma sintetica. Sul server primario controllo master_repl_offset e lo stato delle repliche collegate, compresi i relativi offset. Su una replica controllo inoltre master_link_status e gli stati di sincronizzazione, per individuare eventuali sincronizzazioni complete o parziali in corso. Per un'analisi più approfondita, ricorro a output strutturati e metto in correlazione gli offset con i valori relativi a CPU, I/O e rete. Questa guida mi fornisce un'introduzione approfondita al comando: Redis INFO per il monitoraggio.
ID replica + offset: versione univoca dei dati
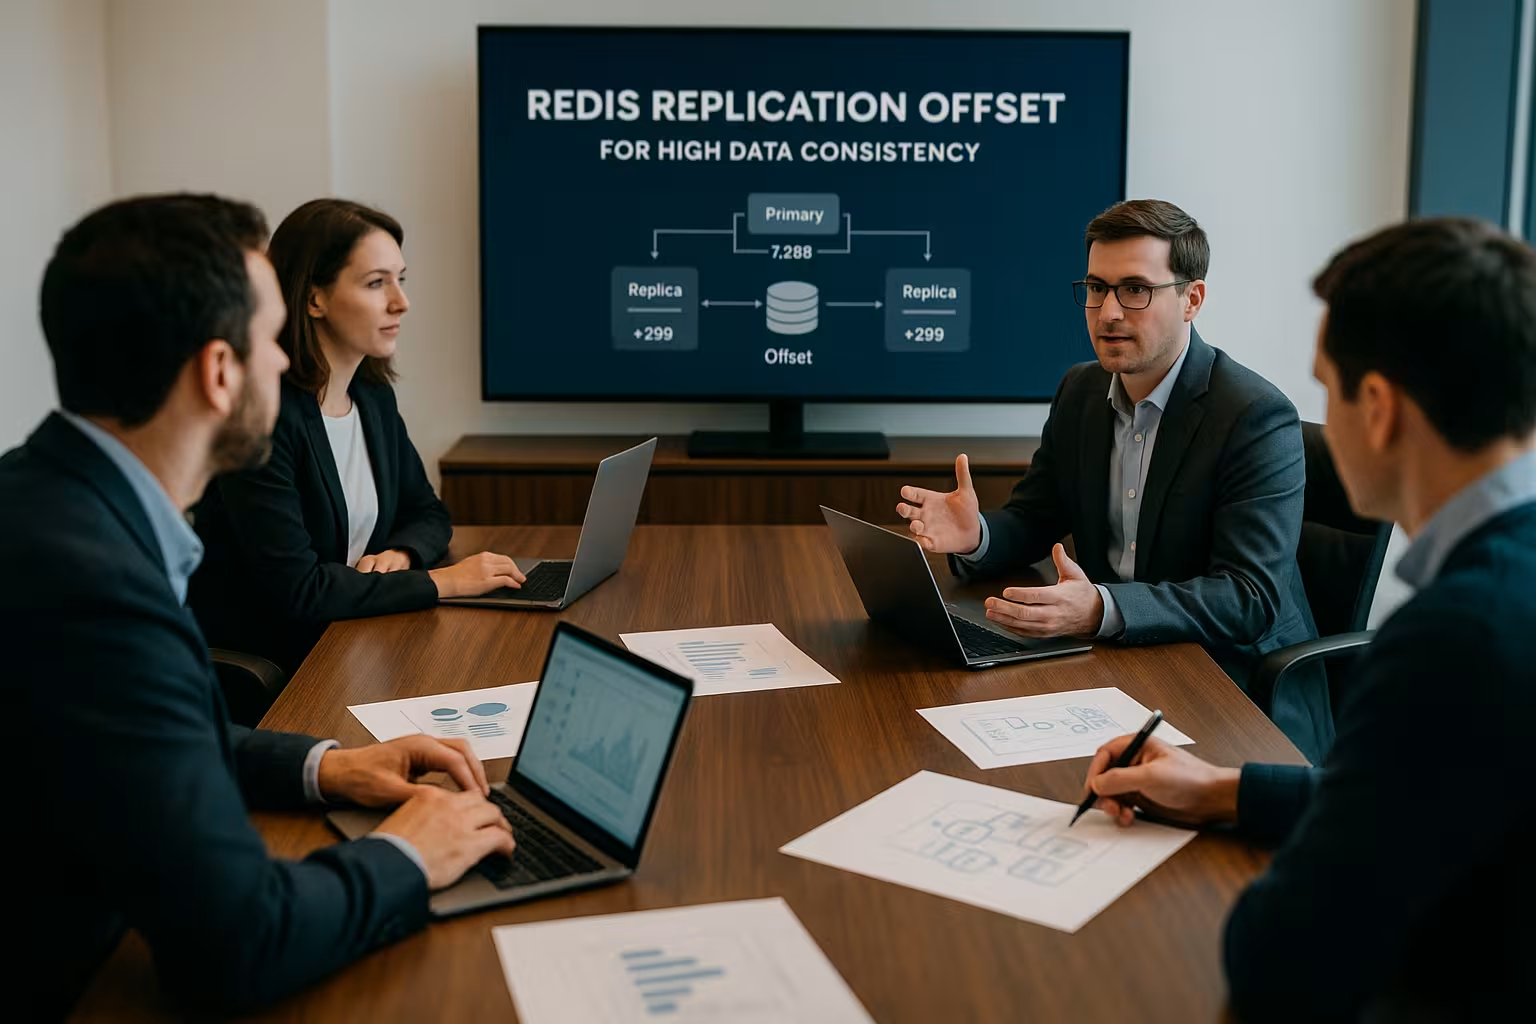
Per ottenere una versione univoca, utilizzo la combinazione di Replica ID e offset. L’ID identifica una cronologia, mentre l’offset indica una posizione all’interno di tale cronologia. Se l’ID e l’offset coincidono su due istanze, presumo che entrambe abbiano lo stesso stato dei dati. Questa combinazione rende possibile la risincronizzazione parziale, poiché una replica può comunicare con precisione al primario a che punto si trovava l’ultima volta. In questo modo riesco anche a capire se un failover può avvenire senza discrepanze nei dati o se è necessario un allineamento completo.
Determinazione delle dimensioni del backlog e del divario di replica
Il Primary ne tiene uno arretrato come buffer circolare, che memorizza le operazioni di scrittura più recenti e consente sincronizzazioni parziali. Se il buffer è troppo piccolo, durante i picchi di carico gli byte escono più rapidamente e una replica temporaneamente disconnessa non riesce a effettuare la risincronizzazione parziale. Dimensiono la dimensione in base al profilo di scrittura e agli obiettivi RPO, in modo che brevi interruzioni non inneschino costose sincronizzazioni complete. Come linea guida approssimativa, scelgo una dimensione che sia in grado di memorizzare almeno il volume di dati previsto per un periodo di registrazione compreso tra alcuni secondi e alcuni minuti. In questo modo riduco il divario tra primario e replica e mantengo snella la riconnessione.
Determinare con precisione l'entità del backlog
Nella pratica, non calcolo la dimensione del backlog solo in base a una stima approssimativa, ma sulla base del flusso di byte effettivamente osservato:
- Determino il Velocità di trasmissione in byte/s, misurando l'aumento di master_repl_offset a intervalli prestabiliti (ad es. 10–60 s) e annotando i valori di picco.
- Definisco un durata dell'interruzione tollerata (ad es. finestre di manutenzione, flussi di traffico di rete) in secondi.
- Moltiplico i byte/s di picco per la durata dell'interruzione e aggiungo un Fattore di sicurezza (1,5–3×).
Esempio: 80 MB/s di picco, 20 s di interruzione prevista, fattore 2 → 80×20×2 = 3.200 MB di backlog. In questo modo mi assicuro che, anche in caso di tempistiche sfavorevoli, si riesca a effettuare una sincronizzazione parziale. Successivamente, verifico nel sistema di monitoraggio se il backlog raggiunge raramente il limite della sua capacità; in tal caso, lo aumento gradualmente.
Ottimizzazione di hz, dimensioni dei batch e rete
Oltre al backlog, prendo in considerazione anche il hz-Configurazione, poiché influisce sui cicli di manutenzione interni e quindi sul lag medio. Inoltre, controllo le dimensioni dei batch di scrittura, l’utilizzo della pipeline e i parametri TCP per rendere più fluido il flusso di replica. Una bassa latenza tra il primario e la replica contribuisce direttamente a ridurre le differenze di offset. Anche i colli di bottiglia sul lato della replica, come supporti di dati lenti o scarsa disponibilità di CPU, aumentano il ritardo. Per questo motivo modifico sempre un solo fattore alla volta, misuro l’effetto sul divario di offset e ne documento chiaramente l’impatto.
Sincronizzazione senza disco ed effetti snapshot sull'offset
Per le sincronizzazioni complete preferisco utilizzare sincronizzazione senza disco, poiché il Primary fornisce quindi lo stream RDB direttamente attraverso la rete senza generare alcun carico di scrittura aggiuntivo sui supporti di dati locali. Ciò riduce i picchi di I/O e stabilizza gli offset durante le fasi di connessione e disconnessione. Un ritardo moderato (repl-diskless-sync-delay) concede alle altre repliche il tempo necessario per collegarsi, in modo che uno stream RDB venga utilizzato più volte. A tal proposito, monitoro il carico della CPU e della rete, poiché anche un trasferimento senza disco può causare brevi ritardi in presenza di grandi quantità di dati.
Gli snapshot (RDB) generano un’operazione di copia su scrittura (Copy-on-Write) al momento del fork. Nei sistemi con un’elevata attività di scrittura, ciò aumenta temporaneamente il fabbisogno di memoria e può Tasso di applicazione rallentare la replica. Per questo motivo programmo gli snapshot nelle ore più tranquille della giornata, verifico le riserve di memoria e mi assicuro che i percorsi di replica e AOF non entrino in conflitto tra loro.
La risincronizzazione parziale nella pratica
Se una replica smette di funzionare per un breve periodo, cerco sempre prima di tutto di Allineamento parziale da raggiungere. Al momento della riconnessione, la replica si identifica con l’ID di replica e l’ultimo offset, dopodiché il primario invia i byte mancanti dal backlog. Se il backlog non è sufficiente o se l’ID è cambiato, viene avviata una sincronizzazione completa con trasferimento RDB e fase di recupero. In questo momento osservo gli offset per verificare la velocità con cui la replica si allinea e da quando i due contatori tornano ad essere vicini tra loro. Se la sincronizzazione parziale ha esito positivo, le latenze e i picchi di I/O rimangono notevolmente inferiori.
ID di replica, PSYNC2 e comportamento di reset
Per ottenere interpretazioni accurate, mi affido alla semantica PSYNC2. Il Primary mantiene un ID replica e, inoltre, un ID cronologico con il relativo offset. In caso di Nuovi inizi o cambiamenti al vertice l'ID primario cambia; il vecchio ID viene conservato come cronologia con un offset finale. Una replica può quindi continuare a recuperare il ritardo tramite sincronizzazione parziale nonostante il cambio di ID, purché l'intervallo richiesto si trovi nel backlog. Valuto in INFO replica Pertanto, analizzo entrambi gli ID insieme agli offset e in questo modo rilevo se è appena avvenuto o sta per avvenire un cambio di ID.
È importante: l'offset è monotono per cronologia, ma un cambio di ID definisce una nuova linea temporale. Documento questo cambiamento durante il funzionamento, affinché le analisi di tendenza possano classificare correttamente tale salto. Un offset a 64 bit non va praticamente mai oltre il limite; molto più rilevanti sono i riavvii, i failover o i collegamenti del backlog, che influenzano la cronologia.
Ricevute del cliente e durata nel contesto Offset
Mostra gli offset Progresso, ma nessuna garanzia sulla durata. Quando ho bisogno di conferme sulle repliche, ricorro anche a:
- ATTENDI: Il Primary conferma dopo che N Replica hanno ricevuto un comando di scrittura e lo hanno memorizzato nel proprio buffer di input. Questo metodo è più veloce rispetto alla sicurezza Full Sync, ma non garantisce la persistenza sui supporti di dati.
- min-repliche-da-scrivere e min-replicas-max-lag: Il primario accetta operazioni di scrittura solo se sono connesse repliche sufficientemente vicine e il loro ritardo rimane al di sotto di una soglia prestabilita. Ciò riduce i rischi di split-brain.
Utilizzo questi meccanismi in combinazione con l’offset: l’offset verifica il effettivo Velocità di recupero e tendenze a lungo termine, mentre WAIT/min-replicas per comando Fornire protezione. In caso di RPO rigorosi, li combino e registro entrambe le visioni nel monitoraggio.
Avvisi e metriche nello stack di monitoraggio
Per il monitoraggio definisco chiari Valori di soglia in base alla differenza di offset in byte. Collego questa metrica alle serie temporali di Prometheus/Grafana e attivo degli allarmi quando il divario supera una durata prestabilita. Inoltre, registro le tendenze per individuare i picchi di carico e pianificare le contromisure. Le dashboard visualizzano master_repl_offset, gli offset delle repliche e il ritardo calcolato, il che accelera notevolmente le analisi durante il funzionamento. Qui trovo consigli pratici per le configurazioni con serie temporali: Monitoraggio di Redis con Prometheus e Grafana.
Runbook e percorsi di escalation
Propongo una procedura standardizzata affinché i team possano agire in modo mirato in caso di aumento del ritardo:
- Avviso: Lag > X MB per > Y s → Verificare la velocità di trasmissione e la latenza della connessione di replica, identificare i processi in competizione (snapshot, script Lua di grandi dimensioni).
- Maggiore: Il carico aumenta costantemente → Il carico del backlog, l'utilizzo della CPU/IO della replica e gli errori di rete (ritrasmissioni, pacchetti persi) sono correlati; se necessario, ridurre il carico di scrittura.
- Critico: Il backlog rischia di andare in sovraccarico → alleggerire il carico sulla replica (ad es. deviare temporaneamente il carico di lettura), pianificare una finestra di sincronizzazione completa o attivare una replica aggiuntiva.
Documento gli alberi decisionali in modo che sia chiaro quando un failover comporta ancora pochi rischi e quando invece dovrei aspettare che l'offset-gap si appiattisca.
Redis Cluster: valutare gli offset per ogni shard
In un cluster controllo gli offset per ogni shard, poiché ogni shard gestisce il proprio flusso di replica. Il comando CLUSTER SHARDS mi fornisce gli intervalli di slot, i ruoli dei nodi e gli offset rilevanti per il nodo primario e la replica. Differenze significative all’interno di uno shard indicano la presenza di rischi nel failover ordinato di tale shard. Pertanto, confronto sistematicamente gli offset di tutti gli shard e do la priorità ai nodi con un ritardo minimo come candidati per il ruolo di leader. In questo modo mantengo coerente il quadro generale ed evito sorprese durante il passaggio.
La quotidianità del cluster: monitoraggio del resharding e della migrazione degli slot
All'indirizzo Spostamenti delle slot la pressione di scrittura spesso aumenta in modo irregolare. Misuro gli offset per ogni shard durante le fasi MIGRATE per verificare se singole repliche restino indietro. Particolarmente delicate sono le finestre di migrazione più lunghe in combinazione con piccoli arretrati: in questi casi prevedo backlog più consistenti oppure scagliono le migrazioni, in modo che le sincronizzazioni parziali non vadano perse. Prima di ogni failover di shard, valuto se il nodo di destinazione ha recentemente assunto il carico dello slot e se il suo offset della replica rimane stabile.
Casi d'uso: interpretare l'offset in modo mirato
Per valutare il ritardo di replica, confronto sistematicamente il master_repl_offset con ogni offset della replica e ne deduco l’età dei dati potenzialmente obsoleti. Prima di un passaggio pianificato, valuto il rischio di failover identificando la replica più vicina e verificandone la coerenza per diversi minuti. Se il ritardo aumenta ripetutamente, lo metto in correlazione con le metriche di rete, il carico della CPU e l’I/O per individuare i colli di bottiglia e risolverli in modo mirato. Per obiettivi di durabilità rigorosi, verifico inoltre se le operazioni sono state confermate nell’AOF e come si comportano gli offset rispetto a esse. Questi modelli mi aiutano a basare le decisioni su un dato oggettivo e a ridurre al minimo i tempi di inattività.
Replica a cascata e configurazioni geografiche
Nelle configurazioni distribuite, spesso scelgo Collane replica (Replica-of-Replica), per alleggerire il traffico a lunga distanza. A tal proposito, tengo presente che l’offset si applica separatamente per ogni bordo e WAIT solo repliche collegate direttamente conta. Per la replica geografica definisco limiti di latenza realistici e misuro gli offset separatamente per ciascuna regione. Un failover regionale pianificato è giustificabile solo se la regione successiva in ordine di priorità mostra un gap minimo per un periodo prolungato e i percorsi di rete sono stabili. In caso di grandi distanze, riduco le operazioni di scrittura in burst, utilizzo il pipelining con moderazione e aumento i backlog sui nodi con il RTT più elevato.
Gestione orientata alla pratica in ambienti di hosting
In un contesto gestito, punto su chiari Cruscotti, che riuniscono offset, ritardi e stati di integrità. Per i team che desiderano accelerare le diagnosi, vale la pena dare un’occhiata agli strumenti che offrono una visione approfondita di Redis e una visualizzazione chiara. In questo modo riesco a individuare tempestivamente gli offset in deriva e ad adottare contromisure prima che i backlog si accumulino o che le sincronizzazioni complete generino picchi di carico. Inoltre, eseguo test di failover in ambienti di staging e misuro la velocità con cui gli offset si riallineano dopo il passaggio. Questa guida mi offre un'introduzione pratica all'analisi grafica: Redis Insight per la diagnostica.
Modelli di risoluzione dei problemi in caso di aumento del lag
Quando l'offset-gap aumenta, procedo seguendo schemi ricorrenti:
- CPU replica a pieno carico: I colli di bottiglia single-thread o gli script Lua dispendiosi rallentano l'elaborazione; lo verifico in base alla velocità di elaborazione e appianerò i picchi.
- Pressione della memoria o I/O: AOF-Rewrite, Snapshot o vicini rumorosi aumentano la latenza; sposto i processi, ottimizzo le classi di archiviazione o attivo la sincronizzazione diskless.
- Il percorso di rete varia: Retransmissioni, pacchetti persi o discrepanze MTU; controllo gli errori di interfaccia, le dimensioni dei buffer e riduco la perdita di pacchetti.
- Buffer di uscita della replica: Se il limite per le repliche è troppo basso, il primario interrompe la connessione; io imposto client-output-buffer-limit per repliche adatte al carico.
- Overhead TLS: Su una CPU poco potente, la crittografia può ridurre le prestazioni; misuro i costi di crittografia e adeguo il numero di core oppure alleggerisco il carico tramite l'accelerazione hardware.
- Strumenti diagnostici con effetti collaterali: MONITOR oppure rallenta il logging troppo intenso; utilizzo tali strumenti con parsimonia e per periodi limitati.
Mantengo presenti questi modelli all’interno del team, in modo che, in presenza di segnali di allarme, non partiamo da zero con la ricerca, ma verifichiamo e scartiamo rapidamente le ipotesi.
Panoramica tabellare: indicatori chiave a colpo d'occhio
Mi piace riassumere la seguente panoramica durante il lavoro, perché illustra i punti più importanti Cifre chiave e raggruppa le iniziative in un unico posto.
| Segnale | Significato | Fonte tipica | Azione/Interpretazione |
|---|---|---|---|
| master_repl_offset | Byte generati dal primario nel flusso di replica | INFO replica | Linea di riferimento per il calcolo del ritardo, monitorare l'andamento |
| slave_repl_offset | Byte già applicati dalla replica | INFO replica, sezione Replica | Sottrarre da master_repl_offset, determinare il gap |
| ID replica | Indicatori relativi alla cronologia/generazione dei dati | INFO replica | Combinare con l'offset, verificare l'allineamento parziale |
| Dimensione del backlog | Buffer circolare per i byte più recenti | Configurazione, INFO replica | Scegliere un modello più grande in caso di volumi di scrittura elevati |
| offset di replica (cluster) | Offset per shard per primario/replica | FRAMMENTI DI CLUSTER | Valutare i candidati allo shard per il passaggio |
Sintesi: Padroneggiare l'offset, evitare i guasti
Ho impostato il Offset come metrica di riferimento centrale per gestire in modo sicuro la coerenza, gli allineamenti parziali e il comportamento di failover. Grazie a INFO replication, a una dimensione adeguata del backlog e a un sistema di alerting ben definito, mantengo i nodi replicati strettamente allineati. Nelle topologie a cluster, valuto gli offset per ogni shard e do priorità ai candidati con un ritardo minimo. L'ottimizzazione di hz, della rete e dei percorsi di memoria riduce ulteriormente il ritardo ed evita costose sincronizzazioni complete. Chi monitora costantemente gli offset riduce i tempi di inattività e aumenta notevolmente l’affidabilità dell’intero stack Redis.


