 Vai al contenuto

Pooling di Redis In PHP riduce il sovraccarico delle connessioni, abbassa la latenza e garantisce che Redis non diventi un collo di bottiglia in caso di carico elevato. Vi mostrerò come configurare i pool di connessioni con phpredis e PHP-FPM in modo che sessioni, cache e code rispondano in modo sensibilmente più veloce.
Punti centrali
Riassumo i punti salienti in modo conciso e chiaro, affinché tu possa attivare correttamente il pooling senza intoppi. pooling influisce sui costi di trasporto, sul profilo degli errori e sulla pianificazione delle capacità; pertanto, vale la pena procedere a un'implementazione strutturata. Mi concentro su phpredis, PHP-FPM e ambienti asincroni, poiché è qui che si ottengono gli effetti maggiori. Impostazioni predefinite ben ponderate aiutano a evitare rischi come le connessioni „inquinate“ e a ottenere tempi di risposta costantemente brevi. Alla fine, conoscerai le leve con cui potrai ottimizzare il tuo Connessioni riesci a tenere sotto controllo.
- Utilizzare pconnect al posto di connect per i socket riutilizzabili
- Limiti INI per le dimensioni della pool, i controlli di integrità e i modelli
- Votazione sull’FPM vs. maxclients di Redis sotto la lente
- Timeout essere concisi e verificare i percorsi di errore
- Condizione pulire prima di restituirlo al pool
L'elenco illustra le priorità che mi sono prefissato per ottenere risultati rapidi, senza modificare il codice a casaccio. Persistente Le connessioni dimostrano la loro utilità solo quando i limiti del server e quelli dei processi sono ben coordinati. Prevengo gli errori tipici gestendo i limiti in modo rigoroso e applicando regole di pulizia ben definite. In questo modo la latenza rimane bassa e Redis gestisce in modo affidabile anche i picchi di carico. Chi effettua misurazioni mirate individua rapidamente dove si trova ancora del potenziale e di quanto margine disponga il Infrastrutture ha.
In che modo il connection pooling riduce la latenza e il consumo di risorse
Ogni nuovo handshake TCP richiede tempo e grava inutilmente sul sistema operativo, pertanto riutilizzo Connessioni In modo coerente. Grazie ai socket persistenti evito ripetuti handshake TLS, il che ha un forte impatto in caso di numerose operazioni brevi come GET/SET. I pool impediscono la creazione di migliaia di socket di breve durata che rimangono bloccati in TIME_WAIT. Mantengo basso il numero di socket simultanei, accelerando comunque l’elaborazione. In questo modo aumentano la velocità di elaborazione e la reattività, senza dover apportare modifiche complesse alla logica nel codice dell’applicazione.
Il pooling dà il meglio di sé soprattutto nelle configurazioni PHP-FPM, poiché ogni processo worker dispone di un proprio piscina gestite. Ciò impedisce a Redis di dover far fronte a un'ondata di connessioni nei momenti di picco di carico. Ne traggo immediatamente vantaggio per quanto riguarda le sessioni, le cache e le code, poiché questi carichi di lavoro generano numerose operazioni di breve durata. Chi desidera approfondire l'argomento delle sessioni, troverà in Sessioni Redis in PHP l'approccio giusto. Regolo i parametri in modo tale che gli errori di rete vengano individuati rapidamente e che, se necessario, l'applicazione passi alle soluzioni di riserva.
In pratica, gran parte della latenza „fredda“ scompare, poiché la connessione è già attiva e non si accumula alcun carico dovuto al DNS o al TLS. VivacitàI controlli assicurano che i socket difettosi non compaiano affatto nella richiesta successiva. In questo modo il tasso di errore rimane basso e l’interazione con l’utente risulta notevolmente più fluida. Mi attengo a passaggi piccoli e logici: attivo pconnect, imposto i limiti, attivo Liveness. Successivamente verifico l’andamento delle metriche e se il carico di Redis, il numero di processi FPM e il comportamento dell’app sono in linea tra loro.
phpredis: connect vs. pconnect – cosa succede davvero?
Con phpredis Faccio una chiara distinzione tra `connect()` e `pconnect()`. `connect()` apre una connessione temporanea per ogni richiesta e la chiude al termine. `pconnect()` crea socket persistenti che il worker FPM mantiene per più richieste. phpredis assegna le connessioni persistenti a un pool in base a host, porta, autenticazione e, facoltativamente, al persistent_id. In questo modo, il mio codice utilizza una connessione già esistente ad ogni chiamata, invece di avviarne una nuova ogni volta.
La tabella seguente mi aiuta a valutare rapidamente le differenze e a fare la scelta giusta. Panoramica Mi fa risparmiare tempo durante il debug e la pianificazione dei limiti. Lo abbino alle misurazioni per osservare gli effetti nel mio stack. Soprattutto con TLS, pconnect offre vantaggi tangibili. Più breve è l’operazione, maggiore è il beneficio derivante dagli handshake risparmiati.
| Aspetto | connect() | pconnect() |
|---|---|---|
| Vita utile | Solo la richiesta corrente | Fino al termine di FPM-Worker |
| Costi generali relativi all'Handshake | Nuovo per ogni richiesta | Una volta, poi riutilizzo |
| pooling | Nessuna piscina | Pool interno per ogni worker |
| Immagine di errore | Molte prese corte | Pochi socket di lunga durata |
| Raccomandazione | Casi particolari, test | Funzionamento quotidiano |
Continuerò a lavorare presso lo stabilimento di produzione di pconnect e utilizzo connect solo per la diagnostica o in casi limite. I socket persistenti si comportano in modo più uniforme nel corso di numerose richieste. Allo stesso tempo, faccio attenzione a non lasciare alcun „stato“ che possa causare problemi in seguito. Ciò vale soprattutto per le transazioni e le opzioni, che pulisco dopo ogni utilizzo. In questo modo, la richiesta successiva ottiene una connessione pulita e l’app rimane prevedibile.
Parametri INI importanti per un pooling efficace
Le impostazioni INI corrette determinano quanto generoso sia il tuo piscina gestisce le connessioni. Impostiamo redis.pconnect.pooling_enabled su 1 affinché il pooling rimanga attivo. Con redis.pconnect.connection_limit limito il numero di connessioni per pool, ad esempio a 32. redis.pconnect.echo_check_liveness verifica i socket riutilizzabili ed elimina quelli difettosi. Un pool_pattern coerente garantisce che phpredis raggruppi correttamente le connessioni.
Ecco come si presenta una configurazione iniziale compatta: Limite 32, pooling attivo, liveness attivo. In questo modo il numero di socket TIME_WAIT diminuisce sensibilmente. Monitoro i client e le latenze e apporto modifiche graduali. Se si verificano timeout, posso aumentare i limiti o regolare il numero di worker FPM. In questo modo mi avvicino a uno stato che funziona correttamente anche sotto carico.
redis.pconnect.pooling_enabled = 1
redis.pconnect.connection_limit = 32
redis.pconnect.echo_check_liveness = 1
Non scelgo mai i valori „a caso“, ma prima valuto la Tempi di risposta. A quel punto regolo i limiti massimi finché Redis, FPM e l'applicazione non funzionano perfettamente insieme. I pool di grandi dimensioni sembrano allettanti, ma aumentano il rischio di superare il limite di maxclients. I pool piccoli e ben sfruttati offrono solitamente prestazioni migliori. Ciò consente di risparmiare RAM su entrambi i fronti e garantisce tempi di risposta costanti.
Sincronizzare correttamente PHP-FPM e Redis
Per prima cosa stabilisco quanti Lavoratore in base a pm.max_children. Ogni worker può gestire più socket Redis, quindi non moltiplico ciecamente i limiti di connessione. Redis stesso ha un limite maxclients che non supero. Faccio il calcolo: worker FPM × connessioni per pool × applicazioni, e lo confronto con maxclients. Lasciando delle riserve per i client di amministrazione o di monitoraggio, non andrò fuori dai limiti anche sotto carico.
Tra le impostazioni di precisione rientrano anche i timeout. Timeout I tempi compresi tra 0,5 e 1,5 secondi coprono le tipiche richieste alla cache e consentono di individuare rapidamente eventuali anomalie. Imposto connect_timeout e read_timeout in modo prudente e registro gli errori in modo dettagliato. In questo modo posso capire se la rete è intasata o se Redis è sovraccarico. Se si verificano spesso reset o timeout, regolo i limiti, i timeout e il numero di worker a piccoli passi.
Distinguo chiaramente i percorsi di errore delle app dagli errori della cache. Ricadute non devono bloccare la richiesta se Redis subisce un breve rallentamento. Ciò migliora l’esperienza complessiva e mantiene i frontend reattivi. Dei log ben strutturati mi consentono di capire se il problema è dovuto a un sovraccarico o a interruzioni di connessione. A quel punto, intervengo sui worker, sulle dimensioni dei pool o sul server Redis stesso.
Un consiglio concreto: inizia con un limite di „nuclei × 2“ per ogni worker e poi verifica il carico di lavoro effettivo. Valori misurati Affidati al tuo istinto in qualsiasi contesto. Tieni d’occhio le metriche e aumenta gradualmente la capacità se ci sono richieste in sospeso. In questo modo sfrutterai l’hardware in modo efficace. Allo stesso tempo, il numero di socket aperti rimarrà gestibile.
Controllo regolarmente le sezioni “INFO clients” e “CLIENT LIST” per verificare l’attuale Carico da osservare. Questi valori indicano se i pool funzionano o se si verificano molte nuove connessioni. Se rilevo picchi, controllo il DNS, il Keep-Alive e i controlli di operatività. In caso di dubbio, eseguo un test senza TLS per misurare l’influenza degli handshake. Successivamente, riattivo il TLS con la ripresa della sessione.
Utilizzo sicuro delle connessioni persistenti
I socket persistenti mantengono il loro Condizione fino al termine del worker, quindi provvedo a ripulire esplicitamente. Chiudo le transazioni in modo corretto con EXEC o DISCARD. Per ogni richiesta, imposto in modo coerente il database necessario tramite SELECT e tutte le opzioni richieste dal mio codice. Prima del ritorno, nessuna pipeline o MULTI deve rimanere aperta. Solo così la connessione del pool rimane utilizzabile in modo corretto.
Prima di riutilizzare i dati, è obbligatorio effettuare i controlli di validità. Difetti Blocco immediatamente le connessioni socket e impiego una ricostruzione. Faccio una chiara distinzione tra „Server down“ e „Timeout“, perché reagisco in modo diverso a ciascuna situazione. In caso di timeout ricorro rapidamente alle soluzioni di ripiego, mentre in caso di interruzioni della connessione preferisco effettuare una riconnessione. In questo modo l’app rimane prevedibile, anche quando la rete fa i capricci.
Documento quali opzioni vengono impostate per una connessione, in modo da evitare sorprese in seguito. Transazioni Lo annoto in modo particolare, perché è proprio qui che spesso si verificano gli errori. Per le librerie scelgo varianti che gestiscono correttamente pconnect. Nei test simulo interruzioni di rete, riavvii del server Redis e picchi di ritardo. Solo quando l'app riesce a gestirli senza problemi, la metto in produzione.
Un ostacolo comune è rappresentato dagli stati globali nelle classi helper. pulizia Dopo ogni utilizzo, impedisce che flag, modalità di sola lettura o timeout „rimangano attivi“. Mantengo la logica di connessione centralizzata, ad esempio in una classe di servizio. Ciò riduce il tasso di errore in tutto il codice. Inoltre, facilita il testing con mock o backend alternativi.
Chi modifica raramente il pooling rischia facilmente di dimenticare le ripercussioni sui test, sulla CLI o sui cronjob. CLI-Anche gli script traggono vantaggio da pconnect se vengono eseguiti frequentemente. Per gli script a esecuzione prolungata, adatto i controlli di liveness. Per gli script one-shot è sufficiente connect con timeout brevi. Impostazioni predefinite uniformi evitano sorprese durante il funzionamento.
Pooling negli stack PHP asincroni (Swoole & Co.)
In ambienti asincroni come Swoole I processi PHP a lunga durata utilizzano modelli di worker dedicati. Inizializzo il pool Redis all’avvio del worker o alla prima richiesta. Le coroutine prendono in prestito una connessione e la restituiscono dopo l’utilizzo. La dimensione del pool può crescere dinamicamente, ma rimane comunque limitata. In questo modo distribuisco in modo efficiente i socket tra i lavori e le richieste.
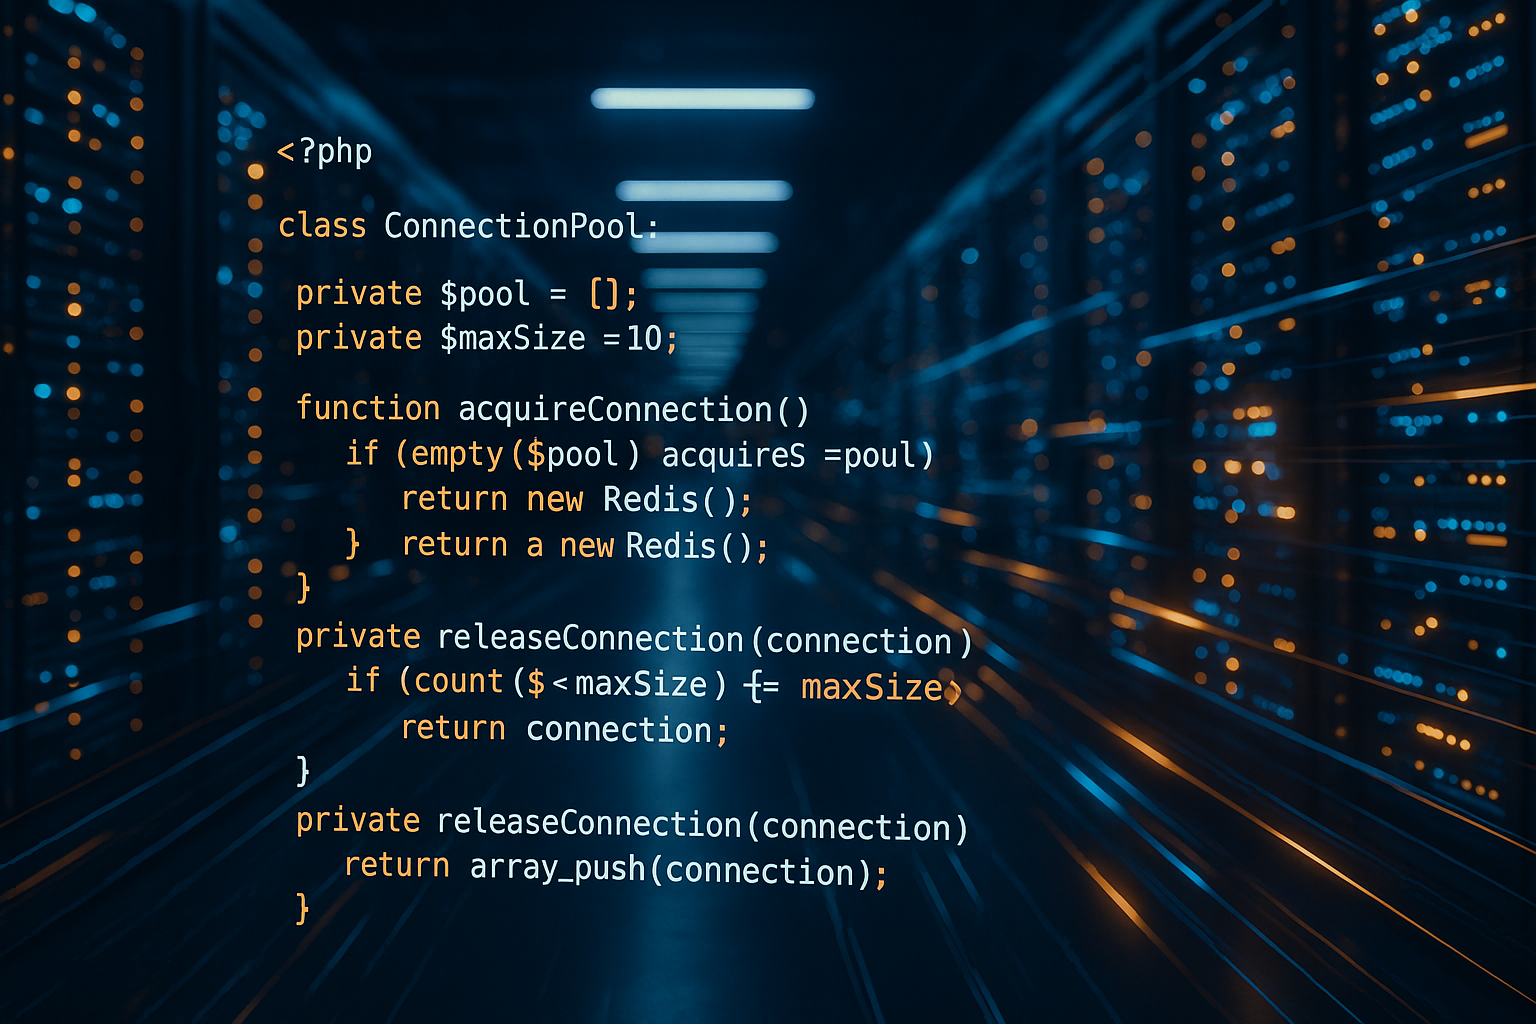
Un oggetto RedisPool astratto rende il codice dell'applicazione più chiaro. API Come getConnection() e releaseConnection(), incapsulano i dettagli e prevengono le perdite di memoria. Registro la durata dei prestiti, i tassi di errore e i tempi di attesa nel pool. Se i tempi di attesa aumentano, ridimensiono la dimensione del pool o il numero di worker. Ciò previene la contropressione e garantisce tempi di risposta brevi.
Anche in questo caso vale la regola: non lasciare residui di stato nei collegamenti. Trasparenza Il log mostra se i controlli di liveness funzionano tempestivamente. Testo in modo mirato i percorsi di failover, inclusi gli errori DNS e la perdita di pacchetti. In questo modo mi accorgo tempestivamente se le strategie di riconnessione funzionano correttamente. Ciò risulta particolarmente utile durante i test di carico.
Prendo in particolare in considerazione l'overhead di TLS, poiché i sistemi asincroni generano molte operazioni parallele. Ripresa Il Keep-Alive riduce i costi per socket. Il pipelining e le letture in batch contribuiscono inoltre a ridurre i round-trip. La combinazione con un serializzatore snello fa risparmiare ulteriore tempo. Alla fine, ciò che conta è la velocità con cui l'utente vede il risultato.
Per le metriche utilizzo i tag per worker e per pool. Tracciamento A livello di richiesta, evidenzia quando un’operazione è in attesa di una connessione. Questo permette di individuare i colli di bottiglia che un semplice monitoraggio di Redis non rileva. In questo modo riesco a trovare il giusto equilibrio tra la dimensione del pool e il numero di worker. Successivamente, le prestazioni si stabilizzano in modo misurabile.
Redis come livello di cache nell’hosting
Negli scenari di hosting utilizzo Redis per le sessioni, la cache delle pagine e la cache degli oggetti, motivo per cui pooling È obbligatorio. Gli accessi frequenti e brevi traggono grande vantaggio dalle connessioni riutilizzate. Per WordPress, tengo conto delle particolarità della cache degli oggetti e ne verifico il comportamento sotto carico. Chi desidera informarsi sugli ostacoli tipici, può consultare Cache degli oggetti in WordPress. In questo modo evito lunghi picchi di TTFB e mantengo veloce il caricamento delle pagine.
Salvo le sessioni in Redis, in modo che i worker PHP-FPM siano indipendenti dal locale Immagazzinamento da fare. Con il pooling riduco l’overhead di locking nella richiesta e preservo l’IO. È importante una chiara separazione tra chiavi di sessione, chiavi dell’app e strumenti di amministrazione. In questo modo mantengo una visione d’insieme nella pianificazione della capacità. A tal fine, documento i TTL per far scadere in modo controllato le vecchie voci.
Negli ambienti multi-tenant, segmento i pool in base al persistent_id o all'host, in modo che i tenant operino in modo nettamente separato. Isolamento riduce il rischio che un cliente occupi le connessioni degli altri. Mi assicuro che i limiti per ogni cliente rimangano realistici. Inoltre, prevedo delle riserve affinché le attività di amministrazione non subiscano rallentamenti. Ciò garantisce un’esperienza uniforme su tutte le applicazioni.
Per garantire un'implementazione rapida, dispongo di una configurazione standard che adeguo con precisione a ciascuna app. Impostazioni predefinite comprendono pconnect, Liveness, limiti moderati e timeout ben definiti. Successivamente, i test di carico verificano la scalabilità. Se un test non viene superato, regolo i limiti e il numero di worker FPM a piccoli passi. In questo modo evito reazioni eccessive e mantengo la curva di apprendimento piatta.
Per ogni app, registro il numero di connessioni necessarie nei momenti di picco. Pianificazione Basandosi su dati reali, evita sorprese in caso di picchi di traffico. Ciò consente di risparmiare tempo e costi durante il funzionamento. Allo stesso tempo, il server Redis rimane sotto carico contenuto. E gli utenti ottengono risposte più rapide.
Pub/Sub, comandi di blocco e code: come gestirli correttamente
I comandi Pub/Sub e di blocco, come BLPOP o XREAD, bloccano il socket. Questi Sciatore di fondo Non utilizzo mai il pool generale. Utilizzo invece, per ogni worker, un client Redis separato e dedicato esclusivamente alle operazioni di blocking o Pub/Sub. In questo modo il pool regolare rimane libero per le chiamate GET/SET veloci e la latenza delle richieste web rimane costantemente bassa.
Per i worker BRPOP, dimensiono il numero di consumatori in parallelo e mantengo brevi i timeout, in modo che le riconnessioni in caso di interruzioni avvengano rapidamente. Per Pub/Sub, separo rigorosamente le connessioni di lettura da quelle di scrittura. Chiudo le sottoscrizioni in modo controllato prima che il worker venga riciclato, per evitare socket bloccati. Questa pratica impedisce che i socket del pool rimangano „accidentalmente“ in modalità bloccante.
Transazioni, WATCH/UNWATCH e script Lua
Il pooling amplifica gli effetti di condizioni come MULTI/EXEC, WATCH o le cache di scripting. Al termine di ogni transazione chiamo sistematicamente EXEC o DISCARD ed eseguo UNWATCH nel caso in cui utilizzi il blocco ottimistico. Per gli script Lua, Redis memorizza gli script nella cache per ogni connessione; utilizzo EVALSHA con fallback su EVAL in caso di errori NOSCRIPT, in modo che il codice rimanga robusto anche in caso di riconnessioni e cambi di pool.
function evalsha_safe(Redis $r, string $sha, array $keys = [], array $argv = []) {
  try {
    return $r->evalSha($sha, array_merge($keys, $argv), count($keys));
  } catch (RedisException $e) {
    // NOSCRIPT-Fallback
    if (str_contains($e->getMessage(), 'NOSCRIPT')) {
      // $script hier passend bereitstellen
      return $r->eval($GLOBALS['MY_SCRIPT'], array_merge($keys, $argv), count($keys));
    }
    throw $e;
  }
}
Nel mio blocco `finally` elimino anche `UNWATCH`, nel caso in cui fosse stato impostato `WATCH`. In questo modo, la connessione rimane „neutra“ quando ritorna nel pool e la richiesta successiva può funzionare senza prerequisiti nascosti.
Socket Unix, TLS e serializzatori/compressione
Se PHP e Redis girano sullo stesso host, preferisco utilizzare socket Unix. Si riduce l'overhead TCP e si abbassano ulteriormente le latenze. Il persistent_id rimane lo stesso, cambia solo l'endpoint. Nei sistemi multiutente mi assicuro che i permessi dei socket siano corretti.
$r = new Redis();
$r->pconnect('/var/run/redis/redis.sock', 0, 0.5, 'app_pool_unix');
$r->setOption(Redis::OPT_READ_TIMEOUT, 1.0);
Con TLS attivo la ripresa della sessione, mantengo snelle le catene di certificati ed evito le risoluzioni DNS ripetute. Tempi di keep-alive brevi a livello di sistema operativo (tcp_keepalive) aiutano a individuare più rapidamente i percorsi difettosi, senza effettuare ricollegamenti troppo aggressivi.
Sto ottimizzando il serializzatore per il trasferimento dei dati. igbinary Riduce sensibilmente le dimensioni dei payload e il tempo di elaborazione della CPU rispetto alla serializzazione PHP. Laddove opportuno, aggiungo una leggera compressione.
$r->setOption(Redis::OPT_SERIALIZER, Redis::SERIALIZER_IGBINARY);
$r->setOption(Redis::OPT_COMPRESSION, Redis::COMPRESSION_LZF);
Utilizzo il serializzatore e la compressione in modo selettivo: per valori molto piccoli non ne vale la pena, mentre per oggetti di grandi dimensioni nella cache degli oggetti spesso ne vale decisamente la pena. Effettuare alcune misurazioni nel proprio stack permette di fare rapidamente chiarezza.
Cluster, Sentinel e failover con pool
All'indirizzo Cluster-Nelle configurazioni utilizzo RedisCluster e attivo le connessioni persistenti. Ogni nodo gestisce i propri socket nel worker. Monitoro i reindirizzamenti (MOVED/ASK) e verifico se aumentano: questo è un segnale di ribilanciamento o di una distribuzione delle chiavi non adeguata.
$rc = new RedisCluster('cluster', ['10.0.0.1:6379','10.0.0.2:6379'], 0.5, 1.0, true); // persistent
$rc->setOption(Redis::OPT_READ_TIMEOUT, 1.0);
Con Sentinel Un livello aggiuntivo monitora il master. In caso di failover, elimino in modo mirato dal pool tutte le connessioni al vecchio master e impongo una ricostruzione. Prevedo TTL DNS brevi oppure utilizzo Sentinel-Discovery direttamente tramite elenco IP, affinché il cambio abbia effetto rapidamente. I controlli di operatività (liveness check) individuano in modo affidabile i socket obsoleti e inattivi.
Limiti lato server, eviction e keep-alive
Il pooling funziona solo se Redis stesso è configurato correttamente. Ritengo che maxclients con un buffer (10–20 %) al di sotto del limite massimo calcolato e tenendo conto dei client aggiuntivi (amministratore, monitoraggio). Impostiamo il `client-output-buffer-limit` per normal/pubsub in modo che i consumatori lenti non intasino la memoria. Utilizzo `tcp-keepalive` con moderazione per individuare le connessioni inattive senza generare un carico di pacchetti superfluo.
A pieno carico, è determinante la Politica di sfratto sul comportamento e sulle latenze. Per le cache utilizzo varianti “volatile” o “allkeys”, a seconda della struttura delle chiavi. Importante: le espulsioni sono visibili nelle metriche; se aumentano notevolmente, significa che la cache è troppo piccola o che la strategia TTL non è adeguata. Intervengo prima che aumentino i timeout.
Calcolo della capacità con esempio
Un pratico modello di calcolo previene i valori anomali: supponiamo di avere 12 worker FPM e tre app che condividono lo stesso Redis (sessioni, cache, coda). Per ogni worker prevedo 2–3 socket per app (operazioni brevi), per un totale di circa 12 × 3 × 3 = 108 socket teorici. Con limite_connessione 16 per pool e, in base al carico di lavoro effettivo, nella pratica ci troviamo spesso ben al di sotto di questo valore (60–80). Con un valore di maxclients pari a 1.000 rimane un’ampia riserva per i client di amministrazione e monitoraggio, nonché per i lavori CLI sporadici. Misuro regolarmente i picchi e abbasso i limiti se non vengono mai raggiunti: in questo modo il fabbisogno di memoria per connessione rimane basso.
Backoff, Circuit Breaker e Graceful Reload
In caso di errori, mi affido a backoff esponenziale con jitter, per evitare effetti “Thundering Herd”. Dopo alcuni tentativi falliti, apro un circuit breaker e passo temporaneamente alle soluzioni di ripiego, invece di intasare i pool con inutili tentativi di riprova. Le operazioni riuscite chiudono rapidamente il circuit breaker.
All'indirizzo Ricarica Con PHP-FPM (graceful) lascio che i worker terminino la loro attività. In questo modo, le connessioni persistenti vengono rilasciate in modo ordinato. Controllo se, dopo un ricaricamento, si verificano temporaneamente più nuove connessioni e, se necessario, adeguo la frequenza di avvio dei nuovi worker. In questo modo evito i picchi di connessioni durante i deployment.
Approfondire l'osservabilità
Taggio le metriche per worker, app e ID del pool. Oltre al monitoraggio lato Redis, analizzo i tempi di attesa per una „connessione libera“. Se questi aumentano, significa che il pool è troppo piccolo oppure che operazioni bloccanti occupano i socket. Impostare semplici Libri di corsa ad esempio: „Se i timeout sono > X, allora…“, compresa la sequenza di passaggi per il limite del pool, il numero di worker, il timeout di lettura e l'analisi della CLIENT LIST. Questi playbook accelerano enormemente la risoluzione dei problemi.
Sintesi e passi successivi
Attivo pconnect, imposto un `connection_limit` moderato, attivo i controlli di attività (Liveness Checks) e sincronizzo i worker FPM con il parametro `maxclients` di Redis. Successivamente, imposto timeout brevi e ripulisco gli stati delle connessioni prima di restituirle al pool. Grazie al monitoraggio e a piccole iterazioni, trovo il punto di equilibrio ideale per la mia app. Le sessioni, le cache e le code reagiscono quindi in modo più rapido e costante. In questo modo ottengo il massimo delle prestazioni dall’hardware disponibile, senza apportare grandi modifiche al codice.
Successivamente controllo il Limiti del mio ambiente e misuro gli effetti del pooling sotto carico. Prevedo delle riserve per i client di amministrazione e monitoraggio. Per WordPress ottimizzo in particolare la cache degli oggetti e controllo il TTFB. Negli stack asincroni garantisco il prestito e la restituzione del pool. Con questi passaggi ottengo tempi di risposta brevi, bassi tassi di errore e server poco sollecitati.


