 Vai al contenuto

Spiego in modo conciso e approfondito come Evento MPM che utilizza l'Apache Event Queue per gestire in modo efficiente numerose connessioni HTTP simultanee. In questo contesto illustrerò i concetti di base, l'event loop, le code interne e le misure concrete di ottimizzazione per una performante Configurazione.
Punti centrali
- Ciclo di eventi separa la gestione delle connessioni dall'elaborazione delle richieste
- Mantenere in vita non blocca più i thread
- Coda degli eventi ordina i socket in base allo stato
- Parametri Come ottimizzare in modo mirato il parametro MaxRequestWorkers
- Monitoraggio garantisce una pianificazione affidabile delle capacità
Come Event MPM gestisce le connessioni
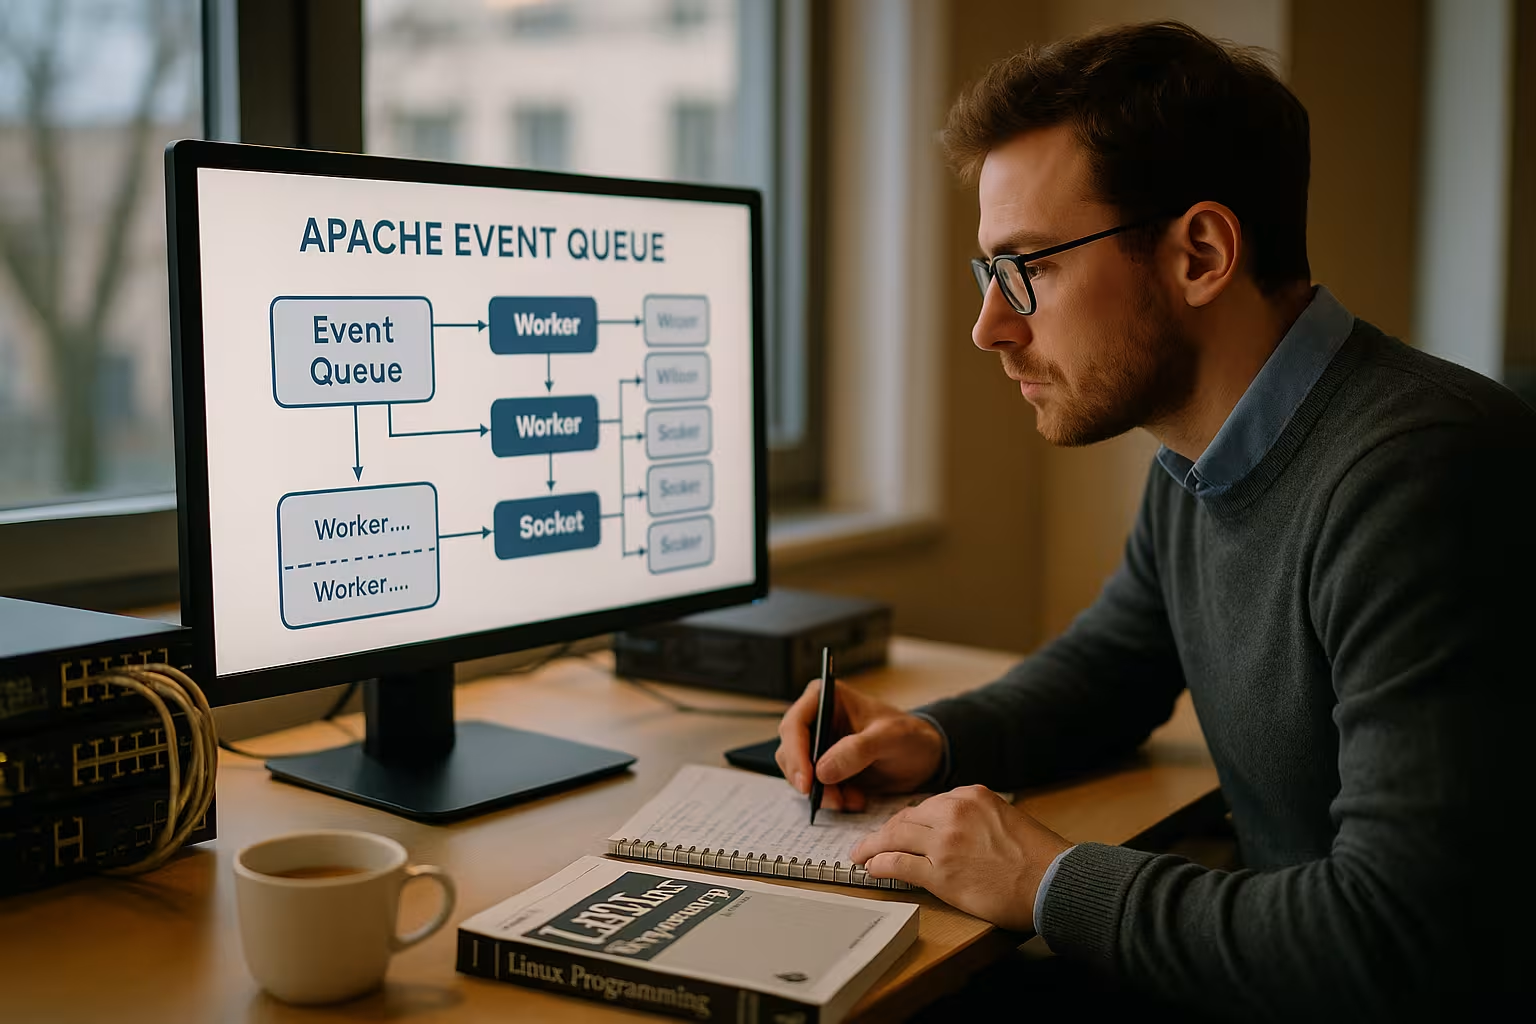
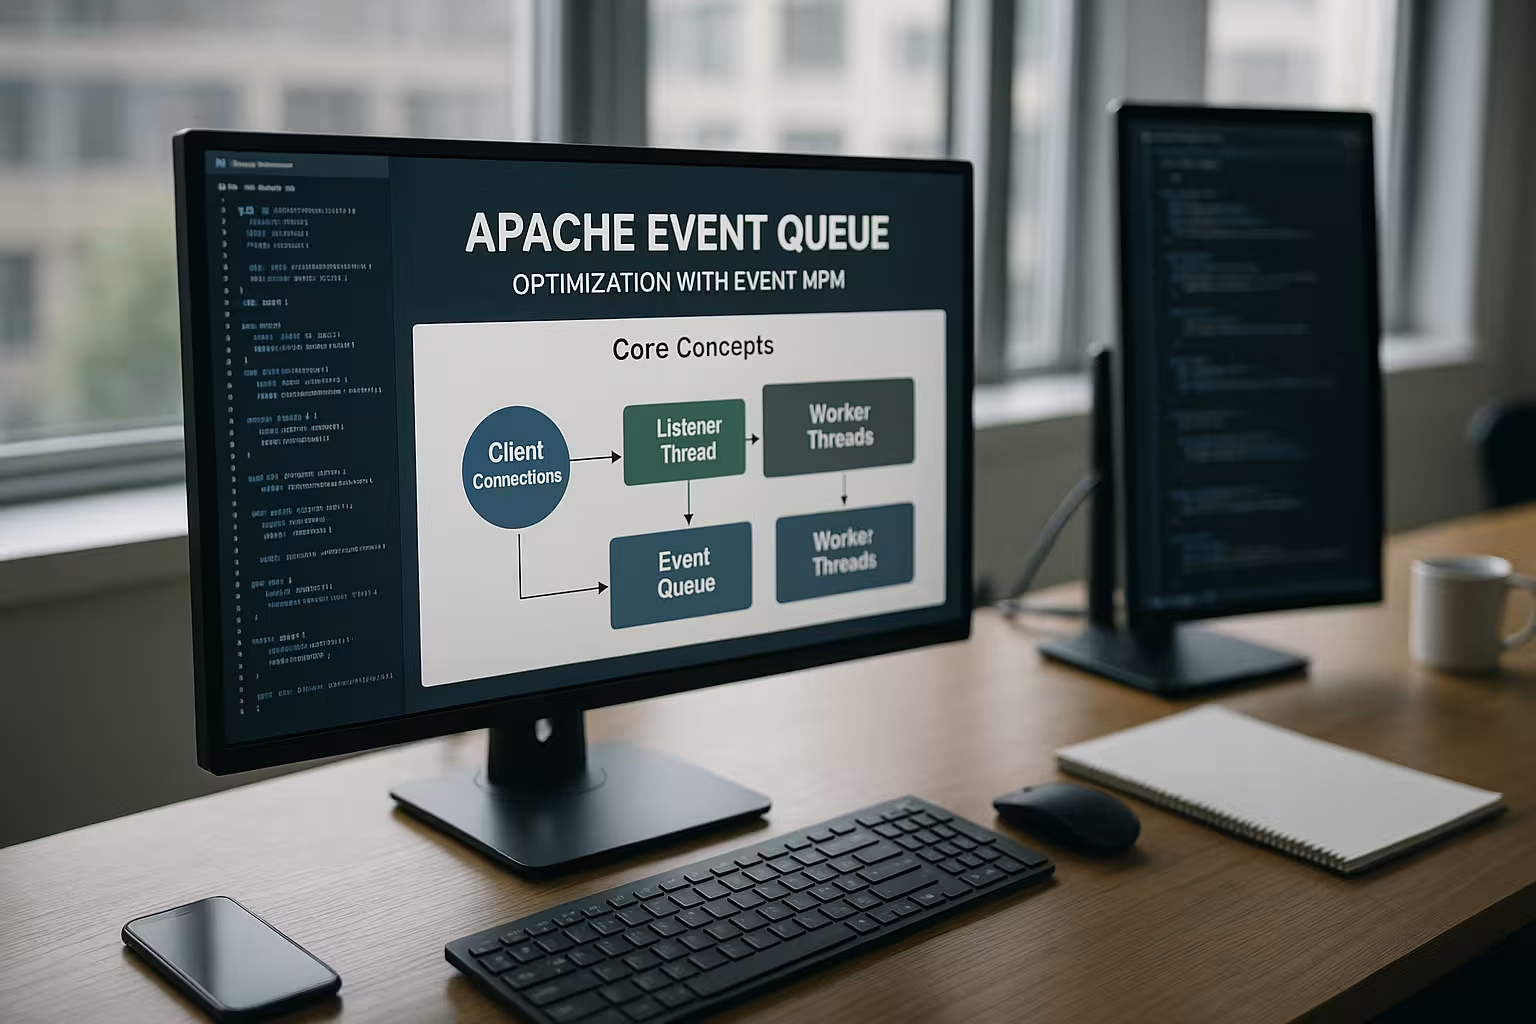
Comincio con la domanda: come si avvia Apache sotto Carico gestisce così tante connessioni. Event MPM combina processi e thread, ma assegna la priorità agli eventi tramite un ciclo di eventi. I thread listener accettano nuovi socket e monitorano le connessioni esistenti senza bloccare immediatamente un worker. Solo quando i dati sono leggibili o scrivibili, il livello degli eventi trasferisce il socket a un thread di lavoro libero. In questo modo si evita che marcia a vuoto- Le connessioni occupano thread e sprecano memoria.
Questa separazione riduce sensibilmente il carico sulla RAM. I thread si occupano soprattutto di „lavoro vero e proprio“, come l’analisi delle richieste, la generazione delle risposte o il proxy. L’event loop riporta poi i socket nello stato appropriato, ad esempio riattivando il Keep-Alive o portandoli nella fase di chiusura. Nella pratica, ho notato code più brevi durante i picchi di carico, poiché i thread liberi tornano disponibili più rapidamente. L’architettura offre una chiara scalabile Reattività per carichi di lavoro tipici di HTTP/1.1 e HTTP/2.
L'Apache Event Queue in dettaglio
La coda degli eventi assegna a ogni connessione uno stato, ed è proprio qui che sta il Profitto rispetto agli MPM classici. Le nuove connessioni finiscono inizialmente in una coda che ne verifica la leggibilità. Quando arrivano dei dati, l'event loop sposta il socket in una coda „readable“ e lo assegna a un worker. Dopo l’elaborazione, lo stato determina nuovamente l’azione da intraprendere: terminare la scrittura, mettere in attesa il Keep-Alive o chiudere la connessione. Questo ciclo rimane snello poiché la gestione delle code avviene in modo efficiente tramite epoll o kqueue.
Spesso noto dei malintesi: la Event Queue non sostituisce i worker, ma ne coordina il Utilizzo più efficiente. I thread continuano a elaborare le richieste, ma solo quando c’è effettivamente un flusso di byte. Ciò riduce il carico sulla CPU e sulla memoria in scenari con molte connessioni Keep-Alive „inattive“. Quanto più accurata è la progettazione dei timeout e dei buffer, tanto minore è il rischio che le connessioni rimangano inutilmente a lungo in stati dispendiosi. In questo modo è possibile mantenere costante il tempo di risposta anche con migliaia di socket aperti.
Il problema del keep-alive negli MPM classici
Con HTTP/1.1, le connessioni rimangono spesso aperte per inviare più richieste senza un nuovo handshake, il che Latenza risparmia. Tuttavia, Prefork o Worker vincolano a tale scopo processi o thread che rimangono in attesa. Nei picchi di carico, molte connessioni keep-alive bloccano quindi preziose risorse di esecuzione. Ciò fa aumentare il consumo di RAM e limita il numero di client paralleli. L’Event MPM risolve questo problema mantenendo i socket inattivi senza thread in uno stato di attesa ottimizzato nella coda degli eventi.
In questo modo metto in attesa numerose connessioni e avvio l'elaborazione solo quando se ne presenta effettivamente la necessità. Ciò modifica il modello di capacità: invece di "thread = connessioni", utilizzo "thread = lavoro attivo". Negli scenari di benchmark, questo mi permette di consentire un numero significativamente maggiore di connessioni aperte senza cali di prestazioni nella Tempo di risposta. Per i backend API, l'hosting WordPress e i siti con grandi quantità di contenuti, ciò si traduce in un carico di lavoro notevolmente più uniforme. I vantaggi del Keep-Alive vengono mantenuti senza che i thread vengano bloccati.
MPM evento vs. MPM lavoratore
Riassumo le differenze in modo sintetico in una Tabella insieme. L'obiettivo è fornire una rapida panoramica sulla gestione, sui requisiti di risorse e sui campi di applicazione tipici. Entrambe le varianti si basano su processi con più thread, ma Event associa il Keep-Alive a un thread con minore frequenza. Worker rimane una scelta solida per carichi moderati, mentre Event eccelle in presenza di molte connessioni parallele. Questa classificazione aiuta a prendere decisioni coerenti per il proprio ambiente. Offro un confronto più approfondito all’indirizzo Evento vs. Lavoratore.
| MPM | Gestione del Keep-Alive | Thread/Processi | Requisiti di RAM | Adatto per |
|---|---|---|---|---|
| Preforcella | Processo si blocca al minimo | Solo processi | Alto | PHP legacy senza thread safety |
| Lavoratore | Thread spesso rimane legato | Processi + thread | Medio | Carico moderato, configurazioni semplici |
| Evento | Ciclo di eventi memorizza i socket inattivi | Processi + thread | Da basso a medio | Molti client, fasi di keep-alive prolungate |
Scenari applicativi tipici
Utilizzo Event MPM quando ci sono molte operazioni parallele Clienti richieste con payload di piccole e medie dimensioni. I blog ad alto traffico, gli shop online con caching, le risorse statiche e gli endpoint API ne traggono notevoli vantaggi. Lo stesso vale per le configurazioni di hosting con molti siti web per server, in cui predominano le connessioni Keep-Alive. La coda degli eventi mantiene basso il numero di thread attivi e distribuisce il carico di lavoro in modo uniforme. Chi utilizza HTTP/2 ne trae ulteriore vantaggio, poiché una singola connessione può trasportare più flussi, mentre il livello degli eventi coordina gli stati in modo ordinato.
Event dimostra i propri punti di forza anche nelle topologie con proxy inverso. Affido ad Apache la gestione delle connessioni SSL, la memorizzazione nella cache e l'inoltro delle richieste a un livello applicativo. La gestione delle connessioni rimane così snella, il che allevia i colli di bottiglia. Anche in caso di picchi di traffico, i tempi di risposta rimangono sotto controllo, a condizione che i limiti siano impostati in modo oculato. Ciò riduce il rischio di Coda-Congestione e timeout.
Configurazione: direttive chiave
Per formulare un giudizio fondato, per prima cosa verifico ServerLimit, StartServers, ThreadsPerChild e MaxRequestWorkers. La regola empirica: ServerLimit × ThreadsPerChild dovrebbe essere vicino a MaxRequestWorkers, con un margine per la manutenzione e la crescita. Un valore troppo basso limita il parallelismo, mentre uno troppo alto fa lievitare il fabbisogno di RAM. Impostiamo KeepAlive su On, ma dimensioniamo KeepAliveTimeout in modo moderato, affinché l’inattività non degeneri. Valori compresi tra pochi secondi e un numero basso a due cifre spesso funzionano bene, a seconda del profilo di traffico.
Inoltre, tengo conto dei timeout per la lettura, la scrittura e i proxy. Valori più brevi proteggono dai backend bloccati, mentre quelli più lunghi aiutano in caso di client che rispondono con lentezza, il che Scambi di opinioni è necessario. Per i file statici, conviene inviarli in blocchi più grandi e utilizzare catene di filtri efficienti. Con PHP tramite FPM o bilanciatori di carico, scalo i worker di backend in base al parallelismo del frontend. Documento ogni modifica e ne misuro l'effetto prima di procedere.
Ottimizzazione della coda degli eventi: passo dopo passo
Inizio con una chiara profilo di carico: connessioni simultanee, richieste al secondo, dimensioni delle risposte, percentuali di Keep-Alive. Successivamente imposto MaxRequestWorkers in modo che la CPU non rimanga inattiva, ma la RAM sia comunque sufficiente. Regolo il valore di `ThreadsPerChild` fino a quando i picchi di carico vengono gestiti senza tempi di attesa. Calibro il valore di `KeepAliveTimeout` per ottenere un buon equilibrio tra esperienza utente (UX) e risparmio di risorse. Chi desidera comprendere più a fondo il comportamento delle code, può trovare le nozioni di base su Accodamento del server web.
Eseguo test iterativi con strumenti come ab, wrk o k6 e analizzo le latenze nei valori P50, P95 e P99. In questo modo osservo quando le connessioni rimangono in Keep-Alive e quando si chiudono. Un leggero sovradimensionamento dei thread aiuta ad assorbire brevi picchi senza sovraccaricare la macchina. Allo stesso tempo, controllo i log degli errori alla ricerca di messaggi come „server reached MaxRequestWorkers“. In questo modo ottengo un armonioso Interazione tra la coda degli eventi e il pool di worker.
Monitoraggio e metriche
Metriche efficaci garantiscono un’affidabile Capacità. Attivo mod_status e monitoro i worker attivi, inattivi e in attesa. Il quadro di controllo mostra se ci sono richieste in attesa o se le risorse sono libere. Inoltre, misuro il numero di processi e thread, l’utilizzo della RAM e l’I/O di rete. Un’analisi visiva aiuta a individuare tendenze e punti di svolta. Maggiori dettagli sono disponibili nel Apache Scoreboard.
Metto in relazione questi valori con i log di accesso e i codici di errore. Se i tassi di errori 5xx aumentano in concomitanza con un carico massimo, spesso i limiti sono troppo bassi. Se i timeout aumentano, controllo i servizi di backend, la risoluzione DNS e i percorsi di rete. In caso di carico elevato, verifico anche i backlog TCP e le ritrasmissioni SYN. In questo modo riesco a capire se il Causa nel server web, nel backend o nella rete.
HTTP/2, proxy inverso e moduli
HTTP/2 raggruppa più flussi in un’unica connessione, il che Evento-Architettura ideale. Mi assicuro che vi sia un equilibrio tra i limiti degli stream e il thread pool, in modo che molti piccoli stream non finiscano in coda. Come proxy inverso, Apache beneficia di timeout ridotti e connessioni affidabili al backend. Tuttavia, i moduli che operano in modo fortemente bloccante possono occupare thread e ridurre i vantaggi. Verifico quindi la compatibilità e sostituisco i componenti obsoleti se generano picchi di latenza.
I moduli di cache e la compressione aumentano l'efficienza, purché i profili della CPU siano adeguati. L'ottimizzazione TLS con algoritmi di crittografia moderni e la prioritizzazione HTTP/2 contribuiscono a una distribuzione più rapida. Utilizzo il ripristino della sessione e monitoro i costi dell’handshake sotto carico. Per le risorse statiche, gli approcci zero-copy e sendfile funzionano bene. Il Arte consiste nel mantenere snella la catena composta da TLS, Event Queue, Worker e backend.
Flusso interno e stati nell'evento MPM
Per comprendere i processi interni, ragiono in termini di condizioni: accept → readable → processing → writable → keep-alive → close. I thread listener monitorano i socket utilizzando meccanismi efficienti del kernel (epoll/kqueue) e attivano i worker solo quando si verifica un evento. Dopo l’elaborazione di una richiesta, il livello eventi decide se la connessione debba essere messa in stand-by in modalità Keep-Alive, chiusa direttamente o portata a termine con una chiusura simile al „lingering close“, in modo che i pacchetti TCP in ritardo vengano elaborati correttamente. Questo automatismo a stati impedisce il „busy waiting“ e riduce al minimo i cambi di contesto.
In questo contesto è importante distinguere tra Tempo di attesa I/O e il carico della CPU: l'analisi delle richieste, le pipeline di filtraggio (ad es. la compressione) e la generazione della risposta vengono eseguite nei thread di lavoro. La semplice attesa della disponibilità in lettura/scrittura rimane nel ciclo degli eventi. In questo modo Apache sfrutta meglio i thread disponibili e riduce il Densità dei fili per ogni connessione aperta, in modo drastico.
Prendo inoltre in considerazione il comportamento dello scoreboard: in mod_status è possibile leggere fasi come „R“ (Reading), „W“ (Sending Reply), „K“ (Keepalive) e „G“ (Gracefully finishing). Un’elevata percentuale di „K“, in presenza di worker liberi, indica che la coda degli eventi viene gestita correttamente e non spreca thread. Se i tempi „R“ aumentano in modo significativo, ciò indica che ci sono client lenti o timeout di lettura troppo restrittivi, il che suggerisce un potenziale di ottimizzazione.
Pianificazione delle risorse: esempio di calcolo e impostazioni predefinite consigliate
Calcolo il Parallelismo composto da CPU, RAM e carico di lavoro. Un esempio: 8 vCPU, 16 GB di RAM, contenuti principalmente memorizzati nella cache e PHP-FPM nel backend. Parto con MaxRequestWorkers tra 512 e 768, ThreadsPerChild tra 32 e 64 e ServerLimit di conseguenza tra 8 e 12. Prevedo 1–3 MB di overhead di Apache più i moduli per ogni worker attivo, a cui si aggiungono il buffer di risposta, l’overhead TLS e i socket del backend. Realisticamente, riservo 4–8 GB per i processi/thread di Apache, 2–4 GB per la cache del sistema operativo e il resto per i backend. Mi assicuro che ServerLimit × ThreadsPerChild non sia mai inferiore a MaxRequestWorkers; è opportuno lasciare un po’ di margine.
Panoramica delle linee guida utili: – MinSpareThreads/MaxSpareThreads: Mantieni la riserva in modo tale che i picchi di carico vengano assorbiti senza „avvio a freddo“, ma senza che troppi thread inattivi occupino memoria. – MaxConnectionsPerChild (alias MaxRequestsPerChild): un ciclo di vita finito per ogni processo contribuisce a evitare la frammentazione della memoria e le perdite di memoria durante il funzionamento a lungo termine (ad es. 5k–20k). – MaxKeepAliveRequests: Limita il numero di richieste per connessione; valori moderati proteggono dalle sessioni „infinite“ senza compromettere i vantaggi del Keep-Alive (ad es. 100–1000). – Timeout, Timeout di lettura/scrittura e ProxyTimeout: Evitare i blocchi; imposta valori differenziati a seconda del contesto, invece di adottare un approccio globalmente troppo prudente.
Per i file statici utilizzo EnableSendfile e Abilita MMAP A proposito: sui dischi locali entrambi possono offrire dei vantaggi; nei volumi NFS/cloud spesso disattivo sendfile per evitare casi limite. Nei percorsi TLS, sendfile ha un effetto minore per sua natura, poiché i dati passano attraverso pipeline di crittografia; in questo caso conta soprattutto un’efficiente Catena di filtri.
Limiti del sistema operativo e della rete
Anche la migliore architettura per gli eventi serve a poco se i limiti del sistema operativo ne frenano le prestazioni. Verifico: – Descrittori di file (ulimit -n): Il valore dovrebbe essere ben al di sopra del numero massimo di connessioni simultanee più i socket del backend; per gli host molto trafficati sono comuni diverse decine di migliaia. – AscoltareBacklog: Un backlog di accettazione sufficientemente ampio impedisce il rifiuto dei pacchetti SYN nei momenti di picco. – Backlog del kernel (ad es. somaxconn) e le code SYN: devono corrispondere alla velocità di „burst“ prevista. – Buffer di rete (rmem/wmem): Non sovradimensionare, ma dimensionare in modo tale che i percorsi con RTT elevato o a larga larghezza di banda non subiscano collassi.
Distribuisco il carico di accettazione utilizzando più thread di ascolto e, di norma, lascio che sia la piattaforma a scegliere il meccanismo di accettazione (AcceptMutex auto). Sui sistemi che lo supportano, è possibile SO_REUSEPORT (a seconda della piattaforma, tramite un'opzione dell'elenco) livellare i percorsi di accettazione. È importante evitare situazioni di "thundering herd", in cui molti thread competono per la stessa accettazione.
Anche Porte TCP effimere (ip_local_port_range) e il comportamento TIME-WAIT devono essere adeguati al numero di connessioni proxy parallele. Evito modifiche aggressive, ma effettuo test realistici e mi assicuro che i backend utilizzino il Keep-Alive, in modo che le connessioni possano essere riutilizzate e si verifichino meno cambi di porta.
Aspetti avanzati del reverse proxy: pool di connessioni e backend
In qualità di proxy inverso, le prestazioni complessive dipendono in larga misura dalla stabilità delle connessioni al backend. Mi assicuro che Connessioni proxy Mantenere la connessione persistente (Keep-Alive verso il backend) e dimensionare i pool del backend in modo che seguano il parallelismo del frontend. Pool troppo piccoli causano un ingorgo nel frontend, mentre quelli troppo grandi generano un carico superfluo sull'app.
Misure concrete: – ProxyTimeout: Più brevi per i percorsi non critici, più lunghi per gli endpoint „costosi“ – occorre differenziare, non applicare regole generali a tutti. – Equilibratore-Impostazioni (per mod_proxy_balancer): pesi, numero massimo di connessioni per backend, intervalli di ritentativo in base allo stato di salute. – mod_proxy_fcgi per PHP-FPM: L'FPM-pm.*- I valori (pm.max_children, pm.start_servers ecc.) devono essere adeguati al parallelismo di Apache per evitare picchi di errori 502/504.
Mi assicuro che gli errori del backend vengano segnalati in modo chiaro e tempestivo, invece di intasare i thread del frontend. I controlli di integrità, una politica di riprova prudente e modelli simili ai circuit breaker mantengono stabili le latenze. Ove possibile, mi assicuro che Caching delle risposte nei punti opportuni, in modo che l'evento MPM possa inviare soprattutto risposte brevi e concise.
Ottimizzazione di HTTP/2 in Event
Per HTTP/2, oltre a TLS, ottimizzo soprattutto Limiti di streaming e l'assegnazione dei worker. La presenza di molti piccoli stream per connessione può ridurre la latenza, ma aumentare il carico sui thread. Impostiamo il numero massimo di stream per sessione in modo tale che il multiplexing sia efficace, ma senza che si verifichi un effetto „head-of-line“. Inoltre, aumento il numero di worker in modo prudente, in modo da attenuare le fasi di picco senza sovraccaricare la RAM.
Ho notato che spesso gli stream rimangono in attesa, anche se i thread sono liberi. In questi casi, di solito sono i limiti degli stream o le dimensioni dei buffer a limitare la velocità di trasmissione. Una Definizione delle priorità Le risorse critiche (ad esempio CSS/JS tramite priorità HTTP/2) incidono direttamente sulle prestazioni percepite. Dal punto di vista del TLS, la ripresa della sessione, i meccanismi simili allo 0-RTT (purché sicuri e disponibili) e i moderni algoritmi di cifratura riducono i costi dell’handshake.
Robustezza: timeout, protezione contro Slowloris e spegnimento graduale
Attivo mod_reqtimeout, per mitigare i modelli simili a quelli dello slow loris. I timeout di lettura impediscono ai client di inviare byte a passo di lumaca, occupando così le risorse. I timeout di scrittura proteggono dalle connessioni lente verso il client. Questi valori devono essere scelti in base al contesto: le API richiedono profili diversi rispetto ai download di file di grandi dimensioni.
Per i rollout e i riavvii mi affido a Grazioso-Processi. Con un timeout graduale ben impostato, i vecchi processi si chiudono in modo controllato mentre quelli nuovi subentrano. In questo modo le connessioni keep-alive rimangono stabili e la coda degli eventi smaltisce il carico residuo senza interruzioni brusche. Log a rotazione, basso livello di verbosità dei log nei momenti di picco (ad es. „info“ anziché „debug“) e, facoltativamente, BufferedLogs riducono sensibilmente il carico I/O.
Rilevamento dei guasti sotto carico: individuare gli schemi ricorrenti
Sintomi tipici e approcci terapeutici: – Elevata P95/P99- Latenze con worker liberi: si tratta per lo più di tempi di attesa del backend o della rete; verificare i timeout del proxy e di lettura, nonché i pool del backend. – „server reached MaxRequestWorkers“: parallelismo insufficiente – aumentare MaxRequestWorkers e/o ThreadsPerChild, verificare l’impronta di RAM. – Molti Mantenere in vita-Connessioni, pochi thread attivi, ma comunque lento: spesso moduli/filtri che causano blocchi o colli di bottiglia nel backend; eseguire il profiling della catena di filtri, verificare la saturazione della CPU e l'I/O. – Picchi 5xx con carico TLS correlato: handshake CPU-bound – ottimizzare i cipher, il ripristino della sessione e, se necessario, l’offload.
Elimino i colli di bottiglia lungo la catena: accettazione dei socket (backlog), ciclo degli eventi (stati di attesa), worker (limitati dalla CPU), filtri (limitati dall’I/O), proxy (limitati dal backend). Questo modello concettuale mi impedisce di modificare il valore di MaxRequestWorkers, anche se in realtà è il backend a essere limitante.
Lista di controllo pratica e ostacoli tipici
Lavoro con una breve Lista di controllo: versione Apache aggiornata, MPM Event attivo, limiti correttamente dimensionati, timeout adeguati. Successivamente verifico i tassi di Keep-Alive e la relazione tra connessioni e thread attivi. Controllo che i moduli garantiscano la thread-safety e che i filtri non causino blocchi prolungati. Per PHP tramite FPM, mi assicuro che i worker FPM siano adeguati al parallelismo del frontend. Allo stesso modo, calibro i limiti del sistema operativo come i descrittori di file, il backlog TCP e i parametri del kernel per i buffer di rete, in modo che il Condotte non si blocchi.
Riesco a individuare rapidamente gli ostacoli più comuni: KeepAliveTimeout troppo lunghi, MaxRequestWorkers troppo ridotti, ThreadsPerChild troppo bassi o una registrazione degli eventi inadeguata. Una registrazione degli eventi eccessivamente dettagliata consuma risorse I/O e rallenta le risposte. Una dimensione del pool del backend del proxy troppo piccola vanifica l’ottimizzazione del frontend. Le configurazioni TLS errate prolungano inutilmente gli handshake. Chi risolve questi punti in modo accurato, crea un affidabile La base per latenze costanti.
Sintesi per i responsabili tecnici
Event MPM separa nettamente la gestione delle connessioni dall'esecuzione e punta su una Coda degli eventi, che gestisce in modo efficiente le connessioni inattive. In questo modo, Apache è in grado di scalare in presenza di molti client simultanei senza lasciare thread in sospeso. Il giusto equilibrio tra MaxRequestWorkers, ThreadsPerChild e timeout ben ponderati tiene sotto controllo la latenza e il consumo di RAM. Grazie a un monitoraggio continuo, a test di benchmark e a poche modifiche mirate, si ottiene un sistema in grado di assorbire i picchi di traffico e di rispondere in modo coerente. Chi fa propri questi principi, ottiene il massimo dal proprio Apache- L'installazione offre molto di più, pur rimanendo compatibile con le applicazioni e i protocolli più diffusi.


