
Rapporti CloudLinux mi mostrano chiaramente quali limiti LVE interessano i singoli account e dove la CPU, la memoria, l'I/O o i processi di ingresso costituiscono effettivamente un collo di bottiglia. Analizzo questi dati in modo mirato per individuare errori ricorrenti, andamenti giornalieri e colli di bottiglia acuti, e per ricavarne ottimizzazioni concrete.
Punti centrali
Riassumo qui di seguito i punti salienti, in modo che tu possa iniziare l'analisi con maggiore chiarezza.
- Indicatori LVE Leggi bene: SPEED, MEM, IO, IOPS, PNO, EP
- Dati in tempo reale verificare con LVE Manager e lvetop
- Cronologia tramite lveinfo, lvechart, cloudlinux-statistics
- Errori stabilire le priorità: frequenza, momento, causa
- Misure derivare per CPU, RAM, I/O, EP
Come interpretare correttamente gli indicatori chiave: SPEED, MEM, IO, IOPS, PNO, EP
Inizio ogni analisi con i Cifre chiave, che CloudLinux riporta nel contesto LVE. SPEED descrive la potenza di calcolo della CPU assegnata, MEM indica il consumo di RAM, IO il throughput dei dati e IOPS il numero di operazioni di I/O. PNO mostra il numero totale di processi in esecuzione, EP i processi di ingresso simultanei che limitano gli accessi al web. Chi osserva valori costantemente elevati, di solito non ha un problema di picchi momentanei, ma un profilo di carico strutturale. In questi casi verifico sempre se i limiti vengono raggiunti in modo continuativo o se si verificano solo singoli picchi isolati, che possono essere spiegati senza ricorrere alla limitazione.
| Figura chiave | Significato | Sintomi tipici | Primi controlli |
|---|---|---|---|
| SPEED | Prestazioni della CPU (percentuale/limite) | Tempi di esecuzione PHP prolungati, timeout | Verifica dei profili PHP, della cache dell'opcode e della memorizzazione nella cache |
| MEM | Memoria di lavoro per account | OOM-Kills, errore 500 sotto carico | Verifica di memory_limit in PHP, plugin e query |
| IO | Velocità di trasferimento in MB/s | Download/upload lenti | Cache statica, compressione dei file multimediali, archiviazione |
| IOPS | Numero di operazioni I/O | Accessi lenti alla banca dati/ai file | Indici, piano di query, cache degli oggetti |
| PNO | Processi complessivi | Aumento del carico del server | Eccedenze di daemon/cron, limiti dei worker |
| EP | Accessi simultanei al sito web | Errore 503 in Peaks | Verifica della cache HTTP, dei limiti di velocità e dei bot |
Monitoraggio in tempo reale con LVE Manager e lvetop
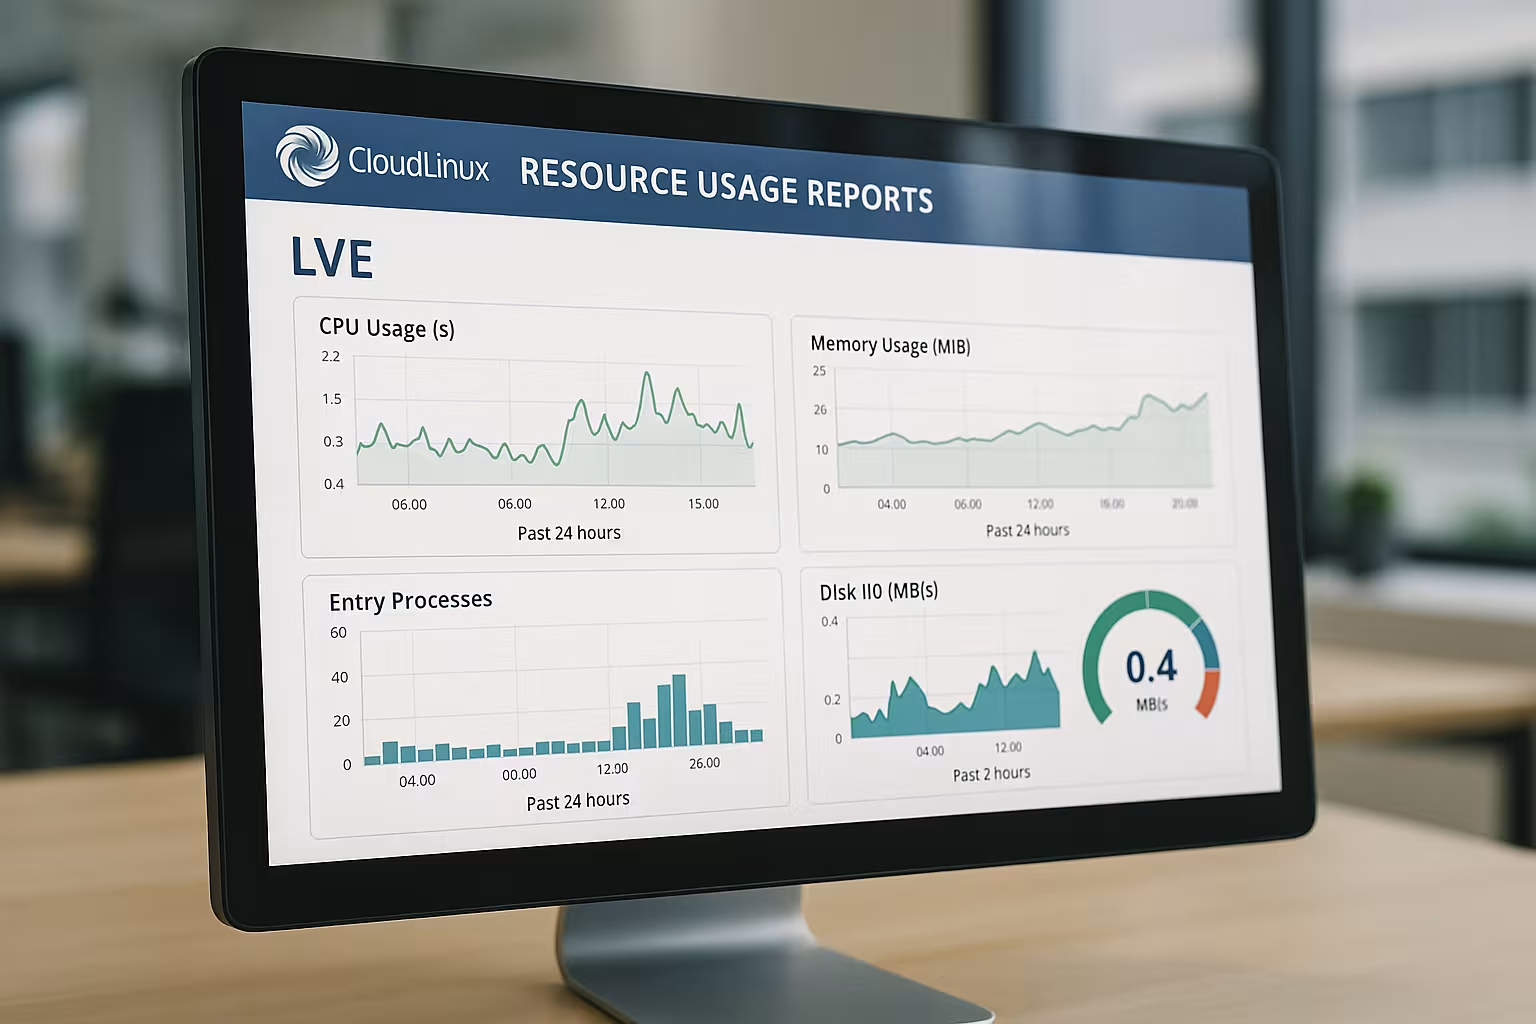
Per le analisi immediate utilizzo il Dati in tempo reale in LVE Manager e lvetop nella shell. La vista “Current Usage” mi mostra in tempo reale l’andamento di CPU, RAM, I/O, IOPS, processi e Entry Processes. In caso di picchi di carico, osservo se sono gli EP o lo SPEED a raggiungere per primi il limite, poiché ciò influenza i passi successivi. lvetop è utile per individuare immediatamente gli account più "rumorosi" e, se necessario, limitarli o ottimizzarli. Chi desidera approfondire l’interfaccia può personalizzare in modo mirato i limiti e le visualizzazioni: a tal fine mi piace utilizzare questa guida: Configurare LVE Manager.
Analisi storica: lveinfo, lvechart e cloudlinux-statistics
Riconoscere le tendenze tramite Cronologia e la cronologia degli errori, non solo attraverso istantanee. Con lveinfo definisco delle fasce orarie e vedo quando i limiti sono stati attivati esattamente e con quale frequenza ciò è avvenuto. lvechart mi fornisce grafici visivi dei picchi nell’arco di ore o giorni, rendendo visibili i modelli di attività nell’arco della giornata. cloudlinux-statistics completa l’analisi quando ho bisogno di serie temporali più lunghe per ogni account. Da questa combinazione ottengo risposte alle domande „quando“, „con quale frequenza“ e „in quali condizioni“ si verificano i picchi di carico.
Comprendere e classificare per priorità i guasti
Un errore significa che: Il Limite È stato rilevato un errore e CloudLinux ha limitato la larghezza di banda. Per questo motivo ordino gli errori prima in base alla frequenza, poi in base al tipo di risorsa e all’ora del giorno. Gli errori EP giornalieri a mezzogiorno indicano spesso picchi di traffico o bot, mentre gli errori RAM notturni sono solitamente legati ai cronjob e ai backup. Se si verificano molti errori CPU, cerco routine PHP inefficienti, cache difettose o attività non limitate. Questa classificazione mi fa risparmiare tempo, perché mi permette di intervenire con ottimizzazioni proprio dove gli utenti subiscono limitazioni tangibili.
Individuare le cause: schemi tipici e contromisure
In base alla mia esperienza, classificherei Campione identifica rapidamente le cause concrete. Valori EP costantemente elevati indicano un numero eccessivo di richieste simultanee o la mancanza di caching edge. Un consumo di RAM persistentemente elevato è spesso dovuto a plugin, temi o processi che consumano risorse in modo incontrollato. I picchi di I/O e IOPS indicano attività ad alta intensità di dati, query non indicizzate o numerosi accessi a file di piccole dimensioni. Per evitare interpretazioni errate, controllo parallelamente gli indicatori di integrità del sistema: un rapido approccio iniziale è possibile con i Controlli di integrità di CloudLinux.
Riconoscere cronjob, backup e bot
Per capire molte delle serie di errori basta dare un’occhiata a Punti nel tempo e attività. Se la limitazione si verifica sempre poco dopo l’ora piena, spesso ci sono cronjob in esecuzione in parallelo che entrano in competizione con i visitatori. I picchi ricorrenti durante la notte indicano spesso backup che sfruttano al massimo l’I/O e gli IOPS. EP-Fault evidenti senza traffico corrispondente in Analytics indicano spesso la presenza di bot o scraper che aggirano i contenuti statici. In questi casi, imposto limiti di velocità, sposto i processi in fasce orarie meno trafficate e attivo sistematicamente le cache edge o di pagina.
Analizzare i dati per rivenditore e account
Nelle configurazioni più grandi, separo il Livelli Chiaro: i rivenditori, i loro clienti e i singoli account. LVE Manager offre proprio questa visione d’insieme e mi mostra quale sottoalbero sta determinando il superamento dei limiti. In questo modo posso capire se è un singolo cliente a destare sospetti o se sono più progetti appartenenti alla struttura di un rivenditore a incidere contemporaneamente. Per i processi di assistenza, seleziono gli account interessati e definisco le misure da adottare, in modo da risolvere più rapidamente i ticket ricorrenti. Questa trasparenza aiuta a distribuire equamente le risorse e a mantenere tracciabili i costi per ogni cliente.
Dimensionare correttamente i valori limite e adeguare le tariffe
Sono io a stabilire i limiti Realistico, non al massimo. Limiti EP troppo stretti generano errori 503, mentre valori SPEED troppo bassi rallentano ogni risposta PHP. Chi riscontra regolarmente errori dovrebbe verificare innanzitutto le ottimizzazioni e poi i piani tariffari. Quando i progetti diventano critici per l’azienda, vale la pena optare per un profilo più elevato, che attenui i picchi e garantisca stabilità. Documento gli effetti nei grafici cronologici, in modo che la decisione rimanga comprensibile.
Progetti che fanno ampio uso di database: ottimizzazione di I/O e IOPS
Nel caso di siti basati su database, verifico IOPS e l'IO è sempre correlato alla qualità delle query. Molte piccole query senza indici generano un elevato numero di IOPS e rallentano i tempi di risposta. L'esperienza dimostra che la cache degli oggetti, il caching delle query e gli indici ottimizzati riducono notevolmente questo flusso. Per le analisi di tendenza, leggo inoltre i report del database e li confronto con l’andamento degli LVE. Questa guida mi fornisce un’introduzione approfondita su Rapporti del MySQL Governor, per classificare correttamente il carico del database.
Manuale di monitoraggio: dall'allarme all'azione
A partire dai valori misurati, elaboro un Playbook, che illustra chiaramente ogni escalation. Fase 1: verificare in tempo reale se i limiti sono attualmente attivi e quale risorsa va in tilt per prima. Fase 2: aprire la cronologia, allineare le finestre temporali ed evidenziare le ripetizioni. Fase 3: Individuare la causa – percorso di codice, cache, database, cron, bot – e definire una contromisura con criteri di test. Fase 4: dopo l’intervento, verificare nuovamente in produzione e nella cronologia se i guasti e la latenza diminuiscono. Questa sequenza fissa evita l’azione impulsiva e garantisce risultati riproducibili.
Interpretare correttamente le interdipendenze dei limiti
Nella pratica, i limiti raramente si applicano in modo isolato. Per questo motivo valuto il Interazioni tra EP, SPEED, MEM e IO/IOPS: se EP e SPEED aumentano contemporaneamente, di solito è la CPU a costituire il limite per ogni richiesta; in questo caso, una cache di pagina o di bordo può essere d’aiuto, poiché entrambi gli indicatori diminuiscono insieme. Se osservo un aumento di EP con SPEED costantemente basso, le richieste si accumulano nel server web, spesso a causa di una carenza di worker, configurazioni Keep-Alive o chiamate esterne bloccanti (ad es. API, posta elettronica). Gli errori MEM con una velocità moderata indicano la presenza di pochi processi, ma che richiedono molta memoria (come la conversione di immagini o esportazioni di grandi dimensioni). I picchi di IO/IOPS senza un carico significativo sulla CPU indicano accessi a file o database ad alta intensità di dati. Utilizzo queste correlazioni per prima ipotesi prima di addentrarmi nei dettagli del codice o del server.
Esercitazione pratica: utilizzare in modo efficiente lvetop, lveinfo e cloudlinux-statistics
Per ottenere risultati rapidi, lavoro con chiari Domande e filtrare. lvetop mi aiuta a visualizzare ogni secondo i principali consumatori e a passare dall’ordinamento per CPU, MEM o IO. Con lveinfo definisco finestre di 1 ora, 24 ore e 7 giorni per elencare i momenti in cui si sono verificati gli errori, i valori di picco e le risorse interessate per ogni account. cloudlinux-statistics mi fornisce serie temporali più lunghe ed è utile per documentare le misure adottate (prima/dopo). Per ogni intervento documento sempre: periodo di tempo, account interessati, valori massimi per ciascuna risorsa, numero di guasti e tempi di risposta ricavati dal monitoraggio delle applicazioni o del web. In questo modo posso documentare le ottimizzazioni ed evitare che i limiti vengano allentati „a caso“.
Aspetti dettagliati dello stack web: handler PHP, worker e OPcache
Un importante fattore di influenza risiede nel Esecuzione PHP: Numero di worker PHP per account, il loro budget di RAM (memory_limit) e l’OPcache. Troppi worker senza cache aumentano EP/PNO e MEM, mentre troppo pochi worker causano un accumulo di richieste (l’EP cresce, il tempo di risposta aumenta). Cerco quindi di individuare un punto di equilibrio: tanti worker quanti ne servono, ma il minor numero possibile. L’OPcache deve essere dimensionata in modo adeguato (memoria e stringhe interne), altrimenti PHP ricompila continuamente e fa aumentare SPEED. Inoltre, verifico se le risorse statiche vengono effettivamente gestite dal server web (e non da PHP) e se il Keep-Alive e il multiplexing HTTP/2 funzionano correttamente. L’obiettivo è quello di gestire le richieste dinamiche in modo da ridurre e di sbrigare rapidamente quelle rimanenti.
Applicare con coerenza le strategie di caching
Distinguo tre livelli: Cache Edge/CDN per un alleggerimento globale, Cache HTTP/pagina proprio prima di PHP e Cache degli oggetti all'interno dell'applicazione. La cache Edge riduce drasticamente l'EP e l'IO per le risorse statiche. La cache di pagina riduce gli accessi dinamici e influisce direttamente sull'EP/SPEED. La cache degli oggetti (ad es. per le ricerche frequenti nel database) riduce gli IOPS e il carico della CPU. È importante che sia stabile Chiave della cache (ad es. nessun cookie superfluo) e TTL adeguati per ogni tipo di pagina. Prevedo delle eccezioni per le aree di amministrazione o del carrello; in tutti gli altri casi, punto a ottenere una percentuale di cache il più alta possibile. Dopo l’attivazione, osservo: si verificano errori EP? I tempi di risposta mediani si riducono?
Gestione della RAM: memory_limit, processi e perdite di memoria
Gli errori MEM si verificano spesso perché limite_di_memoria è impostato in modo generoso e i processi paralleli superano il limite. Pertanto, valuto: quanta RAM serve per una richiesta tipica? Da questo deduco il numero massimo ragionevole di worker. Inoltre, mantengo snelle le librerie PHP e i plugin, rimuovo le estensioni inutilizzate e controllo la presenza di perdite negli script a esecuzione prolungata (esportazioni, importazioni, elaborazione delle immagini). L’OPcache riduce la pressione sulla RAM quando memorizza temporaneamente i codici compilati, ma non deve essere dimensionato in modo troppo ridotto. In caso di picchi ricorrenti, attraverso il profiling isolo i percorsi „costosi“ e intervengo in modo mirato: questo spesso consente di risparmiare RAM più che un aumento generico dei limiti.
Ridurre in modo mirato gli I/O e gli IOPS
I picchi di IO/IOPS sono causati da numerosi piccoli accessi a file o database. Ove possibile, raggruppo i carichi di lavoro: generazione di miniature in batch anziché su richiesta, minimizzazione delle risorse durante la compilazione anziché a ogni richiesta, memoria di sessione e transitoria in un unico Cache degli oggetti esternalizzare, in modo da ridurre il numero di accessi ai file. Nel database do priorità agli indici per le clausole WHERE/JOIN più frequenti ed elimino le query N+1. Parallelamente, confronto gli andamenti LVE con i report del database generati da MySQL Governor per individuare i punti critici. L’obiettivo è trasformare molte piccole operazioni IOPS in pochi accessi efficienti: ciò attenua i picchi e riduce la probabilità di guasti.
Risolvere i problemi legati all'EP: accodamento e flussi di visitatori
EP limita gli accessi simultanei. Se molte richieste incontrano cache quasi vuote, gli errori EP si accumulano rapidamente. Lo evito facendo in modo che Code prima di eseguire il PHP (code di richiesta brevi nel server web), impostare il Keep-Alive in modo appropriato e far memorizzare in cache in modo coerente i percorsi dinamici non personalizzati. Per i bot definisco dei limiti di frequenza e blocco tempestivamente i "bad actors" evidenti. Inoltre, controllo le chiamate a terze parti nel percorso della richiesta: i servizi esterni che causano blocchi aumentano il tempo di permanenza per ogni richiesta e consumano così EP. Ove possibile, sposto le integrazioni esterne in job/code.
Pianificare i cronjob e i backup in modo da non sovraccaricare le risorse
Sgancio le attività ricorrenti dalle ore di punta e le regolo: distribuisco le tabelle Cron (spostandole di qualche minuto), impedisco l'esecuzione in parallelo tramite file di blocco e regolo il carico tramite Nicing e le dimensioni dei batch. Pianifico i backup in fasce orarie con traffico ridotto e mi assicuro di utilizzare procedure incrementali, in modo che IO/IOPS rimangano entro limiti accettabili. Per i processi in-app più impegnativi, imposto dei limiti al numero di worker simultanei, in modo che MEM e SPEED non aumentino in modo repentino. Ne verifico l’impatto nel corso del tempo: i fault notturni diminuiscono? I picchi di carico si riducono allo scoccare dell’ora?
CageFS: una panoramica sul file system e sugli inode
Oltre ai limiti LVE, influenzano Fattori relativi al file system Le prestazioni: milioni di file di piccole dimensioni (come i frammenti di cache) aumentano gli accessi ai metadati e fanno lievitare gli IOPS. Mantengo in ordine le directory della cache, limito il flusso di file tramite cache aggregate in modo razionale e controllo l’utilizzo degli inode. CageFS garantisce l’isolamento, ma i file temporanei collocati in modo errato (ad esempio nella directory webroot anziché nella directory tmp) aumentano inutilmente le operazioni di I/O. Un controllo periodico dello stato di queste aree impedisce che i colli di bottiglia di I/O vengano erroneamente interpretati come semplici problemi di CPU o RAM.
Trasparenza e comunicazione nel contesto dei rivenditori
Negli ambienti di rivendita, documento Driver di carico per ogni sottocomponente e registro le misure adottate: quali limiti sono stati fissati? Quali ottimizzazioni sono previste? Come si presentano i grafici “prima/dopo”? Questa trasparenza accelera le risposte dell’assistenza e favorisce l’accettazione di un cambio di tariffa quando il potenziale di ottimizzazione è esaurito. Stabilisco valori soglia oltre i quali interveniamo (ad es. guasti ricorrenti > N al giorno o tempo di risposta mediano > X ms) e li associo a percorsi d’azione chiari, in modo da evitare cicli infiniti nel sistema di ticket.
Evitare le interpretazioni errate più comuni
Ci sono alcuni modelli che noto regolarmente: l'aumento dell'utilizzo della CPU è non un messaggio automatico che segnala „CPU insufficiente“ – spesso le cache non funzionano o le query sono inefficienti. Un numero elevato di errori EP non implica necessariamente „maggiore traffico“: la causa può essere rappresentata da bot, strumenti di monitoraggio configurati in modo errato o heartbeat. Gli errori MEM non sempre possono essere risolti aumentando il valore di memory_limit: spesso la causa è un numero eccessivo di processi simultanei. I picchi di IO/IOPS non dipendono esclusivamente dallo storage: sono innescati dai modelli applicativi. Verifico quindi sempre le ipotesi con grafici correlati e, se possibile, con brevi test di verifica (ad es. attivando la cache per un sotto-settore e ricontrollando l’andamento).
Provare, misurare, affilare
Valuto ogni modifica con punti di misurazione ben definiti: prima/dopo l'attivazione della cache delle pagine, prima/dopo l'aggiornamento dell'indice, prima/dopo l'adeguamento dei worker. A tal fine utilizzo la cronologia LVE, le metriche dei tempi di risposta e i tassi di errore (5xx/4xx). Ove possibile, eseguo confronti A/B nelle ore di minor traffico per isolare le ripercussioni. Se gli errori persistono, ripeto il processo: ottimizzo la combinazione dei limiti, analizzo ulteriori percorsi critici, adeguo le dimensioni dei batch dei lavori. L’esperienza dimostra che due o tre cicli mirati forniscono risultati nettamente migliori rispetto a un’unica misura generica.
Sintesi: Ecco come leggo in modo efficiente i rapporti sull’utilizzo delle risorse di CloudLinux
Tasso CloudLinux- I dati sono sempre suddivisi in tre livelli: Live, Cronologia, Errori. Gli indicatori SPEED, MEM, IO, IOPS, PNO ed EP mi forniscono una mappa delle cause e degli effetti. Con lvetop vedo immediatamente chi sta generando il carico; con lveinfo e lvechart rilevo i modelli nel corso dei giorni. Dai Faults ricorrenti deduco le necessità di caching, ottimizzazione delle query, adeguamento dei limiti o cambio di tariffa. Questo metodo riduce il carico di lavoro dell’assistenza, aumenta la reattività e rende trasparente la performance dell’hosting.


