 Vai al contenuto

Mostrerò in modo pratico come l’affinità IRQ, sui sistemi multiprocessore, assegni in modo mirato gli interrupt di rete ai core della CPU, riducendo la latenza e aumentando la velocità di trasmissione. Attraverso passaggi chiari, esempi e una tabella, illustrerò come selezionare le maschere esadecimali, tenere conto della struttura NUMA e assegnare i processi in modo appropriato.
Punti centrali
- Affinità IRQ indirizza in modo mirato gli interrupt hardware alle CPU e riduce l'overhead.
- Affinità della CPU Fissare i servizi agli stessi core mantiene le cache locali.
- NUMA Si noti che l’adattatore e i core utilizzano lo stesso nodo.
- irqbalance valutare: distribuzione automatica o regolazione manuale di precisione.
- Monitoraggio e l'adattamento iterativo garantisce latenze stabili.
Comprendere l'affinità IRQ: nozioni di base ed effetti
Sugli host Linux, i pacchetti in entrata, l’I/O su disco e i timer IRQ che il kernel distribuisce tra i core della CPU. Tramite i file /proc/irq//smp_affinity e .../smp_affinity_list, quali CPU possono accedere a una sorgente. Una maschera standard ampia sembra inizialmente flessibile, ma in caso di carico genera cache miss, costosi cambi di contesto e softIRQ dispersi su molti CPU. Assegno le code critiche delle singole schede di rete a core definiti, alleggerisco il carico sugli hotspot e mantengo brevi i percorsi dei dati. Questa gestione migliora sensibilmente la stabilità non appena sono attivi contemporaneamente molti flussi.
Ottimizzazione dell’IRQ e dell’affinità della CPU: mantenere i dati in locale
Sono riuscito a collegare il IRQ-Gestione delle code NIC in base all'appartenenza alla CPU dei worker interessati. A tal fine, assegno i thread del server web o del proxy tramite set di compiti oppure CPUAffinity= in systemd su quei core che gestiscono anche gli interrupt RX/TX. In questo modo le cache line rimangono locali e riduco al minimo la comunicazione tra CPU, il che Latenza uniforma. Proprio i backend API, i servizi in tempo reale e gli stack virtualizzati traggono vantaggio da questa coerenza. Testo l’integrazione sotto carico di produzione finché i flussi, gli SoftIRQ e lo spazio utente non si integrano perfettamente tra loro.
Modalità automatica contro regolazione fine: come interpretare correttamente irqbalance
Il servizio irqbalance distribuisce automaticamente gli interrupt tra i core disponibili, il che funziona bene sui server generici. Tuttavia, in configurazioni di rete sottoposte a carico elevato, questa distribuzione riduce la località della cache e rende più difficile il pinning mirato. Limito l’irqbalance o lo disattivo in modo selettivo quando determinate code richiedono core fissi. Per una comprensione di base e per trovare i profili adatti, trovo utile questa guida su Configurare irqbalance. Di conseguenza, il sistema automatico gestisce gli IRQ non critici, mentre io assegno manualmente quelli sensibili.
Passaggio: rendere visibili gli IRQ rilevanti
Comincio con uno sguardo a /proc/interruzioni e filtra in base al nome del dispositivo, ad esempio ens192, eno1 oppure eth0. Gli adattatori moderni creano diverse code RX e TX, pertanto individuo un gruppo di numeri IRQ assegnati alla stessa scheda di rete. Presto attenzione ai valori dei contatori per individuare rapidamente i punti critici e assegnare per primi le code sottoposte a carico elevato. Controllo regolarmente questa panoramica durante i test di carico, in modo che l’assegnazione sia sostenibile nel tempo. Inoltre, verifico le denominazioni dei driver, poiché forniscono indicazioni sulle funzionalità RSS e sull’offloading.
# Visualizzare tutti gli interrupt
cat /proc/interrupts

# Visualizzare solo le righe relative alla scheda di rete (esempio: ens192)
grep -i ens192 /proc/interrupts
Utilizzare in modo intelligente la topologia NUMA
Sugli host con più nodi, preferisco trasferire gli IRQ sui core di quelli NUMA-Nodo a cui è fisicamente collegata la scheda di rete. Lo verifico con lscpu e numactl --hardware e contrassegno i set di CPU adeguati per la successiva creazione delle maschere. Anche i processi che utilizzano questi percorsi di rete li associo allo stesso nodo e, tramite le politiche di memoria, garantisco che Memoria-Assegnazioni. In questo modo evito costosi accessi remoti attraverso i collegamenti QPI/UPI. Questa disciplina porta rapidamente a vantaggi misurabili nei test di latenza.
Scegliere le maschere di bit in modo sicuro: la logica esadecimale in sintesi
Il file smp_affinity accetta maschere di bit esadecimali che corrispondono direttamente agli ID dei core e coprono anche sistemi di grandi dimensioni. Spesso inizio con modelli semplici: CPU0 è 0x1, CPU1 è 0x2, CPU2 è 0x4, CPU3 è 0x8 ecc., mentre 0xF comprende i core da 0 a 3. Su macchine con molti core scrivo più blocchi da 32 bit, separati da virgole, in modo che il Maschera riporta correttamente tutti gli ID. Questa panoramica mi aiuta a effettuare assegnazioni senza errori ed evitare spostamenti involontari. Utilizzo spesso la tabella seguente come promemoria.
| Numero della CPU | Bit (binario) | Maschera Hex | Suggerimento |
|---|---|---|---|
| 0 | …0001 | 0x1 | CPU0 spesso alleggerire il carico e utilizzarle con parsimonia. |
| 1 | …0010 | 0x2 | IRQ su CPU1 pinnen. |
| 2 | …0100 | 0x4 | Collegare l'IRQ alla CPU2. |
| 3 | …1000 | 0x8 | Collegare l'IRQ alla CPU3. |
| 0–3 | …1111 | 0xF | Se si attivano tutti e quattro i core, la latenza spesso aumenta leggermente. |
| 0–7 | 11111111 | 0xFF | Distribuzione ampia, la località della cache ne risente. |
Impostare l'affinità IRQ: come associare le code ai core
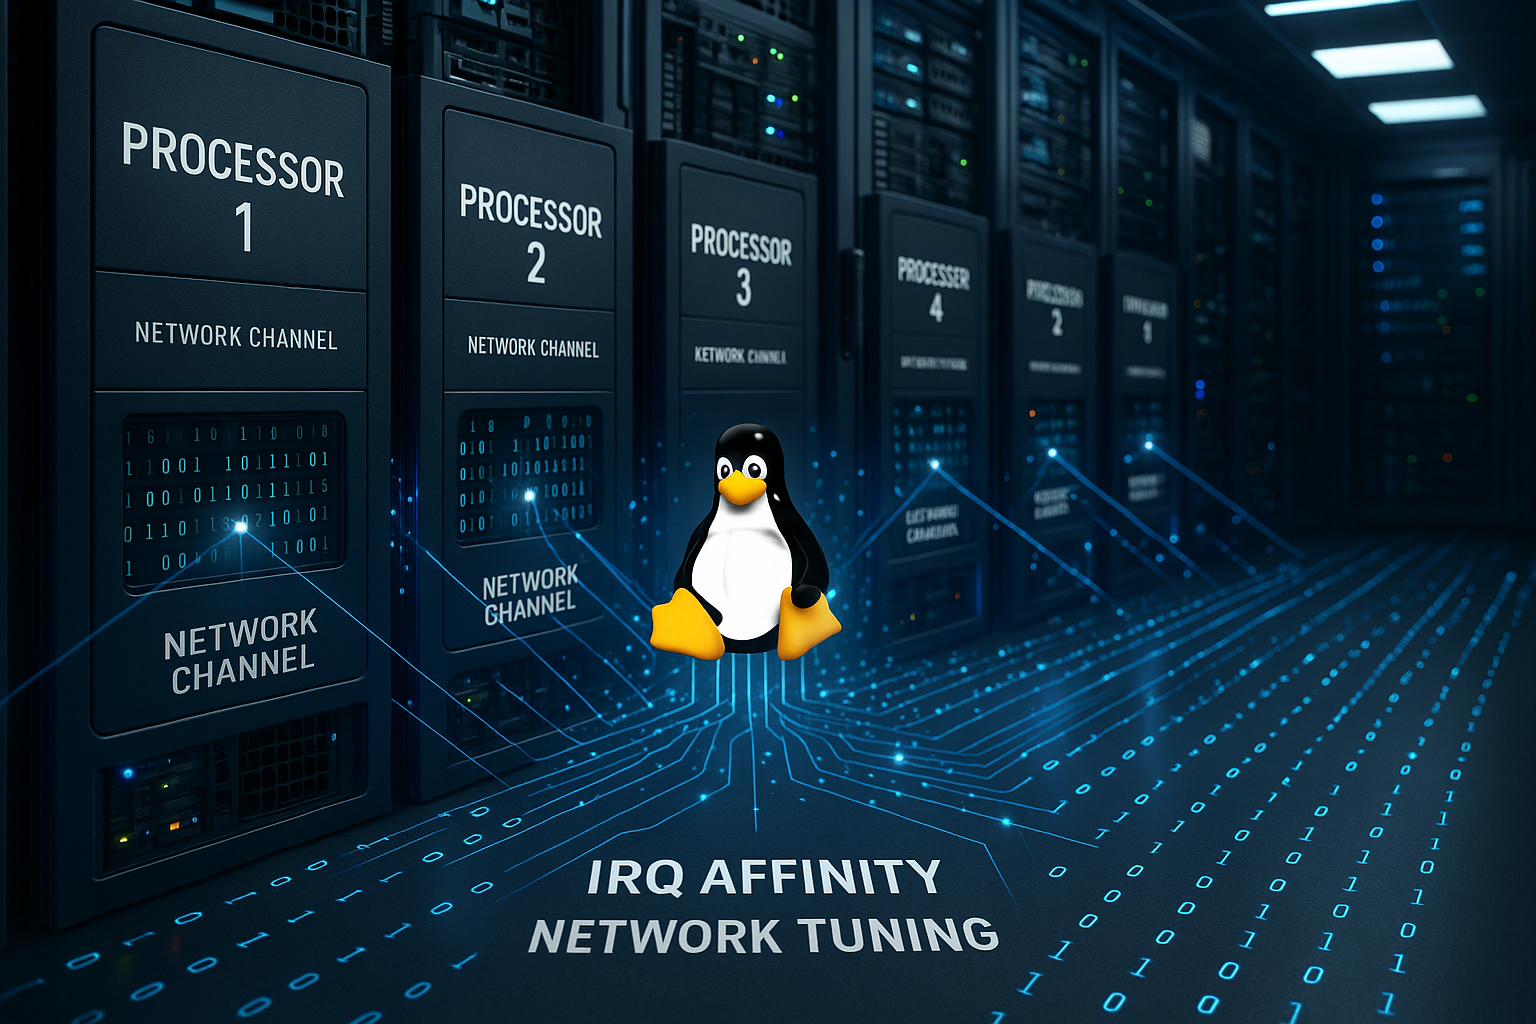
Dopo aver identificato gli IRQ in coda della scheda di rete, li distribuisco su canali dedicati Nuclei come 1, 2 e 3, per scalare correttamente l’elaborazione parallela. In questo modo ogni coda RX/TX rimane associata al proprio core, evitando il cross-talk e garantendo la coerenza del funzionamento degli SoftIRQ. Durante la messa a punto, confronto il throughput e la latenza finché la distribuzione non risulta affidabile. Per un approfondimento mi è d’aiuto un breve Guida pratica con varianti a seconda dell’adattatore. Eseguo i comandi appositamente durante le finestre di manutenzione e li metto in sicurezza tramite uno script di avvio.
Esempio #: associare tre IRQ di coda alle CPU 1-3
echo 2 > /proc/irq/181/smp_affinity   # CPU1 (0x2)
echo 4 > /proc/irq/182/smp_affinity   # CPU2 (0x4)
echo 8 > /proc/irq/183/smp_affinity   # CPU3 (0x8)
Process pinning: assegnare i servizi agli stessi core
Assegno i worker dell'applicazione a quelli CPU, che gestiscono gli IRQ corrispondenti, in modo che i percorsi dei dati rimangano brevi. Con systemd utilizzo CPUAffinity=1 2 3 oppure avvia una sola volta con taskset -c 1-3. Per i server multi-worker, assegno un numero fisso di core a ciascun gruppo di worker, in modo da evitare la concorrenza. Questo abbinamento garantisce valori costantemente più bassi Latenze, perché le cache della CPU rimangono adeguatamente piene. Dopo aver apportato delle modifiche, controllo i thread, i socket e gli SoftIRQ con htop, ss e perf.
Ottimizzazione della rete: integrare RSS, RPS/RFS e i parametri del kernel
Molte schede di rete distribuiscono i pacchetti tramite RSS sulle code, che poi associo ai core tramite l’affinità IRQ. Riassumo i dettagli e i principi di funzionamento nella sezione Receive Side Scaling in modo compatto. Inoltre, gestisco RPS/RFS in modo che gli SoftIRQ non interferiscano con la logica di pinning rigida. Parallelamente, regolo i buffer tramite net.core.rmem_max e net.core.wmem_max e controlla le opzioni TCP come tcp_timestamps. Questi elementi contribuiscono tutti allo stesso obiettivo: bassa latenza con elevata Velocità di trasmissione.
Interpretare correttamente MSI-X e la struttura delle code
Le schede di rete moderne utilizzano MSI-X e creano IRQ dedicati per ogni coda RX/TX. Per prima cosa verifico quante code e quanti canali siano attualmente attivati dal driver e li adeguo al budget di core del nodo NUMA corrispondente. In questo modo evito che un numero eccessivo di code si concentri su un numero insufficiente di core o, al contrario, che la capacità rimanga inutilizzata.
Verificare e regolare il numero di code e canali #
ethtool -l ens192 # limiti attuali (RX/TX/combinato)
ethtool -L ens192 combined 4  #, ad esempio, attivare 4 code

# Verificare l'indirezione RSS e l'impostazione dell'hash
ethtool -x ens192 # Visualizza la tabella di indirezione e la chiave hash
Molti driver assegnano nomi descrittivi agli IRQ (ad es. ens192-TxRx-0). Mantengo la tabella di indirezione coerente con l'assegnazione del core, in modo che i flussi vengano indirizzati in modo stabile verso la „loro“ coda. Se la distribuzione hardware differisce, si verificano spostamenti inutili degli SoftIRQ.
Utilizzare in modo coerente RPS/RFS e XPS
RPS/RFS può distribuire i pacchetti a livello software tra i core: una soluzione utile per le schede di rete che non dispongono di molte code, ma controproducente se ho già impostato un’associazione precisa tramite RSS e IRQ-Affinity. Pertanto, scelgo consapevolmente: o un’associazione rigida tramite RSS+IRQ-Affinity e RPS disattivato, oppure poche code hardware e RPS in modo mirato. Inoltre, configuro XPS per la direzione TX, in modo che i pacchetti in uscita vengano inviati dai core „giusti“.
IF=ens192

# Disattivare completamente l'RPS (in caso di pinning IRQ corretto tramite RSS)
for q in /sys/class/net/$IF/queues/rx-*/rps_cpus; do echo 0 > "$q"; done
echo 0 > /proc/sys/net/core/rps_sock_flow_entries

# In alternativa: attivare RPS in modo selettivo (esempio: CPU 1-3)
for q in /sys/class/net/$IF/queues/rx-*/rps_cpus; do echo 0-0,0-0,0-0,0-0 > /dev/null; done
# Meglio: utilizzare una sintassi simile a quella di smp_affinity_list:
for q in /sys/class/net/$IF/queues/rx-*/rps_cpus; do echo 1-3 > "$q"; done
echo 32768 > /proc/sys/net/core/rps_sock_flow_entries
echo 32768 > /proc/sys/net/ipv4/tcp_rfs_sock_flow_entries

Impostare # XPS in base alle CPU worker selezionate (percorsi TX)
for q in /sys/class/net/$IF/queues/tx-*; do echo 1-3 > "$q"/xps_cpus; done
L'importante è la coerenza: il core RX-IRQ, il carico di ksoftirqd e il thread di lavoro dovrebbero trovarsi sullo stesso core (o coppia di core). In questo modo si eliminano molti effetti di "cross-core bounce".
Tenere conto di SMT/Hyper-Threading e coppie di core
Sui sistemi con SMT, spesso è opportuno riservare un core fisico per un RX-IRQ e assegnare il worker corrispondente al Thread correlato da impostare – oppure da separare intenzionalmente, se il carico di lavoro è intensivo dal punto di vista computazionale. Individuo le coppie di thread in base alla topologia e poi prendo una decisione chiara, anziché ricorrere a una distribuzione casuale.
Individuare le coppie di thread affini #
for c in /sys/devices/system/cpu/cpu*/topology/thread_siblings_list; do
  echo "$(basename "$(dirname "$c")") : $(cat "$c")"
done
Se distribuisco RX-IRQ e i worker dello spazio utente sullo stesso core fisico (diversi thread SMT), si ottiene una buona località L1/L2, ma con carichi di lavoro CPU-bound possono verificarsi colli di bottiglia. In alternativa, distribuisco l’IRQ sul core X e il worker sul core Y dello stesso nodo NUMA, per ottenere un parallelismo effettivo. Esegui un test A/B su entrambe le varianti e scelgo quella che offre la latenza più stabile.
Utilizzo di smp_affinity_list, effective_affinity e Defaults
Oltre alle maschere esadecimali, mi piace scrivere in smp_affinity_list, poiché ciò consente di affrontare ambiti quali 1-3,6,8-9 si possa sistemare comodamente. Per controllare, verifico affinità_effettiva rispettivamente elenco_di_affinità_effettivo, poiché il kernel o i driver possono escludere determinate CPU (ad esempio, core offline o „interrupt gestiti“).
# Assegnazione leggibile dall'utente
echo 1-3 > /proc/irq/181/smp_affinity_list

# Verifica dell'affinità effettiva
cat /proc/irq/181/effective_affinity_list
Per evitare che gli IRQ nuovi o aggiunti in seguito al ricaricamento di un driver vengano nuovamente distribuiti in modo dispersivo, se necessario imposto /proc/irq/default_smp_affinity a un valore di base ragionevole (ad esempio, tutti i core del nodo NUMA in questione, ma esclusa la CPU0). Successivamente, sovrascrivo in modo mirato i singoli IRQ critici.
Garantire la persistenza dopo i riavvii e i ricaricamenti
Le impostazioni di Affinity sono temporanee. Le salvo tramite un'unità systemd one-shot, che viene eseguita dopo l'obiettivo di inizializzazione della rete, oppure tramite un piccolo script che determina e mappa dinamicamente gli elenchi IRQ. In questo modo le assegnazioni vengono mantenute anche dopo gli aggiornamenti del kernel e i reset dei collegamenti.
# /usr/local/sbin/net-irq-pin.sh (esempio)
#!/bin/bash
set -euo pipefail
IF=${1:-ens192}
CPUS="1-3"   CPU di destinazione # (selezionare in modo coerente con NUMA)
for irq in $(grep -i "$IF" /proc/interrupts | awk '{print $1}' | tr -d ':'); do
  echo "$CPUS" > /proc/irq/$irq/smp_affinity_list || true
done

Unità systemd # (schema)
# /etc/systemd/system/net-irq-pin.service
[Unit]
Description=Fissare gli IRQ della scheda di rete
After=network-online.target

[Service]
Type=oneshot
ExecStart=/usr/local/sbin/net-irq-pin.sh ens192

[Install]
WantedBy=multi-user.target
Importante: rieseguo lo script se il driver viene ricaricato o se il numero di code viene modificato, poiché in tal caso i numeri IRQ cambiano.
Virtualizzazione e container: considerare insieme host e guest
Negli ambienti KVM, monto sul Ospite gli IRQ fisici delle schede di rete ai core del nodo NUMA corrispondente. Parallelmente, collego vhost-rete‑Anche i thread e il processo QEMU (o le singole vCPU) vanno collocati lì, in modo che i percorsi dei dati rimangano brevi dal lato host. Nel Ospite Assegno l’affinità IRQ delle vNIC alle vCPU che ho associato ai core fisici sul lato host. I carichi di lavoro dei container (cgroups/cpuset) traggono vantaggio quando le CPU consentite ai container si sovrappongono ai core RX/TX dell’host; in caso contrario, si verificano accessi remoti evitabili.
Approfondimento dell'analisi: SoftIRQ, NAPI e rilevamento degli ingorghi
Inoltre /proc/interruzioni guardo in /proc/softirqs, per vedere se c'è molto lavoro da fare nel contesto di ksoftirqd anziché essere eseguito direttamente nell’handler dell’IRQ – un’indicazione di un carico elevato e prolungato. Con napi_defer_hard_irqs (A seconda del kernel) e tramite assegnazioni corrette delle code regolo l'intensità con cui NAPI raggruppa i batch. ethtool -S mi fornisce statistiche per ogni coda relative a drop, stati di occupato e velocità di trasmissione dei pacchetti; in questo modo riesco a individuare le code sbilanciate e ad adeguare di conseguenza l’affinità o l’indirezione RSS.
# Panoramica rapida sulla distribuzione degli SoftIRQ
cat /proc/softirqs | egrep 'NET_RX|NET_TX'

# Visualizzazione delle statistiche relative al driver e alla coda
ethtool -S ens192 | egrep -i 'rx|tx|drop|busy'
Esempio pratico: mappatura di 4 code su un nodo
Una configurazione tipica che utilizzo spesso: scheda di rete (NIC) sul nodo NUMA 0 con 4 code RSS. Evito la CPU0 e associo le code alle CPU da 1 a 4. Assegno anche i relativi worker web o proxy alle CPU da 1 a 4, assegno gli XPS in modo identico e lascio disattivato l’RPS. In questo modo ottengo percorsi brevi e coerenti in entrambe le direzioni.
IF=ens192
QUEUES=(181 182 183 184)   IRQ di esempio per # (da determinare in precedenza)
CPUS="1-4"

Impostare l'affinità IRQ e XPS per #
for i in ${!QUEUES[@]}; do
  echo "$CPUS" > /proc/irq/${QUEUES[$i]}/smp_affinity_list
done
for q in /sys/class/net/$IF/queues/tx-*; do echo "$CPUS" > "$q"/xps_cpus; done

# Fissare il worker (systemd o taskset)
# systemd: CPUAffinity=1 2 3 4
# Una tantum: taskset -c 1-4
Se il carico continua ad aumentare, aumenterò il numero di code (ethtool -L) fino al numero ragionevole di core del nodo e distribuiscili in modo rigido secondo uno schema riconoscibile (ad es. ID coda → ID core), in modo che i flussi non „migrino“ nel corso del tempo.
Migliori pratiche per host multi-core
Alleggerisco il carico CPU0, poiché lì spesso sono in esecuzione timer e servizi interni del kernel che causano interferenze sotto carico. Preferisco quindi assegnare gli IRQ critici ad altri core e lasciare che la CPU0 gestisca solo poche sorgenti non critiche. Sui sistemi NUMA mantengo una politica coerente e tengo adattatori, IRQ, processi e accessi alla memoria sullo stesso Nodo. In ambienti sottoposti a forte carico, separo i core I/O dai core delle applicazioni e, se necessario, li isolo. Accompagno tutte le modifiche con misurazioni continue e adeguo le assegnazioni in modo iterativo.
Adottare un approccio misurabile: analisi, script e piano di riserva
Prima di apportare modifiche, documento lo stato attuale con mpstat, htop, /proc/interruzioni e misurazioni della latenza tramite iperf3. Configuro degli script che applicano automaticamente le impostazioni di affinità dopo un riavvio o il ricaricamento dei driver. Per i rollback tengo a disposizione delle maschere neutre, in modo da poter tornare immediatamente alla configurazione precedente in caso di malfunzionamenti. Nell’ambiente di staging testo profili di carico il più possibile simili a quelli della mia produzione e ripeto il Misurazione dopo ogni modifica. Solo allora attivo il profilo in modo permanente sull'host di destinazione.
Evitare gli ostacoli più comuni in modo pulito
Le mascherine troppo larghe distribuiscono il lavoro su troppe persone CPU e rallentano le cache, mentre le maschere troppo restrittive intasano le code. Le peculiarità NUMA trascurate generano accessi alla memoria remota che causano fluttuazioni nei tempi di risposta. Un pinning rigido a volte entra in conflitto con le impostazioni RPS/RFS, pertanto verifico esplicitamente la distribuzione del carico SoftIRQ. Dopo gli aggiornamenti del kernel o le sostituzioni dei driver, convalido nuovamente tutti i numeri IRQ, poiché le assegnazioni possono cambiare. Con passaggi cauti e una chiara Documentario rimango in grado di agire.
Riassumendo brevemente
Il "pinning" mirato degli IRQ associa gli interrupt di rete a un numero limitato di IRQ compatibili Nuclei, riduce l'overhead e stabilizza i tempi di risposta. A tal fine, ottimizzo l'affinità IRQ e CPU, tengo conto della NUMA e verifico l'efficacia tramite serie di misurazioni. Laddove è sufficiente la modalità automatica, lascio agire irqbalance, mentre assegno le code critiche a core fissi. Con RSS, RPS/RFS e parametri del kernel ottimizzati, l’ottimizzazione dispiega appieno il suo Effetto. Chi segue questi passaggi con rigore otterrà prestazioni di rete notevolmente superiori sui server Linux multi-core.


