Vai al contenuto

Questo articolo mostra come la thread pool server web Configurazione con Apache, NGINX e LiteSpeed Parallelismo, latenza e requisiti di memoria. Spiego quali impostazioni sono importanti sotto carico e dove è sufficiente l'autotuning, con chiare differenze nelle richieste al secondo.
Punti centrali
- Architettura: Processi/thread (Apache) vs. Eventi (NGINX/LiteSpeed)
- Autoregolazione: L'adattamento automatico riduce la latenza e gli arresti
- Risorse: i core della CPU e la RAM determinano le dimensioni ottimali dei thread
- Carico di lavoro: I/O-heavy richiede più thread, CPU-heavy ne richiede meno
- Sintonizzazione: Parametri piccoli e mirati hanno un effetto maggiore rispetto ai valori forfettari.
Confronto tra architetture thread pool
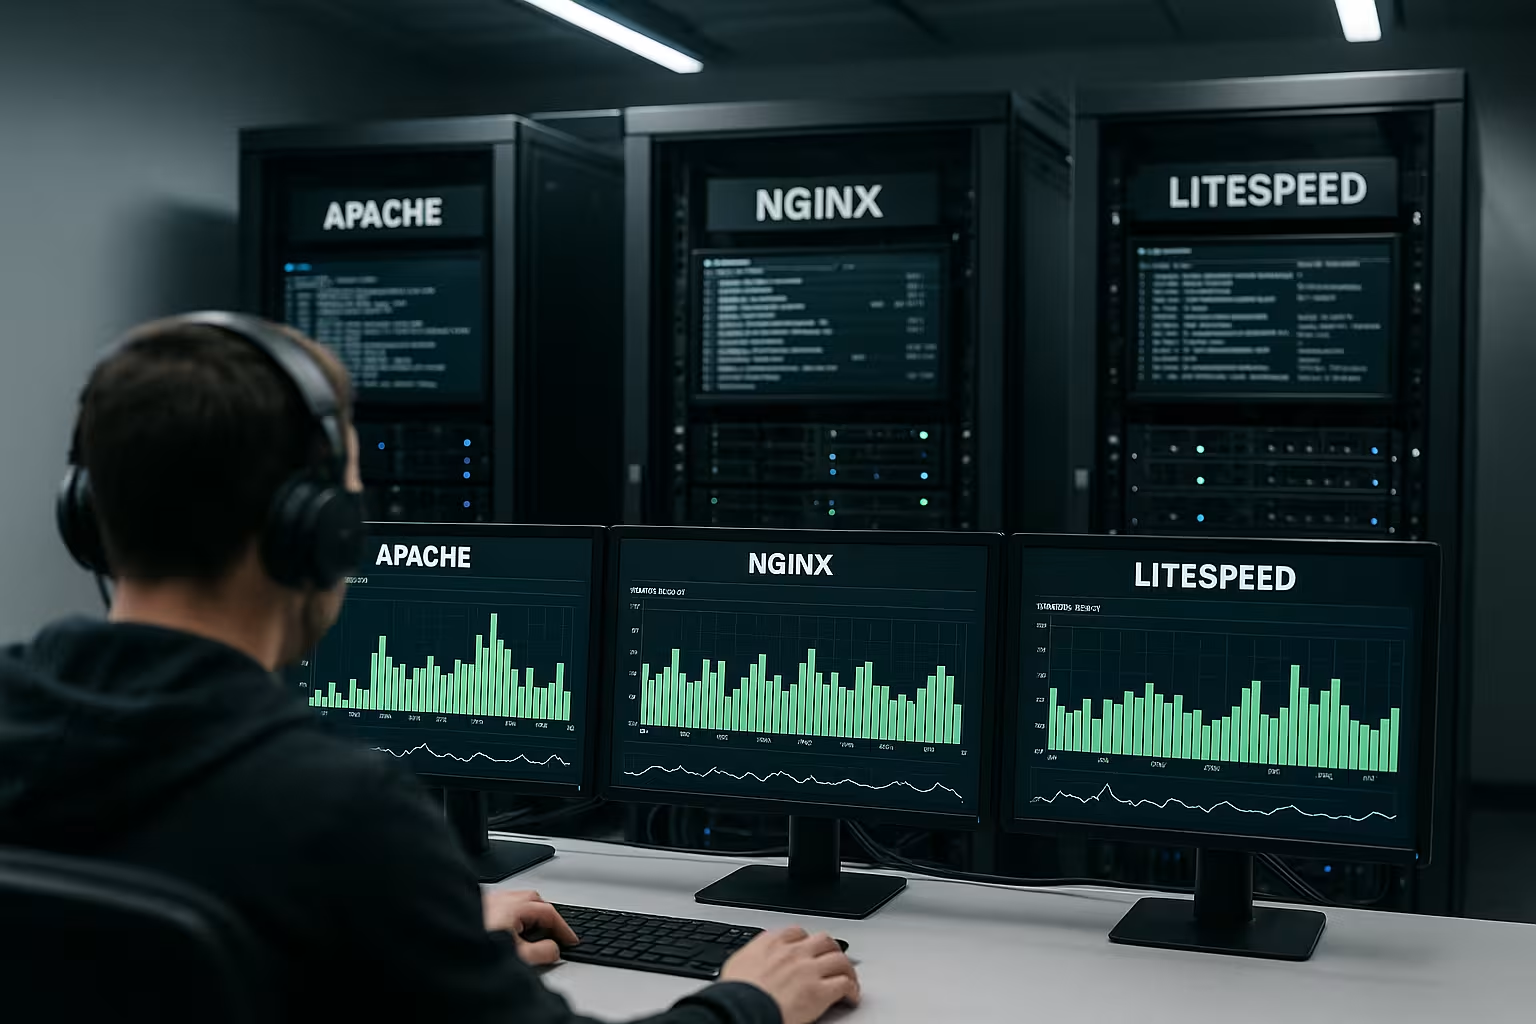
Inizio con il Architettura, perché definisce i limiti dello spazio di ottimizzazione. Apache si basa su processi o thread per connessione; ciò richiede più RAM e aumenta la latenza nelle ore di punta [1]. NGINX e LiteSpeed seguono un modello basato sugli eventi, in cui pochi worker multiplexano molte connessioni, risparmiando cambi di contesto e riducendo il sovraccarico [1]. Nei test, NGINX ha elaborato 6.025,3 richieste/s, Apache ha raggiunto 826,5 richieste/s nello stesso scenario e LiteSpeed si è posizionato al primo posto con 69.618,5 richieste/s [1]. Chi desidera approfondire il confronto tra le architetture può trovare ulteriori dati di riferimento all'indirizzo Apache contro NGINX, che utilizzo per una prima classificazione.
È importante anche il modo in cui ogni motore gestisce le attività bloccanti. NGINX e LiteSpeed separano l'event loop dal file system o dall'I/O upstream tramite interfacce asincrone e thread ausiliari limitati. Nel modello classico, Apache associa un thread/processo a ogni connessione; con MPM event è possibile alleggerire il carico di Keep-Alive, ma l'impronta di memoria per ogni connessione rimane comunque più elevata. In pratica ciò significa che più sono i client lenti simultanei o gli upload di grandi dimensioni, più il modello di eventi risulta vantaggioso.
Come funziona realmente l'auto-ottimizzazione
I server moderni controllano il Thread-Numero spesso automaticamente. Il controller controlla il carico in cicli brevi, confronta i valori attuali con quelli storici e ridimensiona la dimensione del pool verso l'alto o verso il basso [2]. Se una coda si blocca, l'algoritmo accorcia il suo ciclo e aggiunge thread aggiuntivi fino a quando l'elaborazione non torna stabile [2]. Ciò consente di risparmiare interventi, impedisce l'allocazione eccessiva e riduce la probabilità di blocchi head-of-line. Come riferimento utilizzo il comportamento documentato di un controller self-tuning in Open Liberty, che descrive chiaramente il meccanismo [2].
A tal proposito, faccio attenzione a tre leve: una Isteresi contro il flapping (nessuna reazione immediata a ogni picco), un limite massimo rigido contro gli overflow della RAM e una dimensione minima, in modo che i costi di riscaldamento non si verifichino ad ogni burst. È utile anche un valore target separato per attivo Thread (coreThreads) vs. thread massimi (maxThreads). In questo modo il pool rimane attivo senza occupare risorse inattive [2]. Negli ambienti condivisi riduco il tasso di espansione affinché il server web non occupi in modo aggressivo gli slot della CPU rispetto ai servizi vicini [4].
Indicatori chiave dai benchmark
I valori reali aiutano a Decisioni. Negli scenari burst, NGINX si distingue per la latenza molto bassa e l'elevata stabilità [3]. In condizioni di parallelismo estremo, Lighttpd registra il numero più elevato di richieste al secondo nei test, seguito a ruota da OpenLiteSpeed e LiteSpeed [3]. NGINX riesce a trasferire file di grandi dimensioni fino a 123,26 MB/s, seguito a breve distanza da OpenLiteSpeed, il che sottolinea l'efficienza dell'architettura basata sugli eventi [3]. Utilizzo tali indicatori per valutare dove le modifiche ai thread apportano realmente dei vantaggi e dove i limiti derivano dall'architettura.
| Server | Modello/Thread | Esempio di tasso | messaggio chiave |
|---|---|---|---|
| Apache | Processo/thread per connessione | 826,5 richieste/s [1] | Flessibile, ma maggiore fabbisogno di RAM |
| NGINX | Evento + pochi lavoratori | 6.025,3 richieste/s [1] | Basso Latenza, economico |
| LiteSpeed | Evento + LSAPI | 69.618,5 richieste/s [1] | Molto veloce, Ottimizzazione GUI |
| Lighttpd | Evento + Asincrono | 28.308 richieste/s (altamente parallele) [3] | Scalabile in Suggerimenti molto buono |
La tabella mostra i valori relativi. Vantaggi, nessun impegno fisso. Li valuto sempre nel contesto dei propri carichi di lavoro: risposte brevi e dinamiche, molti piccoli file statici o grandi flussi. Le variazioni possono derivare dalla rete, dallo storage, dall'offloading TLS o dalla configurazione PHP. Per questo motivo correlo metriche come CPU steal, lunghezza della coda di esecuzione e RSS per worker con il numero di thread. Solo questa visione distingue i veri colli di bottiglia dei thread dai limiti di I/O o delle applicazioni.
Per ottenere dati affidabili, utilizzo fasi di ramp-up e confronto le latenze p50/p95/p99. Una curva p99 ripida con valori p50 costanti indica piuttosto code piuttosto che una pura saturazione della CPU. I profili di carico aperti (controllati da RPS) anziché chiusi (controllati solo dalla concorrenza) mostrano inoltre meglio dove il sistema inizia a scartare attivamente le richieste. In questo modo posso definire il punto in cui gli aumenti dei thread non servono più e sono più utili la contropressione o i limiti di velocità.
Pratica: dimensionare lavoratori e connessioni
Inizio con il CPU-Core: worker_processes o LSWS-Worker non devono superare i core, altrimenti aumenta il cambio di contesto. Per NGINX, adatto worker_connections in modo che la somma delle connessioni e dei descrittori di file rimanga al di sotto di ulimit-n. Per Apache evito MaxRequestWorkers troppo elevati, perché l'RSS per ogni child consuma rapidamente la RAM. Con LiteSpeed mantengo in equilibrio i pool di processi PHP e gli HTTP worker, in modo che PHP non diventi un collo di bottiglia. Chi desidera comprendere le differenze di velocità tra i motori può trarre vantaggio dal confronto. LiteSpeed vs. Apache, che utilizzo come sfondo per il tuning.
Una semplice regola empirica: prima calcolo il budget FD (ulimit-n meno la riserva per log, upstream e file), lo divido per le connessioni simultanee pianificate per ogni worker e verifico se la somma è sufficiente per HTTP + upstream + buffer TLS. Successivamente, dimensiono moderatamente la coda di backlog: abbastanza grande per i picchi, abbastanza piccola da non nascondere il sovraccarico. Infine, imposto i valori Keep-Alive in modo che corrispondano ai modelli di richiesta: le pagine brevi con molte risorse traggono vantaggio da timeout più lunghi, mentre il traffico API con poche richieste per connessione tende a beneficiare di valori più bassi.
Ottimizzazione LiteSpeed per carichi elevati
Con LiteSpeed mi affido a LSAPI, perché riduce al minimo i cambiamenti di contesto. Non appena mi accorgo che i processi CHILD sono esauriti, aumento gradualmente LSAPI_CHILDREN da 10 a 40, se necessario fino a 100, accompagnato da controlli della CPU e della RAM [6]. La GUI mi facilita la creazione di listener, l'abilitazione delle porte, i reindirizzamenti e la lettura di .htaccess, accelerando le modifiche [1]. Sotto carico continuo, provo l'effetto di piccoli passi invece che di grandi salti, per individuare tempestivamente i picchi di latenza. In ambienti condivisi, riduco i coreThreads quando altri servizi utilizzano la CPU, in modo che il self-tuner non mantenga troppi thread attivi [2][4].
Inoltre, osservo Keep-Alive per listener e l'utilizzo di HTTP/2/HTTP/3: il multiplexing riduce il numero di connessioni, ma aumenta il fabbisogno di memoria per socket. Pertanto, mantengo i buffer di trasmissione conservativi e attivo la compressione solo dove il guadagno netto è evidente (molte risposte testuali, limite CPU minimo). Per i file statici di grandi dimensioni, mi affido a meccanismi zero-copy e limito gli slot di download simultanei in modo che i worker PHP non si blocchino in caso di picchi di traffico.
NGINX: utilizzare in modo efficiente il modello di eventi
Per NGINX imposto worker_processes su auto o il numero di core. Con epoll/kqueue, accept_mutex attivo e valori di backlog personalizzati, mantengo le connessioni accettate in modo uniforme. Mi assicuro di impostare keepalive_requests e keepalive_timeout in modo che i socket inattivi non intasino il pool FD. Trasferisco file statici di grandi dimensioni con sendfile, tcp_nopush e un output_buffers adeguato. Utilizzo il rate limiting e i limiti di connessione solo quando i bot o i burst caricano indirettamente il thread pool, perché ogni limitazione genera un'ulteriore gestione dello stato.
Negli scenari proxy è Keepalive upstream Fondamentale: un valore troppo basso genera latenza nella creazione della connessione, mentre un valore troppo alto blocca gli FD. Scelgo valori adeguati alla capacità del backend e mantengo i timeout per connect/read/send chiaramente separati, in modo che i backend difettosi non blocchino gli event loop. Con reuseport e CPU affinity opzionale, distribuisco il carico in modo più uniforme sui core, purché le impostazioni IRQ/RSS della NIC lo supportino. Per HTTP/2/3, calibro con attenzione i limiti di header e flow control, in modo che singoli flussi di grandi dimensioni non dominino l'intera connessione.
Apache: impostare correttamente MPM event
Con Apache utilizzo evento anziché prefork, in modo che le sessioni Keep-Alive non occupino in modo permanente i worker. Impostiamo MinSpareThreads e MaxRequestWorkers in modo che la coda di esecuzione per ogni core rimanga inferiore a 1. Mantengo ThreadStackSize piccolo in modo che più worker possano stare nella RAM disponibile; non deve diventare troppo piccolo, altrimenti si rischia di avere stack overflow nei moduli. Con un timeout KeepAlive moderato e KeepAliveRequests limitati, impedisco che pochi client blocchino molti thread. Sposta PHP in PHP-FPM o LSAPI in modo che il server web stesso rimanga leggero.
Presto inoltre attenzione al rapporto tra ServerLimit, ThreadsPerChild e MaxRequestWorkers: questi tre fattori determinano insieme il numero di thread che possono essere effettivamente creati. Per HTTP/2 utilizzo MPM event con limiti di flusso moderati; valori troppo elevati aumentano il consumo di RAM e i costi di scheduler. Carico i moduli con cache globali di grandi dimensioni solo quando sono necessari, poiché i vantaggi del copy-on-write svaniscono non appena i processi funzionano a lungo e modificano la memoria.
RAM e thread: calcolare correttamente la memoria
Conto i RSS per ogni worker/child per il numero massimo previsto e aggiungo il buffer del kernel e le cache. Se non rimane alcun buffer, riduco i thread o non aumento mai lo swap, perché lo swapping fa esplodere la latenza. Per PHP-FPM o LSAPI calcolo anche il PHP-RSS medio, in modo che la somma tra server web e SAPI rimanga stabile. Tengo conto dei costi di terminazione TLS, perché gli handshake dei certificati e i buffer in uscita di grandi dimensioni aumentano il consumo. Solo quando la gestione della RAM è corretta, continuo a stringere i thread.
Con HTTP/2/3, prendo in considerazione ulteriori stati di controllo dell'intestazione/flusso per ogni connessione. GZIP/Brotli bufferizzano contemporaneamente dati compressi e non compressi; ciò può significare diverse centinaia di KB in più per ogni richiesta. Prevedo inoltre delle riserve per i log e i file temporanei. Con Apache, valori ThreadStackSize più piccoli aumentano la densità, mentre con NGINX e LiteSpeed sono principalmente il numero di socket paralleli e la dimensione dei buffer di invio/ricezione ad avere un effetto. Sommare tutti i componenti prima della messa a punto evita spiacevoli sorprese in seguito.
Quando intervengo manualmente
Mi affido a Autoregolazione, finché le metriche non dimostrano il contrario. Se condivido la macchina in hosting condiviso, rallento coreThreads o MaxThreads in modo che altri processi mantengano un tempo di CPU sufficiente [2][4]. Se esiste un limite rigido di thread per processo, imposto maxThreads in modo conservativo per evitare errori del sistema operativo [2]. Se si verificano modelli simili a deadlock, aumento solo temporaneamente la dimensione del pool, osservo le code e poi la riduco nuovamente. Chi desidera confrontare i modelli tipici con i valori misurati, può trovare indicazioni nel Confronto della velocità del server web, che mi piace utilizzare come controllo di plausibilità.
Come segnali di intervento utilizzo principalmente: picchi p99 persistenti nonostante un carico CPU basso, code socket in aumento, forte crescita TIME_WAIT-Numeri o un improvviso aumento dei FD aperti. In questi casi, riduco innanzitutto le ipotesi (limiti di connessione/frequenza), disaccoppio i backend con timeout e solo successivamente aumento con cautela i thread. In questo modo evito di trasferire il sovraccarico solo all'interno e di peggiorare la latenza per tutti.
Errori tipici e controlli rapidi
Guardo spesso alto Timeout Keep-Alive che legano i thread anche se non vi è alcun flusso di dati. Altrettanto diffusi: MaxRequestWorkers ben oltre il budget RAM e ulimit-n troppo basso per la parallelità target. In NGINX molti sottovalutano l'utilizzo FD da parte delle connessioni upstream; ogni backend conta doppio. In LiteSpeed, i pool PHP crescono più rapidamente dei worker HTTP, il che significa che le richieste vengono accettate ma servite troppo tardi. Con brevi test di carico, confronto heap/RSS e controllo della coda di esecuzione, trovo questi modelli in pochi minuti.
Altrettanto frequente: syn-backlog troppo piccolo, quindi le connessioni vengono respinte prima ancora di raggiungere il server web; log di accesso senza buffer che scrivono in modo sincrono su un storage lento; log di debug/traccia che rimangono attivi per errore e occupano la CPU. Quando si passa a HTTP/2/3, limiti di flusso e buffer di intestazione troppo generosi aumentano il consumo di memoria per connessione, particolarmente evidente quando molti client trasferiscono pochi dati. Pertanto, controllo la distribuzione delle risposte brevi rispetto a quelle lunghe e adeguo i limiti di conseguenza.
HTTP/2 e HTTP/3: cosa significano per i thread pool
Il multiplexing riduce notevolmente il numero di connessioni TCP per client. Questo è positivo per gli FD e i costi di accettazione, ma sposta la pressione sugli stati per connessione. Per questo motivo, imposto limiti prudenti per gli stream simultanei per HTTP/2 e calibro il controllo di flusso in modo che i singoli download di grandi dimensioni non dominino la connessione. Con HTTP/3 vengono eliminati i blocchi head-of-line causati dal TCP, ma aumenta il carico della CPU per ogni pacchetto. Compenso questo aspetto con una capacità di lavoro sufficiente e buffer di piccole dimensioni, in modo da mantenere bassa la latenza. In tutti i casi vale la regola: meglio poche connessioni ben utilizzate con valori Keep-Alive ragionevoli piuttosto che sessioni di inattività troppo lunghe che occupano thread e memoria.
Fattori della piattaforma: kernel, container e NUMA
Quando si parla di virtualizzazione, faccio attenzione a CPU-Steal e limiti cgroups: se l'hypervisor ruba core o il container possiede solo core parziali, worker_processes=auto potrebbe essere troppo ottimistico. Se necessario, assegno i worker a core reali e adeguo il numero al efficace budget disponibile. Sugli host NUMA, i server web beneficiano dell'allocazione della memoria locale; evito accessi cross-node non necessari raggruppando i worker per socket. Spesso lascio disattivato Transparent Huge Pages per i carichi di lavoro critici in termini di latenza, al fine di evitare picchi di page fault.
A livello di sistema operativo controllo i limiti dei descrittori di file, i backlog delle connessioni e l'intervallo di porte per le connessioni in uscita. Aumento solo ciò di cui ho effettivamente bisogno, testiamo il comportamento durante il rollover e manteniamo rigorosamente i limiti di sicurezza. Dal punto di vista della rete, mi assicuro che la distribuzione RSS/IRQ e le impostazioni MTU siano adeguate al profilo del traffico, altrimenti la messa a punto nel server web va a vuoto perché i pacchetti arrivano troppo lentamente o rimangono bloccati nella coda NIC.
Misurare invece di indovinare: guida pratica per i test
Eseguo test di carico in tre fasi: riscaldamento (cache, JIT, sessioni TLS), plateau (RPS/concorrenza stabili) e burst (picchi brevi). Profili separati per file statici, chiamate API e pagine dinamiche aiutano a isolare i punti in cui thread, I/O o backend sono limitanti. Annotiamo parallelamente i numeri FD, le code di esecuzione, i cambi di contesto, RSS per processo e le latenze p50/p95/p99. Come obiettivo scegliamo punti di funzionamento con un carico di lavoro 70-85 %, un buffer sufficiente per le fluttuazioni reali senza funzionare costantemente nell'area di saturazione.
Guida decisionale in breve
Scelgo NGINX, quando contano bassa latenza, risorse economiche e possibilità di ottimizzazione .conf flessibili. Mi affido a LiteSpeed quando il carico PHP è dominante, la GUI deve semplificare il funzionamento e LSAPI riduce i colli di bottiglia. Utilizzo Apache quando ho bisogno di moduli e .htaccess e ho sotto controllo la configurazione MPM-event. In molti casi, i meccanismi di autoregolazione sono sufficienti; devo intervenire solo quando le metriche indicano blocchi, limiti rigidi o pressione sulla RAM [2]. Con budget realistici per core e RAM, piccoli incrementi e osservazione delle curve di latenza, la regolazione dei thread mi porta in modo affidabile al mio obiettivo.