Vai al contenuto

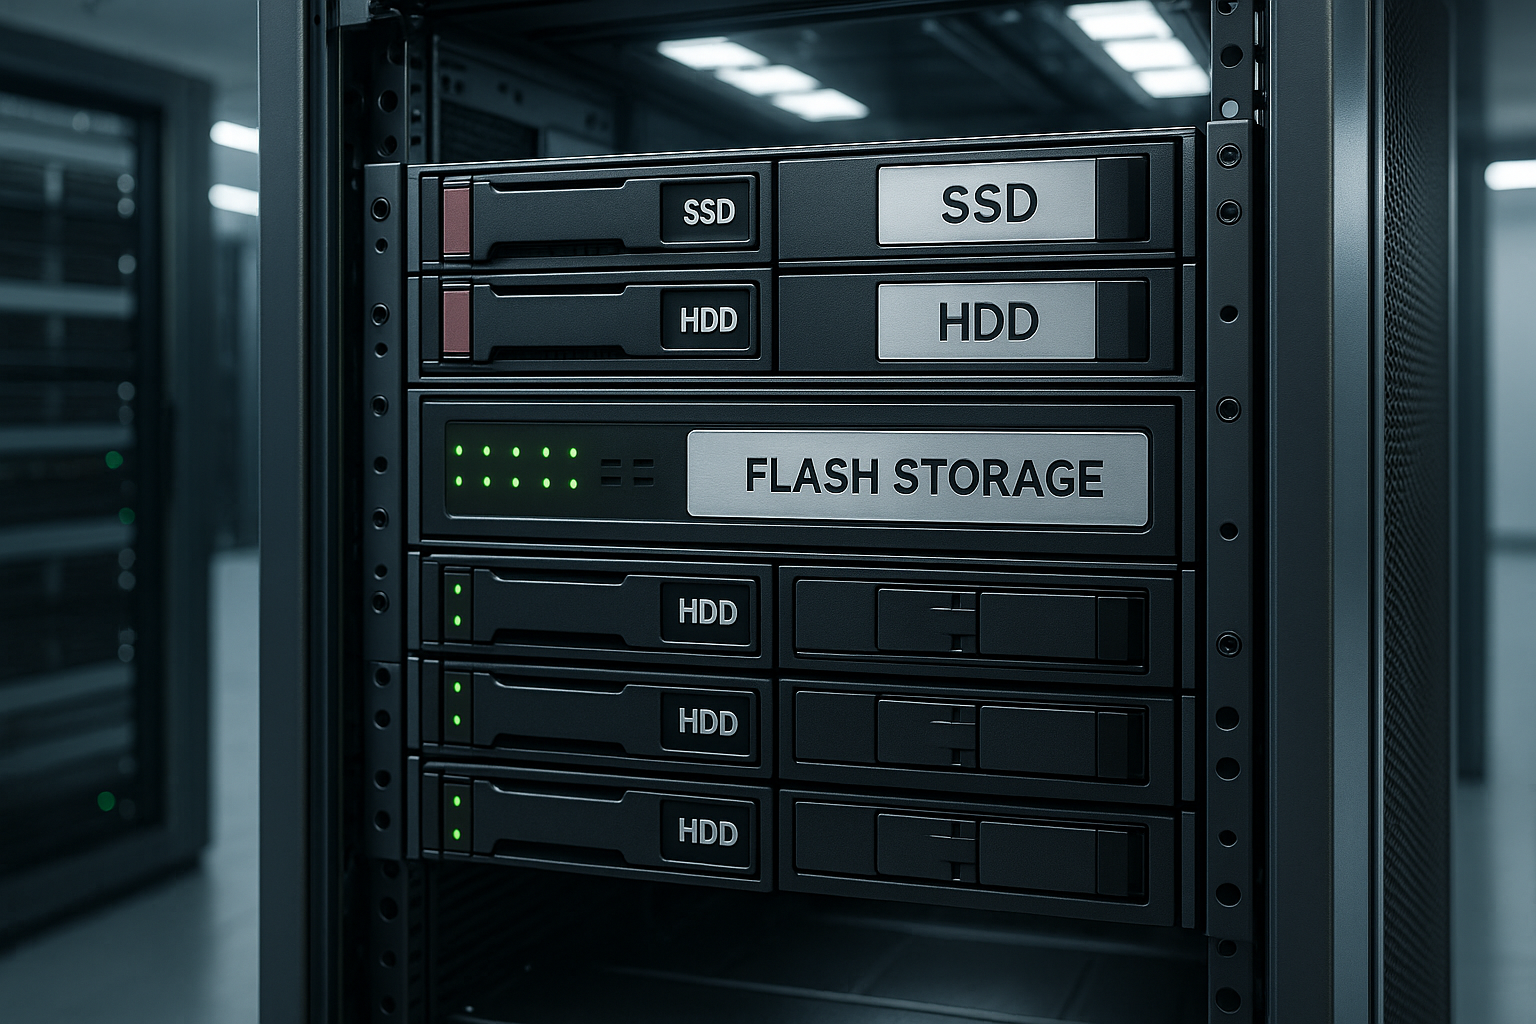
Il tiering dello storage nel web hosting organizza i dati in base alla frequenza di accesso e combina in modo specifico SSD NVMe, RAID SSD, HDD e archivi cloud in un'unica soluzione. ottimale combinazione di supporti di archiviazione. Questo mi permette di accelerare i dati caldi al Tier 0, di esternalizzare i dati freddi a basso costo e di mantenere i costi e la latenza al minimo. Equilibrio.
Punti centrali
Le seguenti affermazioni di base mi danno rapidamente l'orientamento per un efficiente Strategia di stoccaggio e contribuiscono a ottimizzare le prestazioni e i costi del web hosting. Piano:
- Caldo/Freddo Separazione: dati utilizzati di frequente su SSD NVMe, dati utilizzati raramente su HDD o cloud.
- AutomazioneLe politiche spostano i dati tra i livelli senza interventi manuali.
- Ibrido Server di archiviazione: Flash per la velocità, HDD per la capacità, ideale per progetti in crescita.
- Prestazioni Tuning: caching, compressione, deduplicazione e monitoraggio riducono la latenza.
- Costi Controllo: solo i dati 20-30% sono “caldi”; gli altri vengono memorizzati in modo più favorevole.
Cosa fa il tiering dello storage per il web hosting
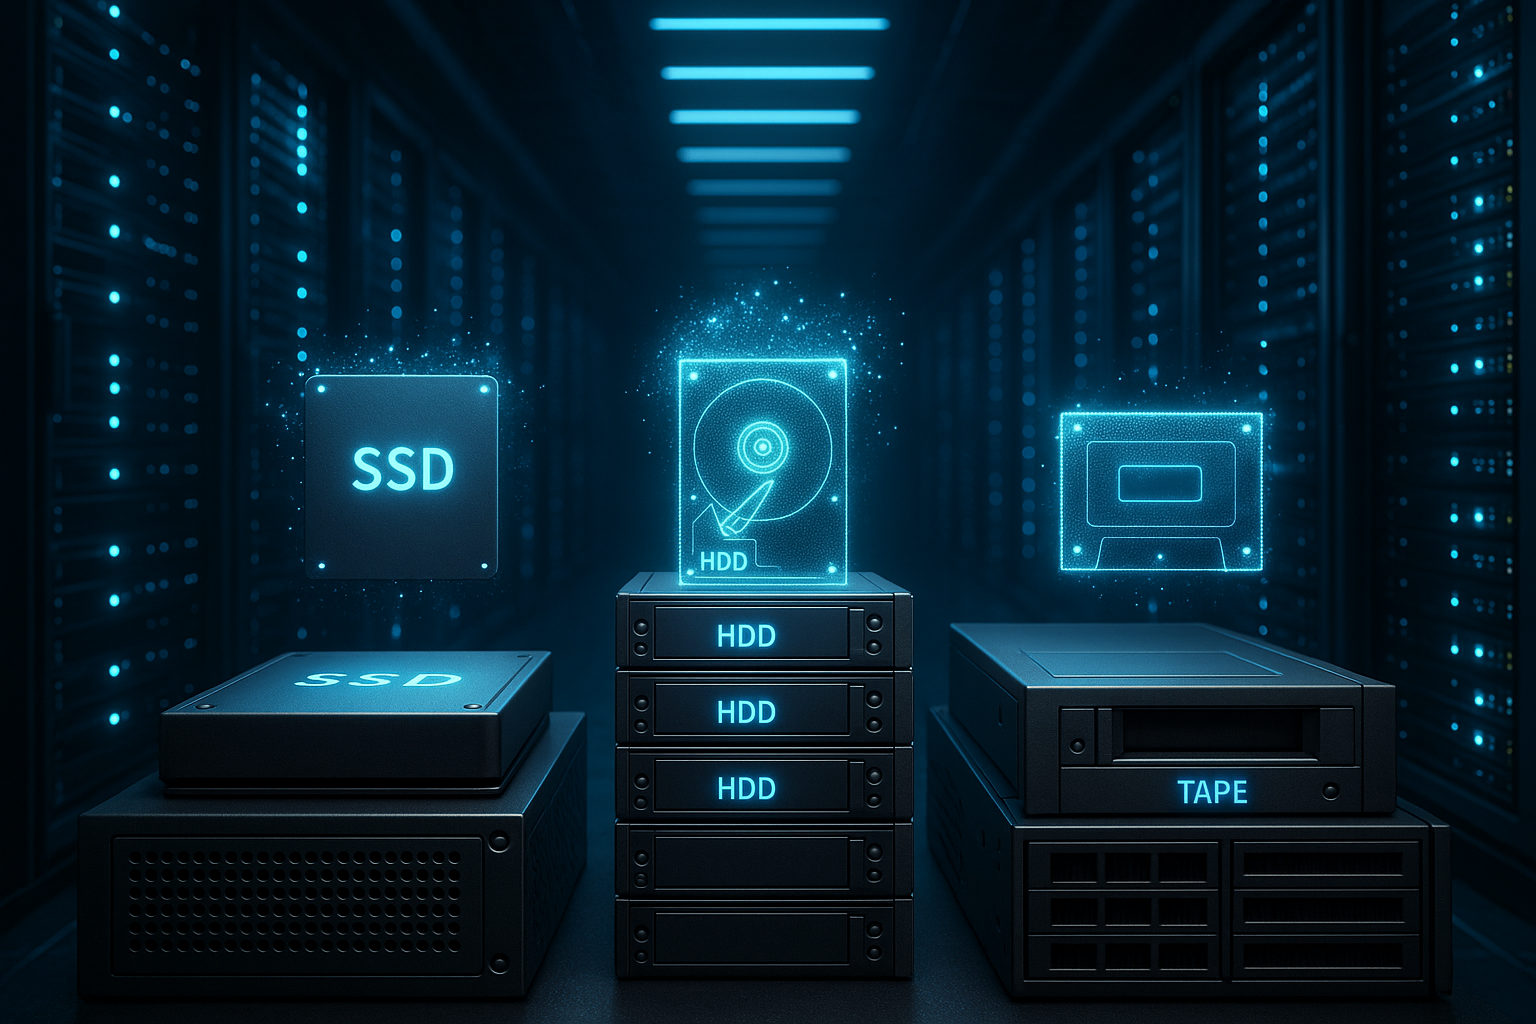
Organizzo i dati in livelli al fine di Accessi rapidamente e utilizzare i budget di storage in modo mirato. Il livello 0 con unità SSD NVMe contiene tabelle, cache e sessioni critiche per le transazioni, con un overhead minimo e una latenza inferiore al millimetro. Il livello 1 contiene contenuti dinamici, risposte API o upload frequenti, in genere su unità SSD aziendali o HDD RAID veloci. Il livello 2 archivia backup, file di registro e risorse statiche di grandi dimensioni in modo conveniente su unità disco SATA. Il livello 3 archivia i dati poco frequenti su storage a oggetti nel cloud o su nastro, consentendomi di scalare la capacità a costi molto bassi, pur mantenendo la capacità di archiviazione. Conformità copertina.
I quattro livelli spiegati in modo chiaro
Scelgo il mezzo giusto in base a Carico di lavoro e modelli di accesso. Il livello 0 (SSD NVMe) accelera i carichi OLTP, gli indici di ricerca e i flussi di pagamento dove ogni millisecondo conta. Il livello 1 (SSD/HDD RAID) fornisce supporti attivi, endpoint API o code di messaggistica con prestazioni IOPS elevate. Il livello 2 (HDD SATA) serve per i log a lungo termine, i punti di ripristino e le esportazioni che sono raramente presenti nel runtime primario. Il livello 3 (cloud/nastri) consente di conservare gli archivi a prova di audit, le relazioni annuali e l'archiviazione legale lontano dal runtime primario. Carico di produzione.
Server di storage ibrido: un mix intelligente di flash e capacità
Mi piace affidarmi a un ibrido Server di storage che combina flash per i picchi di carico e HDD per le grandi quantità di dati. Questa combinazione riduce la latenza per i database e allo stesso tempo garantisce un'archiviazione economica di file voluminosi. Le pagine dinamiche, i cestini della spesa e la personalizzazione vengono eseguiti rapidamente, mentre i backup e i log vengono archiviati su livelli di capacità. Se volete approfondire l'argomento, date un'occhiata ai vantaggi di un Hosting di storage ibrido su. Questo mi permette di tenere sotto controllo i costi e di lasciare che la Prestazioni crescere.
Tiering automatizzato: regole, politiche, strumenti
Definisco regole che ordinano i file in base all'età, alle dimensioni o all'accesso tra i livelli. turno. Esempio di logica: “Meno di cinque accessi alla settimana? Scendi al Tier 2” oppure “Gli oggetti appena creati passano al Tier 0 per 14 giorni”. Il sistema analizza continuamente i modelli di accesso e migra i dati in modo trasparente in background. Le applicazioni rimangono accessibili mentre i blocchi o i file migrano tramite priorità, QoS e hit rate. In questo modo, garantisco tempi di risposta costanti e utilizzo la memoria veloce solo dove è necessaria per la Traffico conta.
Profili di carico di lavoro e obiettivi di hit rate
Misuro in anticipo i miei carichi di lavoro: rapporto lettura/scrittura, dimensioni delle richieste (4-128 KB), I/O casuale o sequenziale, durata dei burst e picchi giornalieri. Da ciò ricavo i valori target, ad esempio “tasso di hit della cache >90% per le pagine dei prodotti” o “P99 < 5 ms per le transazioni del carrello”. Il tasso di successo influenza la quantità di capacità Tier 0 di cui ho realmente bisogno. Inoltre, pianifico strategie di rewarm dopo le implementazioni o le convalide della cache, in modo che i percorsi critici non rimangano in avviamento a freddo.
Messa a punto delle prestazioni per i server di hosting
Combino il tiering con Caching, per accelerare gli accessi in lettura e rendere più fluidi i processi di scrittura. La compressione dei dati riduce il carico di I/O, la deduplicazione fa risparmiare capacità senza adattare la logica dell'applicazione. Il monitoraggio scopre i colli di bottiglia nella CPU, nella RAM, nell'I/O del disco e nella rete e fornisce misure chiare. Il bilanciamento del carico distribuisce le richieste in modo che i picchi non gravino su un singolo sottosistema. La messa a punto del sistema operativo, gli aggiornamenti del firmware e i driver aggiornati completano il quadro e mi forniscono dati stabili e affidabili. Latenze.
RAID, file system e stack di caching
Scelgo i livelli RAID in modo appropriato: RAID10 per bassa latenza ed elevato IOPS, RAID6 per carichi di lavoro ad alta capacità e più sequenziali. Per le unità SSD, considero l'amplificazione della scrittura e la resistenza (TBW/DWPD) per includere la durata nella pianificazione dei costi. A seconda dell'obiettivo, utilizzo ZFS (checksum, snapshot, cache), XFS (prestazioni mature) o btrfs (snapshot, checksum) come file system. Posiziono le cache delle applicazioni, i bordi delle CDN e i buffer dei database davanti a livelli di cache come Redis/Memcached: in questo modo riduco l'I/O prima che raggiunga lo storage.
Costi e benefici: Esempi di calcolo in euro
Calcolo i risparmi analizzando i dati degli attivi e degli inattivi. separato. Supponiamo che un sito contenga 10 TB di dati totali, di cui 25% sono “caldi”. Se metto i dati caldi su NVMe (ad esempio 0,20 euro per GB/mese) e 75% di dati freddi su HDD (ad esempio 0,03 euro per GB/mese), la spesa mensile per lo storage si riduce notevolmente. 2,5 TB a caldo costano quindi circa 500 euro, 7,5 TB a freddo circa 225 euro, complessivamente circa 725 euro invece di 2.000 euro con NVMe puro. Il vantaggio aumenta se si utilizzano gli archivi cloud per il Tier 3 in modo mirato e si soddisfano i requisiti di conformità in modo economico. copertura.
In pratica, tengo conto dei costi aggiuntivi: chiamate API, tariffe di uscita dall'archivio cloud, eventuali tariffe di recupero per dati rari ma non del tutto freddi. Valuto anche i costi di opportunità, ad esempio la perdita di fatturato dovuta a una latenza elevata, e stabilisco un budget per la durata dell'SSD. Mantengo aggiornato il calcolo con una revisione mensile della distribuzione dei dati (file N principali, tassi di crescita, tempi di permanenza).
Panoramica del livello: media, casi d'uso e figure chiave
Utilizzo la seguente tabella per Livelli e prendere decisioni rapide in fase di dimensionamento. Riassume i supporti tipici, i carichi di lavoro, la latenza e le classi IOPS approssimative e fornisce un riferimento compatto per la classificazione. I valori servono come guida per progetti web che vanno dai piccoli negozi ai portali di contenuti. Pianifico i percorsi dei dati, le cache e la replica su questa base. In questo modo, ogni gigabyte di utilizzo rimane trasparente e viene ottimizzato. Carico coordinato.
| animale | Medio | Casi d'uso tipici | Costi | Latenza | Classe IOPS | Suggerimento |
|---|---|---|---|---|---|---|
| 0 | SSD NVMe | Transazioni, database, cache | Alto | < 1 ms | Molto alto | Per i dati caldi, code brevi |
| 1 | RAID SSD / HDD aziendale | Contenuti dinamici, API, upload attivi | Medio | 1–5 ms | Alto | Un solido compromesso per i carichi di lavoro web |
| 2 | HDD SATA | Backup, log, asset di grandi dimensioni | Basso | 5-12 ms+ | Medio | Buona capacità, tempi di accesso più lunghi |
| 3 | Archiviazione a oggetti in cloud / nastro | Archivio, dati rari, conservazione | Molto basso | ms-s (a seconda dell'accesso) | Variabile | Alta scalabilità, utilizzo delle politiche del ciclo di vita |
Sicurezza, protezione dei dati e conformità
Cifro i dati a riposo (LUKS/ZFS-native) e in volo (TLS) e tengo le chiavi separate dallo storage (HSM/KMS). Per i backup immutabili, utilizzo criteri WORM o snapshot immutabili per proteggermi dal ransomware. Mappo i periodi di conservazione legale tramite politiche di conservazione sul livello 3; implemento i concetti di cancellazione (diritto all'oblio) con flussi di lavoro chiari. L'accesso è regolato tramite least privilege, 2FA e registri di audit: questo non solo mantiene i livelli veloci, ma anche puliti. assicurato.
Isolamento dell'IO e separazione dei client
Isolo i “vicini rumorosi” utilizzando QoS, limiti di IOPS/larghezza di banda e pool separati. In questo modo si evita che un lavoro batch intasi il livello 0. Sugli host condivisi, separo i carichi di lavoro utilizzando spazi dei nomi, volumi separati e cache differenziate. Per i clienti particolarmente sensibili, riservo pool flash dedicati o addirittura code di controller separate per assorbire i picchi di latenza.
Scale-up vs. scale-out e selezione del protocollo
Scalano verticalmente (più flash, controller più veloci) finché il rapporto costi-benefici è adeguato. A un certo punto, passo allo scale-out: file system distribuiti o object storage per crescere orizzontalmente. La scelta del protocollo si basa sull'accesso: Block (NVMe/iSCSI) per i database, file (NFS/SMB) per i webroot e gli asset, object per gli archivi o le consegne di contenuti multimediali. Per quanto riguarda la rete, prevedo 25/100 GbE, tessuti di storage separati e, se ha senso, NVMe-oF per una latenza quasi locale sulla rete.
Fasi di attuazione nella pratica
Inizio con un Classificazione dei dati, che analizza i log e le analisi delle ultime settimane. Seguono politiche chiare: limiti di età, tipi di file, tabelle di database e directory sono assegnati a livelli fissi. Poi attivo l'automazione che esegue gli spostamenti senza tempi morti e controlla continuamente i valori di soglia. Il monitoraggio registra le percentuali di successo, il riscaldamento della cache, la profondità delle code e segnala immediatamente i valori anomali. Prima del go-live, verifico gli scenari di carico per garantire che latenze, tassi di errore e throughput rientrino nel corridoio previsto. portare.
Cloud ibrido e archiviazione offsite
Combino i livelli locali con Cloud-per archiviare dati rari in modo economico e sicuro. I dati caldi rimangono vicini all'applicazione, quelli freddi migrano automaticamente nel cloud. La QoS dà priorità ai carichi di lavoro critici, mentre i nodi edge riducono la latenza per i visitatori. Per gli scenari compatibili con S3, vale la pena dare un'occhiata a Hosting di storage a oggetti, per gestire senza problemi archivi e versioning. Le VPN o i peer privati proteggono il trasporto in modo che io possa soddisfare le esigenze di protezione dei dati e di Conformità-rispettare i requisiti.
Migrazione senza tempi morti
Migro passo dopo passo: Creo le istantanee, avvio la replica iniziale, quindi sincronizzo in modo incrementale. Durante una breve finestra di switchover, congelo gli accessi in scrittura, cambio i mount/volumi e controllo le checksum. Ho pronti i punti di rollback. Per i database, pianifico le repliche di lettura o la spedizione dei registri per passare ai nuovi livelli quasi senza soluzione di continuità.
Contenitori, orchestrazione e StorageClasses
Definisco diverse classi di storage per livello in ambienti orchestrati. Lego i carichi di lavoro statici, come i database, alle classi veloci (tier 0/1), i log e gli artefatti ai tier 2/3. Le regole del ciclo di vita tramite snapshot CSI e le politiche di retention e reclaim garantiscono che i volumi non crescano in modo incontrollato. Ciò significa che il tiering rimane coerente anche nelle piattaforme dinamiche.
Impostazione corretta di monitoraggio, QoS e SLA
Stabilisco chiaramente Punti di misura e utilizzare dashboard che mostrano latenza P90/P99, IOPS e larghezza di banda separatamente per ciascun livello. Gli avvisi con livelli di escalation impediscono che i guasti passino inosservati. I limiti QoS proteggono il livello 0 dai vicini rumorosi che consumano inutilmente le quote di burst. Definisco gli SLA in modo realistico: finestre di tempo di risposta, disponibilità e RTO/RPO per i casi di ripristino. Con questo quadro, mantengo i servizi prevedibili e garantisco la tracciabilità. Priorità.
Evitare gli errori tipici: Politiche, backup, conservazione
Mi astengo dall'impostare tutto sul livello 0. laico, perché il budget non serve a nulla. Le politiche devono essere basate sugli accessi reali e aggiornate regolarmente. I backup devono essere rigorosamente separati e gestiti con una chiara conservazione, in modo che i percorsi di ripristino funzionino rapidamente. Questa panoramica di Classi di archiviazione e tempi di backup. In questo modo si evitano costi superflui, si evita lo shadow IT e si mantiene la Audit rilassato.
Benchmarking e metodologia di test
Provo nuove configurazioni di tiering con test sintetici (ad esempio, diverse dimensioni dei blocchi, mix R/W) e replay di carichi di lavoro reali. Sono importanti profili riproducibili, warm-up e misurazioni su P95/P99, non solo valori medi. Eseguo modifiche A/B e confronto le metriche nell'arco di diversi giorni per tenere conto delle idrografie giornaliere.
Futuro: tiering guidato dall'intelligenza artificiale e NVMe-oF
Mi aspetto che i modelli ML Accessi e preparare i livelli in anticipo. NVMe-oF riduce la latenza sulla rete e rende le risorse flash remote quasi locali. La virtualizzazione dello storage integra più cloud e sistemi on-premise e distribuisce i carichi di lavoro in modo dinamico. Per il web hosting, i prossimi passi sono una cache ancora più fine, una compressione adattiva e cicli di vita degli oggetti basati su policy. Questo mi permette di scalare i progetti su più regioni senza Tempo di risposta sacrificare.
Processi operativi, governance e FinOps
Documento le politiche di tiering, le eccezioni e i percorsi di autorizzazione. Le revisioni mensili verificano l'utilizzo della capacità, le variazioni dei costi e la conformità agli SLA. Utilizzo approcci FinOps per allocare i centri di costo, simulare scenari di crescita e pianificare per tempo gli acquisti. I runbook definiscono le finestre di ribilanciamento, le procedure di emergenza e i ruoli di reperibilità, rendendo le operazioni prevedibili e liberando i team.
Riassumendo brevemente
Uso Immagazzinamento Tiering per servire i dati caldi in modo ultraveloce, archiviare i dati freddi a basso costo e ridurre significativamente i costi mensili. Un server di storage ibrido mescola flash e capacità in modo sensato, mentre automazione, caching, compressione e deduplicazione risparmiano gli ultimi millisecondi. Gli approcci al cloud ibrido con lo storage a oggetti ampliano la capacità, proteggono gli archivi e tengono sotto controllo i requisiti di conformità. Il monitoraggio e la QoS garantiscono il rispetto delle priorità e degli SLA. Se si combinano correttamente questi elementi costitutivi, si otterrà un solido sistema di gestione dei dati. Prestazioni a un prezzo equo.