Vai al contenuto

Spiego il gergo del web hosting relativo a Metallo nudo, hypervisor e Multi-tenant Concreto e orientato alla pratica. In questo modo capirai immediatamente come funzionano i modelli, in cosa differiscono e quale scelta è più adatta ai tuoi obiettivi, dal singolo progetto alla piattaforma con molti utenti.
Punti centrali
- Metallo nudo: controllo completo dell'hardware e prestazioni eccellenti.
- hypervisor: Virtualizzazione con chiara separazione e flessibilità.
- Multi-tenant: utilizzo efficiente delle risorse grazie alla separazione logica.
- Vicino rumoroso: Gestire e prevenire le prestazioni in modo pulito.
- Ibrido: separare i carichi sensibili, scalare in modo elastico.
Bare Metal in breve
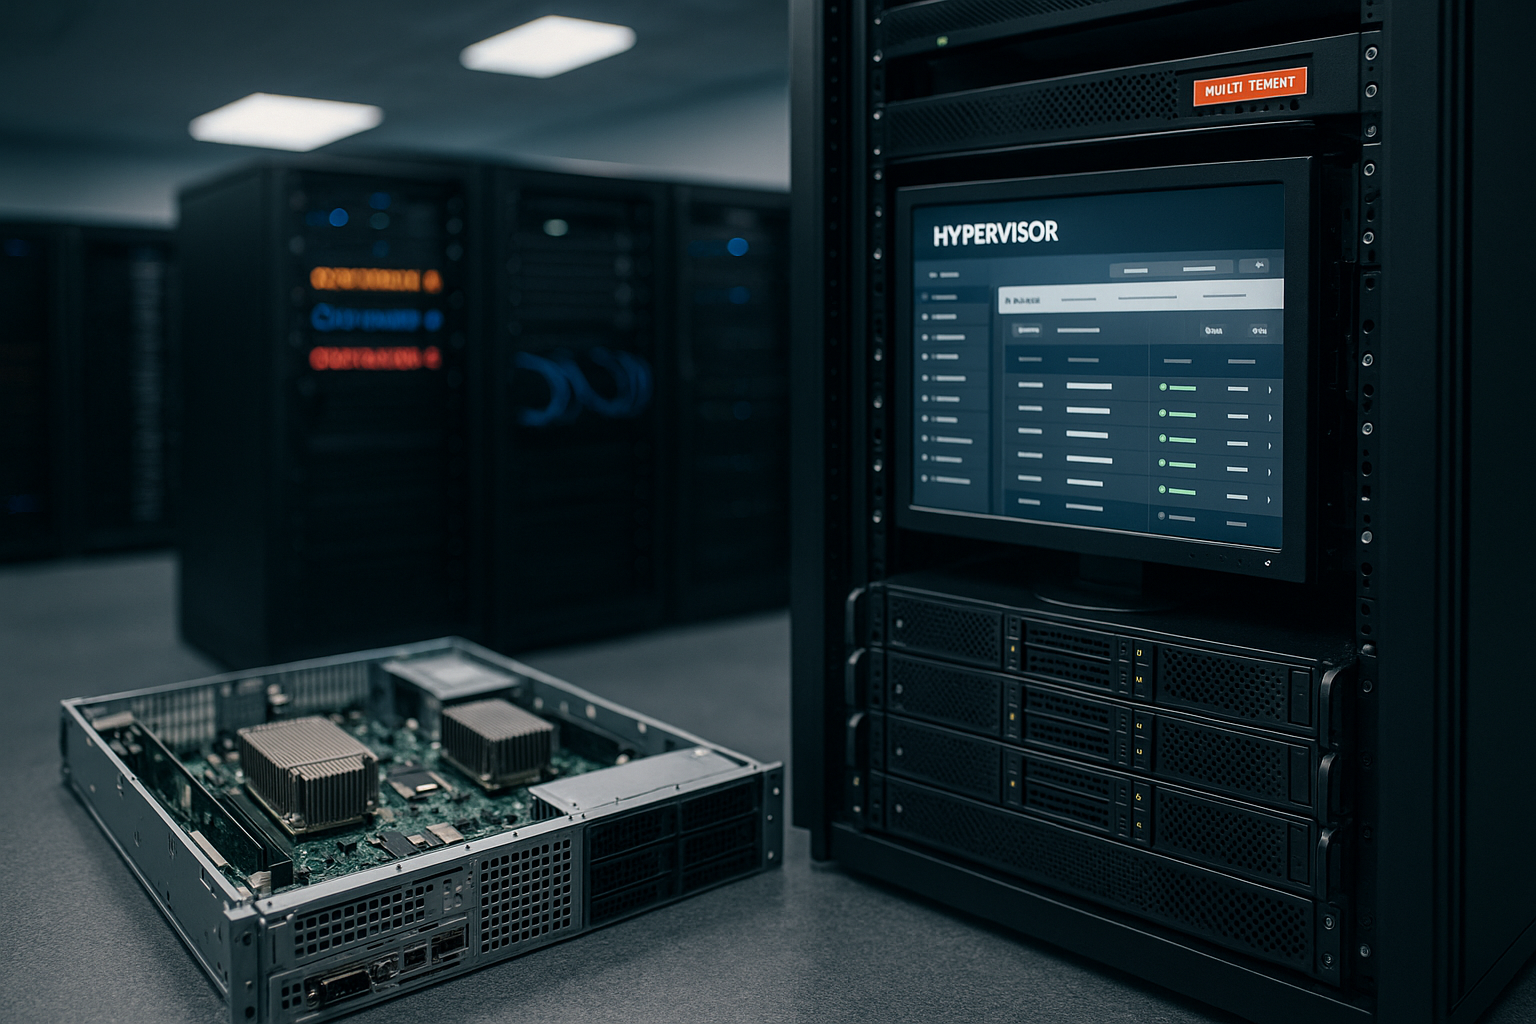
Metallo nudo Significa che un server fisico è di tua esclusiva proprietà. Non condividi CPU, RAM e SSD con altri. Sono io a decidere il sistema operativo, la configurazione dello storage e le funzioni di sicurezza. In questo modo controllo ogni livello, dal BIOS al kernel. Per i dati sensibili e i picchi di carico, Bare Metal offre le riserve più affidabili e la latenza più bassa.
È fondamentale l'assenza di vicini sullo stesso hardware. In questo modo evito il Vicino rumoroso-Effetto completo. Pianifico la capacità in modo realistico e mantengo costanti le prestazioni. Chi proviene da ambienti condivisi nota immediatamente la differenza. È possibile comprendere rapidamente il concetto con un paragone come questo Hosting condiviso vs. dedicato.
Nozioni di base su hardware e reti per piattaforme affidabili
La base determina il margine di manovra verso l'alto. Scelgo CPU moderne con un numero sufficiente di core e prestazioni single-thread elevate, oltre a RAM ECC per garantire l'integrità. Per i percorsi dei dati, mi affido a SSD NVMe con elevata densità IOPS e pianifico livelli RAID dedicati o profili ZFS adeguati al carico di lavoro. Le schede di rete con SR-IOV riducono il sovraccarico e consentono latenze stabili anche con un throughput elevato. 25/40/100 GbE garantisce riserve per la replica, il traffico di archiviazione e la comunicazione est-ovest.
Con Bare Metal, utilizzo direttamente le funzionalità hardware. Negli stack virtualizzati, utilizzo il passthrough in modo mirato: collegamento diretto NVMe, passaggio di SR-IOV-VF alle VM, CPU con Pinning della CPU . Nel funzionamento multi-tenant limito consapevolmente tali privilegi per garantire equità e isolamento. Una progettazione topologica ben congegnata (leaf-spine, VLAN separate, reti di gestione dedicate) previene i colli di bottiglia e semplifica la ricerca degli errori.
Hypervisor: tipo 1 vs. tipo 2 nella pratica
A hypervisor è il livello di virtualizzazione tra hardware e VM. Il tipo 1 funziona direttamente sulla macchina e riduce al minimo il sovraccarico. Il tipo 2 si trova su un sistema operativo esistente ed è particolarmente adatto per i test. In produzione utilizzo principalmente il tipo 1, perché l'isolamento e l'efficienza sono fondamentali. Per le configurazioni di laboratorio utilizzo il tipo 2 perché è facile da usare.
Sono importanti il CPU pinning, la NUMA awareness e lo storage caching. Con queste impostazioni controllo la latenza e il throughput. Gli snapshot, la migrazione live e le funzioni HA riducono notevolmente i tempi di inattività. Scelgo le funzionalità in base al carico di lavoro, non in base ai termini di marketing. In questo modo la Virtualizzazione Prevedibile ed efficiente.
Strategie di archiviazione e layout dei dati
Lo storage determina la velocità percepita. Separo i carichi di lavoro in base al profilo di accesso: database transazionali su pool NVMe veloci con bassa latenza, lavori analitici su storage a banda larga con elevate prestazioni sequenziali. Caching con scrittura inversa Lo utilizzo solo con backup su batteria/condensatore, altrimenti si rischia la perdita dei dati. TRIM e una corretta profondità della coda mantengono le prestazioni degli SSD a lungo termine.
Negli ambienti virtualizzati, posso scegliere tra storage locale (bassa latenza, ma HA complesso) e storage condiviso (migrazione più semplice, ma hop di rete). Soluzioni come la replica a livello di blocco, Provisioning sottile con un monitoraggio rigoroso e livelli di archiviazione separati (hot/warm/cold) aiutano a bilanciare costi e prestazioni. Per i backup utilizzo repository immutabili e provo regolarmente i ripristini, non solo controllando i checksum, ma eseguendo veri e propri riavvii dei sistemi.
Il multi-tenant spiegato in modo comprensibile
Multi-tenant Significa che molti clienti condividono la stessa infrastruttura, ma rimangono logicamente separati. Segmentiamo le risorse in modo chiaro e definiamo le quote. I limiti di sicurezza a livello di rete, hypervisor e applicazione proteggono i dati. Il monitoraggio controlla il carico, l'I/O e i modelli insoliti. In questo modo manteniamo i costi sotto controllo e reagiamo in modo flessibile ai picchi.
Il punto di forza risiede nell'elasticità. Posso assegnare o liberare capacità in modo tempestivo. I modelli pay-as-you-go riducono i costi fissi e incoraggiano la sperimentazione. Allo stesso tempo, impongo limiti rigidi contro gli abusi. Con chiari Politiche scalabile, multi-tenant, sicuro e pianificabile.
Pianificazione delle risorse: gestire consapevolmente l'overcommit
L'overcommit non è un tabù, ma uno strumento. Definisco limiti massimi chiari: overcommit della CPU moderato (ad es. da 1:2 a 1:4, a seconda del carico di lavoro), RAM quasi nulla o nulla (memory ballooning solo con carico calcolato), overcommit dello storage con telemetria stretta. Pagine enormi stabilizzano i servizi che richiedono molta memoria, Collegamento NUMA impedisce le latenze cross-socket. Considero lo swap come un airbag, non come una modalità di guida: i budget RAM assegnati devono essere sufficienti.
- CPU: pin core critici, riservare core host per attività hypervisor.
- RAM: utilizza prenotazioni e limiti, evita il ballooning incontrollato.
- Archiviazione: pianifica i budget IOPS per cliente e imposta lo scheduler I/O in base al profilo.
- Rete: QoS per coda, SR‑IOV per la latenza, percorsi dedicati per lo storage.
Vicini rumorosi, isolamento e prestazioni tangibili
Mi inchino Vicino rumoroso in modo mirato. I limiti della CPU, i limiti I/O e la QoS di rete proteggono i servizi dal carico esterno. I pool di storage dedicati separano i dati critici in termini di latenza. vSwitch e firewall separati escludono il traffico incrociato. Testo scenari con generatori di carico e misuro gli effetti durante il funzionamento.
La trasparenza crea fiducia. Utilizzo metriche come la latenza P95 e P99 invece dei valori medi. Gli avvisi reagiscono al jitter, non solo ai guasti. In questo modo riesco a individuare tempestivamente i colli di bottiglia e intervenire. I clienti rimangono isolati e la Esperienza dell'utente rimane costante.
Osservabilità, test e SLO affidabili
Misuro sistematicamente: metriche, log e tracce confluiscono insieme. Per i servizi utilizzo il metodo RED (Rate, Errors, Duration), per le piattaforme il metodo USE (Utilization, Saturation, Errors). Definisco gli SLO per ogni servizio, ad esempio 99,9% con latenza P95 inferiore a 150 ms, e li collego agli avvisi su Bilanci di errore. In questo modo evito un eccesso di allarmi e mi concentro sull'impatto sugli utenti.
Prima di apportare modifiche, eseguo test di carico: baseline, stress, spike e soak. Verifico come si comportano le latenze in caso di congestione e dove interviene la contropressione. Esperimenti sul caos Verificare a livello di rete, archiviazione e processi se l'auto-riparazione e il failover funzionano davvero. I controlli sintetici da più regioni rilevano errori DNS, TLS o di routing prima che gli utenti se ne accorgano.
Confronto: bare metal, virtualizzazione e multi-tenant
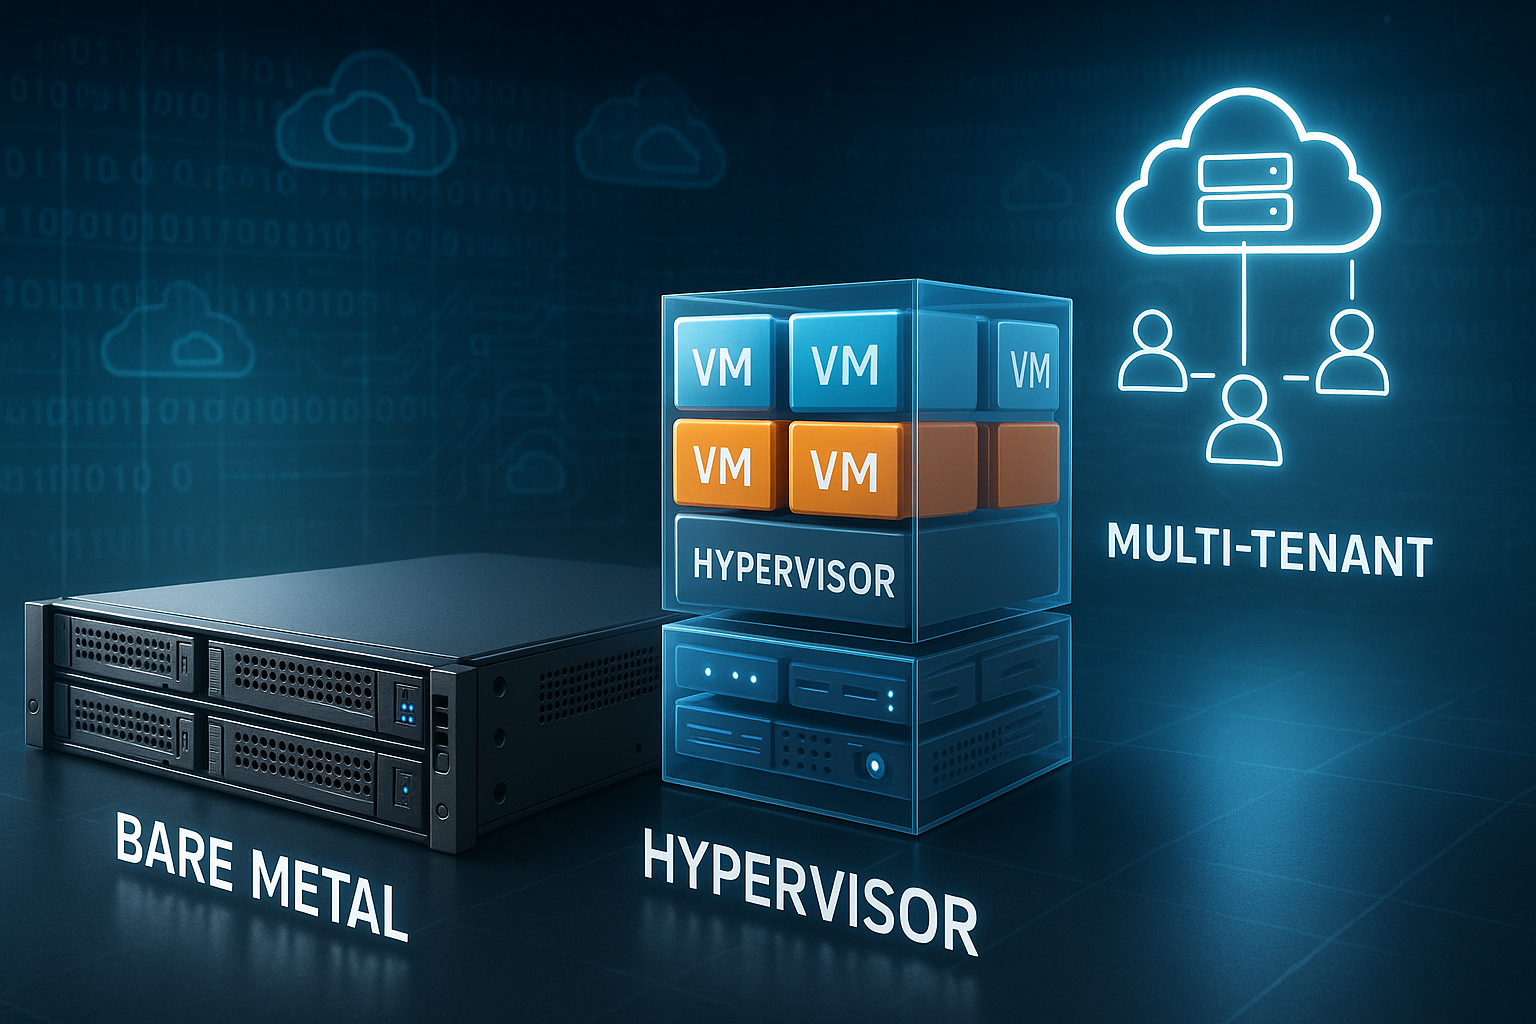
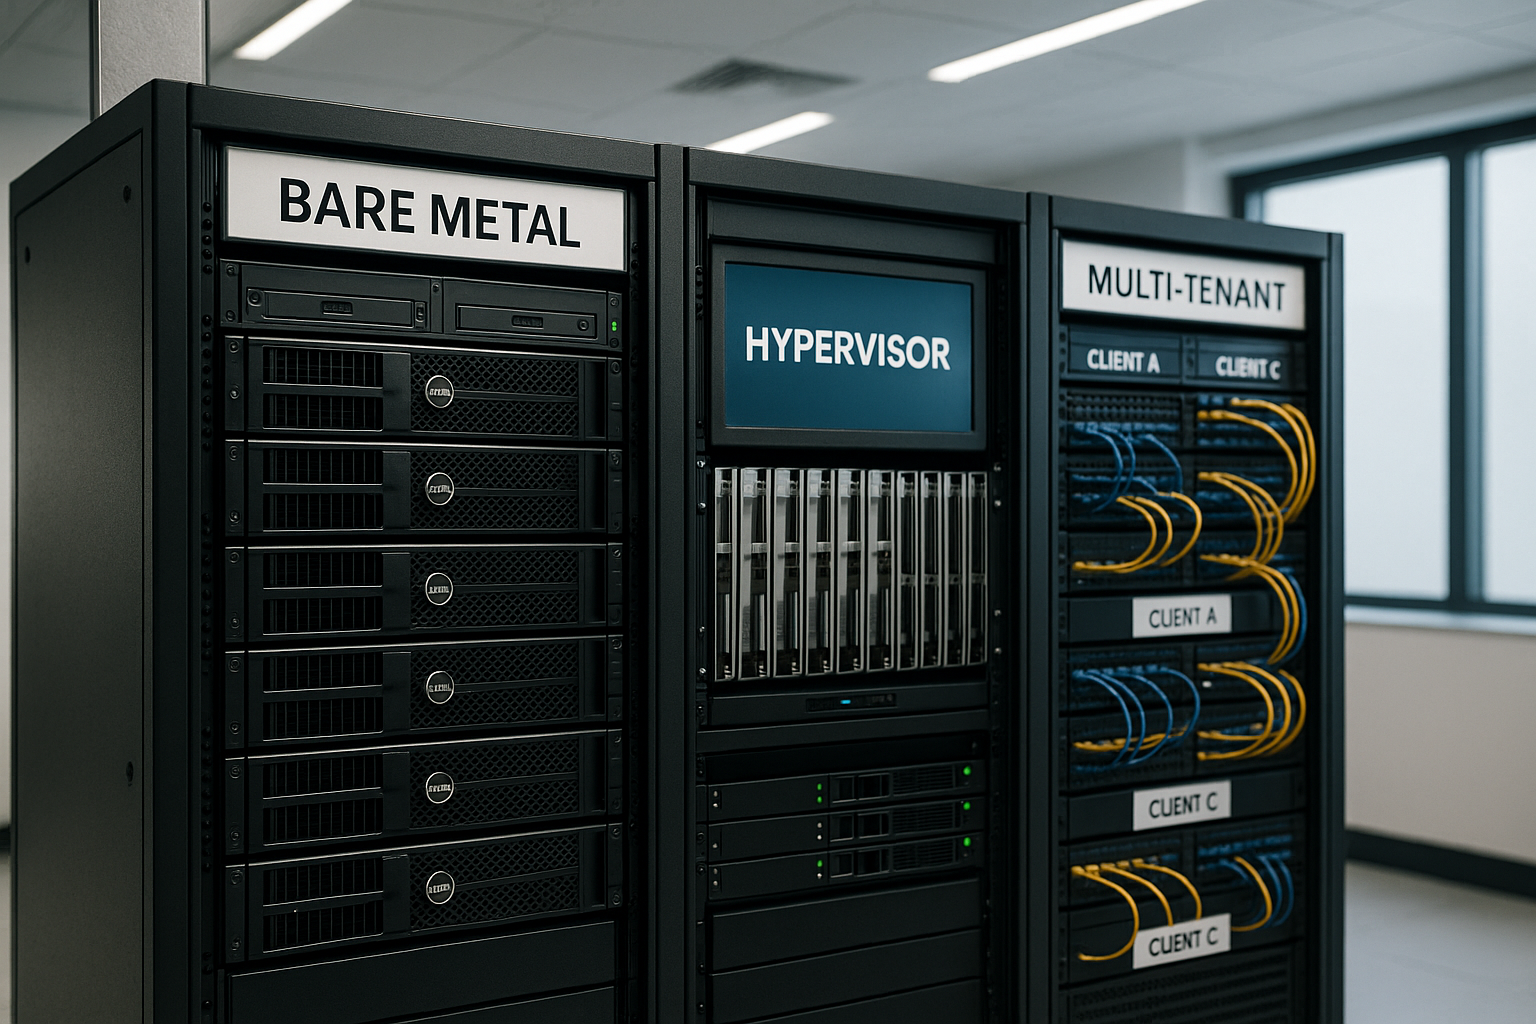
Classifico i modelli di hosting in base a controllo, prestazioni, sicurezza, scalabilità e prezzo. Chi richiede il massimo controllo sceglie Metallo nudo. Chi desidera rimanere flessibile sceglie la virtualizzazione di tipo 1. Per team dinamici e carichi variabili è consigliabile il multi-tenant. La tabella seguente mostra le differenze in sintesi.
| Criterio | Metallo nudo | Virtualizzato | Multi-tenant |
|---|---|---|---|
| controllo delle risorse | Esclusivo, piena sovranità | Basato su VM, controllabile con precisione | Assegnato dal software |
| Prestazioni | Molto elevato, overhead minimo | Elevato, overhead ridotto | Varia a seconda della densità |
| Sicurezza | Separati fisicamente | Isolato tramite hypervisor | Separazione logica, politiche |
| Scala | Legato all'hardware | Rapidamente tramite VM | Molto flessibile e veloce |
| Prezzo | Più alto, pianificabile | Mezzi, in base all'utilizzo | Da conveniente a moderato |
| Applicazioni tipiche | Conformità, carico elevato | Allround, Dev/Prod | SaaS, progetti dinamici |
Non prendo mai decisioni in modo isolato. Prendo in considerazione l'architettura dell'applicazione, il know-how del team e il budget. Vengono presi in considerazione anche i backup, i piani di DR e l'osservabilità. In questo modo la piattaforma rimane gestibile e Scalabile. I costi operativi a lungo termine contano tanto quanto l'affitto a breve termine.
Modelli operativi e automazione
Automatizzo fin dal primo giorno. Infrastruttura come codice definisce reti, host, politiche e quote. Immagini d'oro e le baseline firmate riducono la deriva. Le pipeline CI/CD creano immagini riproducibili, aggiornano i certificati e avviano i rollout Canary. Per le attività ricorrenti pianifico finestre di manutenzione, le comunico con anticipo e tengo pronti i percorsi di rollback.
Controllo la deriva della configurazione con audit periodici e lo stato desiderato. Le modifiche vengono inserite nella piattaforma tramite processi di cambiamento: piccole, reversibili e osservabili. Gestisco i segreti in modo versionato, con rotazione e token di breve durata. In questo modo il funzionamento rimane veloce e allo stesso tempo sicuro.
Pianificare costi, scalabilità e SLA in modo adeguato alle esigenze quotidiane
Non calcolo solo l'hardware, ma anche il funzionamento, le licenze e l'assistenza. Per il bare metal prevedo un margine per i pezzi di ricambio e le finestre di manutenzione. Negli ambienti multi-tenant calcolo il carico variabile e le possibili riserve. Uno SLA chiaro protegge gli obiettivi di disponibilità e i tempi di risposta. In questo modo i costi e Servizio perpendicolare.
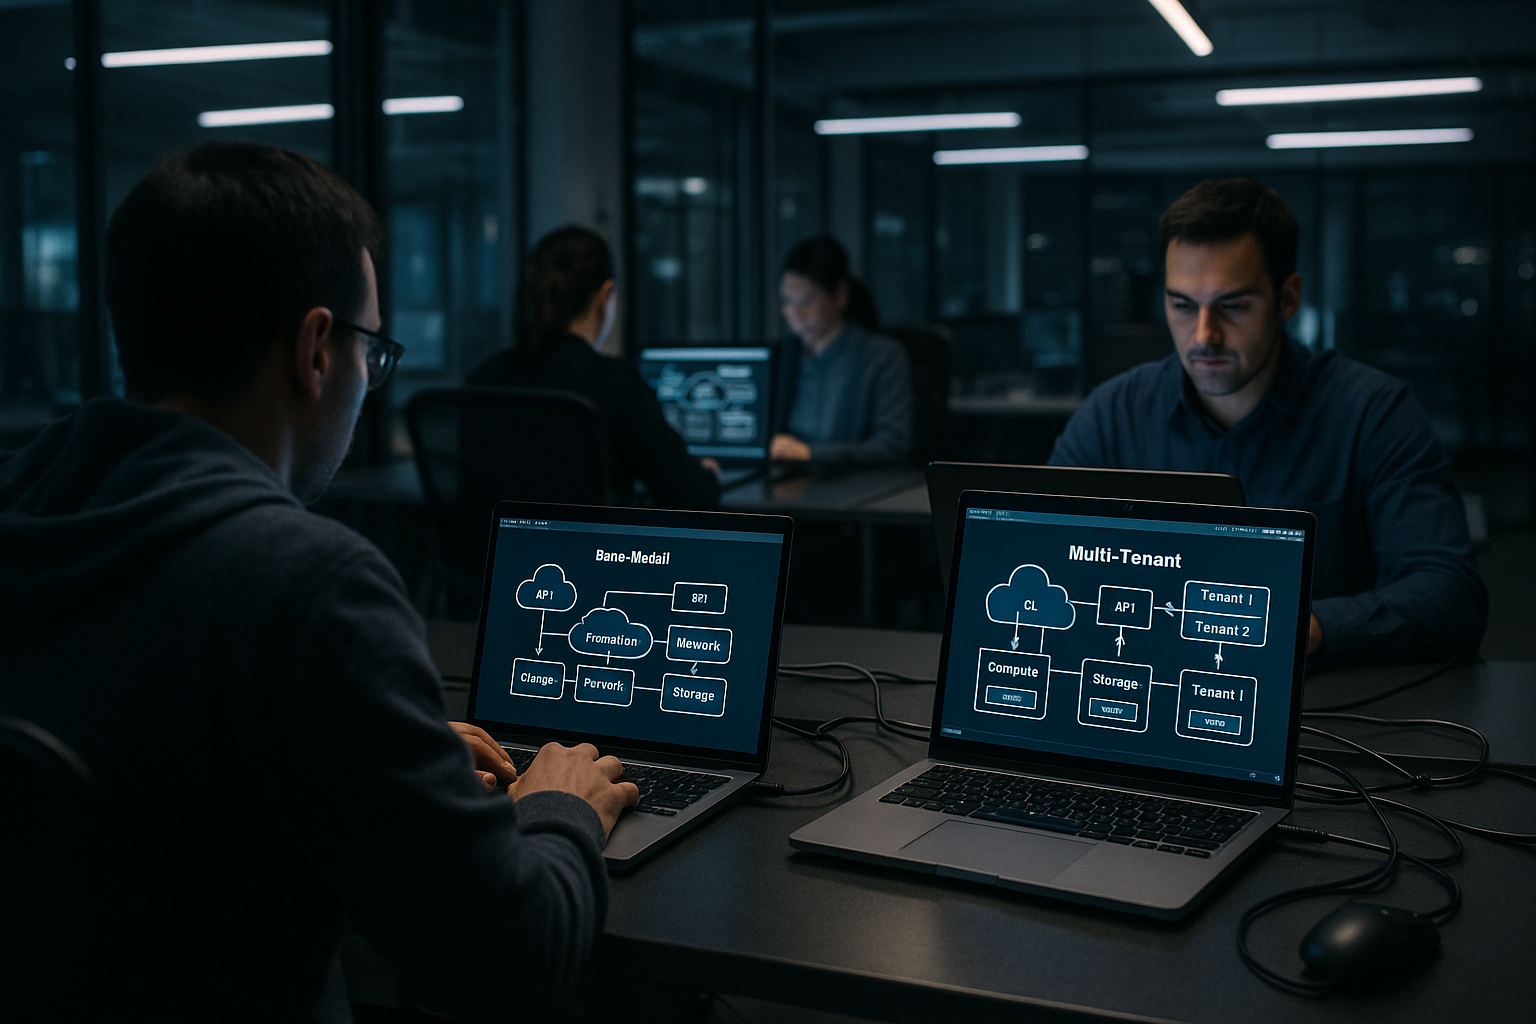
Inizio il ridimensionamento in modo conservativo. Eseguo il ridimensionamento verticale finché ha senso, quindi quello orizzontale. Il caching, i CDN e lo sharding dei database stabilizzano i tempi di risposta. Misuro gli effetti prima del rollout in staging. Quindi imposto le impostazioni appropriate. Limiti produttivo.
Pianificare la migrazione in modo accurato e ridurre al minimo il lock-in
Comincio con un inventario: dipendenze, quantità di dati, requisiti di latenza. Successivamente decido tra Lift-and-shift (veloce, poche modifiche), ripiattaforma (nuova base, stessa app) e refactoring (più impegnativo, ma più efficace nel lungo termine). Sincronizzo i dati con replica continua, cutover finale e livelli di fallback chiari. Se necessario, pianifico tempi di inattività brevi e notturni, con un runbook meticoloso.
Per contrastare il vendor lock-in, punto su formati aperti, immagini standardizzate e livelli di rete e archiviazione astratti. Mi occupo dei piani di uscita: come esportare i dati? Come replicare le identità? Quali passaggi eseguire e in quale ordine? In questo modo la piattaforma rimane flessibile, anche se l'ambiente cambia.
Gestione finanziaria (FinOps) nella quotidianità
Gestisco attivamente i costi. Impostiamo obiettivi di utilizzo per ogni livello (ad es. 60-70% CPU, 50-60% RAM, 40-50% Storage-IOPS), etichettiamo le risorse in modo chiaro e creiamo trasparenza tra i team. Right-sizing Elimino i periodi di inattività e utilizzo le prenotazioni solo quando il carico di base è stabile. Gestisco i picchi in modo flessibile. Lo showback/chargeback motiva i team a rispettare i budget e a richiedere capacità in modo ragionevole.
Virtualizzazione o container?
Paragono le macchine virtuali a contenitori in base alla densità, al tempo di avvio e all'isolamento. I container si avviano più rapidamente e utilizzano le risorse in modo efficiente. Le VM offrono una separazione più forte e sistemi operativi guest flessibili. Sono comuni le forme miste: container su VM con hypervisor di tipo 1. Maggiori informazioni sono disponibili nella mia guida. Container o VM.
L'importante è l'obiettivo dell'applicazione. Se richiede funzioni del kernel, utilizzo le VM. Se richiede molte istanze di breve durata, utilizzo i container. Proteggo entrambi i mondi con politiche di immagine e firme. Separo i segmenti di rete in modo finemente granulare. In questo modo le implementazioni rimangono veloci e pulire.
Utilizzare in modo sensato i modelli ibridi
Separo i dati sensibili Metallo nudo e gestisco front-end elastici virtualizzati o in cluster multi-tenant. In questo modo combino sicurezza e agilità. Gestisco i picchi di traffico con il ridimensionamento automatico e le cache. Proteggo i flussi di dati con sottoreti separate e collegamenti crittografati. Ciò riduce i rischi e mantiene i costi sotto controllo.
Un confronto pratico mostra se il mix è adeguato, come Bare metal vs. virtualizzato. Comincio con SLO chiari per ogni servizio. Successivamente, definisco gli obiettivi di capacità e i percorsi di escalation. Testo il failover in modo realistico e regolare. In questo modo l'interazione rimane Affidabile.
Sicurezza, conformità e monitoraggio alla pari
Io tratto Sicurezza Non come add-on, ma come parte integrante dell'azienda. L'hardening inizia dal BIOS e termina con il codice. Gestisco i segreti in modo centralizzato e con versioni. Le reti zero trust, l'autenticazione a più fattori (MFA) e gli accessi basati sui ruoli sono lo standard. L'applicazione delle patch segue cicli fissi con finestre di manutenzione chiare.
Garantisco la conformità tramite registrazione, tracciamento e audit trail. Raccolgo i log in modo centralizzato e correlo gli eventi. Priorizzo gli allarmi in base al rischio, non alla quantità. Le esercitazioni mantengono il team reattivo. In questo modo la piattaforma rimane verificabile e Trasparente.
Residenza dei dati, politiche di cancellazione e gestione delle chiavi
Definisco chiaramente dove possono essere conservati i dati e quali percorsi devono seguire. Crittografia dei dati inattivi e in transito sono standard, gestisco le chiavi separatamente dalla posizione di archiviazione. Utilizzo modelli BYOK/HYOK quando è richiesta la separazione tra operatore e detentore dei dati. Per le cancellazioni si applicano processi tracciabili: dalla cancellazione logica alla distruzione crittografica fino allo smaltimento fisicamente sicuro dei supporti dati. In questo modo soddisfo i requisiti di protezione dei dati e verificabilità.
Efficienza energetica e sostenibilità
Pianifico tenendo conto dell'efficienza. Le moderne CPU con buoni valori di prestazioni per watt, configurazioni NVMe dense e alimentatori efficienti riducono il consumo. Il consolidamento offre più vantaggi rispetto alle isole: meglio pochi host ben utilizzati che molti host semivuoti. Ottimizzo il raffreddamento e i flussi d'aria tramite la disposizione dei rack e le zone di temperatura. La misurazione è obbligatoria: le metriche di potenza confluiscono nei modelli di capacità e di costo. In questo modo risparmio energia senza sacrificare le prestazioni.
Sommario: Utilizzare con sicurezza il gergo del web hosting
Uso Metallo nudo, Quando il controllo totale, le prestazioni costanti e la separazione fisica sono fondamentali. Per i progetti flessibili, mi affido alla virtualizzazione basata su hypervisor e, se necessario, la combino con i container. Scelgo il multi-tenant quando la priorità è data all'elasticità e all'efficienza dei costi e quando è garantito un buon isolamento. L'ibrido combina i punti di forza, separa le parti sensibili e si adatta dinamicamente ai margini. Con valori di misurazione chiari, automazione e disciplina, il gergo del web hosting non rimane un ostacolo, ma diventa uno strumento per piattaforme stabili e veloci.