
CloudLinux レポート これにより、個々のアカウントにどのLVE制限が適用されているか、またCPU、メモリ、I/O、あるいはエントリープロセスが実際にどこでボトルネックとなっているかが明確にわかります。私はこれらのデータを重点的に分析し、繰り返し発生する障害、日ごとの傾向、および差し迫ったボトルネックを特定し、そこから具体的な最適化策を導き出しています。.
中心点
分析を効率的に進められるよう、まず以下の要点をまとめておきます。.
- LVEの主要指標 正しく読み取る:SPEED、MEM、IO、IOPS、PNO、EP
- リアルタイムデータ LVE Manager と lvetop を使って確認する
- 履歴 lveinfo、lvechart、cloudlinux-statistics 経由
- 障害 優先順位付け:頻度、時期、原因
- 対策 CPU、RAM、I/O、EPについて導出する
重要な指標の読み方:SPEED、MEM、IO、IOPS、PNO、EP
私はどの分析も、まず 主な数字, 、CloudLinuxがLVEの文脈で示すものです。 SPEEDは割り当てられたCPU処理能力、MEMはRAM使用量、IOはデータスループット、IOPSはI/O操作の回数を表します。PNOは実行中のプロセスの総数、EPはWebアクセスを制限する同時エントリープロセスの数を示します。 これらの値が恒常的に高い場合は、一時的なピーク問題ではなく、構造的な負荷プロファイルである可能性が高いです。私は常に、制限値が継続的に達しているのか、それともスロットリングなしで説明できる単発的な急上昇が発生しているのかを確認するようにしています。.
| キーパーソン | 意味 | 典型的な症状 | 初期チェック |
|---|---|---|---|
| SPEED | CPU性能(割合/上限) | PHPの実行時間が長い、タイムアウト | PHPプロファイル、オプコードキャッシュ、キャッシュの確認 |
| MEM | アカウントごとのメモリ容量 | OOMによる強制終了、高負荷時のエラー500 | PHPのmemory_limit、プラグイン、クエリの確認 |
| 入出力 | スループット(MB/s) | ダウンロード/アップロードの速度が遅い | スタティックキャッシュ、メディア圧縮、ストレージ |
| IOPS | I/O操作の数 | DB/ファイルへのアクセスが遅い | インデックス、クエリプラン、オブジェクトキャッシュ |
| PNO | 全体プロセス | サーバー負荷の増加 | デーモン/Cronのオーバーハング、ワーカー制限 |
| EP | 同時ウェブアクセス数 | Peaksでの503エラー | HTTPキャッシュ、レート制限、ボットの確認 |
LVE Manager と lvetop によるリアルタイム監視
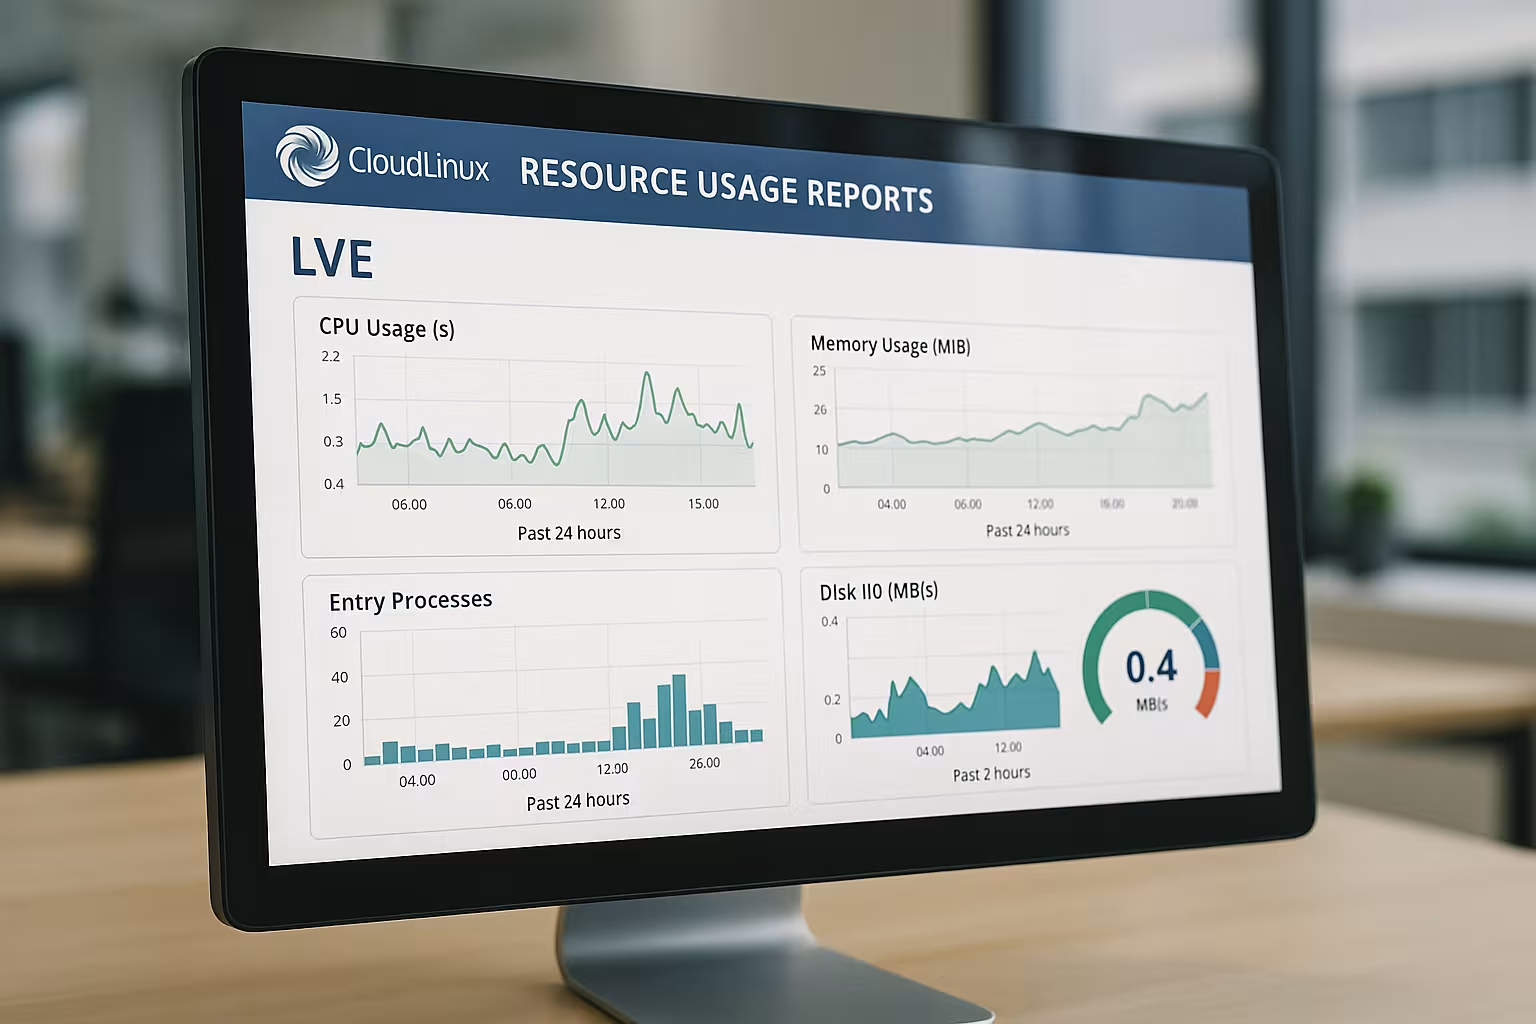
即時の分析には、私は リアルタイムデータ LVE Managerと、シェル上のlvetopです。「Current Usage」ビューでは、CPU、RAM、I/O、IOPS、プロセス、およびエントリープロセスの動作状況をリアルタイムで確認できます。負荷のピーク時には、EPとSPEEDのどちらが先に限界に達するかを観察します。これは、その後の対応策に影響を与えるからです。 lvetopは、リソースを最も多く消費しているアカウントを即座に特定し、必要に応じてスロットリングや最適化を行うのに適しています。インターフェースをより深く活用したい場合は、制限値や表示項目を目的に合わせて調整できます。私はその際、このガイドをよく参考にしています: LVE Manager の設定.
歴史的分析:lveinfo、lvechart、cloudlinux-statistics
トレンドは次のような方法で把握しています 履歴 そして、単なるスナップショットだけでなく、障害履歴も把握できます。lveinfoを使えば、時間範囲を指定して、制限がいつ正確にトリガーされたか、またそれがどのくらいの頻度で発生したかを確認できます。 lvechartは、数時間や数日単位のピークを視覚的に表示してくれるため、時間帯ごとのパターンが明らかになります。アカウントごとに長期的な時系列データが必要な場合は、cloudlinux-statisticsが分析を補完してくれます。これらを組み合わせることで、「いつ」「どのくらいの頻度で」「どのような条件下で」負荷が発生しているのかという疑問に対する答えを得ることができます。.
障害の理解と優先順位の付け方
「Fault」とは、つまり:その 制限 が発生したため、CloudLinuxが帯域制限をかけました。そこで、私はまず発生頻度順に、次にリソースの種類と時間帯順にフォルトを並べ替えています。 昼間のEPフォルトはトラフィックのピークやボットによるものであることが多いのに対し、夜間のRAMフォルトはCronジョブやバックアップに関連している傾向があります。 CPUフォールトが頻発する場合は、非効率なPHPルーチン、破損したキャッシュ、または制御されていないタスクを探します。この分類により、ユーザーが顕著に制限を受けている箇所を正確に特定して最適化を行えるため、時間を節約できます。.
原因の特定:典型的なパターンと対策
これまでの経験から、私は次のように分類しています サンプル 具体的な原因を迅速に特定します。EP値が持続的に高い場合は、同時リクエストが多すぎるか、エッジキャッシュが機能していないことを示唆しています。RAM使用量が継続的に高い場合は、多くの場合、プラグイン、テーマ、またはリーキープロセスが原因です。 IOおよびIOPSのピークは、データ集約型のタスク、インデックス未設定のクエリ、あるいは多数の小さなファイルアクセスを示唆しています。誤った解釈を避けるため、私は並行してシステムの健全性指標を確認しています。手っ取り早く把握するには、以下の CloudLinux ヘルスチェック.
cronジョブ、バックアップ、ボットの識別
多くの「Fault」シリーズについては、以下を見てみるとわかります。 時点 およびタスク。トラフィックの急増が毎正時の直後に発生する場合、多くの場合、Cronジョブが並行して実行されており、訪問者とのリソース競合が生じている可能性があります。夜間に繰り返し発生するトラフィックのピークは、I/OやIOPSを限界まで使い切っているバックアップ作業によるものであることがよくあります。 Analyticsにそれに見合うトラフィックがないにもかかわらず、顕著なEPフォールトが発生している場合は、静的コンテンツを迂回するボットやスクレイパーが原因であることがよくあります。そのような場合、私はレート制限を設定し、ジョブをトラフィックの少ない時間帯にずらし、エッジキャッシュやページキャッシュを徹底的に有効にします。.
リセラーおよびアカウントごとのデータを分析する
大規模な構成では、私は レベル 明確:リセラー、その顧客、および個々のアカウント。LVEマネージャーはまさにこの視点を提供し、どのサブツリーが制限値に影響を与えているかを示してくれます。これにより、特定の顧客に問題があるのか、それともリセラー構造内の複数のプロジェクトが同時に制限値を引き下げているのかを把握できます。 サポートプロセスにおいては、影響を受けるアカウントをマークし、対策を登録することで、繰り返し発生するチケットをより迅速に解決できるようにしています。この透明性により、リソースを公平に配分し、顧客ごとのコストを明確かつ追跡可能な状態に保つことができます。.
許容値を適切に設定し、料金体系を調整する
私は限界を設定する 現実的, 、最大値に設定しないこと。EPの制限が厳しすぎると503エラーが発生し、SPEEDの値が低すぎるとPHPのレスポンスが遅延します。 定期的にエラーが発生する場合は、まず最適化を確認し、その後、料金プランを見直してください。プロジェクトがビジネス上重要になってきた場合は、ピーク負荷を軽減し、安定性をもたらす、より高めのプランを選択する価値があります。私は、その決定の根拠が明確になるよう、変化のグラフに効果を記録しています。.
データベースを多用するプロジェクト:I/O および IOPS の最適化
データベース中心のサイトについては、以下を確認しています IOPS また、IOは常にクエリの品質と並行して変化します。インデックスのない小さなクエリが多数実行されると、高いIOPSが発生し、応答時間が悪化します。経験上、オブジェクトキャッシュ、クエリキャッシュ、および最適化されたインデックスにより、こうしたクエリの洪水を大幅に軽減できます。 トレンド分析を行う際には、さらにデータベースレポートを確認し、LVEの推移と照らし合わせています。このガイドは、そのための確かな入門書となっています。 MySQL ガバナーレポート, 、DBの負荷を適切に分類するために。.
モニタリング・プレイブック:アラームからアクションへ
測定値から、私は プレイブック, 、あらゆるエスカレーションを明確に可視化する。ステップ1:本番環境で、現在リミットが適用されているか、どのリソースが最初にダウンするかを検証する。ステップ2:履歴を開き、時間枠を照合して、繰り返し発生している箇所を特定する。ステップ3: 原因を特定する――コードパス、キャッシュ、DB、Cron、ボット――そしてテスト基準を伴った対策を定義する。ステップ4:対応後、本番環境および履歴データを再度確認し、障害とレイテンシが減少しているかを確認する。この決まった手順により、場当たり的な対応を避け、再現性のある結果を生み出すことができる。.
極限の相互依存関係を正しく解釈する
実際には、リミットが単独で適用されることはめったにありません。そのため、私は 相互作用 EP、SPEED、MEM、IO/IOPSの関係:EPとSPEEDが同時に上昇する場合、通常はリクエストあたりのCPUがボトルネックとなります。この場合、ページキャッシュやエッジキャッシュが有効に機能すれば、両方の指標は同時に低下します。 EPが上昇している一方でSPEEDが常に低い状態が見られる場合、Webサーバー内でリクエストが滞留しています。これは多くの場合、ワーカーの不足、キープアライブの設定、またはブロックする外部呼び出し(APIやメールなど)が原因です。 SPEEDが適度な水準にあるにもかかわらずMEM-Faultsが発生している場合は、数は少ないもののメモリを大量に消費するプロセス(画像変換や大規模なエクスポートなど)が実行されていることを示唆しています。 目立ったCPU負荷を伴わないIO/IOPSのピークは、データ集約的なファイルまたはデータベースへのアクセスを示しています。私はこれらの相関関係を利用して、 最初の仮説 コードやサーバーの詳細について掘り下げる前に、これを設定しておく。.
実践:lvetop、lveinfo、cloudlinux-statisticsを効率的に活用する
迅速な診断結果を出すため、私は明確な クエリ およびフィルタリング。lvetop を使えば、1秒ごとにリソースを最も消費しているプロセスを確認したり、CPU、MEM、IOの順で並べ替えたりできます。 lveinfo を使用すると、1時間、24時間、7日間のウィンドウを設定して、アカウントごとの障害発生時刻、ピーク値、影響を受けたリソースを一覧表示できます。cloudlinux-statistics はより長期の時系列データを提供し、対策の効果(実施前/実施後)を裏付けるのに適しています。 私は、介入のたびに必ず、期間、影響を受けたアカウント、リソースごとの最大値、障害件数、およびアプリケーションやWebモニタリングからの応答時間を記録しています。これにより、最適化の効果を実証でき、「推測」だけで制限値が緩和されるのを防ぐことができます。.
Webスタックの詳細:PHPハンドラー、ワーカー、OPcache
大きな影響力を持つ要素は、 PHPの実行: アカウントごとのPHPワーカー数、そのRAM割り当て(memory_limit)、およびOPcacheの設定。キャッシュなしでワーカー数が多すぎるとEP/PNOとMEMが増加し、少なすぎるとリクエストが滞留する(EPが増加し、応答時間が長くなる)。 そこで、私は「スイートスポット」を見極めます。つまり、必要なだけワーカーを確保しつつ、その数を最小限に抑えることです。OPcacheは十分な容量(メモリとインターナライズされた文字列)を確保する必要があります。そうしないと、PHPが絶えず再コンパイルを行い、SPEEDを押し上げてしまいます。 さらに、静的リソースが実際にWebサーバー(PHPではなく)から提供されているか、Keep-AliveやHTTP/2のマルチプレクシングが正しく機能しているかを確認します。目標は、動的なリクエストを 減らす そして、残りの作業を迅速に片付けること。.
キャッシュ戦略を一貫して活用する
私は3つのレベルに区別しています: エッジ/CDNキャッシュ 世界的な負担軽減のために、, HTTP/ページキャッシュ PHPの直前で、そして オブジェクトキャッシュ アプリケーション内において。エッジキャッシュは、静的アセットのEPとIOを大幅に削減します。ページキャッシュは動的ヒットを減らし、EP/SPEEDに直接影響を与えます。オブジェクトキャッシュ(例:頻繁なDBルックアップ用)は、IOPSとCPU負荷を低減します。重要なのは、安定した キャッシュ・キー (例:不要なCookieを排除する)ほか、ページの種類ごとに適切なTTLを設定します。管理画面やカート画面については例外を設ける予定ですが、それ以外の場所では、キャッシュ率を可能な限り高くすることを目指します。 有効化後は、EPフォルトが発生していないか、応答時間の中央値が短縮されているかを監視します。
RAM管理:memory_limit、プロセス、およびメモリリーク
MEMフォルトは、多くの場合、以下の理由により発生します。 メモリリミット 余裕を持って設定されており、並列処理によってその合計が許容範囲を超えてしまう。そこで、私は次のように調整を行う:一般的なリクエストにはどれくらいのRAMが必要か?そこから、現実的に妥当なワーカー数の上限を導き出す。 さらに、PHPライブラリやプラグインをスリムに保ち、未使用の拡張機能を削除し、長時間実行されるスクリプト(エクスポート、インポート、画像処理)にメモリリークがないかチェックします。 OPcacheはコンパイル結果をキャッシュすることでRAMへの負荷を軽減しますが、その容量自体も小さすぎてはなりません。繰り返し発生するピーク時には、プロファイリングを用いて「負荷の高い」パスを特定し、的を絞って対策を講じます。これにより、一律に制限値を引き上げるよりも、多くの場合、RAMを節約できます。.
I/OとIOPSを的確に抑制する
IO/IOPSのピークは、多数の小さなファイルやDBへのアクセスによって発生します。私は可能な限りワークロードを統合しています。具体的には、サムネイルの生成をオンデマンドではなくバッチ処理で行い、アセットのミニファイ化を各リクエストごとではなくビルド時に実施し、セッションおよび一時ストレージを1つの オブジェクトキャッシュ ファイルへのアクセス回数を減らすために外部化します。データベース内では、頻繁に使用されるWHERE句やJOIN句に対してインデックスを優先的に設定し、N+1クエリを排除します。 並行して、LVEの履歴とMySQL GovernorのDBレポートを比較し、ホットスポットを特定します。目標は、多数の小さなIOPSを、少数の効率的なアクセスに変換することです。これにより、ピークが平滑化され、障害発生の可能性が低減されます。.
EPエラーの緩和:キューイングと訪問者の流れ
EPは同時アクセス数を制限します。キャッシュが空の状態のときに多数のリクエストが集中すると、すぐにEPフォルトが発生してしまいます。私は次のようにしてこれを防いでいます。 キュー PHPを導入する前に(Webサーバーのリクエストキューを短くするため)、Keep-Aliveを適切に設定し、パーソナライズされていない動的パスについては一貫してキャッシュさせるようにします。 ボットに対してはレート制限を設定し、明らかな悪意のあるアクターを早期にブロックしています。さらに、リクエストパス内のサードパーティ呼び出しもチェックしています。リクエストをブロックする外部サービスは、リクエストあたりの滞在時間を増加させ、その結果EPを消費してしまうためです。可能な場合は、外部統合をジョブやキューに移行しています。.
リソースを節約しながらCronジョブとバックアップを計画する
繰り返し行われるタスクについては、ピーク時間帯から切り離して調整を行っています。cronテーブルのタイミングを調整(実行時間を数分ずらす)し、ロックファイルを使って並列実行を防ぎ、負荷を Nicing およびバッチサイズ。バックアップはトラフィックが少ない時間帯にスケジュールし、IO/IOPSが許容範囲内に収まるよう増分方式を心がけています。負荷の高いアプリ内ジョブについては、MEMやSPEEDが急上昇しないよう、同時実行ワーカー数に制限を設けています。 その効果については、経過を見ながら確認しています。夜間のフォルトは減少しているか、1時間ごとの負荷の急上昇は抑えられているか、といった点です。
CageFS、ファイルシステムとiノードの概要
LVEリミット以外にも影響を与える ファイルシステムの要因 パフォーマンス:数百万もの小さなファイル(キャッシュの断片など)は、メタデータへのアクセスを増やし、IOPSを押し上げます。私はキャッシュディレクトリを整理整頓し、適切に集約されたキャッシュによってファイルの氾濫を抑制し、iノードの使用率を確認しています。 CageFSは分離を実現しますが、一時ファイルが誤った場所に配置されると(例:tmpディレクトリではなくWebルートに保存されるなど)、不必要にI/O負荷が増加します。 これらの領域を定期的にヘルスチェックすることで、I/Oのボトルネックが、単なるCPUやRAMの問題と誤って解釈されるのを防ぐことができます。.
リセラーの文脈における透明性とコミュニケーション
リセラー環境では、私は以下の内容を記録しています ロードドライバー 各サブシステムごとに状況を把握し、対策を記録します。どのような制限が設定されたか?どのような最適化が計画されているか?「前」と「後」のグラフはどのようなものか?こうした透明性により、サポート対応が迅速化され、最適化の余地が尽きた場合には料金プラン変更への理解が得られやすくなります。 私は、対応を開始する閾値(例:再発する障害が1日あたりN回以上、または応答時間の中央値がXミリ秒以上)を設定し、それらを明確な対応手順と結びつけます。これにより、チケット管理における無限ループの発生を防ぎます。.
よくある誤解を避ける
いくつか決まったパターンが定期的に見られます。CPU使用率の上昇は ない 自動的に「CPU不足」という警告が表示される――多くの場合、キャッシュが機能していないか、クエリの効率が悪いことが原因です。 EPフォルトが多いからといって、必ずしも「トラフィックが増加している」とは限りません。ボットや、設定ミスのある監視ツール、あるいはハートビートが原因である可能性があります。MEMフォルトは、必ずしもmemory_limitを高く設定することで解決できるわけではありません。多くの場合、同時に実行されているプロセスの数が多すぎるのが原因です。 IO/IOPSのピークは、必ずしもストレージだけが原因ではありません。アプリケーションの動作パターンが引き金となることもあります。そのため、私は常に相関関係のあるグラフを用いて仮説を検証し、可能であれば簡単な対照実験(例:一部領域のキャッシュを有効にして、推移を再度確認するなど)も行っています。.
テスト、測定、再研磨
すべての変更について、私は次のように評価します。 明確な測定ポイント: ページキャッシュの有効化前/後、インデックスの追加前/後、ワーカーの調整前/後。 その際、LVEの履歴、応答時間メトリクス、エラー率(5xx/4xx)を活用します。可能であれば、影響を特定するために閑散時間帯にA/Bテストを実施します。 それでも障害が残る場合は、以下の手順を繰り返します:制限値の組み合わせを微調整し、その他のホットパスをプロファイリングし、ジョブのバッチサイズを調整します。経験上、2~3回の的を絞った反復処理を行う方が、大規模で一律的な対策よりもはるかに良い結果をもたらします。.
まとめ:CloudLinuxのリソース使用状況レポートを効率的に読み解く方法
私の評価 クラウドリナックス-データは常に3段階(ライブ、履歴、障害)で表示されます。SPEED、MEM、IO、IOPS、PNO、EPといった指標が、原因と結果の全体像を把握するための指針となります。 lvetopを使えば、誰が負荷をかけているかが即座にわかります。lveinfoとlvechartを使えば、数日単位のパターンを把握できます。繰り返し発生するFaultsから、キャッシュの最適化、クエリのチューニング、制限値の調整、あるいは料金プランの変更といった対策を導き出します。この手法により、サポート負荷が軽減され、対応の確実性が高まり、ホスティングのパフォーマンスが透明化されます。.


