 コンテンツにスキップ

マルチプロセッサシステムにおいて、IRQアフィニティがネットワーク割り込みを特定のCPUコアに割り当て、レイテンシを低減し、スループットを向上させる仕組みを、実践的な例を交えて解説します。 明確な手順、例、および表を用いて、16進数マスクの選択方法、NUMAの考慮事項、およびプロセスの適切な割り当て方法を解説します。.
中心点
- IRQアフィニティ ハードウェア割り込みを特定のCPUに的確に振り分け、オーバーヘッドを低減します。.
- CPUアフィニティ 同じコア向けのサービスをピン留めすることで、キャッシュをローカルに保持します。.
- NUMA 注意:同じノードのアダプターとコアを使用してください。.
- イラクバランス 検討する:自動配分にするか、手動で微調整するか。.
- モニタリング また、反復的な調整により、安定したレイテンシを確保しています。.
IRQアフィニティの理解:基礎と影響
Linuxホストでは、着信パケット、ディスクI/O、およびタイマーが IRQ カーネルがCPUコアに割り当てるものです。私は以下のファイルを通じて /proc/irq//smp_affinity そして .../smp_affinity_list, 、どのCPUが特定のソースを処理できるかを指定します。広範囲な標準マスクは一見柔軟に見えますが、負荷がかかるとキャッシュミス、コストのかかるコンテキストスイッチ、そして多数の CPU. 個々のNICの負荷の高いキューを定義済みのコアに割り当て、ホットスポットの負荷を軽減し、データ転送経路を短く保ちます。このルーティングにより、多数のフローが同時にアクティブになっている場合、安定性が著しく向上します。.
IRQとCPUアフィニティの調整:データをローカルに保持する
私は無事に 割り込み要求-NICキューの管轄範囲と、関連するワーカーのCPU割り当て。これについては、Webサーバーやプロキシのスレッドを タスクセット 或いは CPUAffinity= systemd において、RX/TX 割り込みも処理するコアに割り当てます。これにより、キャッシュラインがローカルに留まり、CPU 間の通信を最小限に抑えることができるため、 レイテンシー 滑らかにします。特にAPIバックエンド、リアルタイムサービス、仮想化スタックは、この一貫性の恩恵を大いに受けています。私は、フロー、ソフトIRQ、ユーザー空間が互いに正確に連携するようになるまで、本番環境の負荷下でバインディングのテストを繰り返しています。.
自動設定か微調整か:irqbalanceの適切な位置づけ
サービス イラクバランス 利用可能なコア間で割り込みを自動的に分散させるため、汎用サーバーではうまく機能します。しかし、負荷の高いネットワーク環境では、この分散がキャッシュの局所性を損ない、ターゲットを絞ったピンニングを困難にします。 特定のキューに固定のコアが必要な場合は、irqbalance の動作を制限するか、選択的に無効にしています。基本的な理解や適切なプロファイルの設定については、以下のガイドが参考になります。 irqbalance の設定. その結果、自動機能は重要度の低いIRQを処理し、私は重要なIRQを手動で割り当てている。.
手順:関連するIRQを表示する
まずは、次の内容を見てみましょう。 /proc/interrupts そして、次のようにデバイス名でフィルタリングします。 ens192, eno1 或いは エスゼロ. 最新のアダプタは複数のRXおよびTXキューを作成するため、同じNICに割り当てられているIRQ番号のグループを見つけます。 ホットスポットを迅速に特定し、負荷の高いキューを優先的にバインドするために、カウンタ値を注意深く監視しています。この状況を負荷テスト中に定期的に確認し、割り当てが長期的に有効であることを確保しています。さらに、RSS機能やオフロード機能に関する手がかりとなるため、ドライバ名も確認しています。.
# すべての割り込みを表示する
cat /proc/interrupts

# NICに関連する行のみを表示する(例:ens192)
grep -i ens192 /proc/interrupts
NUMAトポロジーを賢く活用する
複数のノードを持つホストでは、IRQを、そのノードのコアに割り当てることを優先しています。 NUMA-NICが物理的に接続されているノード。これを次のように確認します。 lscpu そして numactl --ハードウェア そして、後でマスクを作成するために適切なCPUセットを選択します。これらのネットワークパスを経由するプロセスも同様に同じノードにバインドし、メモリポリシーを通じてローカルな メモリ-割り当て。これにより、QPI/UPIリンクを介したコストのかかるリモートアクセスを回避しています。この徹底した取り組みは、レイテンシテストにおいてすぐに測定可能なメリットをもたらします。.
ビットマスクの正しい選び方:16進数ロジックの要点
ファイル smp_affinity コアIDに直接対応する16進数のビットマスクを受け入れ、大規模なシステムにも対応しています。 私はよく、CPU0を0x1、CPU1を0x2、CPU2を0x4、CPU3を0x8とするような単純なパターンから始めます。また、0xFはコア0~3をまとめて指定します。 コア数の多いマシンでは、 マスク すべてのIDを正確に反映しています。この一覧表のおかげで、誤りのない割り当てを行い、意図しない移動を防ぐことができます。以下の表は、私がよく記憶の助けとして利用しています。.
| CPU番号 | ビット(2進数) | ヘックス・マスク | ヒント |
|---|---|---|---|
| 0 | …0001 | 0x1 | CPU0 頻繁に負荷を軽減し、控えめに使用すること。. |
| 1 | …0010 | 0x2 | IRQを CPU1 ピン留めする。. |
| 2 | …0100 | 0x4 | IRQをCPU2にピン接続する。. |
| 3 | …1000 | 0x8 | IRQをCPU3にピン接続する。. |
| 0–3 | …1111 | 0xF | 4つのコアすべてを有効にすると、レイテンシがわずかに上昇することが多い。. |
| 0–7 | 11111111 | 0xFF | 分散が広いため、キャッシュの局所性が損なわれる。. |
IRQアフィニティの設定:キューをコアに割り当てる方法
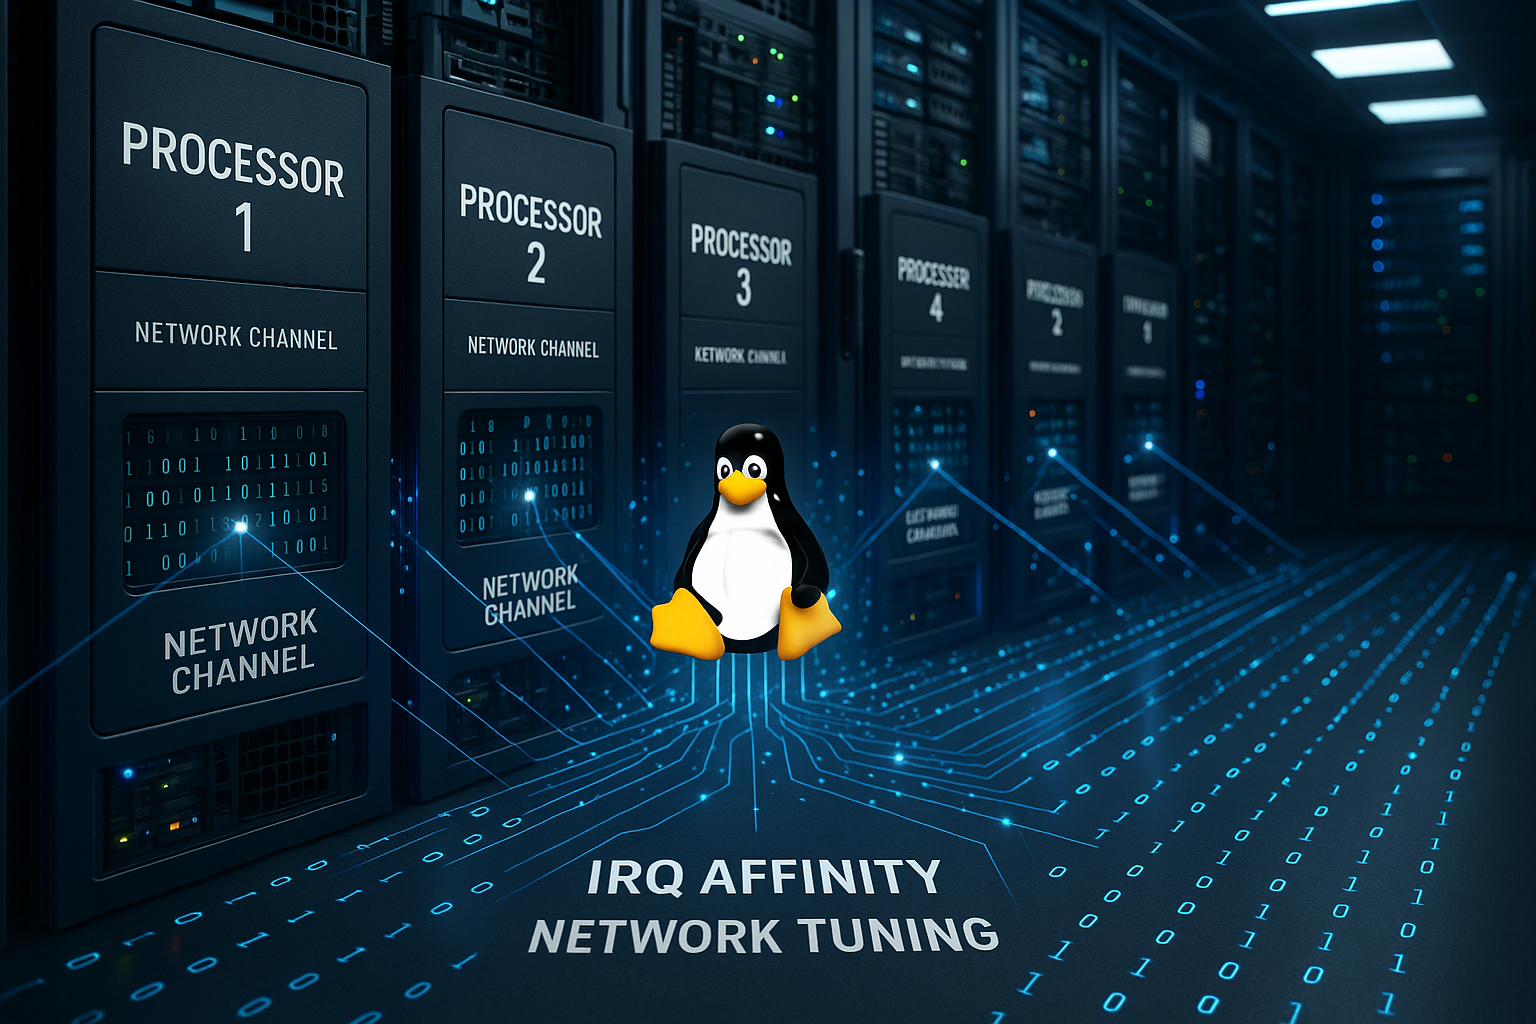
NICのキューIRQを特定した後、それらを専用の コア 1、2、3のように、並列処理をスムーズにスケーリングするためです。これにより、各RX/TXキューはそのコアに留まり、クロストークを回避するとともに、SoftIRQの処理を一貫して維持できます。微調整の過程では、分散処理が確実に機能するようになるまで、スループットとレイテンシを比較検討します。 より深く理解するために、簡単な 実践ガイド アダプターによってバリエーションがあります。これらのコマンドは、意図的にメンテナンスウィンドウ内で実行し、ブートスクリプトによって確実に実行されるようにしています。.
# の例:3つのキューIRQをCPU1~3にバインドする
echo 2 > /proc/irq/181/smp_affinity   # CPU1 (0x2)
echo 4 > /proc/irq/182/smp_affinity   # CPU2 (0x4)
echo 8 > /proc/irq/183/smp_affinity   # CPU3 (0x8)
プロセス・ピニング:サービスを同じコアに割り当てる
アプリケーション・ワーカーをそれらにピン留めします CPU, 、関連するIRQを処理し、データパスを短く保つためのものです。systemdでは、私は CPUAffinity=1 2 3 または、一度だけ次のように実行してください taskset -c 1-3. マルチワーカーサーバーでは、競合が発生しないように、ワーカーグループごとに固定のコア数を割り当てています。この割り当てにより、常に低い 遅延時間, 、CPUキャッシュが適切に保持されるためです。変更後は、htop、ss、perfを使ってスレッド、ソケット、ソフトIRQを監視しています。.
ネットワークチューニング:RSS、RPS/RFS、およびカーネルパラメータの連携
多くのNICは、パケットを RSS キューについて、その後IRQアフィニティを使ってコアにバインドします。詳細と動作原理については、以下でまとめています。 受信側スケーリング コンパクトにまとめます。さらに、ソフトIRQがハードなピンニングロジックと競合しないように、RPS/RFSを制御しています。並行して、バッファを net.core.rmem_max そして net.core.wmem_max を指定し、次のようなTCPオプションを確認してください。 tcp_timestamps. これらの構成要素は、すべて同じ目標、すなわち「高い処理能力と低いレイテンシ」の実現に寄与しています。 ビットレート.
MSI-Xとキュー・レイアウトを正しく解釈する
最新のNICはMSI-Xを採用しており、各RX/TXキューごとに独自のIRQを作成します。 まず、ドライバが現在有効にしているキューとチャネルの数を確認し、それを該当するNUMAノードのコア予算に合わせて調整します。これにより、コア数が少ないのにキューが多すぎて過負荷になることや、逆に容量が遊休状態になることを防ぎます。.
# のキュー数およびチャネル数の確認と調整
ethtool -l ens192 # 現在の制限値(RX/TX/combined)
ethtool -L ens192 combined 4  # 例:4つのキューを有効にする

# RSS間接参照およびハッシュ設定の確認
ethtool -x ens192 # 間接参照テーブルおよびハッシュキーを表示
多くのドライバは、IRQにわかりやすい名前を付けています(例:. ens192-TxRx-0). フローが「それぞれの」キューに安定して割り当てられるよう、インダイレクトション・テーブルをコア割り当てと整合させています。ハードウェアの割り当てがこれと異なると、SoftIRQの不要な移動が発生してしまいます。.
RPS/RFSとXPSを適切に活用する
RPS/RFSはソフトウェア側でパケットをコア間で分散させることができます。これはキュー数が少ないNICには適していますが、すでにRSSとIRQアフィニティによって厳密にバインドしている場合には逆効果です。そのため、私は意図的に次のいずれかを選択しています:RSSとIRQアフィニティによるハードバインド、あるいは RPSをオフに, 、あるいはハードウェアクイーの数が少ない場合や、 RPSを的確に. さらに、送信方向(TX)用にXPSを設定し、送信パケットが「適切な」コアから送信されるようにします。.
IF=ens192

# RPS を完全に無効化(RSS による適切な IRQ ピンニングが行われている場合)
for q in /sys/class/net/$IF/queues/rx-*/rps_cpus; do echo 0 > "$q"; done
echo 0 > /proc/sys/net/core/rps_sock_flow_entries

# 代替方法:RPSを特定のCPUで有効にする(例:CPU 1~3)
for q in /sys/class/net/$IF/queues/rx-*/rps_cpus; do echo 0-0,0-0,0-0,0-0 > /dev/null; done
# より良い方法:smp_affinity_list と同様の構文を使用する:
for q in /sys/class/net/$IF/queues/rx-*/rps_cpus; do echo 1-3 > "$q"; done
echo 32768 > /proc/sys/net/core/rps_sock_flow_entries
echo 32768 > /proc/sys/net/ipv4/tcp_rfs_sock_flow_entries

選択したワーカーCPUに合わせて# XPSを設定する(TXパス)
for q in /sys/class/net/$IF/queues/tx-*; do echo 1-3 > "$q"/xps_cpus; done
重要なのは一貫性です。RX-IRQ-Core、ksoftirqd-Load、およびWorker-Threadは、同じコア(またはコアのペア)上に配置する必要があります。そうすることで、多くのクロスコア・バウンス現象が解消されます。.
SMT/ハイパースレッディングおよびコアペアを考慮する
SMT 搭載システムでは、RX-IRQ 用に物理コアを 1 つ予約し、関連するワーカーを 関連スレッド 配置する――あるいは、ワークロードが計算負荷の高いものである場合は、意図的に分離する。トポロジーからスレッドのペアを特定し、ランダムな割り当てではなく、明確な判断を下す。.
# の兄弟ペアを特定する
for c in /sys/devices/system/cpu/cpu*/topology/thread_siblings_list; do
  echo "$(basename "$(dirname "$c")") : $(cat "$c")"
done
RX-IRQとユーザースペース・ワーカーを同じ物理コア上で共有すると(異なるSMTスレッド)、L1/L2の局所性は高まりますが、CPUバウンドのワークロードではボトルネックが発生する可能性があります。 あるいは、真の並列性を実現するために、IRQを同じNUMAノード内のコアXに、ワーカーをコアYに分散させる方法もあります。私はこれら2つの方法をA/Bテストで比較し、より安定したレイテンシが得られる方を選択します。.
smp_affinity_list、effective_affinity、および Defaults の使用
Hexマスクのほかに、私は以下で書くのが好きです smp_affinity_list, 、これにより、次のような分野が 1-3,6,8-9 快適に座れるようにする。確認のために、私は effective_affinity それぞれ effective_affinity_list, 、カーネルやドライバが特定のCPUを処理対象から除外する可能性があるためです(例:オフラインのコアや「管理された割り込み」など)。.
# 人間が読み取れる割り当て
echo 1-3 > /proc/irq/181/smp_affinity_list

# 実際の割り当てを確認する
cat /proc/irq/181/effective_affinity_list
新しいIRQや、ドライバのリロード後に追加されたIRQが再び広範囲に分散されないようにするため、必要に応じて以下を設定します。 /proc/irq/default_smp_affinity 適切な基準値(例:関連するNUMAノードのすべてのコア、ただしCPU0を除く)に設定します。その後、個別の重要なIRQについては、必要に応じて個別に上書きします。.
再起動や再読み込み後も状態を維持する
Affinity設定は揮発性です。 私は、ネットワーク初期化ターゲットの実行後に実行される systemd の oneshot ユニット、あるいは IRQ リストを動的に検出してマッピングする小さなスクリプトを使用して、設定を保存しています。これにより、カーネルのアップデートやリンクのリセット後も、割り当てが維持されます。.
# /usr/local/sbin/net-irq-pin.sh (例)
#!/bin/bash
set -euo pipefail
IF=${1:-ens192}
CPUS="1-3"   # 対象CPU(NUMAに一貫性のあるものを選択)
for irq in $(grep -i "$IF" /proc/interrupts | awk '{print $1}' | tr -d ':'); do
  echo "$CPUS" > /proc/irq/$irq/smp_affinity_list || true
done

# systemdユニット(概要)
# /etc/systemd/system/net-irq-pin.service
[Unit]
Description=NICのIRQをピン留め
After=network-online.target

[Service]
Type=oneshot
ExecStart=/usr/local/sbin/net-irq-pin.sh ens192

[Install]
WantedBy=multi-user.target
重要:ドライバが再読み込みされた場合やキューの数が変更された場合は、IRQ番号がずれてしまうため、スクリプトを再度実行します。.
仮想化とコンテナ:ホストとゲストを一体として捉える
KVM環境では、 ホスト 対応するNUMAノードのコアへの物理NIC-IRQ。並行して、私は ボストネット‑スレッドとQEMUプロセス(または個々のvCPU)も同様にそこに配置し、ホスト側のデータパスが短くなるようにする。 ゲスト vNICのIRQアフィニティを、ホスト側で物理コアと紐づけたvCPUに割り当てます。 コンテナワークロード(cgroups/cpuset)は、コンテナに割り当てられたCPUとホストのRX/TXコアが重複している場合にメリットがあります。そうでない場合、回避可能なリモートアクセスが発生してしまいます。.
分析をさらに深める:SoftIRQ、NAPI、およびスタムの検出
そのほか /proc/interrupts 私は~を覗いてみると /proc/softirqs, 、という文脈において、仕事量が多いかどうかを確認するために ksoftirqd IRQハンドラ内で直接処理されるのではなく――これは、負荷が引き続き高いことを示している。 napi_defer_hard_irqs (カーネルに依存)および適切なキュー割り当てに基づき、NAPIのバッチ処理の積極度を調整しています。. ethtool -S 各キューごとのドロップ数、ビジー状態、パケットレートの統計情報を表示してくれます。これにより、不均衡なキューを特定し、アフィニティやRSSインダイレクションを適宜調整することができます。.
# SoftIRQの割り当て状況の概要
cat /proc/softirqs | egrep 'NET_RX|NET_TX'

# ドライバ/キュー統計情報の確認
ethtool -S ens192 | egrep -i 'rx|tx|drop|busy'
実践:1つのノード上の4つのキューに対するマッピング
私がよく採用している典型的な設定は、NUMAノード0上のNICに4つのRSSキューを設定するというものです。 CPU0は避け、キューをCPU1~4にバインドしています。関連するWebワーカーやプロキシワーカーも同様に1~4に配置し、XPSも同様に割り当てますが、RPSはオフにしています。これにより、双方向で短く一貫性のあるパスが確保されます。.
IF=ens192
QUEUES=(181 182 183 184)   # のサンプル IRQ(事前に確認しておく)
CPUS="1-4"

# IRQアフィニティとXPSの設定
for i in ${!QUEUES[@]}; do
  echo "$CPUS" > /proc/irq/${QUEUES[$i]}/smp_affinity_list
done
for q in /sys/class/net/$IF/queues/tx-*; do echo "$CPUS" > "$q"/xps_cpus; done

# ワーカーを固定する(systemd または taskset)
# systemd: CPUAffinity=1 2 3 4
# 1回限り: taskset -c 1-4
負荷がさらに増加する場合は、キューの数を増やします(ethtool -L) ノードの適切なコア数まで割り当て、認識可能なパターン(例:キューID → コアID)に従って固定的に割り当てることで、時間の経過とともにフローが「移動」しないようにする。.
マルチコア・ホストのベストプラクティス
負担を軽減します CPU0, 、そこでは負荷がかかると動作に支障をきたすタイマーやカーネルの内部サービスが頻繁に実行されているためです。 そのため、重要なIRQは他のコアに割り当てることを優先し、CPU0には重要度の低いソースのみを割り当てています。NUMAシステムでは一貫性を保ち、アダプタ、IRQ、プロセス、およびメモリアクセスを同じ ノード. 負荷の高い環境では、I/Oコアとアプリケーションコアを分離し、必要に応じて隔離します。すべての変更について継続的な測定を行い、割り当てを反復的に調整します。.
測定可能なアプローチ:分析、スクリプト、およびフォールバック策
変更を行う前に、現状を以下の方法で記録します。 エムピースタット, htop, /proc/interrupts およびiperf3によるレイテンシ測定。再起動やドライバの再読み込み後にアフィニティ設定を自動的に適用するスクリプトを設定しています。 ロールバックに備えて、中立的なマスクを用意しておき、不具合が発生した場合は即座に元に戻せるようにしています。ステージング環境では、本番環境にできるだけ近い負荷プロファイルをテストし、そのテストを繰り返し実施しています。 測定 調整のたびに。その後に初めて、ターゲットホスト上でそのプロファイルを恒久的に有効にします。.
よくあるつまずきをきれいに避ける
幅が広すぎるマスクは、作業をあまりにも多くの人に分散させてしまう CPU また、キャッシュのパフォーマンスを低下させる一方で、マスクが狭すぎるとキューが詰まってしまいます。NUMAの特性を考慮し忘れると、リモートメモリへのアクセスが発生し、応答時間が不安定になります。 ハードピンニングは時折RPS/RFS設定と競合するため、SoftIRQの負荷分散を明示的に確認しています。カーネルの更新やドライバの変更後は、割り当てが変更される可能性があるため、すべてのIRQ番号を再検証します。 慎重な手順と明確な ドキュメンタリー 私は行動力を維持できる。.
簡単にまとめると
ターゲットを絞ったIRQピンニングにより、ネットワーク割り込みを適切な少数のIRQに割り当てる コア, 、これによりオーバーヘッドを低減し、応答時間を安定させます。これに合わせてIRQおよびCPUアフィニティを調整し、NUMAを考慮に入れ、一連の測定で効果を確認します。 自動調整で十分な場合はirqbalanceに任せていますが、重要なキューについては特定のコアに割り当てています。RSS、RPS/RFS、および調整されたカーネルパラメータを組み合わせることで、このチューニングは最大限の効果を発揮します。 効果. これらの手順をしっかりと実行すれば、マルチコアLinuxサーバーにおいて、ネットワークパフォーマンスを著しく向上させることができます。.


