 Ga naar de inhoud

Het Apache Scoreboard laat me in realtime zien hoeveel workers op dit moment verzoeken verwerken, antwoorden versturen of inactief zijn, en daarmee beoordeel ik de Serverbelasting zonder giswerk. Via mod_status krijg ik op een gestructureerde manier toegang tot de statusgegevens, interpreteer ik symbolen, meet ik de doorvoer en leid daaruit concrete Stappen voor het afstellen van.
Centrale punten
- Realtime status alle medewerkers begrijpen en knelpunten snel herkennen.
- mod_status Veilig beschikbaar stellen en ExtendedStatus op een zinvolle manier gebruiken.
- Belangrijke cijfers zoals Req/s, Busy/Idle en CPU systematisch analyseren.
- Symbolen de gegevens op het scorebord interpreteren en doelgericht handelen.
- Controle automatiseren en op basis van gegevens waarschuwingen instellen.
Wat is het Apache Scoreboard?
In het scoreboard slaat Apache per worker een actuele status op, zoals ‘lezen’, ‘verzenden’ of ‘inactief’, en daardoor zie ik de Taakverdeling van de processen. De gegevens zijn intern beschikbaar en worden via mod_status naar de interface gestuurd, naar keuze als HTML of in machinaal leesbare vorm. Ik controleer daar ‘busy workers’, ‘idle workers’, CPU-belasting, uptime, evenals het aantal verzoeken en bytes. Ik vind vooral het zeer gedetailleerde overzicht van individuele workers erg nuttig, omdat ik zo de verwerkingstijd en de actieve host kan zien. Zo kan ik een weloverwogen beslissing nemen of er een tekort aan capaciteit is, of verzoeken te lang duren of dat keep-alive-slots geblokkeerd zijn; deze Transparantie bespaart tijd bij het achterhalen van de oorzaak.
Zo krijg ik er toegang toe via mod_status
Via /server-status open ik een overzichtelijke HTML-pagina; via /server-status?auto krijg ik een beknopte tekstweergave voor Controle en scripts. In productieve omgevingen schakel ik ExtendedStatus in, omdat de extra statistieken per worker mij de nodige context bieden. Ik beperk de toegang strikt tot beheerdersnetwerken of afzonderlijke hosts en maak de pagina niet openbaar. Voor een handmatige controle volstaat een korte browsersessie; bij continue registratie integreer ik de automatische weergave in een monitoringsysteem. Zo houd ik de overhead laag en waarborg ik de statusgegevens is zinvol.
De configuratie beveiligen en de overhead inschatten
Ik beveilig /server-status consequent en kies per situatie tussen IP-toegang, authenticatie of een interne admin-VHost. ExtendedStatus veroorzaakt meetbare, maar in de praktijk geringe Overhead; ik schakel deze functie permanent in als ik de gegevens ook in de monitoring gebruik, of slechts tijdelijk bij ad-hocanalyses. Een duidelijke voorbeeldconfiguratie helpt me fouten te voorkomen:
# activeren
ExtendedStatus On

#-status alleen intern beschikbaar stellen

  SetHandler server-status

  # Variant 1: op IP gebaseerd
  Require ip 10.0.0.0/8 192.168.0.0/16 ::1

  # Variant 2: Basic-Auth (bijv. naast IP)
  #AuthType Basic
  #AuthName "Server Status"
  #AuthUserFile "/etc/httpd/conf/.htpasswd"
  #Require valid-user
Ik zorg ervoor dat de pagina ook buiten de productie-VHosts beschikbaar blijft (bijvoorbeeld via een intern adres), zodat er geen rewrite-regels of proxyroutes tussenbeide komen. Wanneer ik debug-fasen afrond, controleer ik of alleen de noodzakelijke gegevens worden gepubliceerd.
De symbolen op het scorebord snel aflezen
Als er storingen optreden, kijk ik eerst naar de symbolen, want een dicht patroon van R en W duidt op een acute belasting en veel _ duiden op rust; deze Codering versnelt de diagnose. Ook K toont mij open keep-alive-verbindingen die bij een onjuiste timeout de worker blokkeren. Een focus op D wijst op DNS-lookups die de antwoorden vertragen. Veelvuldige L-vermeldingen duiden op blokkerende logboekregistratie en opslagsubsystemen. Met een paar blikken herken ik zo de dominante bottleneck en start ik gerichte Maatregelen.
| Symbool | Dat betekent | Direct bericht |
|---|---|---|
| _ | Werkloze werknemer | Voldoende Capaciteit aanwezig |
| R | Verzoek om in te zien | Controleer de netwerklatentie of Klant |
| W | Antwoord verzenden | Backend-tijd en outputgrootte analyseren |
| K | Keep-Alive | Time-outs en slotbinding controleren |
| D | DNS-opzoeking | Reverse DNS uitschakelen of cache |
| L | Loggen | Asynchroon loggen en I/O kijk op |
| C | Afsluiting | Normale beëindiging van de verbinding, korte zichtbaar |
| G | Een elegante afwerking | Voltooide aanvraag, worker ruimt op op |
| I | Opschoning bij inactiviteit | Ongekritisch, werknemer gecorrigeerd |
| . | Nietsdoend | Rustige periode, middelen gratis |
Geavanceerde patronen en aanvalsprofielen herkennen
Ik beoordeel niet alleen afzonderlijke situaties, maar ook de Duur en de verdeling van de symbolen. Veel langdurige R-toestanden in combinatie met een lage netwerkbandbreedte duiden op trage clients of Slowloris-patronen; in dat geval beperk ik de leestijden per verzoek (bijvoorbeeld met RequestReadTimeout) en stel ik realistische minimumtarieven in. Als er vooral W-toestanden zijn met een hoog aantal bytes per verzoek, is de bandbreedte of opslagruimte eerder de beperkende factor. Bij gelijktijdige pieken van D en L geef ik voorrang aan naamomzetting en log-I/O. Het is doorslaggevend of patronen breed (alle werknemers) of lokale (slechts één VHost of pad) – zo vind ik hotspots in de applicatie sneller.
Kerncijfers voor de analyse van webservers
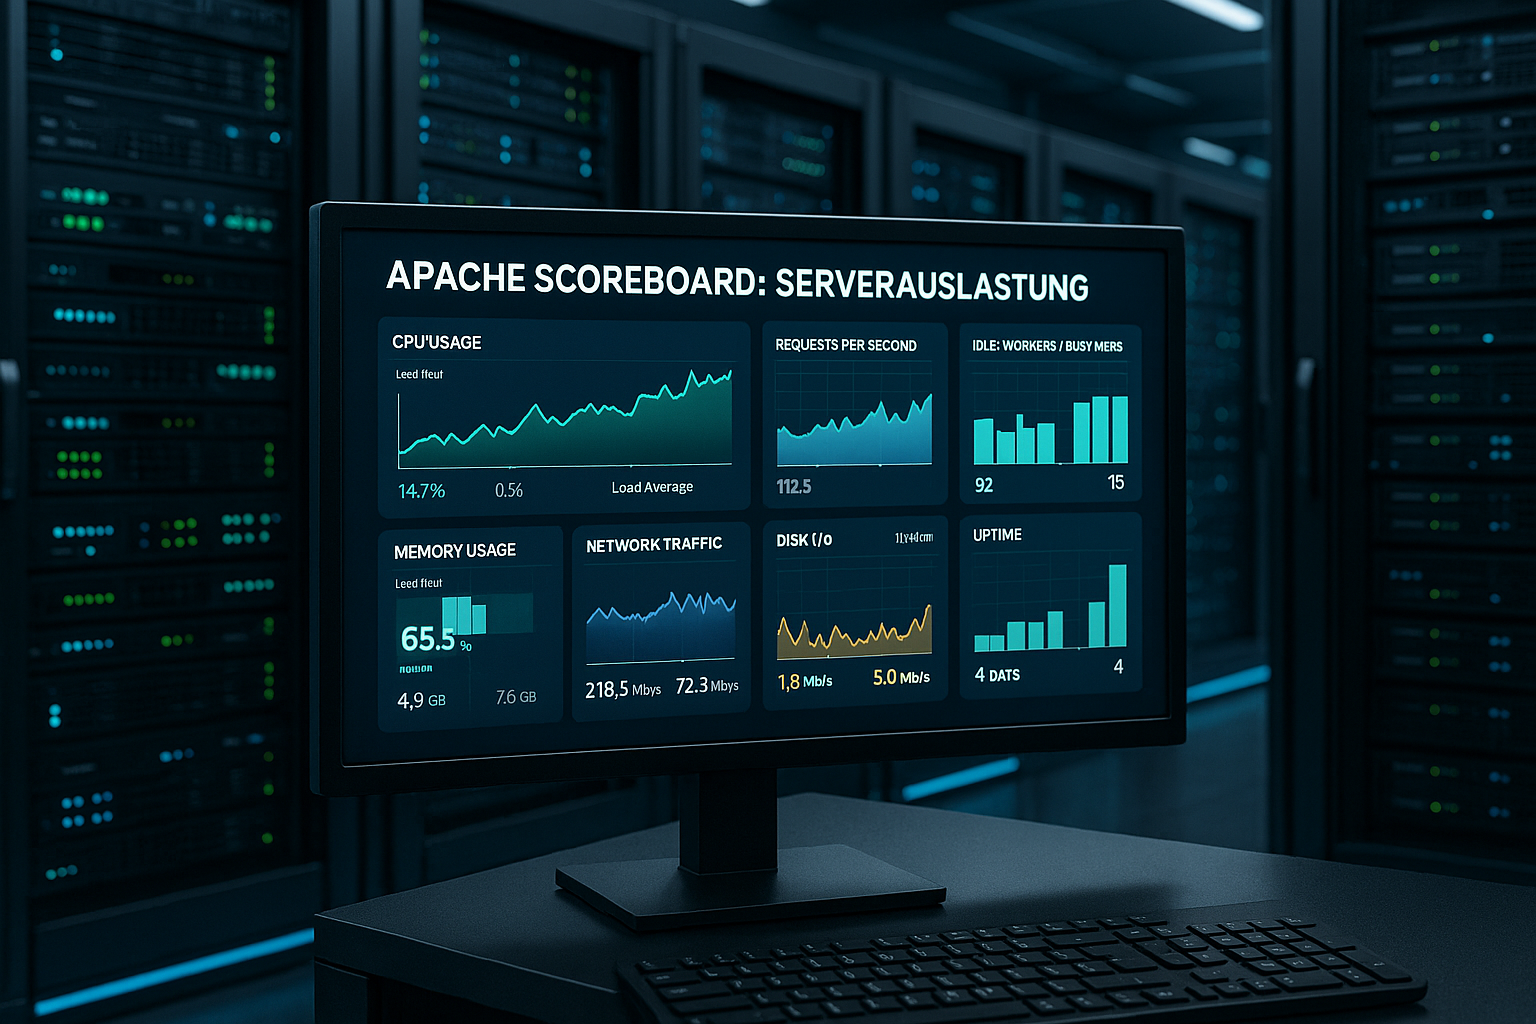
Het aantal verzoeken per seconde geeft mij de doorvoersnelheid weer, maar ik bekijk tegelijkertijd ook het aantal bytes per seconde en het aantal bytes per verzoek voor de laadvermogen. De verhouding tussen ‘busy’ en ‘idle’ geeft aan of er slots ontbreken of dat de instellingen te conservatief zijn. Ik breng de CPU-bezetting in verband met responstijden om CPU-gebonden processen te onderscheiden van I/O-gebonden processen. De uptime helpt om recente herstarts te onderscheiden van echte trends. Uit deze combinatie leid ik concrete afstemmingsmaatregelen af voor workers, keep-alive en Time-outs van.
Grenswaarden en alarmering in de praktijk
Ik stel alarmen niet in op momentwaarden, maar op voortschrijdende gemiddelden en Duur. De volgende heuristieken hebben bijvoorbeeld hun nut bewezen: Idle 4:1 over dezelfde periode wijst op verzadiging. Req/s daalt bij constant verkeer, terwijl Busy constant blijft – dan zit er vaak een backend achter. Een K-aandeel > 50 % tijdens primetime duidt op een te royale keep-alive. Ik vul de drempels aan met trendwaarschuwingen (stijgende responstijden bij gelijke belasting) en Seizoensgebondenheid (dag- en weekpatronen), zodat ik echte veranderingen kan onderscheiden van normaal gedrag.
ScoreboardFile op de juiste plaats zetten
Op sommige platforms schrijft Apache statusgegevens naar een scoreboard-bestand, en ik sla die op in een snelle, beveiligde map zoals /var/run/httpd; dat verhoogt de betrouwbaarheid. Ik zorg ervoor dat niet meerdere instanties hetzelfde bestand gebruiken, anders bestaat het risico op vervalstte waarden. Sommige tools lezen rechtstreeks uit het bestand, waardoor het HTTP-eindpunt overbodig wordt. Dit is aantrekkelijk voor beveiliging en prestaties, mits de machtigingen kloppen. Ik documenteer het pad en de toegang, zodat onderhoud en Controle consistent blijven.
Bijzonderheden van besturingssystemen en containers
Ik zorg ervoor dat de limieten voor bestandsdescriptoren, backlogs en tijdelijke paden aansluiten bij de werklast. In systemd controleer ik of PrivateTmp of ReadOnlyPaths invloed hebben op het Scoreboard-pad. In containers schat ik de opslagbehoefte per proces/thread conservatief in en plaats ik het Scoreboard-pad in een beschrijfbare Runtime-map. Voor piekbelasting pas ik de kernelparameters aan:
# Voorbeeldwaarden voor sysctl (systeemwijd testen en documenteren)
net.core.somaxconn = 4096
net.ipv4.tcp_max_syn_backlog = 4096
fs.file-max = 1048576
Daarnaast stel ik de `ulimit -n` voor de Apache-service zo in dat deze het maximale gelijktijdigheid past (vuistregel: open FD’s ≈ 2–3 × MaxRequestWorkers bij proxy-intensieve configuraties). Na wijzigingen bekijk ik het scorebord opnieuw om de effecten te bevestigen.
Typische toepassingen: overbelaste werknemers herkennen
Als bijna alle slots bezet zijn met R of W en er nauwelijks _-vermeldingen verschijnen, loopt de server vast op zijn Beperk. Vervolgens controleer ik MaxRequestWorkers, responstijden en blokkerende backends. Als extra workers niet helpen, ligt het knelpunt vaak in de applicatie, de database of de opslag. Via /server-status?auto volg ik de ontwikkeling in intervallen, in plaats van alleen momentopnames te bekijken. Zo beslis ik of ik instellingen aanpas, caching versterk of Schalen plan.
Hulpbronnenmodel en capaciteitsformules
Ik bereken de capaciteiten van tevoren, zodat ik geen opslagproblemen veroorzaak. Voor Prefork geldt: geheugen ≈ aantal processen × RSS per proces. Voor Worker/Event: geheugen ≈ aantal processen × (RSS per proces) + threads × thread-overhead. Ik meet de werkelijke RSS met systeemtools en houd rekening met veiligheidsmarges. Een klein voorbeeld: 20 processen × 50 MB + 500 threads × 1 MB is ≈ 1,5 GB, plus cache en OS-buffers. Hieruit leid ik MaxRequestWorkers, ServerLimit en ThreadsPerChild af. Ik houd er bovendien rekening mee dat modules zoals SSL, PHP of reverse-proxying het geheugen per Discussie kunnen verhogen; daarom test ik met een reële belasting, niet alleen in onbelaste toestand.
Wachtrijen en latentie interpreteren
Als verzoeken lang in de status ‘Accept’ of ‘Schrijven’ blijven hangen, neemt de waargenomen latentie toe en houd ik me bezig met de lengte van de wachtrijen en de ‘Accept’-achterstand; het scorebord biedt hiervoor waardevolle Indicatoren. Dit artikel geeft me een uitgebreidere uitleg over wachtrijen, latenties en het verwerken van verzoeken: Wachtrijen en latentie. Aan de hand van deze uitgangspunten bepaal ik of de knelpunten vóór de Apache, in de Apache of erachter ontstaan. Korte pieken tolereer ik, maar langdurige opstoppingen los ik op door de capaciteit of de architectuur aan te passen. Zo voorkom ik dat time-outs escaleren en dat clients afbreken.
Een verbinding met de backend en de proxy tot stand brengen
In omgevingen met veel proxys kan ik aan de hand van W-fasen aflezen of workers op Stroomopwaarts Wachten. ExtendedStatus toont me de VHost en de opgevraagde bron; daarmee breng ik paden in verband met trage backends. Ik stel realistische time-outs in (TimeOut, ProxyTimeout) en controleer connection-pooling, zodat threads niet onnodig worden geblokkeerd. Als de pijplijn bij uploads vastloopt, pas ik de leessnelheden per client aan en bescherm ik mezelf tegen trage verzenders. Als er veel grote antwoorden worden gegenereerd, maak ik gebruik van compressie, chunking en Caching in overweging nemen om W-tijden te verkorten.
Keep-Alive gericht instellen
Veel K-vermeldingen duiden op clients die verbindingen open laten staan; dit versnelt vervolgverzoeken, maar kan slots binden. Ik stel time-outs zo in dat echte herhalingen hiervan profiteren, terwijl inactiviteit niet te lang wordt geblokkeerd. Op drukbezochte sites helpt een proxy die ervoor zorgt dat Keep-Alive efficiënt wordt gebundeld. Voor details over het nauwkeurig afstemmen gebruik ik deze handleiding: Keep-Alive-time-out instellen. Door een verstandig ingestelde time-out neemt de slotbinding af en blijft de server onder belasting responsief.
HTTP/2, TLS en MPM in combinatie
Met HTTP/2 zie ik doorgaans minder K-binding per client, omdat meerdere streams één verbinding gebruiken delen. Event-MPM komt hier goed tot zijn recht: Keep-Alive wordt efficiënter afgehandeld, terwijl actief werk voorbehouden blijft aan threads. TLS verhoogt het CPU-verbruik per verbinding; ik kijk of hoge W-percentages correleren met een hoog CPU-verbruik en optimaliseer de cipher suites en session resumption. In statusoverzichten zie ik per VHost of HTTP/2- of TLS-terminatiepaden domineren en stem ik de capaciteiten daarop af (bijvoorbeeld meer threads in plaats van meer processen, als contextwisselingen veel rekenkracht kosten).
DNS-lookups en logboekregistratie onder controle
Als D vaker voorkomt in het scorebord, controleer ik de reverse-DNS en schakel ik een lokale cache in of schakel ik lookups uit; dat verlaagt de Latency. Als ik veel L-vermeldingen zie, remt het loggen de verwerking af; daarom verdeel ik logbestanden, gebruik ik snellere opslag of asynchrone pijplijnen. Roterende logs configureer ik zo dat er geen flush-pieken ontstaan. Tegelijkertijd meet ik schrijf-I/O en bestandsvergrendelingen om blokkerende patronen te doorbreken. Zo win ik verwerkingstijd terug en ontlast ik de Werknemer.
Integratie in monitoringsystemen
Ik verzamel periodiek /server-status?auto, sla de waarden op als tijdreeks en visualiseer ‘Busy versus Idle’, Req/s, Bytes/s en CPU-belasting op Dashboards. Alarmen definiëren drempelwaarden voor slots die voortdurend vol zijn, toenemende responstijden of ongebruikelijke verkeerspatronen. Met annotaties markeer ik deployments, zodat ik de effecten direct kan zien. Deze geschiedenis maakt onderscheid tussen eenmalige pieken en echte trends. Zo stuur ik de capaciteit planmatig aan en voorkom ik Verrassingen.
Geautomatiseerde gegevensverzameling met scripts
Voor snelle controles volstaat voor mij een lichtgewicht script dat de Auto-weergave parseert en alleen de belangrijkste cijfers weergeeft. Ik houd de opvraagintervallen gematigd (bijv. 10–30 seconden) om de overhead laag te houden, en voorzie elk monster van tags met host, VHost en omgeving.
#!/bin/sh
URL="http://127.0.0.1/server-status?auto"
curl -s "$URL" | awk -F': ' '
  /BusyWorkers/ {busy=$2}
  /IdleWorkers/ {idle=$2}
  /ReqPerSec/   {rps=$2}
  /BytesPerSec/ {bps=$2}
  END { printf("busy=%s idle=%s rps=%.2f bps=%.0f\n", busy, idle, rps, bps) }
'
In grotere omgevingen aggregeer ik bovendien de tijden per worker, wijs ik ze toe aan VHosts en bereken ik Kwantiel voor responstijden. Zo kan ik zien of slechts een deel van de gebruikers problemen ondervindt of dat de meerderheid hiermee te maken heeft.
MPM en capaciteitsplanning
Het MPM bepaalt hoe Apache verbindingen verwerkt; de gegevens van Scoreboard laten me zien of processen of threads de beperkende factor zijn Factor zijn. Voor de selectie en afstemming vergelijk ik events en workers, meet ik idle-tijden, keep-alive-bindingen en contextwisselingen. Dit artikel biedt een beknopte vergelijking: Event versus Worker MPM. Na aanpassingen controleer ik opnieuw de Busy/Idle-waarden en het aantal Req/s om de effecten aan te tonen. Zo neem ik beslissingen op basis van gegevens en verhoog ik de Efficiëntie.
Graceful Restart, rolling deployments en onderhoud
Bij implementaties of configuratiewijzigingen geef ik er de voorkeur aan om een sierlijk Herstart uitgeschakeld. In het scorebord zie ik dit aan de vele G-toestanden, terwijl nieuwe processen starten en oude netjes aflopen. Ik plan rolling-wijzigingen zo dat er voldoende idle-capaciteit overblijft: eerst de belasting verminderen, dan een graceful herlaadbeurt uitvoeren en vervolgens de resterende knooppunten. Langdurige G-fasen zijn een aanwijzing dat oude processen wachten op trage verzoeken – dan controleer ik time-outs en keep-alive om de omschakeltijd te verkorten.
Stap voor stap naar een gedegen analyse
Ik activeer mod_status, beveilig de toegang en schakel ExtendedStatus in, zodat ik alle details krijg. Daarna controleer ik de HTML-pagina in de browser en leer ik het live-patroon van de symbolen kennen. In de volgende stap integreer ik /server-status?auto in mijn monitoring en valideer ik de statistieken. Vervolgens optimaliseer ik achtereenvolgens: het aantal workers, keep-alive, time-outs, caching en applicatiepaden. Ik meet elke wijziging opnieuw, totdat Req/s, responstijd en Busy/Idle weer binnen het Groengebied liggen.
Samenvatting: Apache Scoreboard als kompas
Het Apache Scoreboard geeft me een duidelijk, direct bruikbaar overzicht van de belasting, knelpunten en het gedrag van de Werknemer. Met mod_status, ExtendedStatus en een gedegen monitoring zet ik ruwe gegevens om in onderbouwde beslissingen. Symbolen en statistieken laten zien of ik de capaciteit moet uitbreiden, time-outs moet verkorten of de applicatie moet aanpakken. Een kleine aanpassing aan Keep-Alive of aan de MPM kan een groot effect hebben, mits de gegevens kloppen. Wie de signalen goed interpreteert, houdt Apache onder belasting responsief en planbaar.


