 Ga naar de inhoud

Ik vergelijk de belangrijkste methoden voor MariaDB Flush en laat zien hoe ik innodb flush zo instel dat de schrijflatentie afneemt en de gegevens veilig blijven. De nadruk ligt op de opties van `innodb_flush_method`, de duurzaamheidsregelaar `innodb_flush_log_at_trx_commit` en zinvolle waarden voor `Dirty Pages` en I/O-capaciteit op HDD, SSD en NVMe.
Centrale punten
- innodb_flush_method bepaalt hoe InnoDB met de cache van het besturingssysteem omgaat en dubbele caching voorkomt.
- innodb_flush_log_at_trx_commit bepaalt de houdbaarheid ten opzichte van de latentie per commit.
- Vuile pagina's en de I/O-capaciteit zorgen ervoor dat schrijfsnelheden worden afgevlakt en voorkomen dat er een stortvloed aan flush-verzoeken ontstaat.
- Flush-buren maakt een onderscheid tussen strategieën die zijn geoptimaliseerd voor HDD’s en strategieën die zijn geoptimaliseerd voor SSD’s/NVMe.
- Cloud-configuraties vereisen O_DIRECT, een passende IOPS-limiet en een degelijke monitoring.
Wat houdt innodb_flush_method concreet in?
Ik kies voor de Flush-methode afhankelijk van de manier waarop InnoDB samenwerkt met de cache van het besturingssysteem. Met fsync De gegevens komen eerst in de cache van het besturingssysteem terecht en worden vervolgens via fsync definitief opgeslagen; dit kan leiden tot dubbele caching. Als ik O_DIRECT instel, omzeilt InnoDB grotendeels de paginacache, wat RAM bespaart en op SSD/NVMe bijna altijd voordelen oplevert. O_DSYNC maakt gebruik van write-through en vermindert buffering, wat in bepaalde combinaties zinvol kan zijn. O_DIRECT_NO_FSYNC bouwt voort op O_DIRECT en past het synchronisatiegedrag aan, wat een sterke optie is op betrouwbare hardware met een eigen beveiligingsmechanisme.
Typische waarden en versies
Vanaf MariaDB 10.6 is O_DIRECT vaak de standaardinstelling, omdat dit dubbele caching voorkomt. In oudere versies is fsync, wat voor HDD-configuraties nog acceptabel kan zijn. Vanaf versie 11.0 regelen andere variabelen, zoals `innodb_data_file_buffering` en `innodb_log_file_buffering`, de details van de buffering. In de praktijk blijft innodb_flush_method de belangrijkste instelling die ik als eerste controleer. Daarna schaven we aan de gedetailleerde parameters totdat de latentie daalt en de doorvoer constant blijft.
innodb_flush_log_at_trx_commit doelgericht inzetten
Ik beschouw Duurzaamheid en latentie worden apart behandeld, omdat innodb_flush_log_at_trx_commit beide bepaalt. De waarde 1 schrijft en voert fsync uit bij elke commit, wat maximale veiligheid biedt, maar trage schijven sterk vertraagt. Waarde 2 schrijft bij een commit naar de OS-cache en voert ongeveer één keer per seconde een fsync uit; dit verlaagt de latentie, maar brengt bij een stroomstoring het risico op maximaal één seconde gegevensverlies met zich mee. Waarde 0 verplaatst logschrijfbewerkingen volledig naar een frequentie van één keer per seconde en levert de hoogste schrijfprestaties met het grootste risico. Wie daarnaast let op de binlog-strategie, stemt commit-latenties slim af op de replicatie-eisen; details over de wisselwerking leg ik hier uit: Binaire logbestanden.
Page-flushing en dirty pages beheren
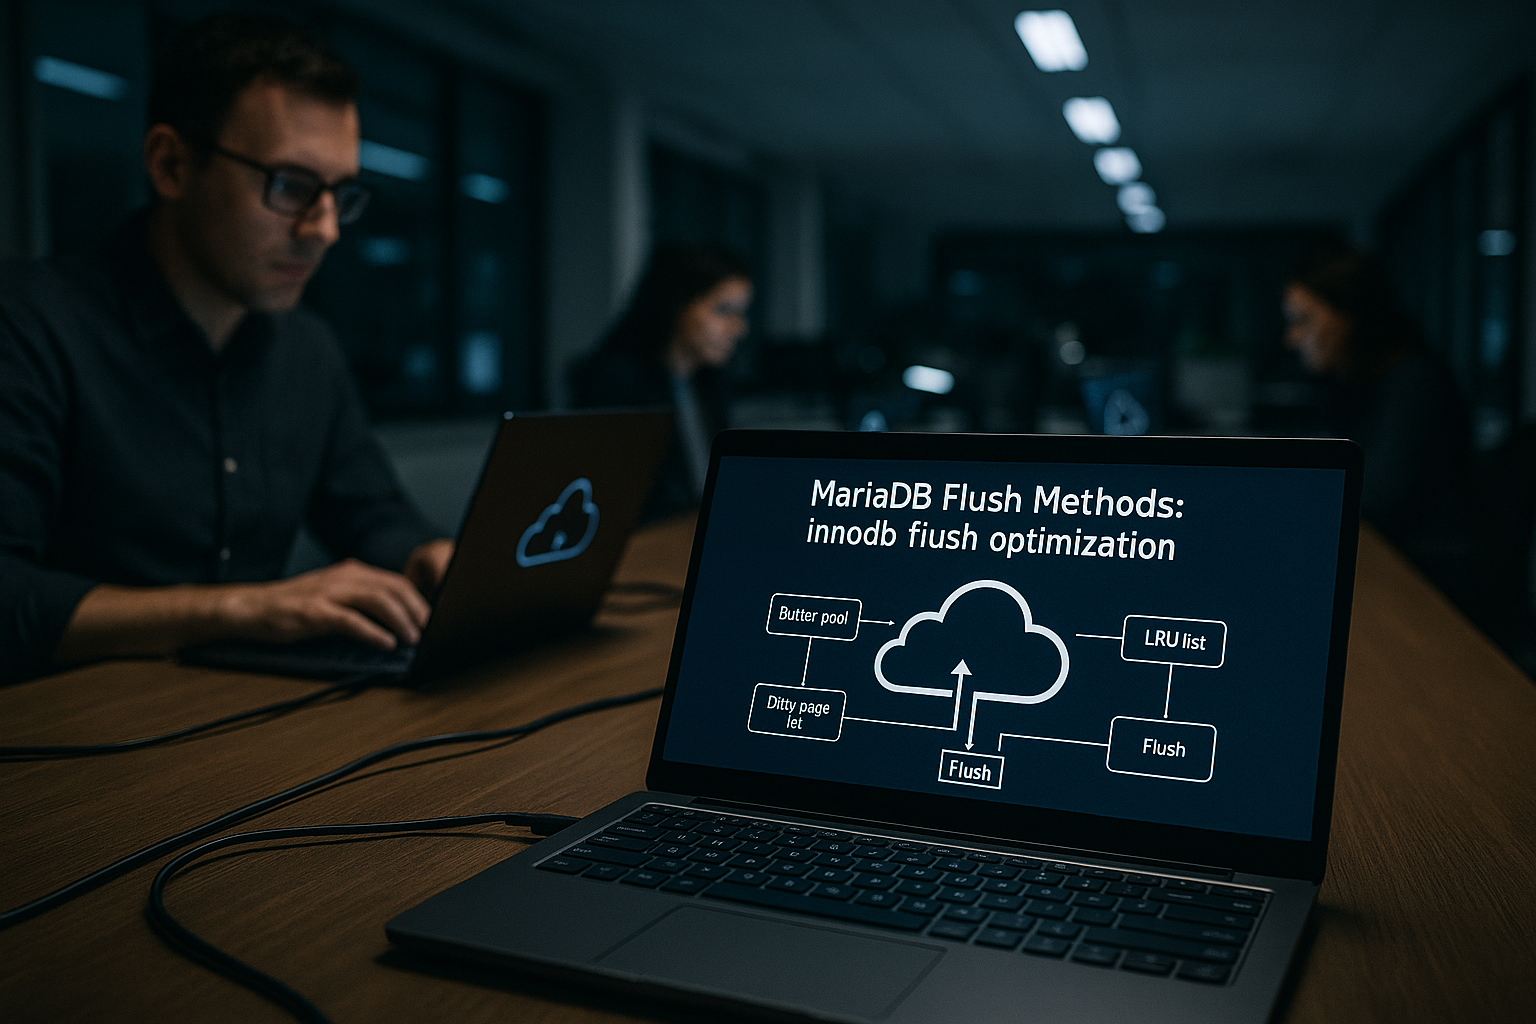
Ik schat het aandeel van de Vuile pagina's zodat de schrijfsnelheden constant blijven. Daarom stel ik innodb_max_dirty_pages_pct op een gematigde waarde in, zodat er geen plotselinge flush-pieken ontstaan. De waarden innodb_io_capacity en innodb_io_capacity_max stem ik af op de werkelijke IOPS van de opslag: laag voor HDD, hoger voor SSD/NVMe. Een goed geconfigureerde page-cleaner-thread schrijft vanuit LRU-perspectief tijdig terug, voordat pagina’s worden verdrongen. Meer informatie over het fijnafstemmen van threads en zinvolle statistieken beschrijf ik hier: Page-Cleaner-threads.
Flush-Neighbors: HDD versus SSD/NVMe
Met innodb_flush_neighbors Ik gebruik HDD-vriendelijke schrijfpatronen of schakel deze uit. Op HDD’s zorgt het gelijktijdig schrijven van aangrenzende pagina’s voor meer efficiëntie, omdat de kop minder vaak hoeft te springen. Op SSD/NVMe is de locatie op het medium nauwelijks relevant; daar veroorzaakt het gelijktijdig schrijven onnodige schrijfbewerkingen. Voor HDD stel ik meestal de waarde 1 in, voor SSD/NVMe de waarde 0. Zo verminder ik overbodige schrijfbewerkingen en verleng ik de levensduur van snelle schijven.
De kosten van fsync begrijpen en beperken
Ik meet de fsync-Latentie, omdat elke milliseconde commits vertraagt. Werkbelastingen met veel schrijfbewerkingen besteden anders een groot deel van de tijd aan het wachten op bevestiging van de opslagmedia. Met `innodb_flush_log_at_trx_commit=2` of `0` verminder ik het aantal kostbare synchronisaties aanzienlijk. O_DIRECT of O_DIRECT_NO_FSYNC helpt om dubbele caching te voorkomen en I/O-paden te vereenvoudigen. Op trage hardware boek ik vaak merkbare winst als ik de synchronisatiefrequentie, de flush-methode en het aandeel ‘dirty pages’ gezamenlijk bekijk.
Aanbevolen startwaarden per opslagmedium
Ik begin met zinvolle Basislijn-waarden en pas deze vervolgens aan op basis van meetwaarden. De tabel geeft richtlijnen voor typische configuraties en workloads. Doorslaggevend zijn de werkelijke IOPS, latenties en het aandeel schrijvende transacties. Na de eerste run controleer ik het percentage ‘dirty pages’, de commit-latentie en het aantal fsync-aanroepen. Vervolgens verfijn ik de instellingen stapsgewijs totdat het profiel stabiel en constant blijft.
| Medium | innodb_flush_method | innodb_flush_log_at_trx_commit | innodb_io_capacity | innodb_flush_neighbors | Opmerkingen |
|---|---|---|---|---|---|
| HDD | fsync of O_DIRECT | 1 (kritisch) / 2 (balans) | 200–400 | 1 | Meer latentie per Commit, continu doorspoelen is belangrijk |
| SSD | O_DIRECT | 1 (kritisch) / 2 (balans) | 1000–2000 | 0 | Dubbele caching vermijden, het aantal ‘dirty pages’ binnen de perken houden |
| NVMe | O_DIRECT of O_DIRECT_NO_FSYNC | 1 (kritiek) / 2 (balans) / 0 (speciaal geval) | 2000–8000+ | 0 | Zeer laag Latency, Kies de synchronisatiefrequentie zorgvuldig |
Ik houd daarbij rekening met de InnoDB Doublewrite-buffer, die gegevensbeschadiging bij crashes vermindert, maar extra schrijfbewerkingen veroorzaakt; ik vat de achtergronden en afstemmingsopties hier kort samen: Doublewrite-buffer. In omgevingen waar veel wordt geschreven, voer ik metingen uit met en zonder doublewrite-effecten voordat ik beslissingen neem. Bij kritieke systemen heeft integriteit voorrang boven een maximale schrijfsnelheid. Test- of analyseomgevingen mogen wat agressiever zijn. Ik onderbouw mijn beslissingen altijd met herhaalbare benchmarks.
Cloud- en containeromgevingen
Ik vermijd dubbele Pagina cache, omdat het RAM daar schaars is; O_DIRECT is daarom vaak een goede keuze. Ik stem de innodb_io_capacity af op de IOPS-limieten van het volume, zodat ik geen beperkingen activeer. De bufferpool moet binnen de Cgroup-limiet blijven, anders dreigen OOM-kills. Persistente volumes zijn verplicht, omdat tijdelijke opslag geen duurzaamheid biedt. In zeer elastische opstellingen beperk ik te veel gelijktijdige verbindingen en maak ik weloverwogen gebruik van de threadpool.
Instellingen voor back-up en flushing
Ik controleer of back-uptools hun eigen Doorspoelen-Gebruik de instellingen. mariadb-backup kan innodb_flush_method anders instellen om een consistent beeld te krijgen. Als de back-up- en serverparameters niet op elkaar zijn afgestemd, ontstaan er onnodige I/O-pieken. Tijdens geplande back-ups regel ik de I/O-capaciteit zorgvuldig, zodat lees- en schrijfpaden schoon blijven. Na afloop controleer ik de latenties en het percentage ‘dirty pages’ om neveneffecten uit te sluiten.
Stapsgewijze tuning in de praktijk
Ik begin met een Inventaris: Opslagtype, werkelijke IOPS, latentie en doorvoersnelheid. Vervolgens stel ik de grootte van de bufferpool in, afgestemd op het beschikbare RAM of de Cgroup-limiet. Daarna kies ik de flush-methode (HDD: fsync/O_DIRECT; SSD/NVMe: O_DIRECT of O_DIRECT_NO_FSYNC). Voor de betrouwbaarheid stel ik innodb_flush_log_at_trx_commit in op 1 voor kritieke gegevens of op 2 als een verlies van één seconde acceptabel is. Tot slot stel ik innodb_io_capacity en innodb_max_dirty_pages_pct zo in dat het flushen soepel en continu verloopt, en controleer ik de statistieken regelmatig.
De grootte van het redo-log en de checkpoints correct afstemmen
Ik voorkom flush-pieken door de Redo-logs de juiste grootte kiezen. Te kleine logbestanden dwingen InnoDB tot frequente checkpoints; dit leidt tot backpressure en schommelingen in de latentie. Met grotere logbestanden zorg ik voor een gelijkmatiger verloop van de checkpoints, omdat er meer wijzigingsgegevens kunnen worden gebufferd voordat ze naar de gegevensbestanden moeten worden geschreven. Daarbij houd ik rekening met twee beperkingen: ten eerste de beschikbare I/O-capaciteit (een grote buffer biedt geen bescherming tegen te trage schijven), ten tweede de crash-recovery-tijd, die toeneemt bij zeer grote redo-logs. Bij schrijfintensieve workloads stel ik de loggrootte zo in dat typische piekbelastingen binnen het logbudget worden opgevangen, zonder dat de hersteltijd onredelijk toeneemt.
Ter fine-tuning houd ik de statistieken bij met betrekking tot de „checkpoint age“ en de verhouding tussen de log-write-rate en de flush-rate van de gegevenspagina’s. Als de checkpoints herhaaldelijk de bovengrens bereiken, schaal ik ofwel de loggrootte op of verhoog ik voorzichtig de I/O-capaciteit voor de page-cleaner. Het doel is een soepele, continue voortgang van de checkpoints zonder gedwongen acties.
Adaptieve spoeling en drempelwaarden
De adaptieve mechanismen van InnoDB helpen bij het flushen van de huidige Schrijfsnelheid aan te passen. Ik let erop dat de LWM-drempel (Low Watermark) voor Dirty Pages niet te laag is, zodat de Page-Cleaner niet voortdurend „op het randje“ werkt. Tegelijkertijd vermijd ik maximumwaarden die tot te agressieve bulk-flushes leiden. In de praktijk controleer ik of de verhouding tussen „nieuwe dirty pages per seconde“ en „flush-IOPS“ op de lange termijn stabiel blijft. Als de bufferpool constant boven de doelwaarde vervuilt, verhoog ik innodb_io_capacity stapsgewijs of verlaag ik de doelwaarden voor dirty pages.
Op NVMe-configuraties kan ik de Page-Cleaner meer speelruimte geven, omdat de apparaten ook onder belasting korte latenties behouden. Op HDD’s werk ik met conservatievere drempelwaarden en beperk ik sterke schommelingen om door zoekbewegingen veroorzaakte latentiepieken te voorkomen. De interactie met innodb_flush_neighbors Ik maak hier doelgericht gebruik van: HDD profiteert van de fysieke nabijheid, flash niet.
Binlog en Group-Commit in combinatie
Wie replicatie toepast, houdt daar rekening mee Commit-logboek over Redo-Log en Binary Log. Ik stel de flush-frequenties zo in dat Group-Commit van kracht is: veel kleine transacties moeten gezamenlijk worden geflushed, in plaats van elke commit afzonderlijk te synchroniseren. Hierbij past innodb_flush_log_at_trx_commit=1 voor maximale duurzaamheid of 2 voor lagere latentie. Tegelijkertijd stel ik het binlog-synchronisatiemechanisme zo in dat het past bij het doelsysteem. Een lage synchronisatiefrequentie verlaagt de kosten per commit, maar kan bij crashes leiden tot meer verlies van binlog-gegevens. In omgevingen met een hoge schrijfsnelheid en een aanvaardbare vertraging tussen master en replica accepteer ik een gematigde ontkoppeling van de binlog-synchronisaties om de latentie te verlagen. De overkoepelende logica en afwegingen behandel ik in het artikel over Binaire logbestanden en pas ze vervolgens aan het specifieke flush-profiel aan.
Bestandssysteem, schrijfcache en beveiliging tegen stroomuitval
Ik beoordeel de Eigenschappen van het geheugen en de controller vóór het tunen. Apparaten met Bescherming tegen stroomuitval (PLP) kunnen veilig gebruikmaken van schrijfcaches; zonder PLP bestaat het risico dat schrijfbewerkingen die als bevestigd zijn gemeld, bij een stroomstoring verloren gaan. In dergelijke gevallen ben ik wat voorzichtiger: fsync-paden blijven verplicht, en ik gebruik O_DIRECT_NO_FSYNC alleen op hardware met betrouwbare beveiliging. Op Linux-bestandssystemen zoals ext4 of XFS worden de beveiligingen standaard als actief beschouwd; ik schakel ze niet lichtvaardig uit, maar stem de afstemming af op de bestaande garanties. Op ZFS houd ik bovendien rekening met het eigen intent-log en de caching-strategieën; afhankelijk van de opstelling loont het de moeite om een afzonderlijk afgestemde strategie te hanteren, die ook double-caching minimaliseert.
Voor consistente prestaties controleer ik bovendien de uitlijning (bijv. 4K-pagina’s bij SSD’s) en de afstemming van de wachtrijdiepte. Korte, deterministische latenties zijn voor commit-paden vaak belangrijker dan maximale IOPS in synthetische benchmarks. Daarom test ik met realistische blokken en concurrentieniveaus in plaats van alleen met piekworkloads.
Meetmethodiek: statistieken, status en diagnose
Ik regel de afstelling via harde meetwaarden in plaats van gevoel. Tot mijn standaardindicatoren behoren:
- Commit-latentie (p50/p95/p99) tijdens piekbelasting
- fsync-latentie en -snelheid voor log- en gegevensbestanden
- Het aandeel van ‘dirty pages’ in de loop van de tijd en de variatie daarin
- Voortgang van de checkpoint en verhouding tussen log-schrijfsnelheid en flush-snelheid
- Page-Cleaner-achterstand (zijn er voortdurend openstaande flushes?)
Ik gebruik hiervoor de statusuitvoer van InnoDB en breng deze in verband met OS-statistieken (iostat, vmstat). Ik let met name op de schijflatentie in milliseconden, de verdeling tussen lees- en schrijfbewerkingen en het aandeel synchrone bewerkingen. Om reproduceerbare tests te garanderen, varieer ik doelgericht slechts één parameter per stap en registreer ik het resultaat over langere intervallen, zodat uitschieters geen doorslaggevende rol spelen.
Veelvoorkomende anti-patronen en tegenmaatregelen
- Te kleine redo-logs: dit leidt tot frequente checkpoints. Oplossing: vergroot de loggrootte en pas de I/O-capaciteit voor het flushing aan.
- Het percentage ‘dirty pages’ is blijvend te hoog: de Page Cleaner raakt overbelast en er dreigen ‘flush-stormen’. Oplossing: verlaag innodb_max_dirty_pages_pct en verhoog io_capacity.
- O_DIRECT zonder monitoring: voorkomt weliswaar dubbele caching, maar kan bij een verkeerde I/O-capaciteit tot pieken leiden. Oplossing: nauwgezette monitoring en het afstemmen van de capaciteitswaarden op de werkelijke IOPS.
- Ongeschikte Flush-Neighbors op SSD/NVMe: dit zorgt voor extra werk zonder dat het iets oplevert. Oplossing: stel innodb_flush_neighbors=0 in.
- Commit-synchronisaties op trage opslagmedia: elke transactie brengt de fsync-kosten met zich mee. Oplossing: Group-Commit bevorderen, eventueel innodb_flush_log_at_trx_commit=2 (na afweging van de risico’s).
- Container zonder RAM-buffer: bufferpool te groot, dreigende OOM. Oplossing: pas de bufferpool strikt aan de Cgroup-limieten aan en houd de druk in de gaten.
Rekening houden met shutdown- en herstelprocessen
Ik ben van plan om te bekijken hoe instellingen van invloed zijn op Uitschakeling en Herstel na een crash gevolgen hebben. Een snelle, nette afsluiting verkort de hersteltijden, omdat er minder redo’s hoeven te worden toegepast. Zeer grote redo-logs bevorderen rustige checkpoints, maar verlengen het inhaalproces in geval van een fout. Voor productieve systemen zoek ik een evenwicht waarbij ik enerzijds geen flush-pieken in de dagelijkse gang van zaken veroorzaak en anderzijds in het ergste geval geen buitensporig lang herstel hoef te accepteren. Daarbij houd ik vanaf het begin rekening met onderhoudsvensters en back-ups.
Praktische tips voor typische workloads
- OLTP met veel kleine commits op SSD/NVMe: O_DIRECT, innodb_flush_log_at_trx_commit=1 of 2, afhankelijk van de duurzaamheid, innodb_io_capacity bij voorkeur hoog, Dirty-Pages matig, Flush-Neighbors=0. Maak actief gebruik van Binlog-Group-Commit.
- Batch-import met veel schrijfbewerkingen: verhoog tijdelijk de doelwaarde voor ‘dirty pages’ enigszins, vergroot de I/O-capaciteit en zet deze na voltooiing weer terug. Stel, indien de houdbaarheid acceptabel is, tijdelijk innodb_flush_log_at_trx_commit=2 in.
- Op HDD gebaseerde legacy-systemen: conservatieve I/O-capaciteit, Flush-Neighbors=1, innodb_flush_method=fsync of O_DIRECT, afhankelijk van de druk op het RAM-geheugen. Besteed bijzondere aandacht aan continu flushing om zoekstormen te voorkomen.
- Cloud-volumes met IOPS-budget: innodb_io_capacity strikt koppelen aan de gegarandeerde limiet, pieken vermijden, O_DIRECT gebruiken om RAM te besparen. Bij creditsystemen (burst-I/O) werk ik met pacing, zodat het budget niet in één keer wordt opgebruikt.
Controlelijst voor probleemoplossing
- Lange p95-commit-vertragingen? Controleer de fsync-duur, schakel Group Commit in en verlaag indien nodig de flush-frequentie (na afweging van de risico’s).
- Grote variatie in het percentage ‘dirty pages’? Stel io_capacity/io_capacity_max nauwkeurig af en controleer de drempelwaarden voor adaptief flushing.
- Plotselinge pieken in de latentie bij back-ups? Synchroniseer de parameters van de back-uptool en de serverwaarden, en pas de I/O-beperking tijdelijk aan.
- Loopt Replica achter? Beoordeel de Binlog-flush-strategie, synchronisatiefrequenties en netwerklatentie gezamenlijk; te agressieve synchronisaties remmen de master af.
- RAM-belasting na overstap naar O_DIRECT? De balans tussen de bufferpool en de OS-cache opnieuw afstemmen; O_DIRECT vermindert de OS-cache, maar kan van invloed zijn op de paginacache van de applicatie.
Korte samenvatting
Ik organiseer de Flush-strategie altijd afhankelijk van de hardware en de doelstellingen op het gebied van duurzaamheid. O_DIRECT voorkomt dubbele caching en levert op SSD/NVMe doorgaans de beste resultaten op. De instelling `innodb_flush_log_at_trx_commit` bepaalt de snelheid per commit en het risico bij een stroomstoring. Zorgvuldig gekozen waarden voor Dirty Pages, I/O-capaciteit en Flush-Neighbors zorgen voor gelijkmatige schrijfsnelheden. Wie bovendien de fsync-kosten meet en zich aan cloudlimieten houdt, zorgt ervoor dat MariaDB betrouwbaar op snelheid draait, zonder in te boeten aan veiligheid.


