 Ga naar de inhoud

Ik leg kort en duidelijk uit hoe Evenement MPM die gebruikmaakt van de Apache Event Queue om een groot aantal gelijktijdige HTTP-verbindingen efficiënt te beheren. Daarbij leg ik de basisprincipes uit, zoals de event-loop, interne wachtrijen en concrete optimalisatiestappen voor een performant Configuratie.
Centrale punten
- Gebeurtenis lus maakt een onderscheid tussen verbindingsbeheer en het verwerken van verzoeken
- Keep-Alive blokkeert geen threads meer
- Evenementenwachtrij sorteert sockets op status
- Parameters hoe je MaxRequestWorkers gericht kunt afstemmen
- Controle zorgt voor een betrouwbare capaciteitsplanning
Hoe Event MPM verbindingen regelt
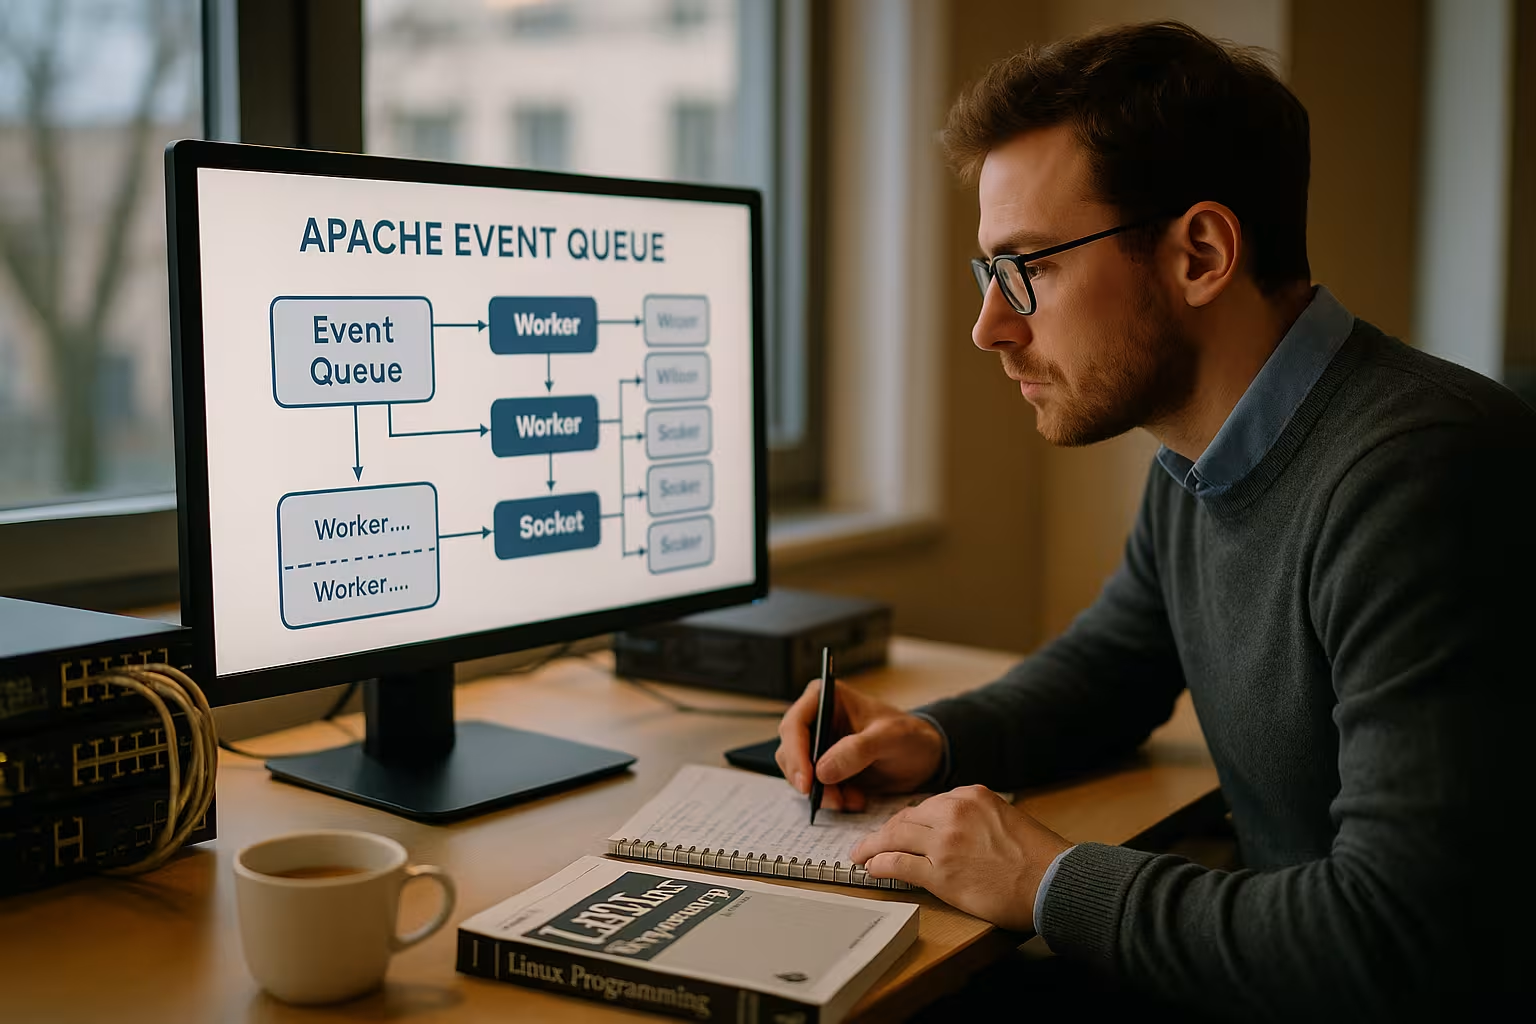
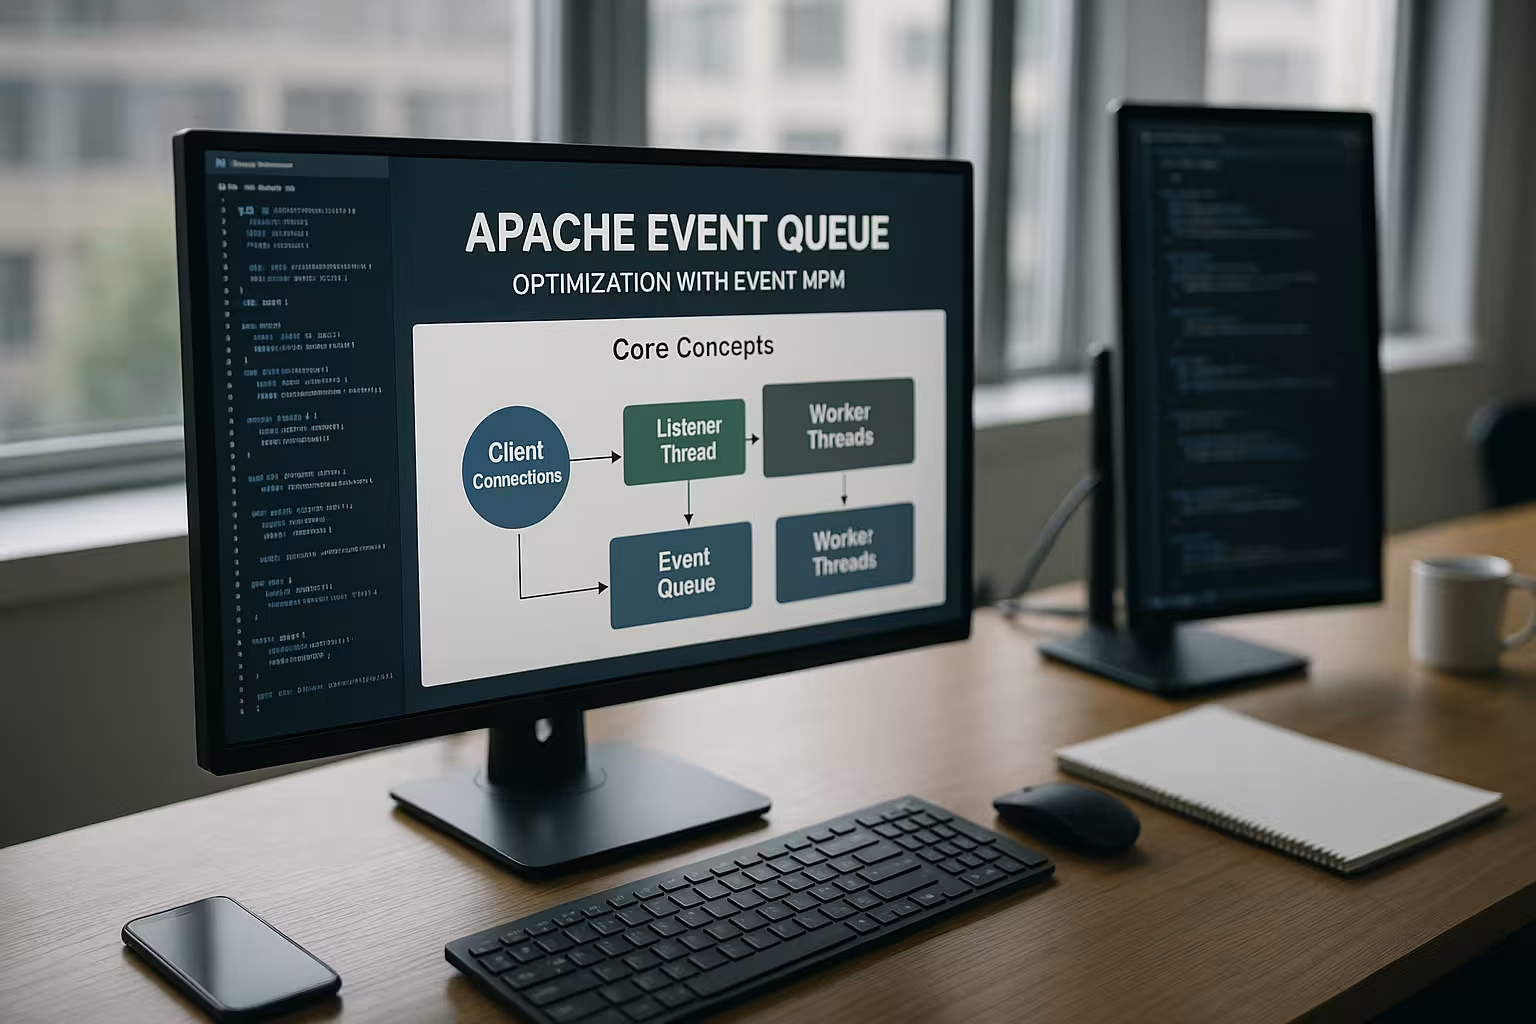
Ik begin met de vraag hoe Apache onder Belasting zoveel verbindingen beheert. Event MPM combineert processen en threads, maar geeft voorrang aan gebeurtenissen via een event-loop. Listener-threads accepteren nieuwe sockets en houden bestaande verbindingen in de gaten, zonder meteen een worker te blokkeren. Pas zodra gegevens leesbaar of schrijfbaar zijn, draagt de gebeurtenislaag de socket over aan een vrije werkthread. Zo voorkom ik dat stationair draaien-Verbindingen nemen threads in beslag en verspillen geheugen.
Deze scheiding vermindert de belasting van het RAM-geheugen merkbaar. Threads voeren vooral „echt werk“ uit, zoals het parseren van verzoeken, het genereren van antwoorden of het fungeren als proxy. De event-loop brengt de sockets daarna weer in de juiste toestand, bijvoorbeeld terug naar Keep-Alive of naar de afsluitfase. In de praktijk zie ik kortere wachtrijen bij piekbelasting, omdat vrije threads sneller weer beschikbaar komen. De architectuur biedt een duidelijke schaalbare Reactievermogen voor typische HTTP/1.1- en HTTP/2-workloads.
De Apache Event Queue in detail
De Event Queue wijst aan elke verbinding een status toe, en juist hier ligt de Winst in vergelijking met klassieke MPM’s. Nieuwe verbindingen komen eerst in een wachtrij terecht die controleert of ze leesbaar zijn. Zodra er gegevens binnenkomen, verplaatst de event-loop de socket naar een „readable“-wachtrij en wijst deze toe aan een worker. Na de verwerking bepaalt de status opnieuw: het schrijven beëindigen, Keep-Alive in de wacht zetten of sluiten. Deze cyclus blijft slank, omdat het wachtrijbeheer op een kostenefficiënte manier via epoll of kqueue wordt afgehandeld.
Ik zie vaak misverstanden: de Event Queue vervangt geen workers, maar coördineert hun Gebruik efficiënter. Threads blijven verzoeken verwerken, maar alleen als er daadwerkelijk bytes worden verzonden. Dit ontlast de CPU en het geheugen in scenario’s met veel „inactieve“ keep-alive-verbindingen. Hoe strakker het ontwerp van time-outs en buffers, hoe kleiner het risico dat verbindingen onnodig lang in kostbare statussen blijven hangen. Zo kan de responstijd constant worden gehouden, zelfs bij duizenden open sockets.
Het keep-alive-probleem bij klassieke MPM’s
Bij HTTP/1.1 blijven verbindingen vaak open om meerdere verzoeken te verzenden zonder een nieuwe handshake, wat Latency bespaart. Prefork of Worker reserveren hiervoor echter processen of threads die alleen maar wachten. Bij piekbelastingen blokkeren veel keep-alive-verbindingen dan waardevolle uitvoeringsbronnen. Dit drijft het RAM-verbruik omhoog en beperkt het aantal parallelle clients. Event MPM lost dit op door in de Event Queue inactieve sockets zonder thread in een gunstige wachtstand te houden.
Zo zet ik een groot aantal verbindingen in de wacht en begin ik pas met de verwerking wanneer dat daadwerkelijk nodig is. Dit verandert het capaciteitsmodel: in plaats van ‘threads = verbindingen’ hanteer ik ‘threads = actief werk’. In benchmarkscenario’s kan ik daardoor aanzienlijk meer open verbindingen toestaan, zonder dat dit ten koste gaat van de Reactietijd. Voor API-backends, WordPress-hosting en grote inhoudssites betekent dit een aanzienlijk gelijkmatiger belasting. De voordelen van Keep-Alive blijven behouden, zonder dat threads worden geblokkeerd.
Event MPM versus Worker MPM
Ik vat de verschillen kort samen in een Tabel samen. Het doel is om in één oogopslag een beeld te krijgen van de bediening, de benodigde systeembronnen en typische toepassingsgebieden. Beide varianten maken gebruik van processen met meerdere threads, maar bij Event wordt Keep-Alive minder vaak aan één thread gekoppeld. Worker blijft betrouwbaar bij een gematigde belasting, terwijl Event uitblinkt bij veel gelijktijdige verbindingen. Deze indeling helpt bij het nemen van weloverwogen beslissingen voor de eigen omgeving. Een meer diepgaande vergelijking vind je onder Evenement versus werknemer.
| MPM | Keep-Alive-verwerking | Threads/processen | RAM-vereiste | Geschikt voor |
|---|---|---|---|---|
| Voorkurk | Proces blokkeert bij stationair draaien | Alleen processen | Hoog | Oude PHP zonder threadveiligheid |
| Werknemer | Discussie blijft vaak vastzitten | Processen + threads | Medium | Matige belasting, eenvoudige installaties |
| Evenement | Gebeurtenis lus slaat inactieve sockets op | Processen + threads | Laag tot gemiddeld | Veel clients, lange keep-alive-fasen |
Typische toepassingsscenario's
Ik gebruik Event MPM wanneer er veel parallelle Klanten kleine tot middelgrote payloads opvragen. Blogs met veel verkeer, webwinkels met caching, statische assets en API-eindpunten profiteren hier merkbaar van. Hetzelfde geldt voor hostingopstellingen met veel websites per server, waarin keep-alive-verbindingen de overhand hebben. De Event Queue houdt daar het aantal actieve threads laag en verdeelt het werk gelijkmatig. Wie HTTP/2 gebruikt, profiteert nog eens extra, omdat één verbinding meerdere streams kan verwerken, terwijl de Event-laag de statussen netjes coördineert.
Ook bij reverse-proxy-topologieën laat Event zijn sterke punten zien. Ik laat Apache de SSL-verbinding tot stand brengen, het caching verzorgen en verzoeken doorgeven aan een applicatielaag. Daarbij blijft het verbindingsbeheer lichtgewicht, wat knelpunten voorkomt. Zelfs bij pieken in het verkeer blijven de responstijden beheersbaar, mits de limieten verstandig zijn ingesteld. Dat verlaagt het risico op Wachtrij-Opstopping en time-outs.
Configuratie: sleutelrichtlijnen
Om tot een weloverwogen besluit te komen, kijk ik eerst naar ServerLimit, StartServers, ThreadsPerChild en MaxRequestWorkers. De vuistregel: ServerLimit × ThreadsPerChild moet dicht bij MaxRequestWorkers liggen, met een marge voor onderhoud en groei. Een te lage waarde remt de parallelliteit af, een te hoge waarde zorgt voor een te hoog RAM-verbruik. Ik zet KeepAlive op On, maar stel KeepAliveTimeout gematigd in, zodat inactiviteit niet uit de hand loopt. Waarden tussen enkele seconden en lage dubbele cijfers werken vaak goed, afhankelijk van het verkeersprofiel.
Verder houd ik rekening met time-outs voor lezen, schrijven en proxyservers. Kortere waarden voorkomen dat backends vastlopen, langere waarden helpen bij traag reagerende clients, wat Afwegingen is vereist. Voor statische bestanden loont het om in grotere blokken te verzenden en efficiënte filterketens te gebruiken. Bij PHP via FPM of proxy-loadbalancers schaal ik het aantal backend-workers af op de parallelliteit van de frontend. Ik documenteer elke wijziging en meet het effect voordat ik verder ga.
De event-wachtrij afstemmen: stap voor stap
Ik begin met een duidelijke lastprofiel: gelijktijdige verbindingen, verzoeken per seconde, antwoordgroottes, Keep-Alive-percentages. Vervolgens stel ik MaxRequestWorkers zo in dat de CPU niet inactief blijft, maar het RAM-geheugen ruimschoots toereikend is. Ik pas ThreadsPerChild aan totdat pieken in de belasting zonder wachttijd worden verwerkt. Ik stel KeepAliveTimeout zo in dat er een goede balans ontstaat tussen gebruikerservaring en het spaarzaam omgaan met systeembronnen. Wie het gedrag van wachtrijen beter wil begrijpen, vindt basisinformatie op Webserver in de wachtrij.
Ik voer iteratieve tests uit met tools zoals ab, wrk of k6 en analyseer de latentie in de P50, P95 en P99. Daarbij houd ik in de gaten wanneer verbindingen in keep-alive blijven en wanneer ze worden verbroken. Een lichte overprovisionering van threads helpt om korte pieken op te vangen zonder de machine te overbelasten. Tegelijkertijd controleer ik foutlogboeken op meldingen zoals „server reached MaxRequestWorkers“. Zo krijg ik een harmonieus Samenwerking tussen de event-wachtrij en de worker-pool.
Bewaking en statistieken
Goede statistieken zorgen voor een betrouwbare Capaciteit. Ik activeer mod_status en houd actieve, inactieve en wachtende workers bij. Het scorebord laat zien of er verzoeken in de wachtrij staan of dat er resources vrij zijn. Daarnaast meet ik het aantal processen en threads, het RAM-gebruik en de netwerk-I/O. Een visuele analyse helpt bij het herkennen van trends en omslagpunten. Meer details vindt u in het Apache Scoreboard.
Ik breng deze waarden in verband met Access-logs en foutcodes. Als het aantal 5xx-fouten toeneemt terwijl de belasting maximaal is, zijn de limieten vaak te laag. Als time-outs toenemen, controleer ik de backend-services, de DNS-resolutie en de netwerkpaden. Ik kijk bij hoge belasting ook naar TCP-backlogs en SYN-hertransmissies. Zo kan ik vaststellen of de Oorzaak in de webserver, in de backend of in het netwerk ligt.
HTTP/2, reverse proxy en modules
HTTP/2 bundelt meerdere streams via één verbinding, wat de Evenement-architectuur optimaal ondersteunt. Ik let op de balans tussen streamlimieten en de threadpool, zodat veel kleine streams niet in wachtrijen terechtkomen. Als reverse proxy profiteert Apache van korte time-outs en betrouwbare backend-verbindingen. Modules die sterk blokkerend werken, kunnen echter threads vastleggen en de voordelen verminderen. Ik controleer daarom de compatibiliteit en vervang verouderde componenten als deze pieken in de latentie veroorzaken.
Cachemodules en compressie verhogen de efficiëntie, mits de CPU-profielen hierop zijn afgestemd. TLS-optimalisatie met moderne versleutelingsalgoritmen en HTTP/2-prioritering dragen bij aan een snelle levering. Ik maak gebruik van sessieherstel en houd de handshake-kosten onder belasting in de gaten. Voor statische assets werken zero-copy-benaderingen en sendfile goed. De Kunst ligt in het slank houden van de keten bestaande uit TLS, de event queue, de worker en de backend.
Interne workflow en statussen in de MPM-event
Om de interne processen te begrijpen, denk ik in toestanden: accept → readable → processing → writable → keep-alive → close. Listener-threads houden toezicht op sockets met behulp van efficiënte kernelmechanismen (epoll/kqueue) en wekken workers alleen als er een gebeurtenis plaatsvindt. Na het verwerken van een verzoek beslist de gebeurtenislaag of de verbinding in de „keep-alive“-status wordt gehouden, direct wordt gesloten of wordt afgesloten op een manier die lijkt op een „lingering close“, zodat laat binnenkomende TCP-pakketten correct worden verwerkt. Deze toestandsautomaat voorkomt ‘busy waiting’ en minimaliseert contextwisselingen.
Belangrijk daarbij is het onderscheid tussen I/O-wachttijd en CPU-belasting: het parseren van verzoeken, filterpijplijnen (bijv. compressie) en het genereren van het antwoord vinden plaats in werkthreads. Het louter wachten op leesbaarheid/schrijfbaarheid blijft in de event-loop. Hierdoor maakt Apache beter gebruik van de beschikbare threads en vermindert de Draaddichtheid per open verbinding drastisch.
Ik houd bovendien rekening met het gedrag van het scoreboard: in mod_status zijn fasen zoals „R“ (Reading), „W“ (Sending Reply), „K“ (Keepalive) en „G“ (Gracefully finishing) af te lezen. Een hoog „K“-percentage bij tegelijkertijd beschikbare workers geeft aan dat de event-wachtrij correct wordt geparkeerd en geen threads verspilt. Als de „R“-tijden aanzienlijk stijgen, duidt dit op trage clients of te restrictieve read-time-outs, wat wijst op optimalisatiemogelijkheden.
Planning van hulpbronnen: rekenvoorbeeld en zinvolle standaardinstellingen
Ik bereken de Parallellisme bestaande uit CPU, RAM en workload. Een voorbeeld: 8 vCPU, 16 GB RAM, voornamelijk gecachete inhoud en PHP-FPM in de backend. Ik begin met MaxRequestWorkers 512–768, ThreadsPerChild 32–64 en ServerLimit dienovereenkomstig 8–12. Ik houd per actieve worker rekening met 1–3 MB Apache-overhead plus modules, plus responsbuffers, TLS-overhead en backend-sockets. Realistisch gezien reserveer ik 4–8 GB voor Apache-processen/threads, 2–4 GB voor de OS-cache en de rest voor backends. Ik let erop dat ServerLimit × ThreadsPerChild nooit kleiner is dan MaxRequestWorkers; een beetje speling is verstandig.
Een overzicht van nuttige richtlijnen: – MinSpareThreads/MaxSpareThreads: Zorg ervoor dat de reserve zo is ingesteld dat piekbelastingen worden opgevangen zonder dat er een „koude start“ nodig is, maar dat er niet te veel inactieve threads geheugen in beslag nemen. – MaxConnectionsPerChild (ook bekend als MaxRequestsPerChild): Een eindige levenscyclus per proces helpt om geheugenfragmentatie en -lekken bij langdurig gebruik te voorkomen (bijv. 5k–20k). – MaxKeepAliveRequests: Beperkt het aantal verzoeken per verbinding; gematigde waarden voorkomen „eindeloze“ sessies zonder afbreuk te doen aan het voordeel van Keep-Alive (bijv. 100–1000). – Time-out, Time-outs bij lezen/schrijven en ProxyTimeout: Voorkom vastlopers; ik stel per context verschillende waarden in, in plaats van globaal te conservatief te zijn.
Voor statische bestanden gebruik ik EnableSendfile en EnableMMAP bewust: op lokale schijven kunnen beide voordelen opleveren; bij NFS/cloudvolumes schakel ik sendfile vaak uit om uitzonderingsgevallen te voorkomen. In TLS-paden heeft sendfile vanwege de opbouw ervan minder effect, aangezien gegevens door versleutelingspijplijnen lopen; hier telt vooral een efficiënte Filterketen.
Beperkingen van het besturingssysteem en het netwerk
Zelfs de beste evenementarchitectuur heeft weinig nut als beperkingen van het besturingssysteem een rem zetten op de prestaties. Ik controleer: – Bestandsdescriptoren (ulimit -n): De waarde moet ruim boven het maximale aantal gelijktijdige verbindingen plus backend-sockets liggen; enkele tienduizenden zijn gebruikelijk voor drukbezochte hosts. – LuisterBacklog: Een voldoende grote accept-backlog voorkomt dat SYN-pakketten tijdens pieken worden afgewezen. – Kernel-achterstanden (bijv. somaxconn) en SYN-wachtrijen: deze moeten overeenkomen met de verwachte „burst“-snelheid. – Netwerkbuffer (rmem/wmem): Niet overdrijven, maar zo dimensioneren dat verbindingen met een hoge RTT of hoge bandbreedte niet instorten.
Ik verdeel de accept-belasting over meerdere listener-threads en laat het platform in de regel het accept-mechanisme kiezen (AcceptMutex auto). Op systemen die dit ondersteunen, kan SO_REUSEPORT (afhankelijk van het platform via de lijstoptie) de acceptatiepaden afvlakken. Het is belangrijk om ‘thundering herd’-situaties te vermijden, waarbij veel threads om dezelfde acceptatie strijden.
Ook Tijdelijke TCP-poorten (ip_local_port_range) en het TIME-WAIT-gedrag moeten aansluiten bij het aantal parallelle proxyverbindingen. Ik vermijd agressieve aanpassingen, maar test op realistische wijze en zorg ervoor dat backends Keep-Alive ondersteunen, zodat verbindingen opnieuw kunnen worden gebruikt en er minder poortwisselingen plaatsvinden.
De fijne kneepjes van reverse-proxy’s: verbindingspools en backends
Als reverse proxy hangt de algehele prestatie sterk af van stabiele backend-verbindingen. Ik zorg ervoor dat Proxyverbindingen Zorg voor persistentie (Keep-Alive naar de backend) en dimensionneer de backend-pools zo dat ze de parallelliteit van de frontend volgen. Te kleine pools veroorzaken frontend-opstoppingen, te grote pools zorgen voor onnodige belasting van de app.
Praktische aanpassingsmogelijkheden: – ProxyTimeout: Korter voor niet-kritieke paden, langer voor „dure“ eindpunten – maak onderscheid, pas geen algemene regels toe. – Balancer-Instellingen (voor mod_proxy_balancer): wegingsfactoren, maximaal aantal verbindingen per backend, op de status afgestemde herhalingsintervallen. – mod_proxy_fcgi voor PHP-FPM: De FPM-pm.*-Waarden (pm.max_children, pm.start_servers enz.) moeten worden afgestemd op de parallelliteit van Apache om pieken in 502/504-fouten te voorkomen.
Ik zorg ervoor dat backend-fouten netjes en snel worden geëscaleerd, in plaats van frontend-threads te blokkeren. Health-checks, een voorzichtig herpogingsbeleid en circuit-breaker-achtige patronen houden de latentie stabiel. Waar mogelijk zorg ik voor Caching van antwoorden op geschikte plaatsen, zodat het evenement MPM vooral korte, beknopte antwoorden kan versturen.
HTTP/2-fijnafstemming onder Event
Voor HTTP/2 optimaliseer ik, naast TLS, vooral Streamlimieten en toewijzing van workers. Veel kleine streams per verbinding kunnen de latentie verlagen, maar de threadbelasting verhogen. Ik stel het maximale aantal streams per sessie zo in dat multiplexing wordt toegepast, maar er geen „head-of-line“-vervanging ontstaat. Daarnaast schaal ik het aantal workers voorzichtig op, zodat piekperiodes worden opgevangen zonder het RAM-geheugen te overbelasten.
Het valt me op hoe vaak streams moeten wachten, ook al zijn er threads vrij. Als dat het geval is, wordt de doorvoersnelheid meestal beperkt door streamlimieten of buffergroottes. Een Prioritering Het gebruik van kritieke bronnen (bijv. CSS/JS via HTTP/2-prioriteiten) heeft een directe invloed op de waargenomen prestaties. Wat TLS betreft, verlagen sessiehervatting, 0-RTT-achtige mechanismen (voor zover deze veilig en beschikbaar zijn) en moderne versleutelingsalgoritmen de kosten van de handshake.
Robuustheid: time-outs, bescherming tegen Slowloris en een soepele uitschakeling
Ik activeer mod_reqtimeout, om ‘slowloris’-achtige patronen te neutraliseren. Time-outs voor het lezen voorkomen dat clients bytes in een slakkengang afleveren en zo bronnen bezetten. Time-outs voor het schrijven bieden bescherming tegen trage verbindingen naar de client. Deze waarden moeten contextgebonden worden gekozen – API’s vereisen andere profielen dan het downloaden van grote bestanden.
Voor roll-outs en herstarts vertrouw ik op Sierlijke-Processen. Met een zinvolle „graceful timeout“ lopen oude processen op gecontroleerde wijze af, terwijl nieuwe processen het overnemen. Zo blijven keep-alive-verbindingen stabiel en verwerkt de eventqueue de resterende belasting zonder abrupte onderbrekingen. Roterende logbestanden, een lage log-verbaliteit tijdens piekuren (bijv. „info“ in plaats van „debug“) en optioneel BufferedLogs verlagen de I/O-belasting merkbaar.
Foutopsporing onder belasting: patronen herkennen
Typische symptomen en benaderingen: – Hoge P95/P99-Vertragingen bij vrije workers: meestal wachttijden aan de backend- of netwerkzijde; controleer proxy- en leestime-outs en backend-pools. – „server reached MaxRequestWorkers“: te weinig parallelliteit – verhoog MaxRequestWorkers en/of ThreadsPerChild, controleer het RAM-gebruik. – Veel Keep-Alive-Verbindingen, weinig actieve threads, maar toch traag: vaak blokkerende modules/filters of backend-bottlenecks; profileer de filterketen, controleer CPU-bezetting en I/O. – 5xx-pieken die samenhangen met de TLS-belasting: CPU-gebonden handshakes – versleutelingsalgoritmen, sessieherstel en eventueel offload optimaliseren.
Ik pak knelpunten in de keten aan: socket-acceptatie (backlog), event-loop (wachttoestanden), workers (CPU-gebonden), filters (I/O-gebonden), proxy (backend-gebonden). Dit denkkader voorkomt dat ik aan MaxRequestWorkers ga sleutelen, terwijl de backend eigenlijk de bottleneck is.
Checklist voor de praktijk en veelvoorkomende valkuilen
Ik werk met een korte Checklist: actuele Apache-versie, Event MPM geactiveerd, limieten correct ingesteld, time-outs zinvol. Vervolgens controleer ik de Keep-Alive-frequenties en de verhouding tussen verbindingen en actieve threads. Ik controleer of modules thread-safe zijn en of filters geen langdurige blokkades veroorzaken. Voor PHP via FPM zorg ik ervoor dat het aantal FPM-workers is afgestemd op de parallelliteit van de frontend. Ook stel ik OS-limieten in, zoals file descriptors, TCP-backlog en kernelparameters voor netwerkbuffers, zodat de Pijpleiding niet vastloopt.
Veelvoorkomende struikelblokken herken ik snel: te lange KeepAliveTimeouts, te weinig MaxRequestWorkers, een te lage ThreadsPerChild of ongeschikte logboekregistratie. Overdreven gedetailleerde logboekregistratie slokt I/O op en vertraagt de reactietijden. Een te kleine proxy-backend-poolgrootte doet afbreuk aan frontend-optimalisatie. Verkeerde TLS-configuraties verlengen handshakes onnodig. Wie deze punten goed op orde heeft, creëert een betrouwbare De basis voor constante latenties.
Samenvatting voor technisch verantwoordelijken
Event MPM maakt een duidelijk onderscheid tussen verbindingsbeheer en uitvoering en kiest voor een Evenementenwachtrij, die inactieve verbindingen op een efficiënte manier parkeert. Hierdoor schaalt Apache bij veel gelijktijdige clients, zonder dat er threads in de lucht blijven hangen. De juiste combinatie van MaxRequestWorkers, ThreadsPerChild en doordachte time-outs houdt de latentie en het RAM-gebruik binnen de perken. Door voortdurende monitoring, benchmarking en enkele gerichte aanpassingen ontstaat een systeem dat pieken opvangt en consistent reageert. Wie deze principes ter harte neemt, haalt het maximale uit zijn Apache-De installatie biedt aanzienlijk meer mogelijkheden en blijft tegelijkertijd compatibel met gangbare toepassingen en protocollen.


