 Ga naar de inhoud

Adaptive Flushing in MariaDB bepaalt hoe snel ik Vuile pagina's uit de bufferpool naar de opslagmedia schrijf, zodat het redo-log nooit een knelpunt wordt. Als ik MariaDB Adaptive Flushing optimaliseer, nemen de latentiepieken af, de Checkpoint-De voortgang blijft stabiel en de schrijfbelasting blijft voorspelbaar.
Centrale punten
- Gemeten waarden Allereerst: de vullingsgraad van het redo-log, het percentage dirty pages, de checkpoint-age
- I/O-capaciteit precies bepalen, niet schatten
- Drempelwaarden Verstandig instellen: adaptive_flushing_lwm en Dirty-Page-LWM
- Achtergrond-I/O doseren: io_capacity en io_capacity_max
- Redo-logs de juiste afmetingen kiezen voor een gelijkmatige doorstroming
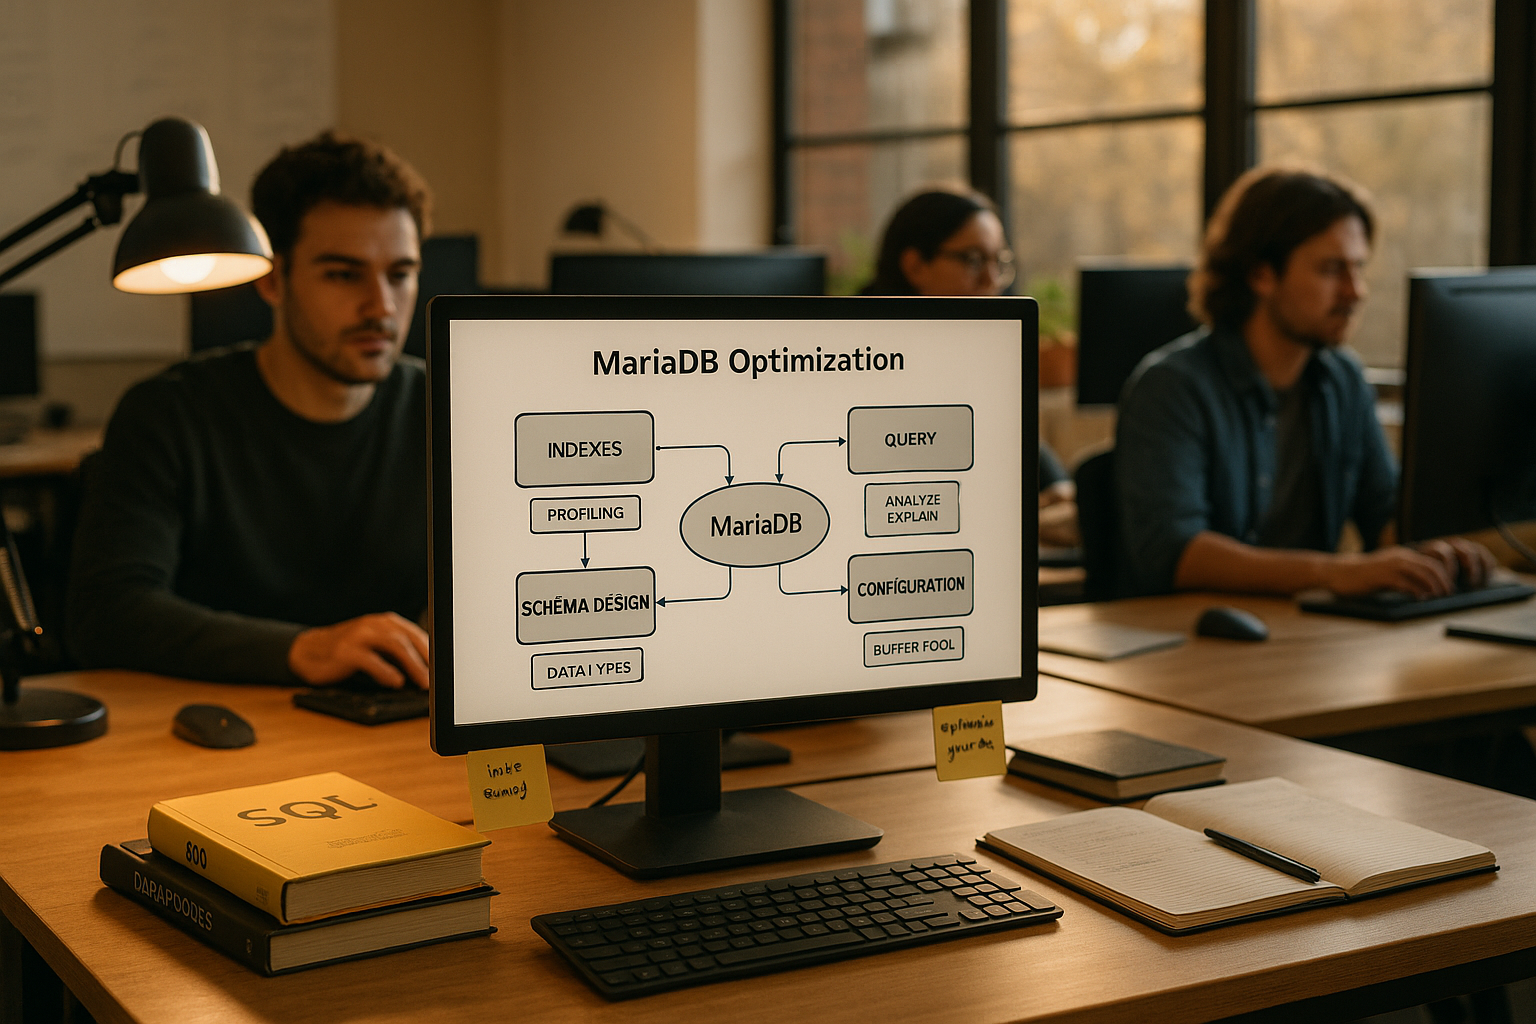
Hoe Adaptive Flushing in MariaDB werkt
Ik activeer de dynamische logica via innodb_adaptive_flushing en stuur het vroegtijdige waarschuwingsgedrag aan met innodb_adaptive_flushing_lwm. Hoe voller het redo-log is en hoe sneller het groeit, hoe agressiever InnoDB flusht om te voorkomen dat er een bottleneck ontstaat. Deze regel koppelt de flush-snelheid aan de werkelijke wijzigingsdoorvoer, waardoor korte I/O-pieken minder vaak voorkomen. Volgens de MariaDB-documentatie wordt de intensiteit afgestemd op de voortgang van de checkpoints, om wachttijden bij schrijfbewerkingen op de schijf te voorkomen. Ik houd daarbij in gedachten dat Adaptive Flushing het werk verdeelt, maar een te lage opslagprestatie niet compenseert.
Kerncijfers begrijpen: redo-log, dirty pages en checkpoints
Ik bekijk eerst het vulpercentage van de Redo-logs, het percentage ‘dirty pages’ in de bufferpool en de checkpoint-age. Deze drie waarden geven aan of de server tijdig en gelijkmatig kan flushen of dat er werk opstapelt. Als de checkpoint-leeftijd te snel toeneemt, treedt Adaptive Flushing in werking, maar dan controleer ik ook de opslaglatentie. Voor gedetailleerde vragen over de I/O-strategie helpt het mij om de relevante Flush-methoden, omdat ze bepalen hoe efficiënt de kernel de schrijfopdrachten verwerkt. Ik koppel deze signalen aan de gemeten I/O-capaciteit, zodat ik doelgericht wijzigingen in de drempelwaarden kan aanbrengen en het totale systeem coherent blijft.
De stelschroeven goed afstellen
Ik begin met innodb_io_capacity en stel de waarde zo dicht mogelijk bij het werkelijke continue vermogen van de accu in, niet bij theoretische maximumwaarden. Voor pieken houd ik rekening met innodb_io_capacity_max aanzienlijk hoger, zodat InnoDB bij hoge belasting kortstondig meer vermogen kan leveren zonder de CPU te overbelasten. De drempelwaarde innodb_adaptive_flushing_lwm Ik stel dit zo in dat de server ruim voordat het redo-log vol raakt, begint met preflushing. Daarnaast stel ik innodb_max_dirty_pages_pct_lwm zodat InnoDB bij een stijgend percentage ‘dirty pages’ vroegtijdig ingrijpt en er geen opstoppingen ontstaan. Ik pas slechts één parameter per cyclus aan, leg het effect nauwkeurig vast en geef het systeem de tijd om verschillende belastingsfasen te doorlopen, voordat ik verder ga met optimaliseren.
De I/O-capaciteit concreet meten
Ik meet de continue schrijfprestaties tijdens productielast, omdat synthetische piektests vaak valse verwachtingen wekken en de Gelijkmatigheid verdoezelen. Veelzeggend zijn gemiddelden en percentielen op middellange tot lange termijn, die korte afvlakkingen doorstaan. Ik kijk naar Write-IOPS, Write-Throughput, latenties en de verdeling van de responstijden, zodat ik niet alleen naar het gemiddelde kijk. Wie alleen uitgaat van de maximale waarde, riskeert agressieve flush-fasen, terwijl de daadwerkelijke transacties juist trager worden. Ik trek conclusies voor innodb_io_capacity op basis van het waargenomen gedrag op de lange termijn, niet op basis van kortstondige toptijden.
Overzicht van startwaarden en grenswaarden
Ik gebruik de standaardinstellingen als uitgangspunt, nooit als dogma, en toets ze aan de hand van de werkelijke werklast, de grootte van de bufferpool en de groei van de Redo-logs. SSD- en NVMe-systemen vertonen duidelijk hogere waarden dan HDD’s, maar ik stel de snelheden slechts zo hoog in dat leesoperaties niet in de wachtrij terechtkomen. Bij drukke systemen schaal ik de capaciteit langzaam op en houd ik de latentie, de checkpoint-leeftijd en het CPU-verbruik gezamenlijk in de gaten. Als het percentage ‘dirty pages’ gelijkmatig daalt en de schommelingen in de vullingsgraad van het redo-log afnemen, zit ik met een gezonde veiligheidsmarge. Cruciaal blijft voor mij dat ik Tips controleer, in plaats van ze te overschrijven met buitensporige achtergrond-I/O.
| Variabele | Effect | Typische beginwaarde HDD | Typische beginwaarde SSD | Typische startwaarde NVMe | Waar ik op let |
|---|---|---|---|---|---|
| innodb_adaptive_flushing | Dynamische flush inschakelen | OP | OP | OP | Compensatie van pieken |
| innodb_adaptive_flushing_lwm | Vroegtijdig preflushing | 20–30% | 20-40% | 30–50% | Vulniveau van het redo-log |
| innodb_io_capacity | Basis-flush-tarief | 100-300 | 800–2000 | 2000–8000 | Continue schrijf-IOPS |
| innodb_io_capacity_max | Noodgrens | 400–800 | 2000-6000 | 6000–20000 | Punten afslijpen |
| innodb_max_dirty_pages_pct_lwm | Dirty Page Low Water | 5–10% | 5–15% | 5–15% | Tijdig ingrijpen |
Probleemgevallen en symptomen herkennen
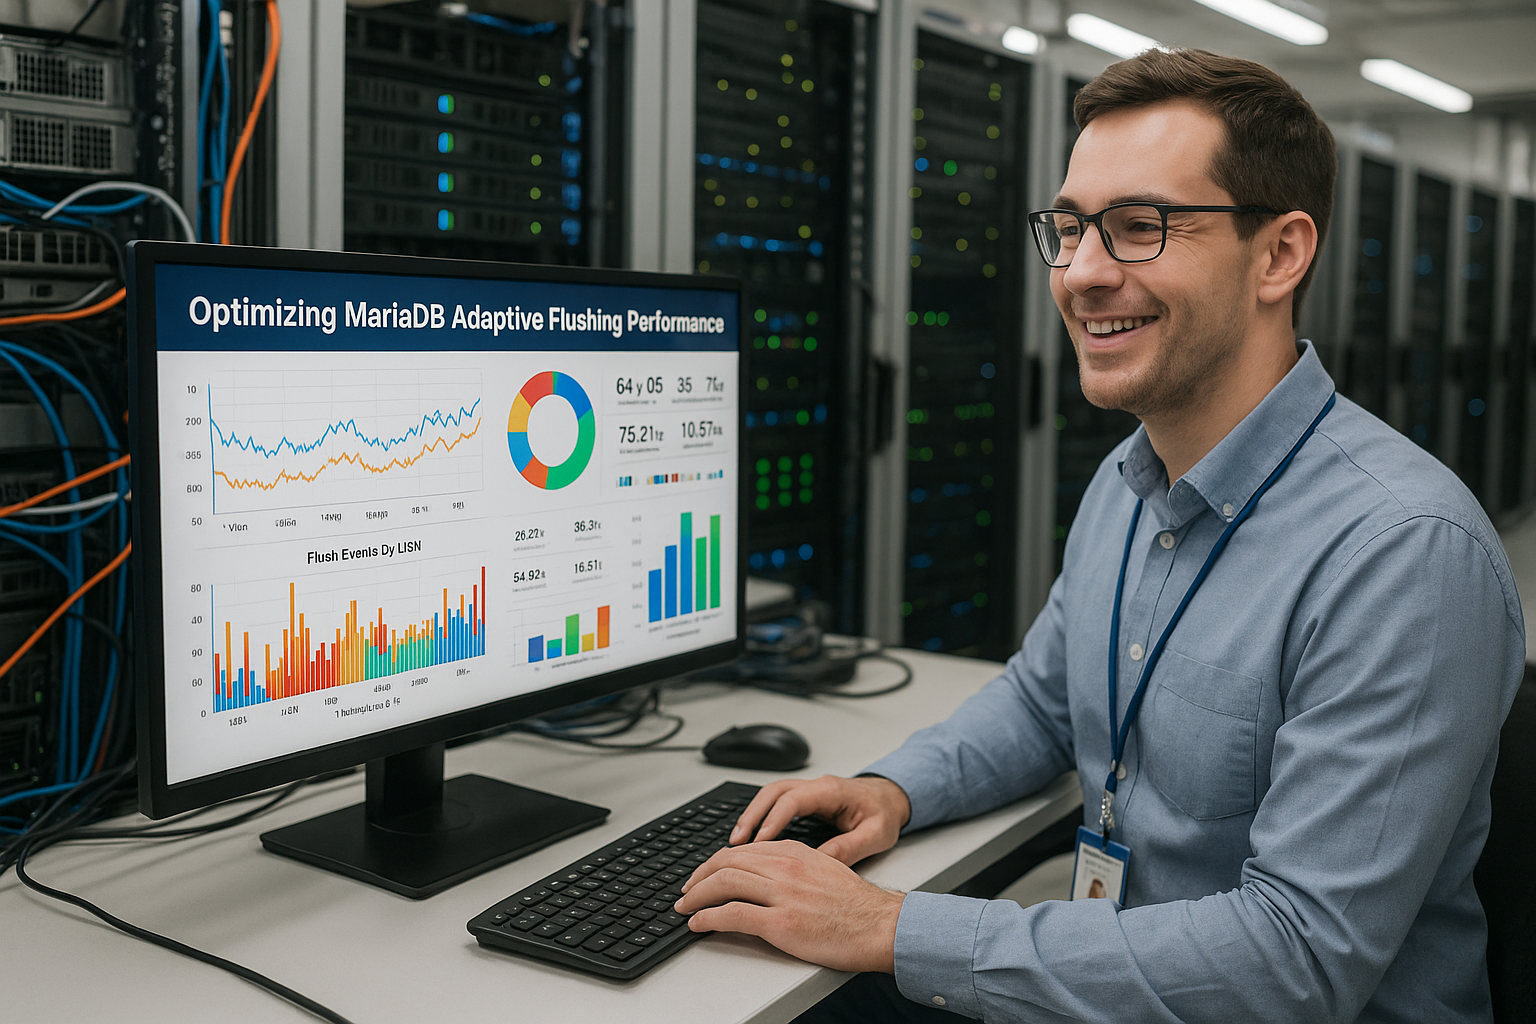
Toen ik Doorspoelen-pieken zie, controleer ik eerst de I/O-waarde: als deze te laag is, stapelen de ‘dirty pages’ zich op en moet het systeem haastig opruimen. Als de waarde te hoog is, overschaduwt achtergrond-I/O de live-workload en worden leesbewerkingen gedwongen te wachten. Een trage checkpoint-age die plotseling omhoogschiet, geeft aan dat de server te laat reageert. Tegelijkertijd wijst een snel stijgend redo-log-vulniveau erop dat de schrijfkant het niet bij kan houden of dat het log te klein is gedimensioneerd. Ik bekijk deze patronen in hun onderlinge samenhang, omdat één enkel getal het gedrag van Adaptive Flushing zelden volledig verklaart.
De Redo-Log dimensioneren voor een gelijkmatige belasting
Ik kies de grootte van de Redo-logs zodat er voldoende buffer overblijft voor piekbelastingen, zonder dat de checkpoints te lang worden. Een groter log geeft Adaptive Flushing meer ruimte om het werk te spreiden, maar ik let wel op hersteltijden en opslagbudget. Als het log met de seconde naar de limiet groeit, verlicht een bescheiden vergroting de druk en maakt het de flush-curve gelijkmatiger. Als de vergroting geen verlichting biedt, ligt het probleem meestal bij onvoldoende I/O-capaciteit of schommelende opslaglatentie. Ik besluit pas na observatieperiodes, en niet op basis van momentopnames, of ik de loggrootte nogmaals verhoog.
Page Cleaner, threads en parallelliteit
Ik bekijk het aantal Page-Cleaner-threads, omdat deze de parallelle Doorspoelen-De prestaties van de bufferpool-instanties regelen. Bij hoge schrijfbelasting zorgt extra parallelliteit voor meer doorvoer, maar ik houd de opslagwachtrij nauwlettend in de gaten. Als de opslagmedia aan prestaties inboeten door overvolle wachtrijen, verminder ik het aantal threads of beperk ik de I/O-capaciteit. Voor achtergrondinformatie over dit mechanisme helpt het overzicht van Page-Cleaner-threads, zodat ik het evenwicht tussen druk en eerlijkheid kan bewaren. Ik neem pragmatische beslissingen: zoveel threads als nodig is, zo weinig als zinvol is, zodat de reads niet in het gedrang komen.
Doublewrite-buffer: veiligheid versus schrijfsnelheid
Ik houd rekening met de Doublewrite-Buffer, want deze beschermt tegen gedeeltelijke schrijffouten, maar kost wel extra I/O. Op betrouwbare NVMe-systemen valt deze extra belasting minder op, terwijl deze op langzamere opslagmedia sterker merkbaar is. Ik meet het daadwerkelijke effect op de latentie en de page-flush-rate voordat ik aan deze instelling ga sleutelen. Voor een weloverwogen afweging maak ik gebruik van uitgebreide informatie over de Doublewrite-buffer en kijk of een ander risico- en rendementsprofiel beter bij mij past. Ik neem nooit lichtzinnig een beslissing, omdat gegevensbeveiliging en doorvoersnelheid hier in directe wisselwerking staan.
Monitoring en statistieken in de praktijk
Ik analyseer het aandeel van de ‘dirty pages’, de verhouding tussen de flush-rate en de wijzigingsfrequentie en het verloop van de Checkpoint-Age. Daarnaast houd ik de procentuele bezettingsgraad van de redo-log in de gaten, omdat een lineaire stijging wijst op krappe drempelwaarden. Ik houd naast de InnoDB-statistieken ook de I/O-latenties in de gaten, zodat ik oorzaak en gevolg duidelijk aan elkaar kan koppelen. Na elke parameterwijziging vergelijk ik identieke belastingperiodes, anders trek ik verkeerde conclusies. Ik documenteer de grafieken, omdat een afbeelding meer zegt dan een enkel meetpunt en ik zo trendbreuken zeker kan herkennen.
Stapsgewijs tuningplan
Ik begin met een realistische meting van de Schrijfsnelheid en stel op basis daarvan innodb_io_capacity in. Vervolgens definieer ik innodb_io_capacity_max als noodoplossing voor situaties onder druk, met voldoende marge ten opzichte van de basiswaarde. Vervolgens controleer ik innodb_adaptive_flushing_lwm en verlaag ik deze waarde als de checkpoint-age te laat daalt. Daarna stel ik innodb_max_dirty_pages_pct_lwm zo in dat preflushing op tijd begint en pieken vroeg worden afgebouwd. Ten slotte pas ik de grootte van het redo-log aan, observeer ik opnieuw meerdere belastingscycli en documenteer ik elke wijziging voordat ik de volgende stap zet.
Flush-mechanisme onder de motorkap
Ik maak onderscheid tussen twee belangrijke drijfveren om te schrijven: de Flush-List-Flushing (aangedreven door de voortgang bij Checkpoint) en de LRU-flushing (als gevolg van een tekort aan vrije pagina’s). Als de bufferpool vol raakt en er geen vrije pagina’s meer zijn, dwingt LRU-flushing mij tot onmiddellijke schrijfbewerkingen, wat pieken in de latentie veroorzaakt. Adaptief flushing heeft tot doel deze noodsituaties te voorkomen door de flush-lijst continu te legen. Om dit te laten slagen, houd ik het percentage vrije pagina's stabiel en houd ik waarden zoals de LRU-scandiepte en de belasting per bufferpool-instantie in de gaten. Hoe gelijkmatiger de flush-lijst wordt afgewerkt, hoe minder vaak ik in de voorgrond op vrije pagina's hoef te wachten.
Daarbij let ik op de relatie tussen innodb_buffer_pool_instances, innodb_page_cleaners en de fysieke I/O-capaciteit. Meer instanties en cleaner-threads verhogen de parallelliteit, maar alleen voor zover dat zinvol is, zolang de opslagwachtrijen niet overlopen. Als flush-bewerkingen hoge wachtrijlengtes bereiken, is dat een teken dat ik al eerder en langzamer had moeten flushen – precies dat pak ik aan via `innodb_adaptive_flushing_lwm` en de basis- en maximale capaciteiten.
Transactiecommit, redo en binlog in samenhang
Ik bekijk commit-paden en houdbaarheidsgaranties in de context van flush-afvlakking. innodb_flush_log_at_trx_commit en de Binlog-synchronisatie beïnvloeden hoe vaak het systeem fsyncs uitvoert en hoe sterk kortstondige pieken zich voordoen. Mijn richtlijnen:
- 1: Maximale duurzaamheid (bij elke commit opnieuw opschrijven naar de schijf). Veilig, maar vereist veel fsync-bewerkingen en kan mogelijk wat haperend werken.
- 2: Redo wordt elke seconde doorgestuurd, Commit schrijft alleen naar de cache van het besturingssysteem. Minder pieken, maar daar staat tegenover dat ik het risico loop op gegevensverlies bij een storing van het besturingssysteem of de host.
- 0: Vergelijkbaar met 2, maar met een nog agressievere cache. Voor productiesystemen alleen met de nodige voorzichtigheid gebruiken.
In combinatie met de Binlog-synchronisatie (sync_binlog) en Group-Commit-effecten kan ik commits bundelen en het aantal harde synchronisaties verminderen. Het is belangrijk dat ik deze middelen niet misbruik als vervanging voor een zorgvuldige afstemming van Adaptive Flushing. Ik weeg altijd risico’s, compliance-eisen en het gewenste latentieprofiel tegen elkaar af en pas de instellingen alleen aan voor zover de bedrijfsregels dat toestaan.
Purge-threads, geschiedenislengte en langlopers
Ik heb de InnoDB-opschoning Let op: veel verwijderde of bijgewerkte regels genereren undo-gegevens die asynchroon worden opgeruimd. Als de Geschiedenisduur sterk, neemt de achtergrondbelasting toe en concurreert met de page-cleaners om I/O. Dit kan Adaptive Flushing indirect vertragen. Oplossingen hiervoor zijn een passende waarde voor de purge-parallelliteit en het vermijden van langlopende transacties die de geschiedenis kunstmatig openhouden. Daarnaast plan ik batchbewerkingen zo dat ik het aantal redo- en undo-bewerkingen onder controle houd, in plaats van in korte tijd miljoenen rijen in één keer te wijzigen.
Change Buffer en merge-fasen
Ik houd rekening met de Buffer wijzigen bij intensieve updates van secundaire indexen. Het vermindert willekeurige I/O tijdens de uitvoering, maar verschuift een deel van het werk naar latere samenvoegingsfasen. Deze samenvoegingen kunnen extra flush-belasting veroorzaken als ze ongelukkig samenvallen met pieken in de productie. Ik houd daarom de omvang en activiteit van de change buffer in de gaten, beperk deze indien nodig en spreid bulkwijzigingen zodanig dat samenvoegfasen niet samenvallen met piekuren. Hierdoor blijft de flush-snelheid beter planbaar en gelijkmatiger.
Flush-methoden en invloeden van het bestandssysteem
Ik neem bewust een besluit over de Flush-methode en de opties voor het bestandssysteem. O_DIRECT voorkomt dubbele caches en zorgt daardoor vaak voor een gelijkmatiger schrijflatentie, terwijl AIO- en Fsync-paden hun eigen kenmerken hebben. Ik meet hoe deze methoden de latentieverdeling en de stabiliteit van de voortgang van het checkpoint beïnvloeden en verwijs voor gedetailleerde vragen naar de opmerkingen over Flush-methoden. Daarnaast controleer ik de koppelingsopties van het bestandssysteem en de onderhoudsroutines (bijvoorbeeld consistente TRIM-/Discard-strategieën bij SSD’s), zodat de onderliggende structuur niet onopgemerkt jitter veroorzaakt.
Diagnose: statusmeldingen correct interpreteren
Ik trek DE STATUS VAN DE INNODB-ENGINE WEERGEVEN om de Checkpoint-Age en de voortgang van de flush te beoordelen. Uit Logboekvolgnummer, Loggegeven doorgespoeld tot en Laatste controlepunt op Ik bepaal hoe groot de kloof is tussen gegenereerde en opgeslagen wijzigingen. Als die kloof voortdurend sneller groeit dan de grootte van het redo-log toelaat, is mijn achtergrond-flush te terughoudend of is de I/O-latentie te hoog. Ik vergelijk deze waarden met de InnoDB-statistieken over ‘dirty pages’, flush-rate en de activiteit van de page cleaner, zodat ik doelgericht de juiste aanpassingen kan doorvoeren in plaats van alleen de symptomen te bestrijden.
Bedrijfsscenario's: bulk, DDL en onderhoudsvensters
Ik ben van plan Bulkvracht en uitgebreide DDL-bewerkingen zodanig dat Adaptive Flushing niet wordt overschreden. Voor planbare onderhoudsvensters verhoog ik tijdelijk innodb_io_capacity_max, om aanstaande schrijfbewerkingen op een gecontroleerde manier af te handelen, en breng deze vervolgens weer terug naar het normale niveau. Bij grote imports pas ik de commit-frequenties aan, zodat de groei van de redo-log en de voortgang van de checkpoints gelijke tred houden. Ondertussen houd ik continu de vullingsgraad van het redo-log, het percentage dirty pages en de latentiepercentielen in de gaten, zodat ik bij afwijkingen onmiddellijk corrigerende maatregelen kan nemen.
Veelvoorkomende misvattingen en anti-patronen
Ik trap niet in de val, innodb_io_capacity_max als permanente toestand te gebruiken. Een te hoge Max-waarde kan de geheugenwachtrijen overspoelen en realtime leesbewerkingen vertragen. Evenmin „verberg“ ik zwak geheugen achter een enorme redo-log – grotere logs zorgen voor afvlakking, maar creëren geen I/O-reserves. En ik beschouw latentiepieken niet als een gegeven: vaak zijn ze het gevolg van te laat preflushing of sterk schommelende achtergrondbelasting, die ik kan temperen door lagere LWM-drempels en realistische capaciteitswaarden. Ten slotte vermijd ik het om meerdere instellingen tegelijk te wijzigen; anders verlies ik het causale verband en kan ik verbeteringen niet reproduceerbaar maken.
Kort samengevat
Ik gebruik Adaptief Flushing, om schrijfbewerkingen gelijkmatig over de tijd te verdelen en zo pieken in de latentie te voorkomen. De grootste invloed wordt verkregen door een nauwkeurige instelling van innodb_io_capacity en een verstandige verhouding tot innodb_io_capacity_max. Drempelwaarden die al vroeg in werking treden voor de redo-log-vulstand en het percentage ‘dirty pages’ helpen mij om wachtrijen klein te houden. Met geschikte redo-logs, een verstandige parallelliteit van de page-cleaner-threads en waakzame monitoring creëer ik betrouwbaardere schrijfroutines. Volgens de MariaDB-documentatie over systeemvariabelen en page-flushing werken deze instellingen samen – ik pas ze stapsgewijs aan en houd het effect in de gaten totdat het systeem stabiel en voorspelbaar draait.


