Przejdź do treści

Grupa cgroup w systemie Linux Kontroler procesora kontroluje, ile czasu obliczeniowego otrzymują usługi, kontenery i procesy, oraz pozwala na precyzyjne planowanie wydajności. Wyjaśnię konkretnie, w jaki sposób współdziałają ze sobą wagi, limity i praktyki, abyś mógł bezpiecznie przydzielać czas procesora i unikać wąskich gardeł.
Punkty centralne
- Ważenie kontra Limit zrozumieć: sprawiedliwy podział czy surowy limit
- cgroup v2 należy preferować: jasną semantykę, spójną hierarchię
- cpu.weight oraz cpu.max: dwie dźwignie regulacyjne
- systemd korzyści: ustalanie reguł dla poszczególnych usług
- Monitoring oraz Przejrzystość: odczytanie danych z cpu.stat i PSI
Zrozumieć cgroups: grupy procesów i cele
Podsumowuję procesy w Grupy i za jej pomocą zarządzam zasobami, takimi jak procesor, pamięć i operacje wejścia/wyjścia, w precyzyjnie wyodrębnionych hierarchiach. Zamiast żonglować pojedynczymi identyfikatorami PID, przypisuję do grupy kontrolnej całe usługi, kontenery lub pule pracowników i ustalam jasne zasady. W ten sposób zapobiegam sytuacji, w której rozrastające się zadanie spowalnia maszynę, podczas gdy ważne komponenty muszą reagować. Takie podejście sprawdza się szczególnie w kontekście hostingu, ponieważ wielu klientów i usług działa na tym samym sprzęcie. Dobry przegląd praktycznego zastosowania tego rozwiązania przedstawia ten artykuł na temat cgroups i hosting, który pozwala zrozumieć podział obciążeń.
Jak działa kontroler procesora
Kontroler procesora dzieli czas obliczeniowy dwa mechanizmy: ważenie względne i bezwzględne ograniczenie szerokości pasma. Ważenie oznacza, że grupy otrzymują udziały w mocy procesora proporcjonalnie do siebie, gdy tylko pojawia się konkurencja; wyższe wartości częściej wygrywają wówczas przedziały czasowe. Limit w postaci kwoty ogranicza zużycie w stałym przedziale czasowym, nawet jeśli nie ma konkurencji. Wybieram ważenie, gdy na pierwszym planie leżą sprawiedliwość i dynamiczne wykorzystanie zasobów, a ustalam limity, gdy twardy pułap musi pozostać niezmienny. Dokumentacja jądra jasno przedstawia tę różnicę i pokazuje, w jaki sposób oba mechanizmy razem tworzą spójny model sterowania [1].
cgroup v1 a v2: różnice i pliki
Z cgroup v2 Zarządzam regułami CPU w sposób bardziej spójny i przejrzysty w porównaniu ze starszą wersją v1. W wersji v1 korzystałem z różnych plików dla każdego kontrolera; w wersji v2 skupiam się na parametrze `cpu.weight` do ustalania względnego priorytetu oraz na parametrze `cpu.max` do ustawiania sztywnego limitu przepustowości. To wyraźne rozdzielenie skraca czas konfiguracji, pozwala uniknąć nieporozumień i ułatwia audyty. W scenariuszach hostingowych z dużą liczbą kontenerów hierarchia wersji v2 zapewnia przejrzystość reguł na wszystkich poziomach. Praktyczną ocenę tej zmiany przedstawia artykuł na temat cgroup v2 w hostingu, który porusza kwestię spójnego sterowania w przypadku wspólnie wykorzystywanej infrastruktury sprzętowej.
| Temat | cgroup v1 | cgroup v2 | Typowe parametry |
|---|---|---|---|
| Waga procesora | cpu.shares | cpu.weight | cpu.weight (wartość domyślna to zazwyczaj 100) |
| Limity/ograniczenia procesora | cpu.cfs_quota_us + cpu.cfs_period_us | cpu.max | cpu.max (np. 20 000 100 000) |
| Hierarchia | Oddzielne kontrolery | Jednolita struktura drzewa | Wspólne zasady dla każdego poziomu |
| Czas rzeczywisty | Oddzielny kontroler rt | Ograniczenia dotyczące RT | Zobacz uwagi dotyczące jądra [1] |
Dla administratorów liczy się to, że Spójność Ograniczam liczbę błędów w zestawie reguł i sprawiam, że zmiany wchodzą w życie szybciej. Dokumentuję parametry w węzłach grupowych, aby każdy mógł rozpoznać ich aktualny wpływ. Podczas migracji z wersji v1 dokładnie sprawdzam odpowiedniki, zwłaszcza udziały (Shares) w stosunku do wagi (Weight) oraz limit CFS (CFS-Quota) w stosunku do cpu.max. Dopiero gdy obciążenia testowe reagują zgodnie z oczekiwaniami, przenoszę usługi produkcyjne do nowej hierarchii. Takie zdyscyplinowane wdrażanie zmian pozwala później zaoszczędzić wiele cykli wsparcia technicznego.
Hierarchia, poddrzewa i delegowanie uprawnień
W cgroup v2 steruję kontrolerami na poziom i w razie potrzeby deleguj je dalej. Poprzez cgroup.subtree_control włączam kontroler procesora dla węzłów podrzędnych; systemd zazwyczaj robi to automatycznie, gdy ustawiam właściwości procesora. Ważne: W wersji 2 procesy najlepiej utrzymywać w Grupy liści a nie w węzłach pośrednich. Dzięki temu reguły są bardziej jednoznaczne, a rozkład obciążenia wyraźnie odzwierciedla strukturę drzewa. W złożonych konfiguracjach przypisuję całe usługi do segmentów (np. tenant-a.slice), w tym usługi i pule pracowników. To wyraźne rozdzielenie ułatwia delegowanie zadań zespołom, które pracują w „swoich“ poddrzewach, bez naruszania globalnych zasad.
Ważne parametry: cpu.weight i cpu.max
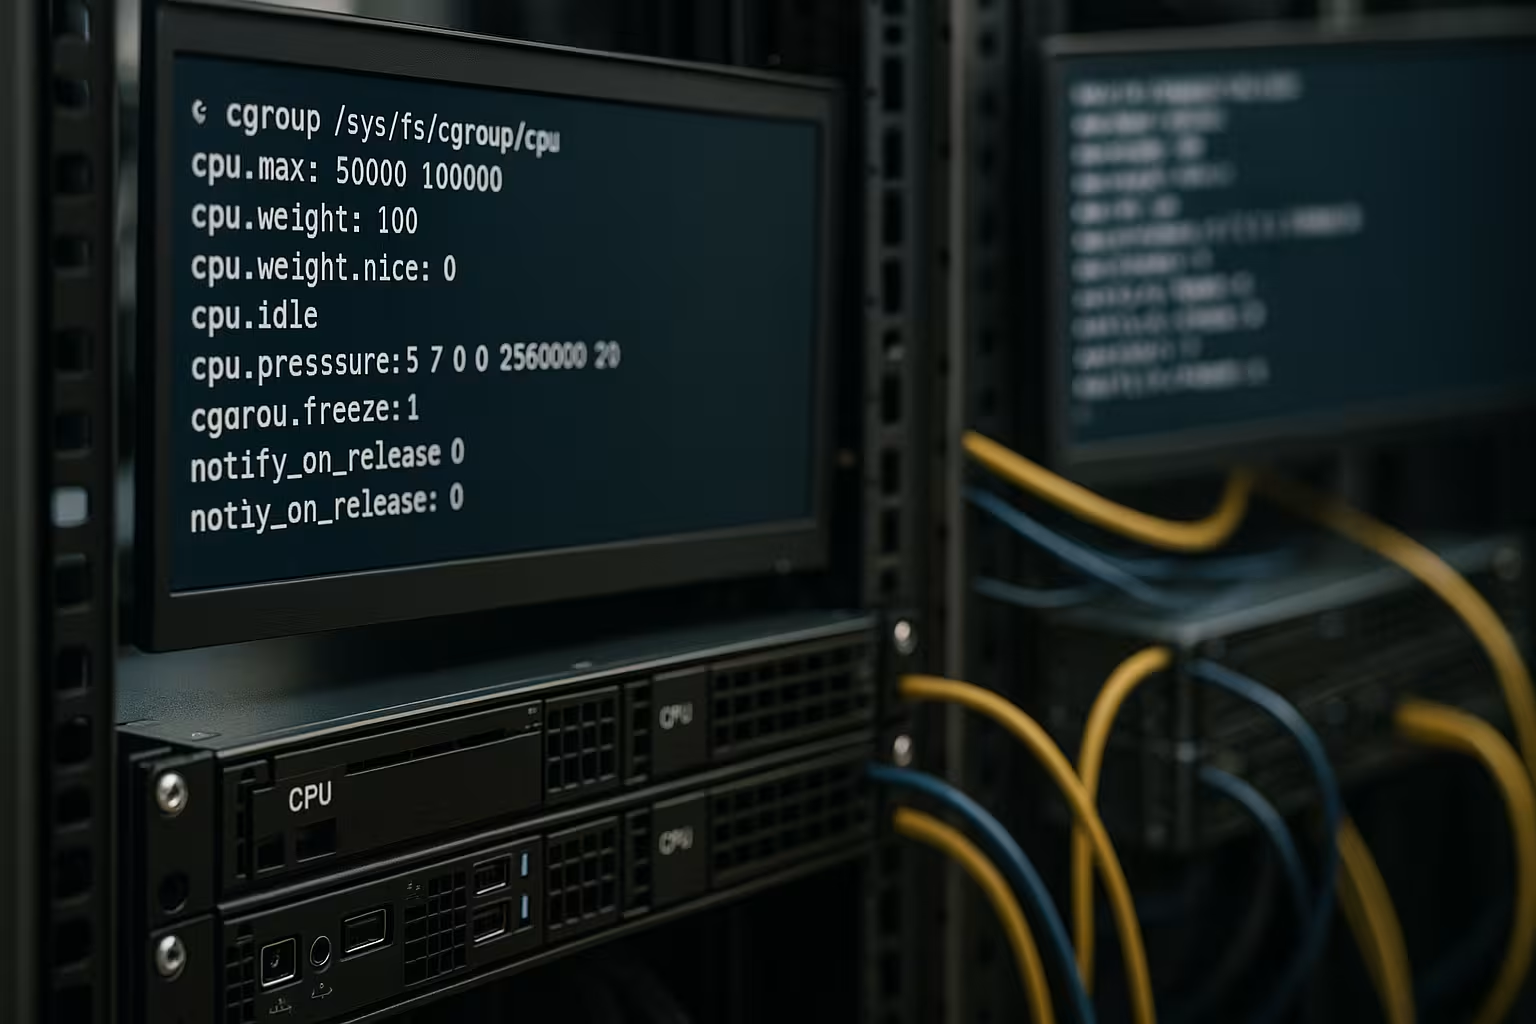
Używam cpu.weight, aby ustalić względne priorytety usług: jeśli usługa A otrzyma wyższą wagę niż usługa B, to przy obciążeniu A będzie częściej otrzymywać czas procesora. Domyślna wartość w wersji v2 to zazwyczaj 100; wyższe wartości faworyzują daną grupę, jednak pozostaję w rozsądnych granicach, aby zachować kontrolę nad proporcjami. W przypadku sztywnego ograniczenia wpisuję w cpu.max współczynnik i okres, na przykład 20000 100000 za około 20 procent miejsca na vCPU. Z max Jako pierwszą zmianę znoszę ograniczenie, pozostawiając jednak okres, co ułatwia diagnozowanie. Firma Red Hat w przystępny sposób opisuje typowe ustawienia i pokazuje ich wpływ na działanie systemu [2].
Dodatkowe parametry regulacyjne: cpu.weight.nice i UClamp
Dla zespołów, które korzystają z klasycznego ładny-Jeśli chodzi o semantykę, wersja v2 oferuje cpu.weight.nice praktyczny pomost: mogę tworzyć grupy w zakresie -20..19 klasyfikować, co wewnętrznie przekłada się na skalę wagową. Dzięki temu względne oczekiwania („nieco preferować“, „lekko ograniczyć“) pozostają spójne, bez konieczności ustalania za każdym razem konkretnych wag. Ponadto w razie potrzeby stosuję Ograniczenie wykorzystania za pośrednictwem cpu.uclamp.min oraz cpu.uclamp.max, aby określić minimalną lub maksymalną wartość efektywnego obciążenia procesora na poziomie harmonogramu. W ten sposób zapewniam np., że usługa, dla której opóźnienia mają kluczowe znaczenie, nie spadnie poniżej wymaganego obciążenia podstawowego nawet przy małej liczbie wątków, lub że zadania wsadowe nie otrzymają zbyt dużego przyspieszenia. Ta precyzyjna regulacja uzupełnia wagi i limity, ale ich nie zastępuje: zawsze sprawdzam, jak UClamp współgra z moimi ustawieniami regulatorów i polityką energetyczną, zanim wdrożę go na szeroką skalę.
Planowanie obciążeń: sprawiedliwość a sztywne ograniczenia
Świadomie decyduję, czy Sprawiedliwość lub czy pierwszeństwo mają ścisłe limity. W przypadku usług internetowych, dla których opóźnienia mają kluczowe znaczenie, nieznacznie zwiększam wagę, aby były one obsługiwane w pierwszej kolejności w sytuacji konkurencji, bez nadmiernego dyskryminowania innych grup. W przypadku zadań wsadowych wymagających dużej mocy obliczeniowej ustalam dodatkowo limit, aby nigdy nie zajmowały zbyt dużo czasu, nawet jeśli system ma w innym przypadku wolne zasoby. Bazy danych obciążam umiarkowanie i obserwuję, jak wpływają na system punkty kontrolne, odbudowy lub duże zapytania; w razie potrzeby wprowadzam tymczasowe korekty. Zasady te łączę z alertami, aby móc reagować wcześnie, zanim opóźnienia się nasilą.
Zachowanie współczynników na procesorach wielordzeniowych i wybór okresu
Częstą przeszkodą jest interpretacja Wydajność w systemach wielordzeniowych. Wskaźnik odnosi się do Całkowity czas obliczeniowy grupy w danym okresie, a nie poszczególnych jąder. CPUQuota=200% lub cpu.max = 200000 100000 Pozwalają one w przybliżeniu na dwie sekundy czasu procesora na okres 100 ms – rozłożone na wszystkie wątki/rdzenie. Może to oznaczać, że wiele wątków działa równolegle przez krótki czas, dopóki pula w bieżącym okresie nie zostanie „wyczerpana“ i nie nastąpi jej ograniczenie. Aby uniknąć nieporozumień, zawsze myślę o limitach w kategoriach „slotów procesora“ i dostosowuję je do stopnia równoległości danej usługi.
Standardowy okres wynosi często 100 ms. Krótsze okresy (z. B. 50 ms) sprawiają, że ograniczanie zaczyna działać szybciej, ale mogą powodować mikrozachwiany; dłuższe okresy wygładzają sygnał, ale reagują wolniej. W systemd dostosowuję to za pomocą CPUQuotaPeriodSec= i sprawdzam, czy uda się lepiej osiągnąć szczytowe wartości opóźnienia czy cele przepustowości. W przypadku usług interaktywnych mierzę opóźnienie od początku do końca, natomiast w przypadku przetwarzania wsadowego kieruję się całkowitą przepustowością oraz sprawiedliwością wobec sąsiadów.
W praktyce: Konfiguracja z wykorzystaniem systemd i cgroup v2
W systemd definiuję reguły dla poszczególnych usług, ponieważ Pliki służbowe umożliwiać odtworzenie konfiguracji. Dzięki systemctl set-property ciągle je zmieniam, a dzięki plikom typu „drop-in” starannie wersjonuję ustawienia. Przykład: systemctl set-property --runtime nginx.service CPUWeight=150 NGINX z łatwością ustala priorytety; systemctl set-property --runtime batch.service CPUQuota=20% ogranicza zadania wsadowe. Na stałe wpisuję w /etc/systemd/system/service.d/limits.conf Wybierz odpowiednie opcje i zaktualizuj jednostki. Aby łatwiej zacząć, warto zapoznać się z tym poradnikiem dotyczącym Kontrola zasobów systemd, w którym krótko podsumowano najczęstsze opcje.
# Przykłady dla systemd v245+ z cgroup v2
# Priorytetyzacja względna
systemctl set-property --runtime nginx.service CPUWeight=150

# Sztywny limit górny
systemctl set-property --runtime batch.service CPUQuota=20%

# Kombinacja w pliku typu 'drop-in'
mkdir -p /etc/systemd/system/php-fpm.service.d
cat < /etc/systemd/system/php-fpm.service.d/cpu.conf
[Service]
CPUWeight=120
CPUQuota=50%
EOF
systemctl daemon-reload
systemctl restart php-fpm.service
Slices dla dzierżawców i zespołów
W przypadku granic klientów lub zespołów korzystam z Plasterki jako element łączący pod względem organizacyjnym. Jeden „slice” obejmuje kilka usług i zakresów, które są regulowane wspólnie. W ten sposób przydzielam budżety poszczególnym klientom bez konieczności indywidualnego zarządzania każdą jednostką oraz w kontrolowany sposób deleguję zmiany.
# – segment najemcy z regułami domyślnymi
mkdir -p /etc/systemd/system/tenant-a.slice.d
cat < /etc/systemd/system/tenant-a.slice.d/cpu.conf
[Slice]
CPUWeight=120
CPUQuota=150%
# Opcjonalnie: okres dla bardziej precyzyjnego ograniczania wydajności
CPUQuotaPeriodSec=100ms
EOF
systemctl daemon-reload
systemctl restart tenant-a.slice
Wszystkie usługi pod adresem tenant-a.slice przjmują te wytyczne. W przypadku krótkotrwałych szczytów tymczasowo zwiększam obciążenie, ale utrzymuję współczynnik na stałym poziomie, aby nie wyprzeć sąsiednich systemów.
Monitorowanie i rozwiązywanie problemów
Sprawdzam działanie i skutki uboczne za pomocą Przejrzystość w metrykach. Pliki cpu.stat oraz cpu.pressure (PSI) dla każdej grupy cgroup otrzymuję dane dotyczące udziałów, czasów oczekiwania i zatorów, które wskazują na ograniczenie przepustowości lub przeciążenie. Dzięki top, htop oraz systemd-cgtop na bieżąco rozpoznaję trendy w rozkładzie i porównuję je z moimi regułami. Jeśli opóźnienia rosną, ale procesor pozostaje w stanie bezczynności, problem wynika raczej z operacji wejścia/wyjścia (I/O) lub blokad niż z ograniczeń procesora; nie dostosowuję wtedy pochopnie wagi. Po wprowadzeniu zmian dokumentuję wyniki pomiarów przez co najmniej jeden cykl obciążenia, aby uniknąć błędnych korelacji.
Podręcznik monitorowania: co konkretnie czytam
cpu.stat: usage_usec, user_usec, system_usec pokazują zużycie; nr_okresów, nr_throttled, throttled_usec ujawniają drastyczne ograniczenia. Wzrasta nr_throttled/nr_periods o kilka procent – oznacza to, że przedział jest zbyt wąski lub okres zbyt krótki.cpu.pressure: Obserwuję niektóre średnie 10/60/300 w przypadku zatorów mających wpływ na opóźnienia. Trwale podwyższona wartość pomimo wolnych procesorów wskazuje na rywalizację o blokady, konflikty powinowactwa lub zdalne dostępy NUMA.systemd-cgtoporazps: Sprawdzam, czy wątki rzeczywiście mogą działać równolegle, czy też czekają na zasoby wyłączone.
Aby zapewnić powtarzalność testów, stosuję stress-ng, sysbench lub uruchamiam własne generatory obciążenia i przed oraz po wprowadzeniu zmian rejestruję migawki metryczne. Dopiero gdy wartości pomiarowe stabilnie odpowiadają oczekiwaniom, wdrażam zmiany.
Czas rzeczywisty i cechy szczególne
Na stronie Czas rzeczywisty-Jeśli chodzi o obciążenia, stosuję się do wskazówek zawartych w dokumentacji jądra, ponieważ wersja v2 obsługuje kontroler procesora dla RT tylko w ograniczonym zakresie. Niektóre wątki RT muszą znajdować się w grupie cgroup root, a konfiguracja wymaga ostrożnego postępowania. Sprawdzam również, jak harmonogramowanie RT współdziała z limitami, aby żaden termin nie został przypadkowo przekroczony. W przypadku typowych usług internetowych i baz danych stosuję standardowe zasady, ponieważ taka konfiguracja pozwala na bezpieczniejsze planowanie w codziennej eksploatacji. Gdy potrzebuję RT, oddzielam systemy lub wyraźnie rezerwuję jądra, aby uniknąć nieoczekiwanych interakcji [1].
Precyzyjne sterowanie w systemach wielordzeniowych
Kontroler procesora dzieli Okno czasowe, a nie częstotliwość taktowania, dlatego w razie potrzeby łączę to z cpuset i afinnością. Aby uzyskać niskie opóźnienia, ograniczam przełączanie między gniazdami, przypisuję wątki do rdzeni lokalnych w ramach NUMA oraz optymalizuję rozkład IRQ. Usługi wsadowe uruchamiam w sposób bardziej elastyczny, aby mogły wykorzystywać wolną moc obliczeniową bez blokowania rdzeni przeznaczonych dla krytycznych interfejsów użytkownika. Sprawdzam zasady działania trybów Turbo lub Powersave, ponieważ zmiany częstotliwości mogą znacząco wpłynąć na zachowanie systemu pod obciążeniem. Dopiero suma limitów, wag, powinowactwa procesora i strategii energetycznej zapewnia spójne wyniki.
SMT, NUMA i powinowactwo w praktyce
W systemach z SMT/Gwintowanie nadprądowe Zwracam uwagę, że dwa wątki logiczne na jednym rdzeniu fizycznym nie zapewniają dwóch pełnych slotów procesora. Limit „100 %“ obejmuje jeden slot logiczny, a niekoniecznie pełną moc rdzenia fizycznego. Dlatego mierzę opóźnienie i przepustowość zarówno z wykorzystaniem SMT, jak i bez niego. W systemach NUMA ograniczam usługi krytyczne za pomocą AllowedCPUs= (cpuset) lub CPUAffinity= wykorzystaj lokalne jądra i odpowiednio skonfiguruj przypisanie pamięci, aby dostęp zdalny nie zniweczył wszystkich szczegółowych planów.
Najlepsze praktyki w zakresie hostingu i kontenerów
Zaczynam od umiarkowanego Ustawienia domyślne: Usługi internetowe przypisuję nieco wyższy współczynnik wagi, bazy danych – zbliżony do standardowego, przetwarzanie wsadowe z limitem. Dla dzierżawców ustalam limity maksymalne na klienta i zezwalam na chwilowe przekroczenia dzięki odpowiedniej wadze, o ile nie ma innych potrzeb. Dokumentuję profile według przypadków użycia, na przykład „krytyczne pod względem opóźnień“, „mieszane“ i „wymagające dużej mocy obliczeniowej“, oraz ustalam dla każdego profilu jasne przedziały wartości dla wagi i cpu.max. Zmiany najpierw wprowadzam do środowiska stagingowego i testuję przy użyciu obciążenia syntetycznego, które realistycznie odzwierciedla szczytowe obciążenia. Dzienniki i metryki utrzymuję blisko limitów cgroup, aby diagnostyka nie kończyła się w mgle.
Koordynacja kontenerów: udziały, żądania i limity
W środowiskach kontenerowych mapuję Żądania na wagę względną oraz Ograniczenia na sztywne limity. Pozwala to na intensywne obciążenie, o ile węzły dysponują wolną przepustowością, i zapewnia sprawiedliwy podział zgodnie z wagą w warunkach konkurencji. Krytyczne pody lub usługi otrzymują nieco większą wagę, bez tego, by limity ograniczały możliwości pozostałych. Dbam o to, aby suma limitów na węzeł była realistycznie dopasowana do dostępnej mocy obliczeniowej procesora; w przeciwnym razie, mimo jasnych zasad, dojdzie do ogólnosystemowego ograniczenia przepustowości, które dotknie wszystkich najemców.
Przykładowe konfiguracje i przykłady obliczeń
Współczynniki zawsze przeliczam na Akcje na każde gniazdo vCPU: cpu.max = OKRES LIMITU odpowiada LIMIT/OKRES automatu. Przykład: 20000 100000 wynoszą 0,2 dla pojedynczego procesora; w przypadku czterech procesorów jest to maksymalnie 0,8 całkowitego slota, ale rozkład ten nie jest gwarantowany. W przypadku wartości procentowych w systemd piszę CPUQuota=20%, co w zależności od wersji jest zgodne z parametrem cpu.max. Kto ustala sztywne ograniczenia, musi porównać zachowanie w trybie burst z opóźnieniem: zbyt krótki okres może powodować mikrozacięcia, natomiast zbyt długi zapewnia płynniejsze działanie, ale reaguje wolniej. Dlatego testuję okresy w zakresie 50–100 ms i wybieram wariant, który pasuje do klasy opóźnienia danej usługi [2].
Migracja z wersji 1 do wersji 2 bez niespodzianek
Podczas zmiany linii przewożę cpu.shares w cpu.weight oraz cpu.cfs_quota_us/period_us w cpu.max. Pragmatycznym odwzorowaniem dla akcji jest: 1024 → ~100, 2048 → ~200, 512 → ~50. Drobne korekty wprowadzam po testach obciążeniowych, ponieważ skale się różnią. Planuję również, że zasady wersji 2 będą przeznaczone dla dzieci skumulowany działają: Kwota ograniczająca na węźle nadrzędnym nakłada ograniczenie na wszystkie podgrupy łącznie. Dlatego często znoszę kwoty nadrzędne (max) i dostosowuję ustawienia z dużą precyzją w poszczególnych arkuszach, aby uniknąć efektów ubocznych.
Typowe usterki i sposoby ich usuwania
- 100 % pomylone z „wszystkimi rdzeniami“: 100 jednostek % odpowiada jednemu logicznemu gniazdu procesora, a nie całej maszynie. Rozwiązanie: Obliczyć limit na podstawie liczby potrzebnych gniazd (np. 400 jednostek % na cztery gniazda).
- Zbyt krótki okres: Drobne zacięcia w usługach interaktywnych. Rozwiązanie: zwiększyć okres lub zastosować wagę zamiast współczynnika.
- Waga zmierzona bez uwzględnienia konkurencji: Waga ma znaczenie dopiero w warunkach konkurencji. Rozwiązanie: przeprowadzić testy z rzeczywistym obciążeniem równoległym.
- Zapomnij o kwotach dla rodziców: Ograniczony element nadrzędny ogranicza działanie wszystkich elementów podrzędnych. Rozwiązanie:
cpu.max=maxna elemencie nadrzędnym, ograniczenia na liściach. - NUMA/gniazdo pominięte: Opóźnienie mimo wolnego procesora. Rozwiązanie: Sprawdzić afinność/zestawy procesorów oraz lokalizację pamięci.
Podsumowanie
Z Kontroler procesora Celowo przydzielam czas obliczeniowy, ustalam sprawiedliwe priorytety i wyznaczam ścisłe ograniczenia tam, gdzie jest to konieczne. cgroup v2 oferuje w tym zakresie jasne parametry, takie jak cpu.weight i cpu.max, które planuję i mierzę w zależności od obciążenia. Za pomocą systemd ustalam reguły dla poszczególnych usług, sprawdzam ich działanie za pomocą cpu.stat i PSI oraz dostosowuję je bez zgadywania. W przypadku najemców, kontenerów i mieszanych środowisk serwerowych takie sterowanie pozostaje kluczem do osiągnięcia niezawodności i przewidywalności. Kto dokumentuje reguły, wprowadza je stopniowo i weryfikuje za pomocą testów obciążeniowych, zapobiega wąskim gardłom i zachowuje kontrolę nad czasem procesora.