 Przejdź do treści

Funkcja Adaptive Flushing w MariaDB reguluje, jak szybko Brudne strony zapisuję z puli buforów na nośnik danych, aby dziennik ponownego wykonania nigdy nie stał się wąskim gardłem. Gdy optymalizuję funkcję Adaptive Flushing w MariaDB, zmniejszają się szczytowe wartości opóźnień, a Punkt kontrolny-Postępy są stabilne, a obciążenie zapisem pozostaje przewidywalne.
Punkty centralne
- Zmierzone wartości Po pierwsze: poziom zapełnienia dziennika Redo, odsetek brudnych stron, wiek punktu kontrolnego
- Pojemność wejść/wyjść określić dokładnie, a nie szacować
- Wartości progowe Właściwe ustawienie: adaptive_flushing_lwm i Dirty-Page-LWM
- We/wy w tle wartości: io_capacity i io_capacity_max
- Dzienniki ponownego wykonania dobór odpowiednich wymiarów w celu zapewnienia równomiernego przepływu
Jak działa funkcja Adaptive Flushing w MariaDB
Aktywuję logikę dynamiczną za pomocą innodb_adaptive_flushing i kieruj zachowaniami związanymi z wczesnym ostrzeganiem za pomocą innodb_adaptive_flushing_lwm. Im bardziej zapełniony jest dziennik ponownego wykonania (Redo Log) i im szybciej się powiększa, tym bardziej agresywnie InnoDB przeprowadza operacje flush, aby nie doszło do wąskiego gardła. Zasada ta wiąże częstotliwość operacji flush z rzeczywistą przepustowością zmian, dzięki czemu rzadziej występują krótkie skoki obciążenia we/wy. Zgodnie z dokumentacją MariaDB intensywność ta jest dostosowywana do postępu tworzenia punktów kontrolnych, aby uniknąć opóźnień związanych z operacjami zapisu na dysku. Należy jednak pamiętać, że adaptacyjne opróżnianie rozkłada obciążenie, ale nie kompensuje zbyt niskiej wydajności pamięci.
Zrozumienie kluczowych wskaźników: dziennik powtórzeń (Redo-Log), brudne strony (Dirty Pages) i punkty kontrolne (Checkpoints)
Najpierw sprawdzam procentowy poziom napełnienia Dzienniki ponownego wykonania, wskaźnik brudnych stron w puli buforów oraz wiek punktów kontrolnych. Te trzy wskaźniki pokazują mi, czy serwer jest w stanie na czas i równomiernie opróżniać pamięć buforową, czy też gromadzą się zaległości. Jeśli czas życia punktu kontrolnego rośnie zbyt szybko, uruchamia się funkcja Adaptive Flushing, ale wówczas dodatkowo sprawdzam opóźnienie pamięci masowej. W przypadku szczegółowych pytań dotyczących strategii operacji wejścia/wyjścia pomocne jest zapoznanie się z odpowiednimi Metody flush, ponieważ decydują one o tym, jak efektywnie jądro przetwarza polecenia zapisu. Łączę te sygnały z zmierzoną przepustowością operacji wejścia/wyjścia, aby móc celowo dostosowywać wartości progowe i zapewnić spójność całego systemu.
Prawidłowe wyregulowanie śrub regulacyjnych
Zaczynam od innodb_io_capacity i ustaw wartość zbliżoną do rzeczywistej mocy ciągłej akumulatora, a nie do teoretycznych wartości maksymalnych. Jeśli chodzi o wartości szczytowe, uważam, że innodb_io_capacity_max znacznie wyższy, aby InnoDB mógł na krótko zwiększyć wydajność w sytuacji obciążenia, nie przeciążając procesora. Wartość progową innodb_adaptive_flushing_lwm ustawiam to tak, aby serwer rozpoczął preflushing w sposób zauważalny, zanim dziennik redo zapełni się całkowicie. Dodatkowo ustawiam innodb_max_dirty_pages_pct_lwm tak, aby InnoDB mógł wcześnie podjąć odpowiednie działania w miarę wzrostu wskaźnika brudnych stron i zapobiec powstawaniu zatorów. Zmieniam tylko jedną wartość na cykl, skrupulatnie rejestruję efekty i daję systemowi czas na przejście przez kilka faz obciążenia, zanim przystąpię do dalszej optymalizacji.
Konkretny pomiar przepustowości wejść/wyjść
Mierzę ciągłą wydajność zapisu podczas obciążenia produkcyjnego, ponieważ syntetyczne testy szczytowe często budzą fałszywe nadzieje, a Równomierność zamaskować. Istotne znaczenie mają średnie i percentyle w perspektywie średnio- i długoterminowej, które przetrwają krótkotrwałe wygładzanie danych. Analizuję Write-IOPS, przepustowość zapisu, opóźnienia oraz rozkład czasów odpowiedzi, aby nie skupiać się wyłącznie na wartości średniej. Kto opiera się wyłącznie na wartości maksymalnej, ryzykuje agresywne fazy opróżniania pamięci, podczas gdy rzeczywiste transakcje ulegają spowolnieniu. Wyciągam wnioski dotyczące innodb_io_capacity na podstawie obserwowanego zachowania w dłuższej perspektywie, a nie na podstawie krótkotrwałych rekordów.
Przegląd wartości początkowych i wartości granicznych
Wartości początkowe traktuję jako punkt wyjścia, a nie jako dogmat, i weryfikuję je w oparciu o rzeczywiste obciążenie, wielkość puli buforów oraz wzrost Dzienniki ponownego wykonania. Systemy SSD i NVMe osiągają zdecydowanie wyższe wartości niż dyski HDD, ale ustawiam te wartości na takim poziomie, aby operacje odczytu nie trafiały do kolejki. W przypadku obciążonych systemów stopniowo zwiększam pojemność, obserwując jednocześnie opóźnienia, wiek punktów kontrolnych oraz zużycie procesora. Jeśli wskaźnik brudnych stron równomiernie spada, a wahania poziomu zapełnienia dziennika ponownego wykonania maleją, osiągam bezpieczny margines bezpieczeństwa. Kluczowe znaczenie ma dla mnie to, że Wskazówki kontroluj, zamiast zagłuszać je nadmierną aktywnością operacji wejścia/wyjścia w tle.
| Zmienna | Efekt | Typowa wartość początkowa dysku twardego (HDD) | Typowa wartość początkowa dysku SSD | Typowa wartość początkowa NVMe | Na co zwracam uwagę |
|---|---|---|---|---|---|
| innodb_adaptive_flushing | Włącz dynamiczne opróżnianie | ON | ON | ON | Kompensacja impulsów |
| innodb_adaptive_flushing_lwm | Wczesne przepłukiwanie | 20–30% | 20-40% | 30–50% | Poziom zapełnienia dziennika ponownego wykonania |
| innodb_io_capacity | Podstawowa stawka za przepłukanie | 100-300 | 800–2000 | 2000–8000 | Liczba operacji zapisu na sekundę (IOPS) przy obciążeniu ciągłym |
| innodb_io_capacity_max | Próg sytuacji kryzysowej | 400–800 | 2000-6000 | 6000–20000 | Usuwanie nadmiaru |
| innodb_max_dirty_pages_pct_lwm | Dirty Page – niski poziom wody | 5–10% | 5–15% | 5–15% | Wczesne podjęcie działań zaradczych |
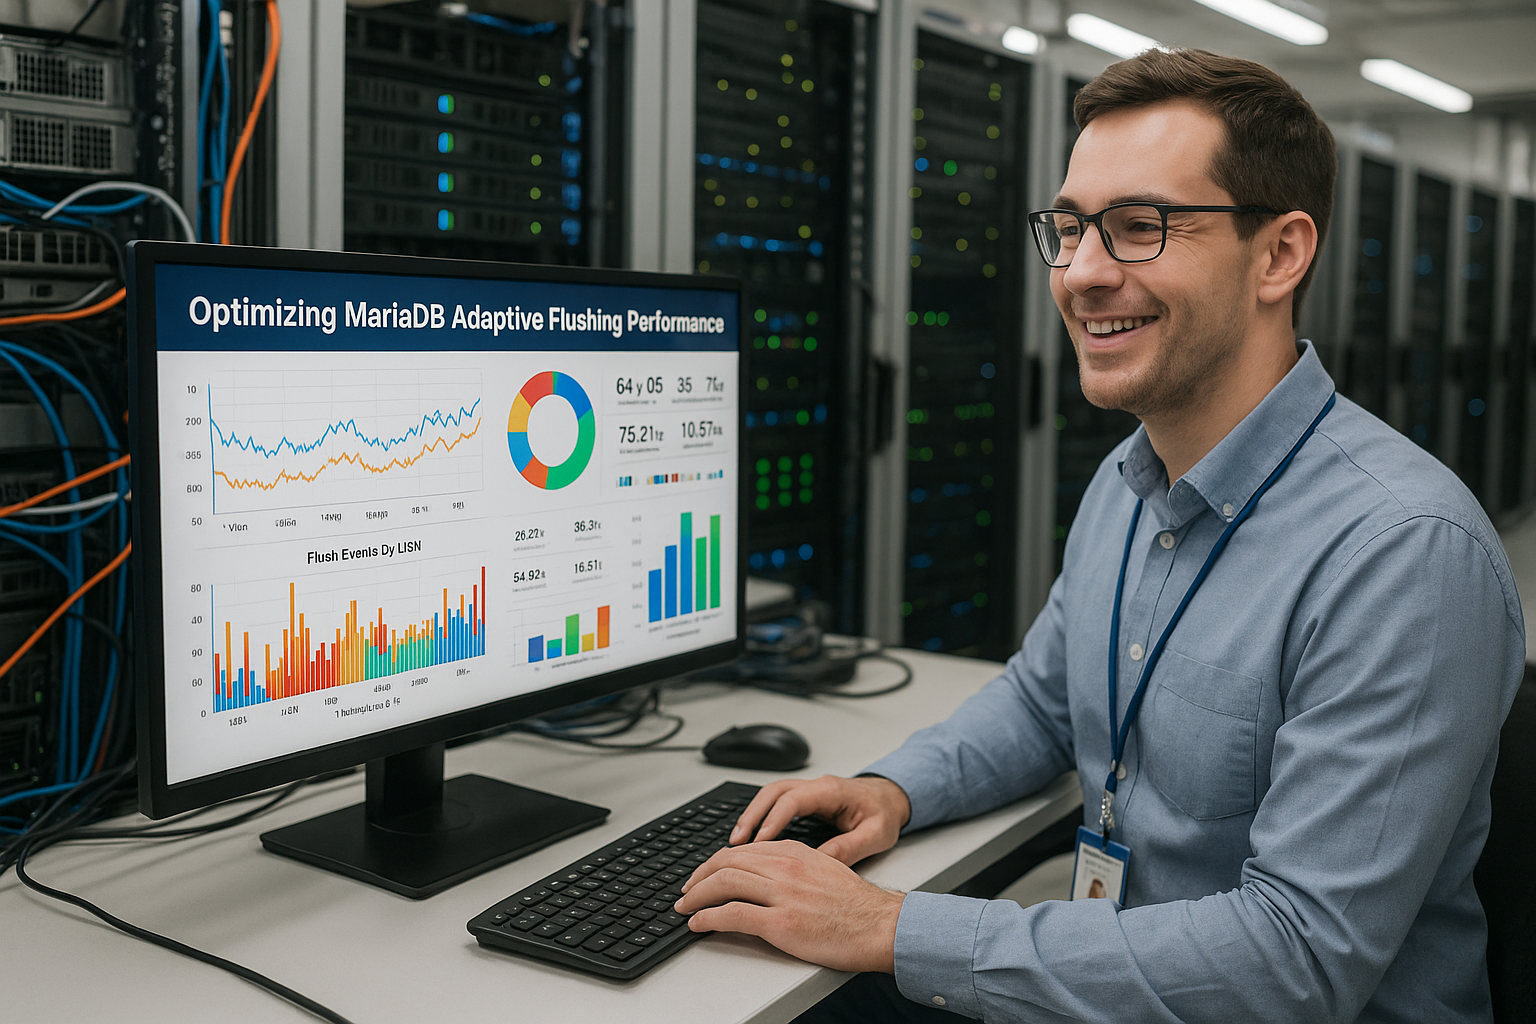
Rozpoznawanie problemów i objawów
Kiedy Spłukiwanie– Gdy dostrzegam takie skoki, najpierw sprawdzam wartość I/O: jeśli jest zbyt niska, gromadzą się brudne strony, a system musi pilnie je usunąć. Jeśli wartość jest zbyt wysoka, operacje I/O w tle dominują nad bieżącym obciążeniem i powodują, że operacje odczytu muszą czekać. Powolny czas życia punktu kontrolnego (Checkpoint-Age), który nagle gwałtownie wzrasta, wskazuje mi, że serwer reaguje zbyt późno. Jednocześnie szybko rosnący poziom zapełnienia dziennika ponownego wykonania (Redo-Log) sygnalizuje, że strona zapisu nie nadąża lub że dziennik jest zbyt mały. Analizuję te wzorce łącznie, ponieważ pojedyncza liczba rzadko w pełni wyjaśnia zachowanie funkcji Adaptive Flushing.
Dopasowanie rozmiaru dziennika Redo w celu zapewnienia równomiernego obciążenia
Wybieram rozmiar Dzienniki ponownego wykonania tak, aby pozostało wystarczająco dużo miejsca na fale obciążenia, a punkty kontrolne nie były zbyt długie. Większy dziennik daje funkcji Adaptive Flushing więcej swobody w rozłożeniu pracy, jednak zwracam uwagę na czasy odzyskiwania i budżet pamięci. Jeśli dziennik rośnie co sekundę w kierunku limitu, rozsądne zwiększenie pojemności zmniejsza presję i wygładza krzywą opróżniania. Jeśli zwiększenie rozmiaru nie przynosi ulgi, problem leży zazwyczaj w nieodpowiedniej przepustowości wejścia/wyjścia (I/O) lub zmiennym opóźnieniu pamięci masowej. Decyzję o ponownym zwiększeniu rozmiaru dziennika podejmuję dopiero po przeanalizowaniu okien obserwacyjnych, a nie na podstawie pojedynczych chwilowych odczytów.
Page Cleaner, wątki i równoległość
Sprawdzam liczbę wątków programu Page Cleaner, ponieważ odzwierciedlają one równoległą Spłukiwanie-Kontrola wydajności instancji puli buforów. Przy dużym obciążeniu zapisem dodatkowa równoległość zapewnia większą przepustowość, jednak uważnie monitoruję kolejkę pamięci masowej. Jeśli nośnik danych traci na wydajności z powodu przepełnionych kolejek, zmniejszam liczbę wątków lub ograniczam przepustowość operacji wejścia/wyjścia. Aby lepiej zrozumieć ten mechanizm, pomocny jest dla mnie przegląd Wątki dotyczące narzędzia Page Cleaner, abym mógł zachować równowagę między presją a sprawiedliwością. Podejmuję decyzje w sposób pragmatyczny: tyle wątków, ile trzeba, a jednocześnie tak mało, jak to możliwe, żeby czytelnicy nie zostali w tyle.
Bufor Doublewrite: bezpieczeństwo a szybkość zapisu
Biorę pod uwagę Doublewrite-Bufor, ponieważ chroni przed częściowymi błędami zapisu, ale wiąże się z dodatkowymi operacjami wejścia/wyjścia. W niezawodnych systemach NVMe ten dodatkowy nakład ma mniejsze znaczenie, natomiast w przypadku wolniejszych nośników jest bardziej odczuwalny. Zanim wprowadzę zmiany w tym zakresie, mierzę rzeczywisty wpływ na opóźnienia i szybkość opróżniania stron (page-flush-rate). Aby dokonać rzetelnej oceny, korzystam z bardziej szczegółowych wskazówek dotyczących Bufor podwójnego zapisu i sprawdzam, czy inny profil ryzyka i zwrotu będzie odpowiedni. Nigdy nie podejmuję decyzji pochopnie, ponieważ bezpieczeństwo danych i przepustowość są tu ze sobą bezpośrednio powiązane.
Monitorowanie i wskaźniki w praktyce
Oceniam udział „brudnych stron”, stosunek wskaźnika flush do wskaźnika zmian oraz przebieg Punkt kontrolny-Age. Dodatkowo obserwuję procentowe obciążenie dziennika Redo w czasie, ponieważ liniowy wzrost wskazuje na zbliżanie się do krytycznych wartości progowych. Śledzę opóźnienia we/wy obok statystyk InnoDB, aby móc precyzyjnie przyporządkować przyczyny i skutki. Po każdej zmianie parametrów porównuję identyczne okna obciążenia, w przeciwnym razie wyciągnąłbym błędne wnioski. Dokumentuję wykresy, ponieważ obraz mówi więcej niż pojedynczy punkt pomiarowy i dzięki temu mogę pewnie rozpoznać załamania trendów.
Plan strojenia krok po kroku
Zacznę od realistycznej oceny Współczynnik zapisu i na tej podstawie ustalam wartość innodb_io_capacity. Następnie definiuję innodb_io_capacity_max jako rozwiązanie awaryjne na wypadek sytuacji kryzysowych, z wystarczającym marginesem w stosunku do wartości bazowej. Następnie sprawdzam parametr innodb_adaptive_flushing_lwm i zmniejszam jego wartość, jeśli czas życia punktu kontrolnego (Checkpoint-Age) jest zbyt długi. Potem ustawiam parametr innodb_max_dirty_pages_pct_lwm tak, aby preflushing rozpoczynał się w odpowiednim czasie, a szczyty obciążenia były szybko redukowane. Na koniec dostosowuję rozmiar dziennika redo, ponownie obserwuję kilka cykli obciążenia i dokumentuję każdą zmianę, zanim podejmę kolejny krok.
Mechanizm spłukujący pod pokrywą
Rozróżniam dwa główne czynniki motywujące do pisania: Opróżnianie listy Flush (wynikające z postępów w Checkpoint) oraz Płukanie LRU (spowodowane brakiem wolnych stron). Gdy pula buforów się zapełni i zabraknie wolnych stron, operacja LRU-Flushing zmusza mnie do natychmiastowego zapisu, co powoduje skoki opóźnień. Adaptacyjne opróżnianie ma na celu uniknięcie takich sytuacji poprzez ciągłe opróżnianie listy flush. Aby to się udało, utrzymuję stały odsetek wolnych stron i monitoruję takie wartości, jak głębokość skanowania LRU oraz obciążenie poszczególnych instancji puli buforów. Im bardziej równomiernie przetwarzana jest lista flush, tym rzadziej muszę czekać na wolne strony w tle.
Zwracam przy tym uwagę na związek między innodb_buffer_pool_instances, innodb_page_cleaners oraz fizycznej przepustowości wejścia/wyjścia. Większa liczba instancji i wątków czyszczących zwiększa równoległość, ale tylko w takim zakresie, w jakim nie dochodzi do przepełnienia kolejek pamięci masowej. Jeśli operacje flushowania osiągają duże długości kolejek, jest to znak, że należało przeprowadzić flushowanie wcześniej i wolniej – właśnie tym zajmuję się za pomocą parametru innodb_adaptive_flushing_lwm oraz wartości bazowych i maksymalnych pojemności.
Potwierdzenie transakcji, redo i dziennik binarny w kontekście
Analizuję ścieżki commitów i gwarancje trwałości w kontekście wygładzania operacji flush. innodb_flush_log_at_trx_commit a synchronizacja binlogu wpływa na częstotliwość wykonywania operacji fsync przez system oraz na intensywność krótkotrwałych skoków obciążenia. Moje wytyczne:
- 1: Maksymalna trwałość (ponowne zapisywanie na nośniku przy każdym commitcie). Bezpieczne, ale wymaga częstego stosowania fsync i może powodować większe opóźnienia.
- 2: Redo jest opróżniane co sekundę, a Commit zapisuje dane wyłącznie w pamięci podręcznej systemu operacyjnego. Szczyty obciążenia są mniejsze, ale w zamian narażam się na utratę danych w przypadku awarii systemu operacyjnego lub hosta.
- 0: Podobnie jak w przypadku 2, jednak buforowanie jest jeszcze bardziej agresywne. W systemach produkcyjnych należy stosować z rozwagą.
W połączeniu z synchronizacją Binlog (sync_binlog) oraz dzięki efektom Group Commit mogę grupować zatwierdzenia i zmniejszyć liczbę twardych synchronizacji. Ważne jest, aby nie nadużywać tych narzędzi jako substytutu prawidłowego dostrajania adaptacyjnego opróżniania bufora. Zawsze wspólnie oceniam ryzyko, wymagania dotyczące zgodności oraz pożądany profil opóźnień i dostosowuję ustawienia tylko w takim zakresie, w jakim pozwalają na to zasady biznesowe.
Wątki do usunięcia, długość historii i długotrwałe wątki
Mam tę InnoDB-Purge Warto zwrócić uwagę: duża liczba usuniętych lub zaktualizowanych wierszy generuje dane operacji cofania, które są czyszczone asynchronicznie. Jeśli liczba Długość historii W miarę wzrostu obciążenia w tle wzrasta zużycie zasobów i dochodzi do rywalizacji o operacje wejścia/wyjścia z modułami czyszczącymi strony. Może to pośrednio spowolnić działanie funkcji Adaptive Flushing. Środkami zaradczymi są odpowiednie ustawienie wartości równoległości czyszczenia oraz unikanie długotrwałych transakcji, które sztucznie utrzymują historię w stanie otwartym. Ponadto planuję operacje wsadowe w taki sposób, aby kontrolować ilość operacji „redo” i „undo”, zamiast zmieniać miliony wierszy partiami w krótkim czasie.
Bufor zmian i fazy scalania
Biorę pod uwagę Zmień bufor podczas intensywnych aktualizacji indeksów drugorzędnych. Zmniejsza on liczbę operacji losowego wejścia/wyjścia w czasie wykonywania, jednak przenosi część pracy na późniejsze fazy scalania. Scalanie to może generować dodatkowe obciążenie związane z operacjami flush, jeśli zbiega się ono w niekorzystnym momencie z szczytami obciążenia produkcyjnego. W związku z tym monitoruję rozmiar i aktywność bufora zmian, w razie potrzeby ograniczam jego rozmiar i rozkładam zmiany zbiorcze w taki sposób, aby fazy scalania nie kolidowały z godzinami szczytu. Dzięki temu częstotliwość operacji flush jest bardziej przewidywalna i równomierna.
Metody czyszczenia pamięci i wpływ systemu plików
Świadomie podejmuję decyzję w sprawie Metoda Flush oraz opcje systemu plików. Opcja O_DIRECT pozwala uniknąć podwójnego buforowania, co często zmniejsza opóźnienia zapisu, podczas gdy ścieżki AIO i Fsync mają swoje własne cechy charakterystyczne. Mierzę, jak te metody wpływają na rozkład opóźnień oraz stabilność postępu tworzenia punktów kontrolnych, a w przypadku szczegółowych pytań odsyłam do wskazówek dotyczących Metody flush. Dodatkowo sprawdzam opcje montowania systemów plików oraz procedury konserwacyjne (np. spójne strategie TRIM/Discard w przypadku dysków SSD), aby infrastruktura nie powodowała niezauważalnych wahań.
Diagnoza: prawidłowe odczytywanie komunikatów o stanie
Wyprowadzam się POKAŻ STATUS SILNIKA INNODB w celu oceny wieku punktu kontrolnego i postępu operacji flush. Z Numer sekwencji dziennika, Dziennik wyczyszczono do oraz Ostatni punkt kontrolny o godz. Sprawdzam, jak duża jest różnica między wygenerowanymi a zapisanymi zmianami. Jeśli różnica ta stale rośnie szybciej, niż pozwala na to rozmiar dziennika redo, oznacza to, że moje operacje flush w tle są zbyt powolne lub opóźnienie wejścia/wyjścia jest zbyt duże. Porównuję te wartości z metrykami InnoDB dotyczącymi brudnych stron, częstotliwości opróżniania (Flush-Rate) oraz aktywności modułu czyszczenia stron (Page Cleaner), aby celowo dostosowywać odpowiednie parametry, zamiast leczyć objawy.
Scenariusze operacyjne: operacje masowe, DDL i okna serwisowe
Planuję Ładunki masowe oraz obszerne DDL-operacje w taki sposób, aby nie zakłócić działania funkcji Adaptive Flushing. W przypadku planowanych okien konserwacyjnych tymczasowo zwiększam innodb_io_capacity_max, aby w kontrolowany sposób zrealizować oczekujące operacje zapisu, a następnie ponownie obniżam go do normalnego poziomu. W przypadku dużych importów dostosowuję częstotliwość commitów, tak aby tempo wzrostu redo logu i postęp tworzenia punktów kontrolnych były zsynchronizowane. W międzyczasie stale monitoruję poziom zapełnienia dziennika Redo, wskaźnik brudnych stron oraz percentyle opóźnień, aby w razie odchyleń móc natychmiast podjąć odpowiednie działania korygujące.
Częste błędne przekonania i antywzorce
Nie dam się złapać w pułapkę, innodb_io_capacity_max wykorzystywać to jako stan stały. Zbyt wysoka wartość Max może przeciążyć kolejki pamięci i spowolnić operacje odczytu w czasie rzeczywistym. Nie „ukrywam“ też słabej pamięci za ogromnym dziennikiem Redo – większe dzienniki wygładzają obciążenie, ale nie tworzą rezerw operacji we/wy. Nie akceptuję też szczytów opóźnień jako nieuniknionych: często są one wynikiem zbyt późnego preflushingu lub silnie wahającego się obciążenia w tle, które mogę złagodzić poprzez niższe progi LWM i realistyczne wartości pojemności. Wreszcie unikam jednoczesnej zmiany wielu parametrów; w przeciwnym razie tracę związek przyczynowo-skutkowy i nie jestem w stanie odtworzyć uzyskanych ulepszeń.
Krótkie podsumowanie
Używam Adaptacyjne Flushing, aby równomiernie rozłożyć operacje zapisu w czasie i tym samym uniknąć skoków opóźnień. Największy wpływ ma precyzyjne ustawienie parametru innodb_io_capacity oraz rozsądny stosunek do wartości innodb_io_capacity_max. Wcześnie uruchamiane progi dla poziomu zapełnienia dziennika redo oraz wskaźnika brudnych stron pomagają mi utrzymać kolejki na niskim poziomie. Dzięki odpowiednim dziennikom redo, rozsądnej równoległości wątków czyszczących strony oraz czujnemu monitorowaniu udaje mi się zapewnić bardziej niezawodne procedury zapisu. Zgodnie z dokumentacją MariaDB dotyczącą zmiennych systemowych i opróżniania stron (page flushing) te parametry działają wspólnie – dostosowuję je stopniowo i obserwuję ich wpływ, aż system zacznie działać stabilnie i zgodnie z planem.


