 Przejdź do treści

Pokażę, jak Przesunięcie w Redis celowo czytam, analizuję i dbam o wysoką jakość danychSpójność korzystam. W ten sposób wcześnie wykrywam luki w replikacji, oceniam ryzyko związane z przełączeniem awaryjnym oraz niezawodnie synchronizuję klastry produkcyjne.
Punkty centralne
Poniższe kluczowe stwierdzenia stanowią konkretne wprowadzenie do tematu, terminologii i praktycznego zastosowania.
- Przesunięcie mierzy postęp strumienia replikacji bajt po bajcie.
- Lag jest to różnica między wartościami master_repl_offset i slave_repl_offset.
- ID+przesunięcie oznacza konkretną wersję danych przeznaczoną do częściowych synchronizacji.
- zaległości chroni przed pełną synchronizacją w przypadku krótkich przerw w połączeniu.
- Monitoring za pomocą INFO/wskaźników klastrów steruje systemem alarmowania i przełączaniem awaryjnym.
Co oznacza offset replikacji w Redis?
Przesunięcie replikacji to ciągły licznik 64-bitowy, który dla każdego przesłanego Prąd bajtowy między serwerem głównym a repliką. Na tej podstawie mogę sprawdzić, na jakim etapie znajduje się replikacja i czy replika ma jeszcze coś do zrobienia. Ten master_repl_offset Na serwerze głównym wartość ta rośnie wraz z każdym nowo wygenerowanym bajtem, podczas gdy replika zwiększa swój własny licznik zaraz po zastosowaniu poleceń. Różnice te powodują opóźnienie wyrażone w bajtach i wskazują, czy replika pozostaje w tyle. Ta prosta, ale skuteczna semantyka sprawia, że przesunięcie staje się kluczową wartością dla synchronizacji, analizy awarii i podejmowania trafnych decyzji dotyczących przełączania awaryjnego.
Odczytywanie offsetów: jak prawidłowo korzystać z funkcji INFO replication
Diagnozę prawie zawsze rozpoczynam od INFO replikacja, ponieważ polecenie to w zwięzły sposób podaje odpowiednie pola. Na serwerze głównym sprawdzam wartość master_repl_offset oraz status połączonych replik wraz z ich przesunięciami. Na serwerze replikacyjnym sprawdzam dodatkowo master_link_status oraz stany synchronizacji, aby wykryć trwające pełne synchronizacje lub synchronizacje częściowe. W celu przeprowadzenia bardziej szczegółowej analizy korzystam z ustrukturyzowanych wyników i koreluję przesunięcia z wartościami procesora, operacji wejścia/wyjścia oraz sieci. Gruntowne wprowadzenie do tego polecenia zapewnia mi niniejszy przewodnik: Redis INFO do monitorowania.
Identyfikator replikacji + przesunięcie: unikalna wersja danych
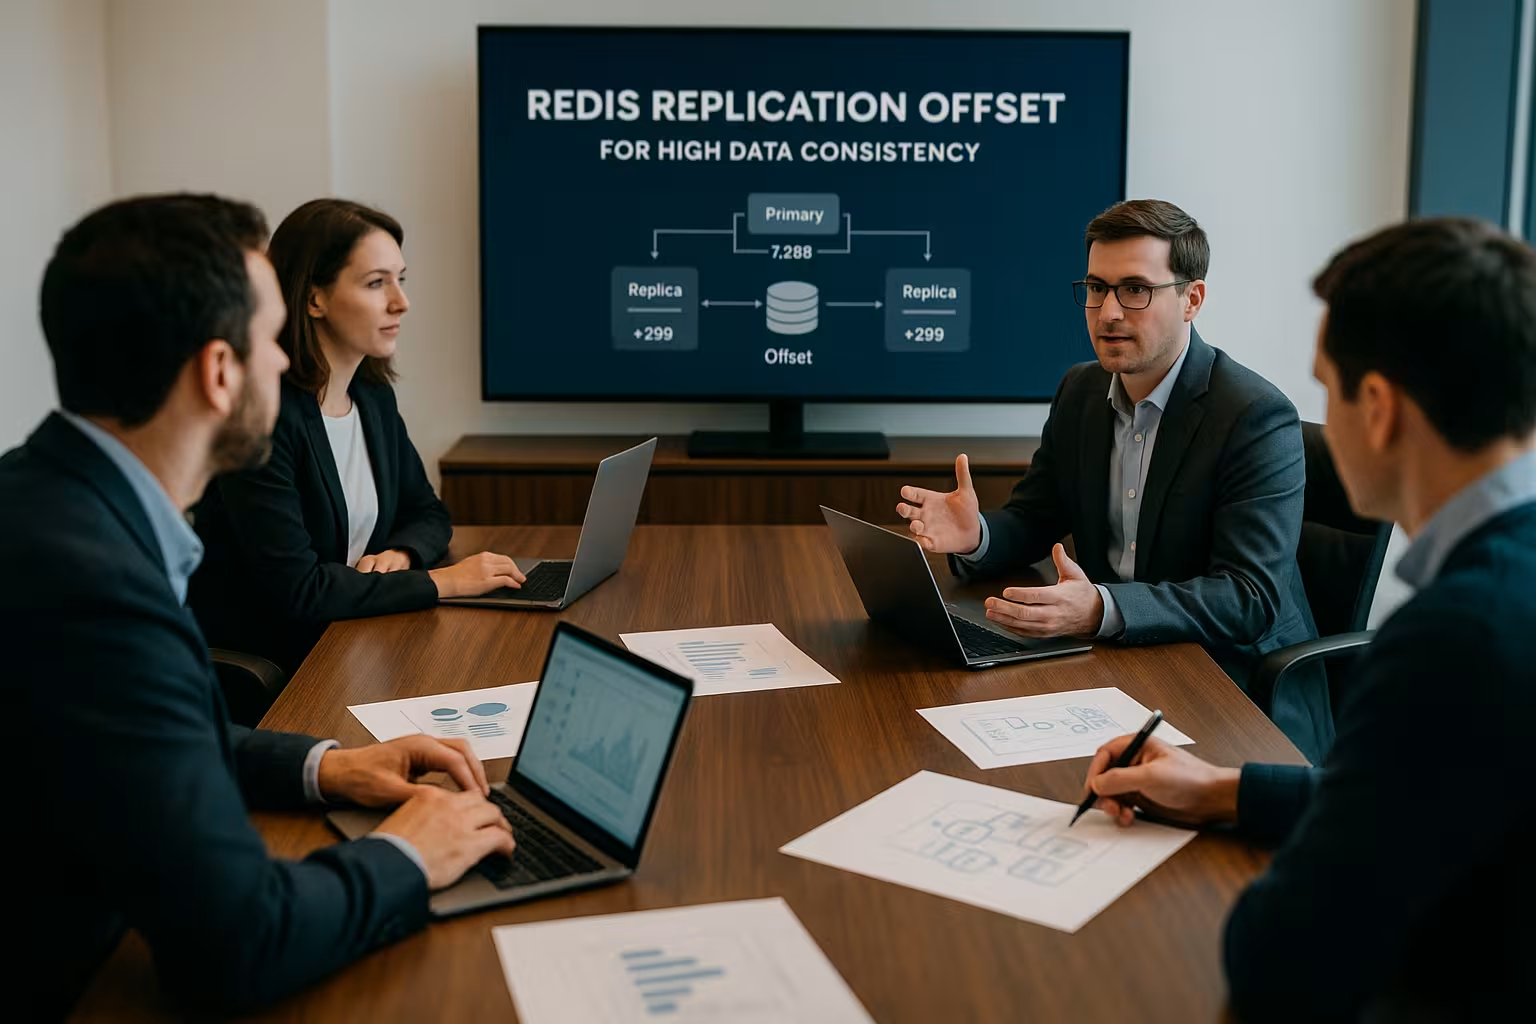
Aby uzyskać jednoznaczną wersję, stosuję kombinację Replikacja ID i offset. ID określa historię, a offset – pozycję w tej historii. Jeśli ID i offset są zgodne dla dwóch instancji, zakładam, że obie mają ten sam stan danych. Ta kombinacja umożliwia częściową resynchronizację, ponieważ replika może dokładnie poinformować serwer główny, w którym miejscu ostatnio się znajdowała. Na tej podstawie rozpoznaję również, czy przełączenie awaryjne przebiegnie bez rozbieżności danych, czy też konieczna będzie pełna synchronizacja.
Określenie wielkości zaległości w replikacji i luki
Primary utrzymuje jeden zaległości jako bufor pierścieniowy, który przechowuje najnowsze operacje zapisu i umożliwia częściową synchronizację. Jeśli bufor jest zbyt mały, podczas szczytów obciążenia bajty szybciej z niego wypadają, a replika, która na krótko straciła połączenie, nie zdąży wykonać częściowej resynchronizacji. Wybieram rozmiar w zależności od profilu zapisu i celów RPO, aby krótkie przerwy w połączeniu nie powodowały kosztownych pełnych synchronizacji. Jako ogólną wytyczną wybieram rozmiar, który buforuje co najmniej przewidywaną ilość danych z okresu od kilku sekund do kilku minut. W ten sposób zmniejszam lukę między serwerem głównym a repliką i zapewniam sprawne ponowne połączenie.
Dokładne określenie wielkości zaległości
W praktyce wielkość zaległości nie jest ustalana wyłącznie na podstawie intuicji, ale na podstawie faktycznie obserwowanego strumienia bajtów:
- Określam Przepustowość w bajtach/s, mierząc wzrost wartości master_repl_offset w określonych odstępach czasu (np. 10–60 s) i odnotowując wartości szczytowe.
- Definiuję dopuszczalny czas trwania przerwy (np. okna serwisowe, awarie sieciowe) w sekundach.
- Mnożę wartość szczytową w bajtach na sekundę przez czas trwania przerwy i dodaję Współczynnik bezpieczeństwa (1,5–3×) dodać.
Przykład: 80 MB/s szczytowe, 20 s przewidywanej przerwy, współczynnik 2 → 80×20×2 = 3 200 MB zaległości. W ten sposób zapewniam, że nawet przy niekorzystnym zgraniu w czasie uda się przeprowadzić częściową synchronizację. Następnie sprawdzam w systemie monitorowania, czy zaległość rzadko osiąga granicę swojej pojemności; jeśli tak się dzieje, stopniowo ją zwiększam.
Optymalizacja częstotliwości, wielkości partii i sieci
Oprócz zaległości biorę pod uwagę również hz-Ustawienie to, ponieważ wpływa na wewnętrzne cykle konserwacyjne, a tym samym na średnie opóźnienie. Dodatkowo sprawdzam rozmiary partii zapisu, wykorzystanie potoku oraz parametry TCP, aby zapewnić płynniejszy przepływ replikacji. Niskie opóźnienie między serwerem głównym a repliką bezpośrednio przekłada się na mniejsze różnice w przesunięciu. Wąskie gardła po stronie repliki, takie jak wolne nośniki danych lub niewystarczająca moc procesora, również zwiększają opóźnienie. Dlatego zmieniam zawsze tylko jeden czynnik, mierzę wpływ na różnicę offsetu i jasno dokumentuję ten efekt.
Synchronizacja bez dysku i wpływ migawek na przesunięcie
W przypadku pełnej synchronizacji najchętniej korzystam z synchronizacja bez dysku, ponieważ serwer Primary dostarcza wówczas strumień RDB bezpośrednio przez sieć i nie generuje dodatkowego obciążenia zapisu na lokalnych nośnikach danych. Zmniejsza to szczytowe obciążenia we/wy i stabilizuje przesunięcia podczas faz podłączania i odłączania. Umiarkowane opóźnienie (repl-diskless-sync-delay) daje innym replikom czas na dołączenie się, dzięki czemu strumień RDB jest wykorzystywany wielokrotnie. Obserwuję przy tym obciążenie procesora i sieci, ponieważ nawet transfer bez dostępu do dysku może przy bardzo dużych ilościach danych powodować krótkotrwałe opóźnienia.
Snapshoty (RDB) powodują podczas tworzenia rozgałęzienia kopię typu „copy-on-write”. W systemach o intensywnym zapisie powoduje to tymczasowy wzrost zapotrzebowania na pamięć i może wpłynąć na Współczynnik stosowania spowolnić działanie repliki. Dlatego też planuję tworzenie migawek na spokojniejsze pory dnia, sprawdzam rezerwy pamięci i dbam o to, by ścieżki replikacji i AOF nie kolidowały ze sobą.
Częściowa resynchronizacja w praktyce
Jeśli replika na chwilę przestaje działać, zawsze najpierw próbuję Porównanie częściowe osiągnąć. Podczas ponownego łączenia replika zgłasza identyfikator replikacji (Replication ID) oraz ostatni offset, po czym serwer główny (Primary) dostarcza brakujące bajty z zaległości. Jeśli zaległości są niewystarczające lub identyfikator uległ zmianie, uruchamia się pełna synchronizacja z transferem RDB i fazą nadrabiania zaległości. W tym momencie obserwuję przesunięcia, aby sprawdzić, jak szybko replika nadrabia zaległości i od kiedy oba liczniki znów znajdują się blisko siebie. Jeśli częściowa synchronizacja zakończy się powodzeniem, opóźnienia i szczyty operacji wejścia/wyjścia pozostają znacznie mniejsze.
Identyfikatory replikacji, PSYNC2 i zachowanie przy resetowaniu
Aby zapewnić poprawne interpretacje, polegam na semantyce PSYNC2. Sygnał Primary zawiera aktualną Identyfikator replikacji oraz dodatkowo identyfikator historii wraz z odpowiadającym mu przesunięciem. W przypadku Ponowne uruchomienia lub zmiany na stanowiskach kierowniczych zmienia się identyfikator pierwotny; stary identyfikator pozostaje zachowany w historii wraz z końcowym przesunięciem. Dzięki temu replika może nadal nadrabiać zaległości poprzez synchronizację częściową pomimo zmiany identyfikatora, o ile wymagany zakres znajduje się w zaległościach. Analizuję w INFO replikacja Dlatego analizuję oba identyfikatory wraz z przesunięciami i w ten sposób rozpoznaję, czy zmiana identyfikatora właśnie miała miejsce, czy też ma nastąpić.
Ważne jest to, że przesunięcie wynosi monotonicznie według historii, ale zmiana identyfikatora definiuje nową linię czasową. Dokumentuję tę zmianę podczas pracy, aby analizy trendów prawidłowo uwzględniły ten skok. Przesunięcie 64-bitowe praktycznie nigdy nie przekracza granicy; znacznie większe znaczenie mają ponowne uruchomienia, przełączenia awaryjne lub połączenia z zaległościami, które wpływają na historię.
Potwierdzenia klienta i okres ważności w kontekście offsetu
Pokaż przesunięcia Postęp, ale nie udzielam żadnych gwarancji dotyczących trwałości. Jeśli potrzebuję potwierdzeń dotyczących replik, korzystam dodatkowo z:
- WAIT: Serwer główny potwierdza, gdy N replik odbierze polecenie zapisu i zapisze je w swoich buforach wejściowych. Jest to szybsze niż zabezpieczenie typu „full sync”, ale nie gwarantuje trwałości danych na nośnikach.
- min-replik-do-zapisania oraz min-replicas-max-lag: Serwer główny akceptuje operacje zapisu tylko wtedy, gdy podłączonych jest wystarczająco dużo replik znajdujących się wystarczająco blisko, a ich opóźnienie nie przekracza określonego progu. Zmniejsza to ryzyko wystąpienia zjawiska „split-brain”.
Wykorzystuję te mechanizmy w połączeniu z offsetem: offset sprawdza rzeczywista Prędkość nadrabiania zaległości i długoterminowe trendy w przypadku replik WAIT/min na polecenie Zapewniają ochronę. W przypadku rygorystycznych RPO łączę je i rejestruję oba widoki w systemie monitorowania.
Powiadomienia i wskaźniki w stosie monitorowania
W celu monitorowania ustalam jasne Wartości progowe na podstawie różnicy offsetu w bajtach. Łączę ten wskaźnik z szeregami czasowymi z Prometheusa/Grafany i uruchamiam alarmy, gdy różnica przekroczy zdefiniowany czas trwania. Ponadto rejestruję trendy, aby wykrywać szczyty obciążenia i planować działania zaradcze. Pulpity nawigacyjne wizualizują master_repl_offset, przesunięcia replik oraz obliczone opóźnienie, co znacznie przyspiesza analizę danych w trakcie pracy. Praktyczne wskazówki dotyczące konfiguracji z wykorzystaniem szeregów czasowych znajduję tutaj: Monitorowanie Redis za pomocą Prometheusa i Grafany.
Podręczniki postępowania i ścieżki eskalacji
Przedstawiam ustandaryzowane kroki, które pozwolą zespołom podejmować ukierunkowane działania w przypadku wzrostu opóźnienia:
- Ostrzeżenie: Obciążenie > X MB przez > Y s → Sprawdzić przepustowość i opóźnienie połączenia replikacyjnego, zidentyfikować konkurencyjne zadania (migawki, duże skrypty Lua).
- Major: Obciążenie stale rośnie → należy sprawdzić korelację między zaległościami w przetwarzaniu, obciążeniem procesora i wejścia/wyjścia repliki oraz błędami sieciowymi (ponowne transmisje, utraty pakietów); w razie potrzeby ograniczyć obciążenie zapisem.
- Krytyczny: Istnieje ryzyko przepełnienia kolejki zadań → należy odciążyć replikę (np. tymczasowo przekierować obciążenie odczytowe), zaplanować okno pełnej synchronizacji lub uruchomić dodatkową replikę.
Dokumentuję drzewa decyzyjne, aby było jasne, kiedy przełączenie awaryjne wiąże się jeszcze z niewielkim ryzykiem, a kiedy powinienem poczekać, aż różnica offsetowa się wyrówna.
Klaster Redis: ocena offsetów dla poszczególnych fragmentów
W klastrze sprawdzam przesunięcia na każdy shard, ponieważ każdy fragment prowadzi własny strumień replikacji. Polecenie CLUSTER SHARDS dostarcza mi zakresy slotów, role węzłów oraz odpowiednie przesunięcia dla instancji głównej i repliki. Duże różnice w obrębie jednego fragmentu wskazują na ryzyko związane z uporządkowanym przełączeniem awaryjnym tego fragmentu. Dlatego systematycznie porównuję przesunięcia wszystkich fragmentów i traktuję węzły o minimalnym opóźnieniu jako priorytetowych kandydatów do pełnienia roli wiodącej. W ten sposób zapewniam spójność całościowego obrazu i zapobiegam niespodziankom podczas przełączania.
Codzienne funkcjonowanie klastra: monitorowanie procesu reshardingu i migracji slotów
Na stronie Przesunięcia gniazd obciążenie zapisem często rośnie nierównomiernie. Mierzę przesunięcia dla poszczególnych fragmentów podczas faz MIGRATE, aby sprawdzić, czy poszczególne repliki pozostają w tyle. Szczególnie delikatną kwestią są dłuższe okna migracji w połączeniu z niewielkimi zaległościami: W takich przypadkach planuję albo większe zaległości, albo rozkładam migracje, aby nie utracić częściowych synchronizacji. Przed każdym przełączeniem awaryjnym fragmentu oceniam, czy węzeł docelowy przejął ostatnio obciążenie slotu i czy jego przesunięcie repliki pozostaje stabilne.
Przykłady zastosowań: celowa interpretacja offsetu
Aby ocenić opóźnienie replikacji, systematycznie porównuję magister_repl_offset z każdym offsetem repliki i na tej podstawie określam wiek potencjalnie nieaktualnych danych. Przed planowanym przełączeniem oceniam ryzyko awarii, identyfikując najbliższą replikę i potwierdzając jej spójność w ciągu kilku minut. Jeśli opóźnienie wielokrotnie wzrasta, koreluję je z metrykami sieciowymi, obciążeniem procesora i operacjami wejścia/wyjścia, aby zidentyfikować wąskie gardła i celowo je usunąć. W przypadku rygorystycznych celów dotyczących trwałości danych sprawdzam również, czy operacje zostały potwierdzone w pliku AOF oraz jak zachowują się w tym kontekście przesunięcia. Te wzorce pomagają mi opierać decyzje na obiektywnych danych liczbowych i ograniczać przestoje do minimum.
Replikacja kaskadowa i układy geograficzne
W konfiguracjach rozproszonych często wybieram Naszyjniki Replica (Replica-of-Replica), aby odciążyć ruch międzysieciowy. Zwracam przy tym uwagę, że przesunięcie obowiązuje osobno dla każdej krawędzi i WAIT – tylko bezpośrednio połączone repliki liczy się. W przypadku replikacji geograficznej ustalam realistyczne limity opóźnień i mierzę przesunięcia oddzielnie dla każdego regionu. Planowane przełączenie awaryjne na inny region jest uzasadnione dopiero wtedy, gdy najbliższy kandydat do przejęcia obciążenia wykazuje minimalną lukę przez dłuższy czas, a ścieżki sieciowe są stabilne. W przypadku dużych odległości ograniczam zapisy w trybie burst, umiarkowanie korzystam z potokowania i zwiększam zaległości w węzłach o największym RTT.
Praktyczne wykorzystanie w środowiskach hostingowych
W środowisku zarządzanym stawiam na jasne Pulpity nawigacyjne, które łączą przesunięcia, opóźnienia i stany zdrowia. Zespoły, które chcą przyspieszyć proces diagnostyki, powinny zwrócić uwagę na narzędzia zapewniające dogłębny wgląd w Redis i przejrzystą wizualizację. Dzięki temu mogę wcześnie wykrywać narastające przesunięcia i podejmować działania zaradcze, zanim zaległości się skumulują lub pełne synchronizacje spowodują szczyty obciążenia. Ponadto przeprowadzam testy przełączania awaryjnego w środowiskach testowych i mierzę, jak szybko przesunięcia zbliżają się do siebie po przełączeniu. Praktyczne wprowadzenie do analizy graficznej zapewnia mi ten przewodnik: Redis Insight do celów diagnostycznych.
Wzorce rozwiązywania problemów w przypadku rosnącego opóźnienia
Gdy różnica offsetowa rośnie, postępuję zgodnie z powtarzającymi się schematami:
- Procesor Replica pracuje na pełnych obrotach: Wąskie gardła związane z jednoprzewodowym przetwarzaniem lub kosztowne skrypty Lua spowalniają przetwarzanie; weryfikuję to na podstawie szybkości przetwarzania i wygładzam skoki.
- Ciśnienie w zbiorniku lub ciśnienie we/wy: AOF-Rewrite, Snapshot lub hałaśliwi sąsiedzi zwiększają opóźnienie; przenoszę zadania, optymalizuję klasy pamięci masowej lub włączam synchronizację bezdyskową.
- Ścieżka sieciowa ulega zmianom: Retransmisje, utraty pakietów lub niezgodności MTU; sprawdzam błędy interfejsów, rozmiary buforów i ograniczam utratę pakietów.
- Bufor wyjściowy repliki: Jeśli limit replik zostanie ustawiony na zbyt małą wartość, serwer główny przerywa połączenie; ustawiam limit bufora wyjściowego klienta do replik dostosowanych do obciążenia.
- Obciążenie związane z protokołem TLS: Na słabym procesorze szyfrowanie może obniżać wydajność; mierzę koszty kryptograficzne i skaluję liczbę rdzeni lub odciążam system dzięki przyspieszeniu sprzętowemu.
- Narzędzia diagnostyczne powodujące skutki uboczne: MONITOR lub zbyt intensywne rejestrowanie danych spowalnia działanie systemu; korzystam z takich narzędzi oszczędnie i tylko przez ograniczony czas.
Dbam o to, by te schematy były obecne w zespole, tak aby w razie pojawienia się sygnałów ostrzegawczych nie zaczynaliśmy szukać od nowa, lecz szybko weryfikowaliśmy i odrzucaliśmy hipotezy.
Przegląd w formie tabeli: kluczowe wskaźniki w skrócie
Chętnie przedstawiam poniższy przegląd podczas pracy, ponieważ zawiera on najważniejsze Kluczowe dane i skupia wszystkie działania w jednym miejscu.
| Sygnał | Znaczenie | Typowe źródło | Działanie/Interpretacja |
|---|---|---|---|
| master_repl_offset | Bajty wygenerowane przez serwer główny w strumieniu replikacji | INFO replikacja | Wartość bazowa do obliczenia opóźnienia, obserwacja przebiegu |
| slave_repl_offset | Bajty, które replika już zastosowała | INFO: replikacja, sekcja „Replika” | Odjąć od master_repl_offset, określić różnicę |
| Identyfikator replikacji | Oznaczniki historii/generacji danych | INFO replikacja | Połączyć z przesunięciem, sprawdzić częściowe wyrównanie |
| Wielkość zaległości | Bufor pierścieniowy dla najmniejszych próbek | Konfiguracja, INFO replikacja | Wybierz większy rozmiar w przypadku dużej liczby wydruków |
| przesunięcie replikacji (klaster) | Przesunięcia na fragment dla instancji głównej/repliki | FRAGMENTY KLASTRA | Ocena kandydatów na shardy pod kątem przełączenia |
Podsumowanie: Jak opanować efekt offsetu i uniknąć awarii
Ustawiłem Przesunięcie jako główny wskaźnik, aby skutecznie kontrolować spójność, częściowe synchronizacje i zachowanie podczas przełączania awaryjnego. Dzięki replikacji INFO, odpowiedniej wielkości zaległości i sprawnemu systemowi alertów utrzymuję ścisłą synchronizację replikowanych węzłów. W topologiach klastrowych oceniam przesunięcia dla każdego fragmentu i nadaję priorytet kandydatom o minimalnym opóźnieniu. Optymalizacja częstotliwości (hz), sieci i ścieżek pamięciowych dodatkowo zmniejsza opóźnienia i zapobiega kosztownym pełnym synchronizacjom. Kto konsekwentnie monitoruje przesunięcia, ten ogranicza przestoje i znacznie zwiększa niezawodność całego stosu Redis.


