 Saltar para o conteúdo

Vou mostrar como os administradores utilizam o CloudLinux MySQL Governor Analisar relatórios com segurança e tomar decisões claras com base em poucos indicadores. Ao concentrar-me na CPU, na leitura, na escrita e na conexão, consigo identificar rapidamente qual a conta que está a atingir o limite, qual é a causa e onde é possível otimizar ou ajustar o limite de forma específica.
Pontos centrais
Os seguintes aspetos fundamentais orientam a minha abordagem na leitura dos relatórios e ajudam a identificar rapidamente os pontos de estrangulamento e a resolvê-los de forma eficaz.
- Números-chave Interpretar corretamente: CPU, Read, Write e Conn indicam qual é o gargalo que está a causar o atraso.
- Contexto avaliar: o momento, a duração e a repetição, em vez de picos isolados.
- Modo A saber: os parâmetros «Abusers», «All», «Single» e «Off» alteram a interpretação.
- Causas Priorizar: aumentar a prioridade dos índices, consultas e ligações em detrimento dos limites.
- Fluxo de trabalho Aproveite: verifique em tempo real, analise o histórico e, depois, aja.
CloudLinux MySQL Governor: Função e efeitos
O Governor monitoriza, por utilizador, o Carga da base de dados e intervém antes que determinadas contas dominem o servidor. Consigo ver, por conta, a utilização da CPU, as E/S de leitura e escrita, bem como as ligações simultâneas, e percebo se foi ativada alguma limitação. É precisamente esta separação por utilizadores que torna a hospedagem partilhada previsível, porque os grandes consumidores apenas abrandam a sua própria conta. Para começar, memorizei simplesmente o mecanismo „Consultas → Medição → Limitação“. Quem compreender o princípio consegue definir limites com segurança e reduzir as escaladas. Esta visão geral fornece uma base prática para tal: Limitar a carga da base de dados, que explica a interação com a infraestrutura LVE e apresenta os principais parâmetros de ajuste. A ideia fundamental é: proteger toda a instância através de Limites ao nível do utilizador.
Indicadores no relatório: CPU, Leitura, Escrita, Conexão
Começo sempre pelos quatro valores fundamentais e avalio-os ao longo do tempo, e não isoladamente. Os CPUA coluna - mostra o impacto das consultas que exigem muitos recursos computacionais e se o Plancache ou o desenho da consulta requerem atenção. «Read» destaca as operações reais de leitura do disco; as leituras em cache não aparecem, o que evita interpretações erradas. «Write» revela cargas de trabalho com muitas gravações, como grandes importações, falta de lógica de processamento em lote ou tabelas temporárias desnecessárias. «Conn» revela se a aplicação abre demasiadas sessões em paralelo, por exemplo, devido a tarefas Cron ou à ausência de pooling de ligações. Só quando identifico padrões ao longo de minutos e horas é que tomo decisões relativas a limites, cache ou Índices.
Ler relatórios: seguir passo a passo
Primeiro, vou esclarecer qual é o Utilizador se for afetado, qual o valor-limite que o regulador acionou. Em tempo real, verifico com ferramentas como o dbtop se está a ocorrer alguma limitação e anoto a hora e a duração. Depois, comparo os valores históricos para distinguir picos de padrões recorrentes. Se o evento ocorrer diariamente a horas fixas, analiso as tarefas Cron, as importações ou as cópias de segurança. Se o Conn for acionado várias vezes, concentro-me no comportamento das sessões, nos tempos de espera e no pooling. Se a curva indicar principalmente CPU, analiso as consultas, as somas de verificação e as camadas de cache antes de definir limites levante.
Identificar com segurança padrões típicos no relatório
Picos curtos seguidos de normalização são comuns em campanhas, durante o aquecimento da cache ou em importações pontuais. Fases prolongadas de limitação, com duração de vários minutos, indicam limites demasiado restritivos de forma permanente ou ineficiência Consultas . Um padrão em ziguezague no Conn sugere uma paralelização agressiva ou tentativas de repetição com erros. Valores de escrita elevados e uniformes indicam frequentemente registo, sessões na base de dados ou ausência de processamento em lote. Proporções muito elevadas de leitura sem uma cobertura de índices adequada revelam varreduras completas da tabela. Para cada padrão, pergunto-me: o que é plausível do ponto de vista técnico e onde se encontram as alavancas concretas para Alívio?
Evitar erros frequentes na interpretação dos relatórios
Nunca me concentro apenas na utilização total do servidor, porque o Governor por Conta mede. Um servidor com baixo tráfego pode esconder utilizadores individuais com grande volume de tráfego que geram regularmente eventos de limite. Da mesma forma, questiono a prática de „simplesmente aumentar os limites“ como reação padrão. Por vezes, uma loja legítima precisa de mais margem de manobra, mas, muitas vezes, o trabalho nas consultas ou nos índices resolve o problema real. Sem uma análise das causas, os estrangulamentos apenas se deslocam, até que o próximo apareça. Quem interpreta os relatórios como instrumentos de diagnóstico toma melhores decisões, poupa tempo e estabiliza o Desempenho.
Classificar corretamente as unidades, os limiares e a amostragem
Antes de abordar os limites, procuro compreender bem quais são os valores representar: A CPU é um indicador de carga avaliado em relação ao orçamento computacional disponível de uma conta. As operações de leitura/gravação refletem o trabalho real de E/S, e não apenas acessos lógicos de leitura a partir das caches. O «Conn» mede as ligações ativas em simultâneo, e não a soma de todas as tentativas de ligação. Além disso, trabalho sempre com o Corte ao longo de um intervalo de tempo e coloco os valores pontuais em relação à evolução: picos curtos num intervalo denso têm um efeito diferente dos picos isolados e esporádicos. As janelas de amostragem e agregação influenciam a perspetiva – por isso, tenho em conta se estou a avaliar em tempo real, numa visão de 1 minuto ou de 5 minutos. Só tomo decisões quando os padrões se repetem ao longo de vários intervalos coerente são.
Estratégias concretas de valores-limite por métrica
Nunca ajusto os limites de forma generalizada, mas sim de forma diferenciada consoante o ponto de estrangulamento:
- CPU: Primeiro, identificar as consultas (registo de consultas lentas, EXPLAIN) e, em seguida, dar prioridade ao trabalho de planeamento e indexação. Só quando a carga de trabalho for legítima e estiver otimizada (por exemplo, uma promoção de vendas de curta duração) é que aumente moderadamente a utilização da CPU e verifique o efeito no dia seguinte.
- Ler: Procuro casos em que a cobertura do índice é insuficiente, instruções SELECT desnecessariamente extensas e padrões „N+1“. Só considero aumentar o limite de leituras se as consultas forem eficientes ou se for permitido, de forma deliberada, que as tarefas de relatório realizem mais leituras.
- Escrever: Reduzo a frequência de registos (registos, sessões na base de dados), agrupo transações e implemento o processamento em lotes. O aumento dos limites de gravação é o último passo – por exemplo, no caso de importações com prazos apertados e com um intervalo de tempo claramente definido.
- Conn: Implemento o pooling, limito as tentativas de reenvio com backoff e distribuo as janelas do cron. Só quando a aplicação gerir as ligações de forma adequada é que abro as ligações gradualmente.
Cada aumento é efetuado incremental e com um plano de contingência: documentar a alteração, verificar o seu efeito ao longo do processo e, em caso de efeitos secundários, revertê-la de forma sistemática.
Ajustar os valores-limite de forma específica e precisa
Só ajusto os limites quando a utilização for adequada do ponto de vista técnico e as otimizações tiverem sido esgotadas. Primeiro, identifico o estrangulamento dominante: CPU, Read, Write ou Conn. Depois, aumento apenas o valor em questão, em vez de aumentar tudo de forma generalizada. Ao nível do pacote ou do utilizador, isto pode ser controlado de forma clara no contexto do LVE. Quem utilizar a página do pacote encontrará no Gestor de LVE os controladores adequados e consegue manter os perfis de forma consistente. Desta forma, os mecanismos de proteção permanecem eficazes e as outras contas não ficam desnecessariamente sujeitas a Pressão.
Dois exemplos práticos
Caso 1: O Conn-Limit atinge repetidamente os seus limites. Ao vivo, vejo no dbtop muitas ligações de curta duração e novas tentativas. O histórico mostra um padrão em ziguezague sempre à hora certa. Causa: várias tarefas cron são iniciadas em paralelo e, cada uma, estabelece dezenas de ligações à base de dados. Medida: desacoplar as janelas cron, ativar o pooling, harmonizar os tempos limite. Resultado: o número de ligações estabiliza e, de passagem, a utilização da CPU diminui. Não é necessário aumentar o limite.
Caso 2: Fases de gravação intensas com longos períodos de limitação. Ao longo do dia, observam-se valores de escrita dominantes durante mais de uma hora, com a CPU a apresentar uma utilização moderada. A análise revela que um script de importação escreve linha a linha e efetua o commit após cada registo. Mudo para o processamento em lotes, reduzo o nível de detalhe do registo e agrupo os commits. Resultado: os picos de escrita transformam-se em platôs curtos, que permanecem dentro dos limites. Se necessário, autorizo uma janela de importação curta com um limite de escrita ligeiramente superior – documentada e delimitada no tempo.
Detetar anomalias específicas da aplicação
Muitos padrões têm uma Caligrafia Stacks comuns. Nos sistemas de gestão de conteúdos, encontro frequentemente SELECTs amplos e sem cache logo após a limpeza da cache – a leitura domina, seguida pela CPU. Nos sistemas de lojas online, observo, em picos de carga, JOINs dispendiosos em colunas com baixa seletividade; a CPU aumenta primeiro, seguida pela leitura. Os frameworks com processadores de fila geram, por vezes, padrões de conexão ondulatórios quando se iniciam picos de atividade dos trabalhadores. Por isso, atribuo sempre as curvas à pilha em questão: onde é que os caches entram em ação? O que é que está a correr no Cron? Como é que o sistema paraleliza? Este conhecimento encurta significativamente a análise das causas.
Parâmetros do MySQL/InnoDB em interação com o Governor
O Governor protege de forma justa, mas não substitui extremamente sólido Configuração do MySQL. Verifico, adicionalmente, parâmetros que agravam ou atenuam sintomas típicos: tamanho das tabelas temporárias (evita leituras/gravações desnecessárias no disco), níveis adequados de detalhe dos registos (reduz o ruído das gravações), limites bem definidos para ligações simultâneas do lado da aplicação. As estatísticas das tabelas e dos índices também têm de estar atualizadas; caso contrário, os planos de execução tornam-se mais dispendiosos do que o necessário. Para mim, a clareza é importante: os limites do governador são os guarda-corpos exteriores; dentro destes limites, o MySQL tem de funcionar de forma eficiente. Quando as alterações na configuração surtem efeito, o relatório melhora visivelmente – sem que eu tenha de alargar os limites.
Métricas, causas, medidas: resumo conciso
A tabela seguinte ajuda-me a formular hipóteses rapidamente e a testá-las de forma direcionada. Utilizo-a como guia antes de alterar qualquer configuração. Importante: confirmo cada suposição no histórico e na aplicação antes de definir limites mudança.
| Métricas | Causa típica | Verificação rápida | Medida específica |
|---|---|---|---|
| CPU | Juntas dispendiosas, falta de cache, ordenações de grande dimensão | Registo de consultas lentas, EXPLAIN, acerto na cache | Completar o índice, reescrever a consulta, ativar o cache |
| Ler | Varreduras completas de tabelas, cache vazio, relatórios extensos | Leituras do handler, EXPLAIN, cobertura de índices | Atualizar índices, restringir consultas às colunas |
| Escrever | Importações em massa, registo detalhado, tabelas temporárias | Innodb_status, tmp_table_size, frequência de commit | Agrupamento, verificação do nível de registo, agrupamento de transações |
| Conn | Demasiadas sessões paralelas, picos de cron | max_user_connections, lista de processos, tentativas de repetição | Utilizar o pooling, backoff, equilibrar as janelas do Cron |
A matriz não substitui a análise, mas fornece um ponto de partida claro. Quem analisa de forma estruturada poupa tempo e evita o método de tentativa e erro. Combino sempre a tabela com gráficos de evolução e conhecimentos práticos. Desta forma, interpreto os sinais técnicos de forma profissional e tomo decisões sólidas Decisões.
Compreender os modos de funcionamento do regulador
Os modos determinam quais as contas que são afetadas pela limitação e o grau de rigor com que o sistema atua. No modo „Abusers“, o regulador limita os utilizadores que se desviam das normas, enquanto o modo „All“ trata todos os utilizadores de acordo com parâmetros fixos. O modo „Single“ ajuda a testar de forma específica um Contas, „Off“ desativa temporariamente a limitação para fins de diagnóstico. Verifico o modo ativo antes de cada avaliação, porque este determina a forma como as curvas são interpretadas. Quem utiliza a opção „All“ deve definir claramente os limites dos pacotes, enquanto a opção „Abusers“ demonstra maior tolerância a picos de curta duração. Este contexto determina frequentemente se devo aumentar os limites ou analisar primeiro a aplicação otimizar.
Estabilidade, tempos limite e experiência do utilizador
A limitação não significa „avaria“, mas sim Proteção. No entanto, quando existem limites ativos, observo sempre o impacto nos tempos de resposta e nas taxas de erro. Se se acumularem timeouts ou novas tentativas, a carga tende frequentemente a aumentar ainda mais. Por isso, adoto uma abordagem dupla: simplifico as consultas e reduzo o paralelismo, ao mesmo tempo que avalio os pontos finais mais importantes da aplicação. Se uma função for afetada de forma crítica para o negócio, dou prioridade a um alívio temporário dos limites – acompanhado de medidas de otimização – em vez de transferir o estrangulamento para outras métricas.
Mais contexto através da monitorização e das verificações de estado
Os relatórios fornecem a visão da carga, enquanto a monitorização fornece o contexto. Integro métricas da Web e do PHP para ver como a cache, a fila e o Cron interagem com a base de dados. As verificações de integridade revelam pontos cegos, como partições cheias, falta de RAM para o buffer ou cópias de segurança que bloqueiam o sistema. Este guia oferece uma boa introdução a Interpretar as verificações de saúde, que descreve os percursos de teste típicos. No final, o que conta é a combinação entre o relatório, as métricas do sistema e o conhecimento da aplicação. É assim que tomo medidas sólidas e mantenho a Estabilidade elevado.
Automatização, alarmes e documentação
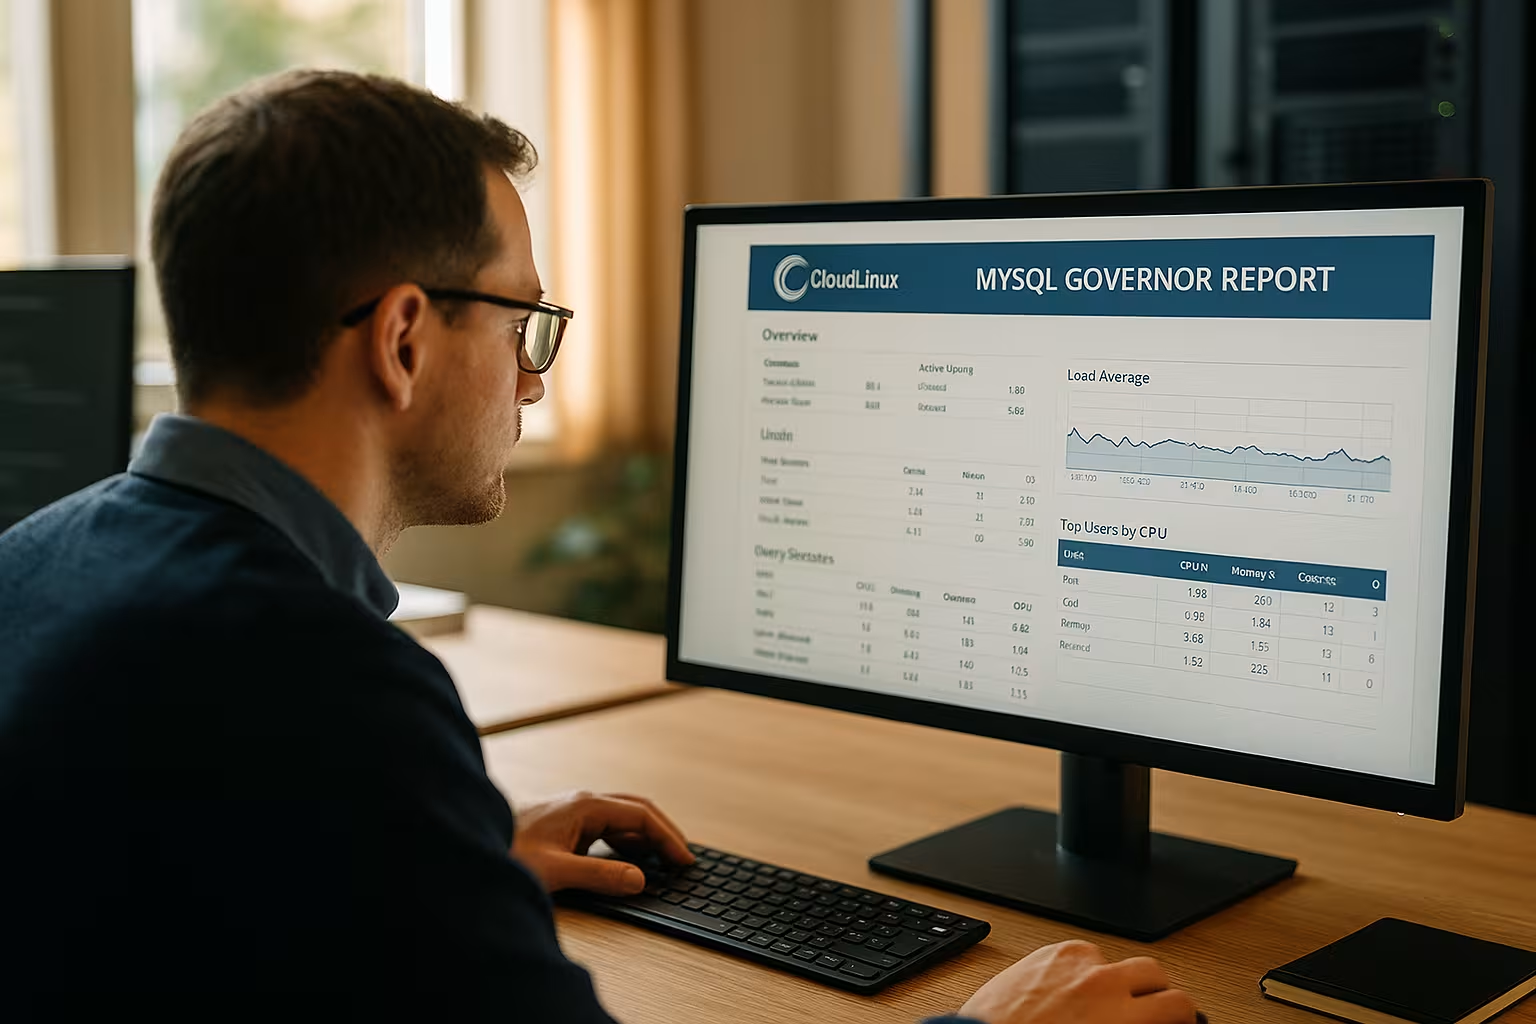
Eu defino claro Critérios de alarme ao longo das quatro métricas principais: ultrapassamentos repetidos dos limites ao longo de vários intervalos, platôs prolongados em vez de picos ou novos padrões que não ocorriam anteriormente. Os alarmes não desencadeiam processos automáticos para aumentar os limites, mas sim iniciam o meu fluxo de trabalho de análise. Documento as alterações com a data, o motivo, as métricas afetadas e o impacto esperado. Registo igualmente as medições de acompanhamento. Esta transparência cria consistência na equipa, facilita as escalações e evita que as soluções provisórias se tornem configurações permanentes e descontroladas.
Avaliação prática no dia-a-dia: o meu fluxo de trabalho rápido
Começo pela visualização em tempo real para identificar estrangulamentos agudos e registar os processos afetados. Depois, passo diretamente para o histórico, comparo os horários do dia e identifico padrões recorrentes Picos. No passo seguinte, atribuo cada pico a um fator desencadeante: promoção na loja, cópia de segurança, cron, importação, efeito de cache ou lançamento de código. Assim que a causa e a métrica estiverem associadas, defino a medida a tomar: trabalho no índice, reestruturação da consulta, redução do paralelismo, ativação do cache ou ajuste preciso do limite. Em seguida, verifico o impacto ao longo do dia seguinte e documento a alteração. Este ciclo é curto, poupa tickets de suporte e aumenta a Transparência.
Brevemente resumido
Leio os relatórios do MySQL Governor de forma sistemática, com foco no utilizador, e analiso padrões ao longo do tempo, em vez de sinais isolados. As quatro métricas principais levam-me diretamente ao ponto de estrangulamento e indicam por onde devo começar. Antes de aumentar os limites, trabalho em Índices, consultas, paralelismo e cache. O modo ativo determina o nível de rigor do sistema e influencia a interpretação. Com um fluxo de trabalho definido, que inclui verificação em tempo real, histórico, análise das causas e nova medição, resolvo os casos de forma fiável. Desta forma, estabilizo os ambientes, reduzo os esforços de suporte e faço uma distinção clara entre otimização, ajuste de limites e atualização de pacotes, sem afetar outras contas Carga para definir.


