 Saltar para o conteúdo

Vou mostrar-te como interpretar o vmstat no Linux de forma eficaz: conseguirás identificar gargalos da CPU, pressão na memória, swap e tempos de espera de E/S em poucos segundos. É assim que interpretas com segurança as colunas r, b, free, si/so, bi/bo e us/sy/id/wa/st e deduzes medidas concretas a partir dos padrões observados – sem adivinhar, com claro Regras.
Pontos centrais
- Fila de execução vs. Bloqueios: «r» indica a carga da CPU, «b» avisa sobre tempos de espera de E/S.
- Memória Avaliar de forma realista: o facto de ser gratuito, por si só, não conta; o que importa é o resultado.
- E/S Em destaque: o bi/bo não são críticos, desde que o wa se mantenha baixo.
- Quotas de mercado da CPU interpretar: us+sy elevado, id baixo → elevada carga de trabalho.
- Linhas de base criar: comparar os valores do quotidiano com as fases problemáticas.
O que é que o vmstat realmente mostra?
O vmstat reúne os estados dos processos, a memória, o espaço de swap, as E/S de bloco e as percentagens de utilização da CPU numa saída compacta, que, em segundos, fornece um a nível do sistema Dá uma boa ideia. Primeiro, leio „procs“ para r/b, depois „memory/swap“ para free, buff, cache e si/so. Em seguida, verifico „io“ com bi/bo e termino com „cpu“ para us, sy, id, wa e, opcionalmente, st. Esta ordem ajuda-me a distinguir causa e efeito: um valor elevado de r indica carga computacional, um valor elevado de b aponta para tempos de espera de E/S, e wa associa a inatividade da CPU à latência de E/S. Assim, consigo identificar se o problema está no trabalho de processamento, na escassez de memória ou no dispositivo de armazenamento – e poupo-me Desvios.
Início em 60 segundos: chamadas e intervalos
Para obter um instantâneo desde o arranque, executo o „vmstat“ sem parâmetros; para análises imediatas, utilizo o „vmstat 1“ ou o „vmstat 5 12“ para doze pontos de medição a cada cinco segundos e obtenho um temporal Linha. Importante: a primeira linha reflete os valores médios desde o arranque do sistema; por isso, analiso sobretudo as linhas seguintes. Com „Delay/Count“, controlo a frequência de amostragem e a duração, por exemplo, «vmstat 1 30» em picos curtos. Em cargas de trabalho instáveis, defino 1–2 segundos; em cenários mais calmos, prefiro 5 segundos. Observo tendências, não fotogramas isolados, porque os padrões revelam o verdadeiro Causas espetáculo.
Compreender os processos: r e b no dia a dia
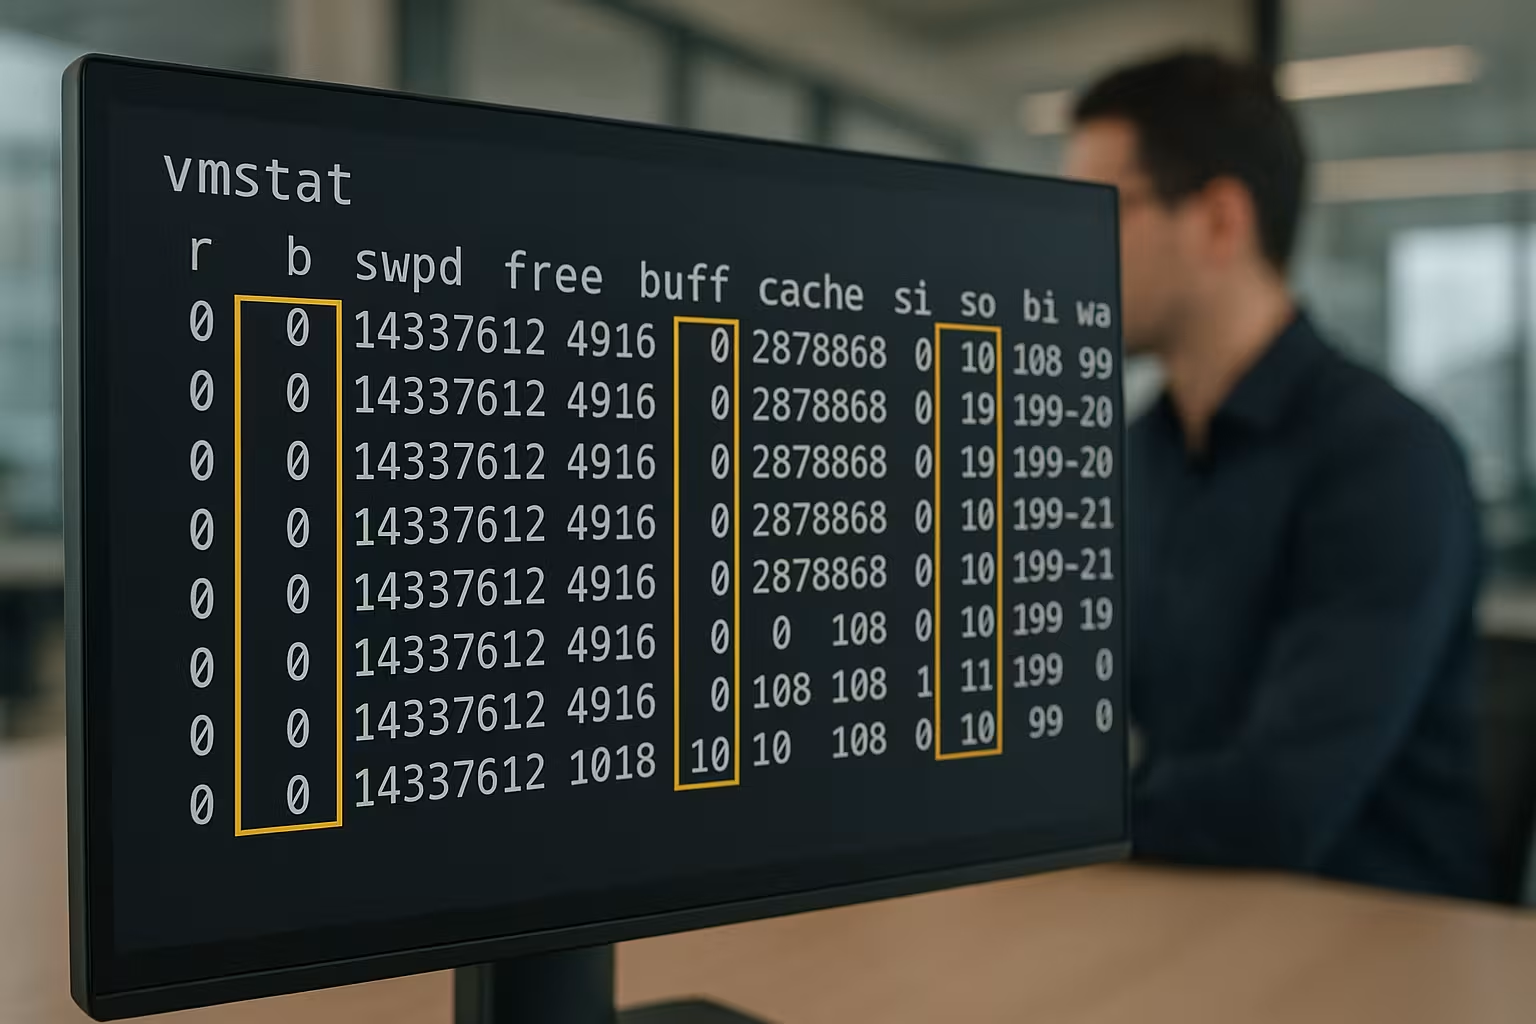
A coluna «r» mostra os threads prontos a executar que estão à espera de tempo de CPU; a coluna «b» conta os threads bloqueados, muitas vezes em espera de E/S. Se o valor de «r» se mantiver significativamente acima do número de núcleos físicos, é inevitável que Limitação da CPU ; em quatro núcleos, um valor de r=8 durante um período prolongado é considerado um sinal claro. Um valor de b superior a 0 durante um período prolongado indica suportes de dados lentos, bases de dados sobrecarregadas ou percursos de rede ou de armazenamento lentos. Estabeleço uma correlação entre r, us+sy e id: se o id for baixo e o r for elevado, a CPU está a ter dificuldades; se o wa for elevado e o b for elevado, a E/S está a causar um estrangulamento. É assim que decido se devo escalar a potência de computação, otimizar as consultas ou o Sistema de armazenamento verificar.
Interpretar as memórias: free, buff, cache, swpd
Um valor baixo de «free» é normal no Linux, uma vez que o kernel utiliza a RAM de forma intensiva como cache, o que acelera o acesso aos ficheiros e proporciona um verdadeiro Rendimento traz. Por isso, presto mais atenção ao swpd e aos fluxos de swap si/so do que apenas ao free. Um cache elevado é bom, desde que o si/so se mantenha quase sempre a 0; só um movimento contínuo de swap indica pressão real. Se, além disso, ocorrer latência ou mesmo OOM, intervenho: aumente a RAM, reduza os processos atempadamente ou ajuste os tamanhos da cache e da JVM. O contexto continua a ser importante: a carga de trabalho, a capacidade de memória e a disposição NUMA determinam o que, no seu ambiente, é considerado saudável aplica-se.
Atividade de swap: classificar de uma forma ou de outra
As colunas «si/so» medem o fluxo contínuo entre a RAM e a área de troca em KB/s e revelam a pressão real sobre a memória, e não apenas a percebida Carência. Picos de curta duração são normais, por exemplo, quando páginas raramente utilizadas são transferidas para a memória de paging. A situação torna-se crítica quando esses valores permanecem permanentemente acima de 0; isso abranda tudo, uma vez que cada transferência para a memória de paging gera custos adicionais de E/S. Valores elevados de «so» indicam uma transferência ativa para a memória de paging, e os tempos de resposta aumentam significativamente. Nesta altura, procuro identificar as causas: reduzir o consumo de memória, aumentar a RAM ou otimizar serviços que consomem muita memória sintonizar.
Compreender a E/S em bloco: bi e bo
Com o bi/bo, consigo determinar a taxa de leitura e escrita em blocos por segundo, mas, sem contexto, não a avalio; o que é decisivo é a interação com wa. Valores elevados de bi/bo, juntamente com um valor elevado de wa, indicam que o armazenamento não está a acompanhar o ritmo. Quando se verifica um valor elevado de bi numa base de dados, verifico os perfis de consulta e os acertos na cache antes de substituir o hardware. Para uma análise mais aprofundada dos tempos de resposta, recorro ao iostat e analiso o comprimento das filas e as latências, para que eu Analisar a espera de E/S e possa resolver os estrangulamentos de forma específica. Só quando o wa se mantiver baixo, mas o bi/bo disparar de forma sustentada, é que penso em Escalonamento do sistema de armazenamento.
Componentes da CPU: us, sy, id, wa, st
Valores elevados de us com valores baixos de wa indicam trabalho útil produtivo, enquanto valores elevados de sy sugerem uma sobrecarga significativa do kernel, como inúmeras pequenas operações de E/S ou muitas Mudança de contexto. Se o id for próximo de 0 e se mantiver nesse valor, a CPU está a funcionar no limite; combinado com um valor elevado de r, isso indica uma carga computacional elevada. Se o wa aumentar, a CPU está à espera de E/S – neste caso, o ajuste fino do armazenamento costuma trazer mais benefícios do que as atualizações da CPU. Nas máquinas virtuais, presto atenção ao st (steal): valores elevados de st indicam que o hipervisor está a desviar tempo de CPU, pelo que discuto a utilização do anfitrião com o operador. Avalio sempre us+sy como uma soma, pois esta mostra a atividade Trabalho no sistema.
Referência rápida: colunas e valores de referência
Utilizo a tabela seguinte como um resumo prático quando analiso os resultados do vmstat para uma primeira Avaliação leitura aleatória.
| Coluna | Significado | Em que é que presto atenção |
|---|---|---|
| r | Threads prontos a ser executados | Permanente > Núcleos → Pressão da CPU |
| b | Tópicos bloqueados | Constante > 0 + wa elevado → Problema de E/S |
| livre | RAM grátis | Um valor baixo não faz mal, desde que si/so se mantenha ≈ 0 |
| buff/cache | Buffer FS/Cache de páginas | Ter muito cache é bom; pode ser publicado tornar-se |
| si/so | Troca de entrada/saída | Valor contínuo > 0 → pressão real no reservatório |
| bi/bo | E/S em bloco | Só é crítico se o «wa» também for elevado |
| us/sy | Utilizador/Núcleo | us+sy de forma contínua > 80% → elevado Carga |
| id | marcha lenta | Próximo de 0 ao longo do tempo → CPU saturada |
| wa | Espera de E/S | Valor elevado com «b» elevado → Armazenamento como causa |
| st | Roubar (máquinas virtuais) | Elevado → O hipervisor ocupa CPU-Hora |
Valores de referência e monitorização contínua
Não me baseio em dados pontuais, mas sim comparo esses valores com valores de referência de períodos mais calmos, para poder identificar claramente os valores atípicos reconhecer. O comando „vmstat 1 60“ fornece-me um perfil de carga de um minuto, que comparo com fases normais conhecidas. Para uma perspetiva histórica, utilizo Monitorização sar/sysstat, para avaliar tendências ao longo de vários dias e afinar os valores-limite. Defino os alertas de forma conservadora: r em relação aos núcleos, si/so diferente de 0 ao longo de vários intervalos, wa significativamente elevado. Assim, reajo atempadamente, antes de os utilizadores reportarem atrasos e antes de Pico-As fases agravam-se.
O vmstat em conjunto com outras ferramentas
Começo pelo vmstat, analiso os padrões e aprofundo a análise de forma específica com o iostat, o mpstat, o pidstat ou métricas de aplicações, para identificar as causas claro atribuir. O vmstat mostra os tempos de espera de E/S; com o iostat, medo as latências e as filas por dispositivo. Se «r» indicar um limite do núcleo, o mpstat revela assimetrias do núcleo. Em picos de carga dos processos, fornece Análise de processos pidstat os tópicos mais acalorados sobre o tempo. Só a correlação com os registos e os tempos de execução das aplicações é que clarifica o quadro e me leva à verdadeira Causa.
Identificar padrões e agir
Se eu observar que r está alto, id baixo e wa moderado, a aplicação costuma otimizar de forma demasiado intensiva em termos de cálculo, pelo que verifico o código ou o paralelismo e planeio os recursos da CPU antes de Hardware exijo. Se os valores de b, wa e bi/bo aparecerem em conjunto, tenho em consideração o ajuste do armazenamento, a otimização das consultas e o cache. Se o valor de free for baixo, com si/so superior a 0, reduzo o consumo de memória, transmito os resultados em streaming ou aumente a RAM. Se os valores de us forem moderados e os de sy muito elevados, analiso os filtros de pacotes, as opções do sistema de ficheiros ou os controladores. Com esta lista de verificação, agi rapidamente e dedico o meu tempo onde é mais contagens.
Evitar erros de medição: amostragem, unidades, primeira linha
De forma deliberada, não considero a primeira linha para detetar falhas agudas, uma vez que ela calcula a média desde o arranque e suaviza completamente os picos. Além disso, defino a frequência de amostragem com base na hipótese da causa: registo picos de CPU com intervalos de 1 segundo e fugas de memória lentas com intervalos de 5 a 10 segundos. Tenho em conta as unidades: si/so correspondem a KB/s, bi/bo a „blocos/s“ (historicamente 1 KB por bloco, variável consoante a versão do vmstat). Verifico se o comando „vmstat -w“ (saída ampla) evita o corte de colunas e se as alterações na frequência de clock (P-States, Turbo) influenciam a perceção da carga a curto prazo. Sincronizo as medições com os picos da aplicação, em vez de considerar cegamente „minutos inteiros“.
Descodificar a secção «System»: in e cs
Para além de procs/memory/swap/io/cpu, o vmstat também apresenta „system“: em (interrupções/s) e cs (Mudanças de contexto/s). Estes dois valores dão-me muitas informações sobre a sobrecarga do kernel.
- cs muito elevado com carga útil moderada: oscilação de threads, lotes de workers demasiado pequenos ou contenção de bloqueios. Aumento o tamanho dos lotes, regulo o paralelismo (conjuntos de threads) e verifico os pontos críticos do agendador e dos mutex.
- aumentos repentinos: picos de interrupções de rede ou de armazenamento, efeitos NAPI/polling ou interrupções de temporizador. Comparo com a percentagem de sy e os resultados do iostat para verificar os controladores ou os percursos de rede.
- cs proporcional a r: isto aponta para uma pressão constante de mudança de contexto devido a um paralelismo excessivo. Vou reduzir o paralelismo ativo ou fixar os Hot-Threads aos núcleos.
Correlaciono sempre in/cs com sy e b/wa: só em conjunto é que se obtém uma imagem clara sobre se o trabalho do kernel é útil (por exemplo, débito) ou se constitui apenas sobrecarga.
Variantes e opções úteis do vmstat
Utilizo o vmstat de forma flexível para obter perspetivas adicionais sem ter de mudar de ferramenta:
- vmstat -s: Contadores de soma (por exemplo, processos iniciados desde o arranque, falhas de página principais/secundárias). Ideal para comparar fugas ou números de casos ao longo de intervalos de tempo.
- vmstat -m: Utilização de Slab – ajuda a classificar as caches do kernel (Dentry/Inode, rede) como consumidores de RAM.
- vmstat -d: Eventos de disco ao nível dos totais. Não substitui o iostat, mas é útil para uma verificação rápida da situação real.
- vmstat -S M: Alterar as unidades (M/K) para facilitar a leitura dos números.
- vmstat -w: Colunas mais largas evitam que os números sejam cortados em colunas com muitos números.
Combino estas opções com intervalos curtos, para não perder nenhum evento e, mesmo assim, manter uma visão geral.
Containers, máquinas virtuais e cgroups: particularidades
Nos contentores, interpreto o vmstat com cautela: muitos dados do kernel são válidos para todo o host, enquanto os limites provêm dos Cgroups. Valores elevados de r num contentor refletem a perspetiva do namespace, mas o tempo real de CPU pode estar limitado pela quota de CPU/quotas de CPU. Eu baseio-me st (Steal) nas máquinas virtuais: um valor elevado de st significa que o hipervisor me retira tempo – nesse caso, mesmo uma otimização perfeita da aplicação pouco ajuda, desde que o anfitrião esteja sobrecarregado. No caso de limites de memória em Cgroups, o si/so pode deixar de funcionar, apesar de o contentor estar a „agitar-se“ no limite (terminações OOM em vez de swap). Por isso, verifico adicionalmente os registos OOM e as estatísticas do Cgroup e comparo as imagens do vmstat com os limites.
NUMA e afinidade: quando a localização é importante
Em hosts NUMA, verifico os valores de r e us/sy por núcleo (com o mpstat) e observo se determinados sockets ficam „sobrecarregados“, enquanto outros permanecem inativos. Uma localização inadequada da memória leva a aumentos nos valores de cs/sy e b/wa, devido a acessos à memória distantes. Testo a afinidade da CPU e da memória (cpuset, numactl), configuro grandes heaps como „intercalados“ ou estritamente locais e certifico-me de que os threads ativos são executados onde se encontra a sua pegada de dados. Um layout NUMA estável suaviza o cs, reduz os picos de wa e aumenta a Planeamento sob carga.
Evitar interpretações erradas: o wa e o b são mais do que „suportes de dados lentos“
O wa não aumenta apenas devido às latências clássicas do disco: também o NFS/rede de alta latência, o armazenamento de objetos saturado, os volumes na nuvem que causam bloqueios ou os writebacks lentos da cache de páginas fazem com que o wa aumente. O b conta as tarefas em estado de suspensão ininterrupta (D-State) – o que inclui também bloqueios em controladores, percursos de rede ou bloqueios do sistema de ficheiros. Por isso, nunca avalio o wa/b isoladamente, mas sempre em conjunto com o bi/bo e os tempos de resposta das aplicações. Se o wa estiver elevado, mas o bi/bo baixo, isso indica frequentemente uma Dependência da espera para além da mera questão do débito dos dispositivos (por exemplo, bloqueio, E/S remota, congestionamento de writeback).
Otimização com bom senso: Swappiness, Writeback, Scheduler
Só alterei o Kernel-Tuner após ter efetuado medições e com um plano de reversão:
- vm.swappiness: Um valor baixo reduz a troca proativa de páginas, o que é bom para aplicações em que a latência é crítica – um valor demasiado baixo pode aumentar a pressão na cache de páginas.
- vm.dirty_background_ratio / vm.dirty_ratio (ou *_bytes): Influenciam os momentos de writeback. Valores demasiado elevados provocam longas rajadas de escrita (picos de wa), enquanto valores demasiado baixos aumentam os pequenos flushes constantes (sy/bo aumentam).
- Agendador de E/S/Profundidade da fila: Configurações diferentes do Optima em NVMe do que em HDD/RAID. Medei os compromissos entre latência e débito com o iostat antes de fazer qualquer alteração.
- Caminhos de rede: Muitos pequenos pacotes/interrupções chegam a /cs/sy. Os principais parâmetros de ajuste são GRO/LRO, RPS/RFS e IRQ-Affinity – faço medições antes e depois.
O meu objetivo é obter curvas estáveis e previsíveis no vmstat: us/sy mais estáveis, wa/b mais baixos e si/so próximos de 0. Só então é que procuro aumentar a capacidade do hardware.
Guia prático: Análise de 3 minutos com o vmstat
- 0:00–0:30 – „vmstat 1 30“: ignorar a primeira linha e, em seguida, analisar r/b, us/sy/id/wa. Pergunta: limite da CPU (r elevado, id baixo) ou limite de E/S (b/wa elevados)?
- 0:30–1:00 – Visão geral do acumulador: verificar swpd e si/so. si/so constantemente > 0? → pressão real no acumulador. free é secundário.
- 1:00–1:30 – Contexto de E/S: bi/bo vs. wa. Valores elevados de bi/bo sem wa? → A E/S é desligada. Valores elevados de wa com bi/bo moderados? → Latência/bloqueio/E/S remota.
- 1:30–2:00 – Secção «system»: in/cs em relação a sy. cs muito elevado? → Verificar pressão de mudança de contexto, paralelismo/bloqueio.
- 2:00–3:00 – Confirmar a hipótese e selecionar a ferramenta adequada: iostat para o índice de E/S, mpstat para assimetrias do núcleo, pidstat para pontos críticos dos processos. Só depois é que se procede ao ajuste/dimensionamento.
Exemplos avançados retirados da prática
- Saturação da CPU sem um r elevado: us+sy em 90%+, id ≈ 0, mas r moderado → ponto crítico de thread único ou problema de afinidade. Solução: paralelizar o caminho crítico, verificar o core-pinning.
- Swap-Thrash: em ambos os casos, simultaneamente, valores claramente > 0, b/wa aumentam, us diminui → RAM claramente insuficiente ou heap mal dimensionado. Medidas: aumentar a RAM, reduzir o conjunto de trabalho, ajustar a swappiness.
- Sobrecarga do kernel: sy elevado, cs/in elevado, us moderado → muitas pequenas chamadas de sistema/E/S. Solução: processamento em lote, redução das chamadas de sistema, verificar as opções de montagem do sistema de ficheiros.
- Atraso na reverte: wa elevado, bo elevado, ondas curtas → limites de «dirty» demasiado elevados, latência de armazenamento variável. Verificar o ajuste do «writeback» e o agendador de E/S.
- Pressão da virtualização: st visível, r oscila, id „salta“ → O anfitrião partilha a CPU. Solução: verificar a atribuição/colocação da vCPU, reduzir o overcommit.
Conhecer os limites do vmstat
O vmstat é um excelente Sensor de alerta precoce, mas não é um microscópio. Mostra-me que e onde está o problema – não o ficheiro específico, a consulta ou o thread. É por isso que, após o diagnóstico com o vmstat, recorro sistematicamente a ferramentas mais aprofundadas, confirmo hipóteses a partir de várias perspetivas e, depois, altero apenas uma coisa de cada vez. Desta forma, as melhorias permanecem mensuráveis e reproduzíveis.
Resumo da prática
Com o vmstat, consigo perceber em segundos se é a CPU, a RAM, o swap ou a E/S que está a causar o atraso, analisando a interação entre r, b, si/so, bi/bo e us/sy/id/wa/st ler. Avalio tendências em vez de valores individuais, comparo com valores de referência e, se necessário, recorro ao iostat, ao mpstat, ao pidstat e a medições históricas. Ignoro a primeira linha no caso de falhas agudas e concentro-me nas linhas seguintes, com uma taxa de amostragem fixa. Tomo decisões com base nos dados: r em relação aos núcleos, si/so permanentemente diferentes de 0, wa persistentemente elevado, us+sy próximos da carga máxima. Assim, deduzo rapidamente medidas concretas e mantenho os sistemas visivelmente reativo.


