Saltar para o conteúdo

O cgroup do Linux Controlador da CPU controla a quantidade de tempo de processamento atribuída a serviços, contentores e processos, permitindo planear o desempenho de forma específica. Vou explicar concretamente como a ponderação, as quotas e as práticas interagem entre si, para que possas atribuir o tempo de CPU de forma segura e evitar gargalos.
Pontos centrais
- ponderação versus Limite Compreender: partilha justa ou limite máximo rígido
- cgroup v2 dar preferência a: semântica clara, hierarquia consistente
- cpu.weight e cpu.max: as duas alavancas de regulação
- systemd Utilizar: Definir regras por serviço
- Monitorização e Transparência: Ler o cpu.stat e o PSI
Compreender os cgroups: grupos de processos e objetivos
Resumo os processos em Grupos em conjunto e, através deles, controlo recursos como a CPU, a memória e as E/S em hierarquias bem delimitadas. Em vez de ter de lidar com PIDs individuais, atribuo serviços completos, contentores ou conjuntos de trabalhadores a um grupo de controlo e defino regras claras. Desta forma, evito que uma tarefa que se expanda descontroladamente abrande a máquina, enquanto componentes importantes precisam de reagir. Especialmente no contexto da alojamento, esta abordagem compensa, porque muitos clientes e serviços funcionam no mesmo hardware. Este artigo sobre o tema fornece uma boa visão geral da organização prática cgroups e alojamento, que torna compreensível a separação das cargas.
Como funciona o controlador da CPU
O controlador da CPU divide tempo de computação através de dois mecanismos: ponderação relativa e limitação absoluta da largura de banda. A ponderação significa que os grupos recebem quotas de CPU proporcionalmente uns aos outros, assim que surge concorrência; os valores mais elevados ganham, então, faixas de tempo com maior frequência. Um limite por quota restringe o consumo num intervalo de tempo fixo, mesmo que não haja concorrência. Opto pela ponderação quando a equidade e a utilização dinâmica são prioritárias, e defino quotas quando é necessário que um limite máximo rígido permaneça inalterável. A documentação do kernel ilustra claramente esta diferença e mostra como ambos os mecanismos, em conjunto, resultam num modelo de controlo coerente [1].
cgroup v1 vs. v2: diferenças e ficheiros
Com cgroup v2 Giro as regras da CPU de forma mais uniforme e clara em comparação com a versão anterior, a v1. Na v1, utilizava ficheiros diferentes para cada controlador; na v2, concentro-me no cpu.weight para a prioridade relativa e no cpu.max para um limite rígido de largura de banda. Esta separação clara reduz o tempo de configuração, evita mal-entendidos e facilita as auditorias. Em cenários de alojamento com muitos contentores, a hierarquia da v2 garante regras compreensíveis em todos os níveis. O artigo sobre cgroup v2 na hospedagem, que aborda a questão do controlo consistente em caso de partilha de hardware.
| Tópico | cgroup v1 | cgroup v2 | Parâmetros típicos |
|---|---|---|---|
| Ponderação da CPU | cpu.shares | cpu.weight | cpu.weight (O valor padrão é frequentemente 100) |
| Quota/Limites da CPU | cpu.cfs_quota_us + cpu.cfs_period_us | cpu.max | cpu.max (por exemplo, 20 000 100 000) |
| Hierarquia | Controladores separados | Estrutura em árvore uniforme | Regras comuns para cada nível |
| Tempo real | Controlador rt independente | Restrições para a RT | Ver notas sobre o kernel [1] |
Para os administradores, o que importa é que Consistência Reduzir erros nas regras e fazer com que as alterações surtam efeito mais rapidamente. Documento os parâmetros nos nós de grupo, para que todos possam perceber o efeito atual. Nas migrações da v1, verifico cuidadosamente os equivalentes, sobretudo as «Shares» em relação ao «Weight» e a «CFS-Quota» em relação ao «cpu.max». Só quando as cargas de teste reagem conforme o esperado é que transfiro os serviços produtivos para a nova hierarquia. Esta transição disciplinada poupa muitos ciclos de suporte mais tarde.
Hierarquia, subárvores e delegação
No cgroup v2, controlo o controlador por nível e delega-as conforme necessário. Através de cgroup.subtree_control Ativo o controlador da CPU para os nós filhos; o systemd geralmente trata disso automaticamente quando defino as propriedades da CPU. Importante: na v2, o ideal é manter os processos em Grupos de folhas e não em nós intermédios. Desta forma, as regras mantêm-se mais claras e a distribuição de carga segue claramente a estrutura em árvore. Em configurações complexas, atribuo serviços inteiros a slices (por exemplo,. tenant-a.slice), incluindo serviços e conjuntos de trabalhadores. Esta separação clara facilita a delegação a equipas que trabalham nas „suas“ subárvores, sem violar as políticas globais.
Parâmetros importantes: cpu.weight e cpu.max
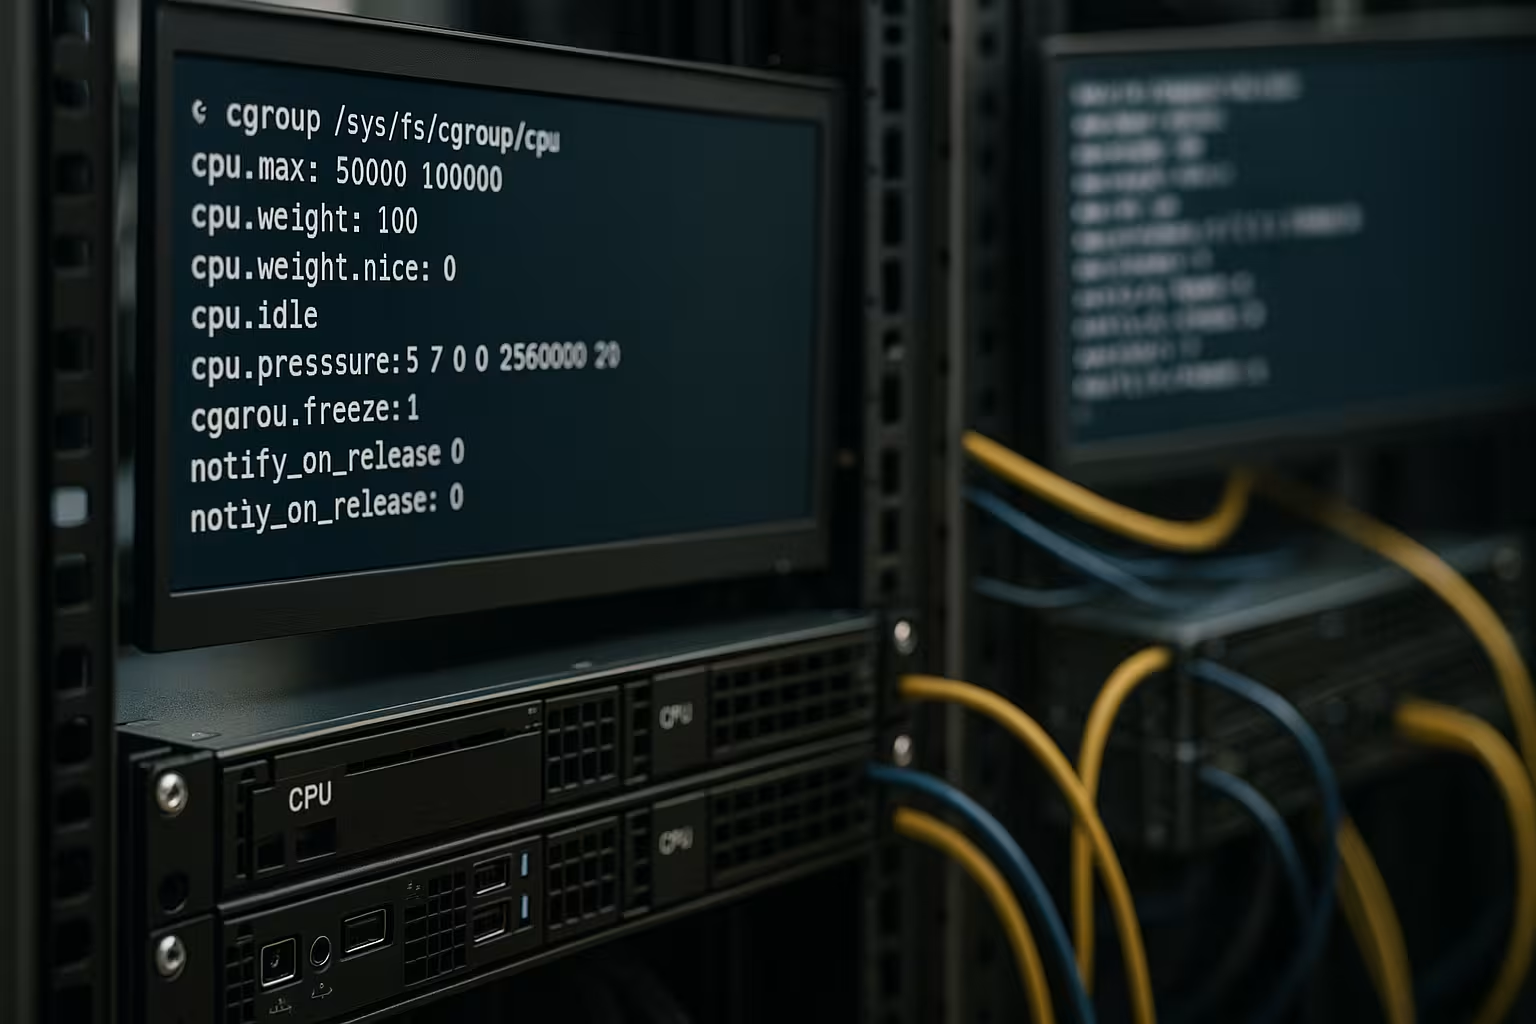
Eu uso cpu.weight, para priorizar os serviços de forma relativa: se o Serviço A receber um peso superior ao do Serviço B, o A terá acesso mais frequente ao tempo de CPU em condições de carga. O valor padrão na v2 é frequentemente 100; valores mais elevados dão preferência ao respetivo grupo, mas mantenho-me dentro de intervalos razoáveis para manter a relação controlável. Para limites rígidos, escrevo em cpu.max uma quota e um período, por exemplo 20000 100000 cerca de 20 por cento de um slot de vCPU. Com max Como primeiro passo, retiro o limite máximo, mas mantenho o período, o que simplifica os diagnósticos. A Red Hat documenta as configurações mais comuns de forma clara e mostra os efeitos na operação [2].
Parâmetros de ajuste adicionais: cpu.weight.nice e UClamp
Para equipas que partem da abordagem clássica legal-No que diz respeito à semântica, a v2 oferece cpu.weight.nice uma ponte prática: posso trabalhar com grupos na área de -20..19 classificar, o que é internamente mapeado para a escala de ponderação. Desta forma, as expectativas relativas („dar um pouco mais de ênfase“, „reduzir ligeiramente“) mantêm-se consistentes, sem ser necessário definir ponderações concretas de cada vez. Além disso, caso seja necessário, eu defino Fixação da utilização via cpu.uclamp.min e cpu.uclamp.max, para definir um limite mínimo ou máximo para a utilização efetiva da CPU ao nível do agendador. Desta forma, garanto, por exemplo, que um serviço sensível à latência não desça abaixo da carga básica necessária, mesmo com um número reduzido de threads, ou que as tarefas em lote não recebam um aumento de desempenho excessivo. Este ajuste fino complementa a ponderação e as quotas, mas não as substitui: avalio sempre como o UClamp se coaduna com a minha política de governadores e de energia antes de o implementar em grande escala.
Planeamento de cargas de trabalho: equidade versus limites rígidos
Decido conscientemente se Equidade ou que os limites máximos estritos tenham prioridade. Para serviços web em que a latência é crítica, aumentei ligeiramente o peso, para que sejam executados com prioridade em caso de concorrência, sem prejudicar excessivamente outros grupos. Para tarefas em lote que exigem grande capacidade de computação, defino adicionalmente uma cota, para que nunca ocupem demasiado tempo, mesmo que o sistema esteja ocioso. Atribuo uma ponderação moderada às bases de dados e observo o impacto de checkpoints, reconstruções ou consultas de grande dimensão; se necessário, faço ajustes temporários. Combino estas regras com alertas, para poder reagir atempadamente, antes que as latências aumentem.
Comportamento das quotas em processadores multicore e seleção do período
Um obstáculo frequente é a interpretação de Taxas em sistemas multicore. Uma quota refere-se à Tempo total de cálculo do grupo por período, e não a núcleos individuais. CPUQuota=200% ou cpu.max = 200 000 100 000 Permitem, grosso modo, dois segundos de CPU por período de 100 ms – distribuídos por todas as threads/núcleos. Isto pode significar que muitas threads funcionam em paralelo durante um curto período de tempo, até que o grupo seja „esgotado“ no período atual e seja limitado. Evito mal-entendidos ao pensar sempre nas quotas em termos de „slots de CPU“ e ao adaptá-las ao grau de paralelismo do serviço.
O período padrão é frequentemente de 100 ms. Períodos mais curtos (z. B. (50 ms) fazem com que a limitação tenha efeito mais rapidamente, mas podem gerar micro-jitter; períodos mais longos suavizam o sinal, mas têm uma resposta mais lenta. No systemd, ajusto isso com CPUQuotaPeriodSec= e verifico se os picos de latência ou as metas de débito são melhor atingidos. Para serviços interativos, medo a latência de ponta a ponta; para serviços em lote, baseio-me no débito total e na equidade em relação aos vizinhos.
Prática: Configuração com o systemd e o cgroup v2
No systemd, defino regras para cada serviço, porque Ficheiros de serviço permitir uma configuração reproduzível. Com systemctl set-property Alterço-as constantemente e, com ficheiros «drop-in», controlo as versões das definições de forma organizada. Um exemplo: systemctl set-property --runtime nginx.service CPUWeight=150 o NGINX atribui facilmente prioridades; systemctl set-property --runtime batch.service CPUQuota=20% limita os trabalhos em lote. De forma permanente, introduzo em /etc/systemd/system/service.d/limits.conf Defina as opções correspondentes e atualize as unidades. Para uma introdução prática, vale a pena consultar este guia sobre Controlo de Recursos do systemd, que resume sucintamente as opções mais comuns.
# Exemplos para o systemd v245+ com cgroup v2
# Priorização relativa
systemctl set-property --runtime nginx.service CPUWeight=150

# Limite máximo rígido
systemctl set-property --runtime batch.service CPUQuota=20%

# Combinação num ficheiro drop-in
mkdir -p /etc/systemd/system/php-fpm.service.d
cat < /etc/systemd/system/php-fpm.service.d/cpu.conf
[Service]
CPUWeight=120
CPUQuota=50%
EOF
systemctl daemon-reload
systemctl restart php-fpm.service
Slices para inquilinos e equipas
Para definir limites de clientes ou de equipas, utilizo Fatias como estrutura organizacional. Um «slice» agrupa vários serviços e âmbitos que são regulados em conjunto. Desta forma, atribuo orçamentos por cliente, sem ter de gerir cada unidade individualmente, e delego as alterações de forma controlada.
# Tenant-Slice com regras padrão
mkdir -p /etc/systemd/system/tenant-a.slice.d
cat < /etc/systemd/system/tenant-a.slice.d/cpu.conf
[Slice]
CPUWeight=120
CPUQuota=150%
# Opcional: período para uma limitação mais precisa
CPUQuotaPeriodSec=100ms
EOF
systemctl daemon-reload
systemctl restart tenant-a.slice
Todos os serviços em tenant-a.slice herdam estas especificações. Em caso de picos de curta duração, aumento temporariamente a carga, mas mantenho a quota estável, para que os sistemas vizinhos não sejam prejudicados.
Monitorização e resolução de problemas
Estou a avaliar a eficácia e os efeitos secundários com Transparência em métricas. Os ficheiros cpu.stat e cpu.pressure (PSI) por cgroup fornece-me percentagens, tempos de espera e congestionamentos que indicam limitação de largura de banda ou sobrecarga. Com topo, htop e systemd-cgtop Identifico tendências de distribuição em tempo real e comparo-as com as minhas regras. Se as latências aumentarem, mas a CPU estiver ociosa, o problema deve-se mais à E/S ou aos bloqueios do que a limites da CPU; nesse caso, não ajusto a ponderação precipitadamente. Após as alterações, documento os valores medidos ao longo de, pelo menos, um ciclo de carga, para evitar correlações erradas.
Manual de monitorização: O que leio, concretamente
cpu.stat: usage_usec, user_usec, system_usec mostram o consumo; nr_periods, nr_throttled, throttled_usec desmascarar uma restrição severa. Aumenta nr_throttled/nr_periods Se a variação for superior a alguns pontos percentuais, significa que o intervalo é demasiado estreito ou que o período é demasiado curto.cpu.pressure: Estou a observar algumas médias 10/60/300 para engarrafamentos que afetam a latência. Um valor persistentemente elevado, apesar de haver CPUs livres, indica contenção de bloqueios, conflitos de afinidade ou acessos remotos NUMA.systemd-cgtopeps: Vou verificar se os threads conseguem realmente funcionar em paralelo ou se ficam à espera de recursos exclusivos.
Para testes reproduzíveis, utilizo stress-ng, sysbench ou utilizo os meus próprios geradores de carga e registo instantâneos das métricas antes e depois. Só quando os valores medidos se mantiverem estáveis e corresponderem às expectativas é que implemento as alterações.
Tempo real e características específicas
Em Tempo real- No que diz respeito às cargas de trabalho, sigo as orientações da documentação do kernel, uma vez que a v2 gere o controlador da CPU para RT apenas de forma limitada. Certos threads RT têm de estar no cgroup raiz, e a configuração exige um procedimento cuidadoso. Além disso, verifico como a programação RT se comporta com as quotas, para que nenhum prazo seja ultrapassado inadvertidamente. Para serviços típicos da Web e de bases de dados, utilizo políticas normais, pois esta configuração permite um planeamento mais seguro no dia-a-dia. Quando necessito de RT, isolo os sistemas ou reservo núcleos de forma clara, para que não ocorram interações inesperadas [1].
Controlo de precisão em sistemas multi-core
O controlador da CPU divide Janela de tempo, e não a frequência de clock; por isso, quando necessário, combino-o com o cpuset e a afinidade. Para obter uma latência baixa, limito as transições entre sockets, associo threads a núcleos locais NUMA e otimizo a distribuição de IRQs. Deixo os serviços em lote a funcionar de forma mais flexível, para que aproveitem a capacidade excedente sem bloquear núcleos destinados a front-ends críticos. Verifico as políticas de turbo ou de poupança de energia, porque as alterações de frequência podem alterar significativamente o comportamento sob carga. Só a combinação de quotas, ponderações, afinidade da CPU e estratégia energética proporciona resultados consistentes.
SMT, NUMA e afinidade na prática
Em sistemas com SMT/Hyper-Threading Reparo que dois threads lógicos num núcleo físico não correspondem a dois slots completos da CPU. Uma cota de „100 %“ corresponde a um slot lógico, não necessariamente a um núcleo físico completo. Por isso, medo a latência e o débito com e sem utilização de SMT. Em sistemas NUMA, limito os serviços críticos com AllowedCPUs= (cpuset) ou CPUAffinity= utilizar núcleos locais e configurar a ligação à memória em conformidade, para que os acessos remotos não comprometam todo o planeamento detalhado.
Melhores práticas para alojamento e contentores
Começo com uma dose moderada Predefinições: Atribuir uma ponderação ligeiramente superior aos serviços web, bases de dados próximas do padrão, processamento em lote com quota. Para os inquilinos, defino limites máximos por cliente e permito picos de utilização através da ponderação, desde que não haja outras necessidades. Documento os perfis por caso de utilização, como „latência crítica“, „misto“ e „intensivo em computação“, e defino intervalos claros para «weight» e «cpu.max» por perfil. Aplico as alterações primeiro no ambiente de teste e simulo-as com uma carga sintética que reflita de forma realista os picos. Mantenho os registos e as métricas próximos dos limites do cgroup, para que os diagnósticos não se percam na névoa.
Orquestração de contentores: partilhas, pedidos e limites
Em ambientes de contentor, mapeio Pedidos com base na ponderação relativa e Limites com quotas rígidas. Isto permite picos de atividade, desde que os nós tenham capacidade disponível, e garante uma distribuição justa de acordo com o peso em situações de concorrência. Os pods ou serviços críticos recebem um pouco mais de peso, sem que os limites prejudiquem os outros. Tenho o cuidado de garantir que a soma dos limites por nó corresponda de forma realista à CPU disponível; caso contrário, apesar de regras bem definidas, ocorre uma limitação a nível do sistema que afeta todos os inquilinos.
Configurações de exemplo e exemplos de cálculos
Calculo sempre as quotas em Acções por slot de vCPU: cpu.max = PERÍODO DE QUOTA corresponde a QUOTA/PERÍODO do slot. Exemplo: 20000 100000 correspondem a 0,2 de uma única CPU; com quatro CPUs, o máximo é de 0,8 de slot total, mas a distribuição não é garantida. Para indicar percentagens no systemd, escrevo CPUQuota=20%, o que, dependendo da versão, está em sintonia com o cpu.max. Quem definir limites rígidos tem de ponderar o comportamento em picos de carga face à latência: um período demasiado curto pode causar micro-travamentos, enquanto um período demasiado longo distribui a carga de forma mais suave, mas reage com mais lentidão. Por isso, testo períodos entre 50 e 100 ms e escolho a variante que se adequa à classe de latência do serviço [2].
Migração da v1 para a v2 sem surpresas
Ao mudar de linha, passo por cpu.shares em cpu.weight e cpu.cfs_quota_us/period_us em cpu.max. Uma representação pragmática para as «Shares» é: 1024 → ~100, 2048 → ~200, 512 → ~50. Faço pequenos ajustes após os testes de carga, pois as escalas diferem. Além disso, pretendo que as regras da v2 se apliquem às crianças cumulativo Efeito: uma quota restritiva no nó pai limita todos os subgrupos em conjunto. Por isso, muitas vezes elimino as quotas dos nós pais (max) e faço ajustes granulares nas folhas, para evitar efeitos colaterais.
Problemas frequentes e soluções
- 100 % confundido com „todos os núcleos“: 100 % correspondem a uma ranhura lógica da CPU, e não à máquina na sua totalidade. Solução: calcular a quota com base nas ranhuras necessárias (por exemplo, 400 % para quatro ranhuras).
- Período demasiado curto: Pequenos solavancos em serviços interativos. Solução: aumentar o período ou utilizar a ponderação em vez da quota.
- Ponderação medida sem concorrência: O peso só tem efeito em condições de competição. Solução: realizar testes com carga paralela real.
- Esquecer as quotas parentais: Um pai com restrições limita todos os filhos. Solução:
cpu.max=maxno elemento pai, limites nas folhas. - NUMA/soquete ignorado: Latência apesar de a CPU estar livre. Solução: verificar a afinidade/CPUSets e a localidade da memória.
Resumo
Com o Controlador da CPU Atribuo tempo de processamento de forma específica, defino prioridades justas e estabeleço limites rígidos sempre que necessário. O cgroup v2 oferece parâmetros claros, como o cpu.weight e o cpu.max, que planeio e avalio consoante a carga de trabalho. Através do systemd, defino regras por serviço, verifico o impacto com o cpu.stat e o PSI e faço ajustes sem ter de adivinhar. Para inquilinos, contentores e ambientes de servidores mistos, este controlo continua a ser fundamental para alcançar fiabilidade e previsibilidade. Quem documenta as regras, as implementa gradualmente e as valida com testes de carga evita gargalos e mantém o controlo sobre o tempo de CPU.