Перейти к содержимому

Системы управления базами данных - это важнейшие программные решения для хранения, обработки и защиты больших объемов данных. В этой статье дается грамотное введение в системы управления базами данных, объясняются принципы их построения, различия между реляционными и NoSQL-моделями, а также показываются современные тенденции и рекомендации по эффективному использованию.
Центральные пункты
- Relational и NoSQL Базы данных сильно различаются по своей структуре
- Доступ к данным обычно осуществляется с помощью SQL или гибких языков запросов с NoSQL
- Надежность с помощью резервного копирования, репликации и концепции ролей
- Облачные решения и искусственный интеллект характеризуют современные разработки
- Поэтапное внедрение Повышает долгосрочную стабильность системы
Что именно делают системы управления базами данных?
Системы управления базами данных (СУБД) надежно управляют структурированными и неструктурированными данными. Они обеспечивают защиту доступа, целостность данных и предлагают такие функции, как транзакции, автоматизация и протоколирование. Таким образом, можно контролировать весь жизненный цикл данных - от ввода до архивирования. Компании используют СУБД для систематического использования информации о клиентах, данных о продажах или журналах. Я использую их каждый день для работы с проектами клиентов и автоматизированного анализа.
Реляционная или NoSQL - какая модель данных подходит?
A реляционная система управления базами данных Организует данные в таблицах с фиксированной схемой. Такая структура подходит для процессов с четко определенными взаимосвязями - например, процессов заказа или бухгалтерской информации. Решения NoSQL Напротив, они хранят данные гибко, часто в виде JSON или документов, что идеально подходит для систем с растущими или меняющимися форматами данных. Современные веб-приложения получают огромную выгоду от такой гибкости. Я рекомендую четко проанализировать тип проекта, прежде чем принимать решение.
Сравнение: реляционные и NoSQL-системы
Свойства реляционных и NoSQL баз данных существенно различаются в зависимости от случая использования. В следующей таблице представлен конкретный обзор:
| Критерий | Реляционные СУБД | Базы данных NoSQL |
|---|---|---|
| Модель данных | Таблица | Без схемы |
| Запросы | SQL | Различные API |
| Масштабирование | Вертикальный | Горизонтальный |
| Последовательность | Правила ACID | Зачастую постоянство |
MySQL как пример для изучения и практического применения
MySQL одна из самых распространенных в мире систем реляционных баз данных. Она имеет открытый исходный код, является кроссплатформенной и идеально подходит для веб-проектов. Я использую ее, в частности, в интернет-магазинах и для конвертации данных. Если вы ищете краткое введение, вы найдете Руководство по базам данных MySQL полезные советы по установке и использованию. Такие инструменты, как phpMyAdmin, облегчают администрирование без командной строки.
SQL как язык для запросов структурированных данных
Язык структурированных запросов позволяет выполнять мощные манипуляции с данными. С помощью всего нескольких команд, таких как ВЫБЕРИТЕ, JOIN и ГРУППА ПО Записи данных можно объединять, анализировать и фильтровать. Я ежедневно использую SQL для создания информационных панелей с анализом в режиме реального времени. Этот язык прост в изучении и входит практически во все решения для реляционных баз данных.
NoSQL: гибкие структуры данных за пределами табличной модели
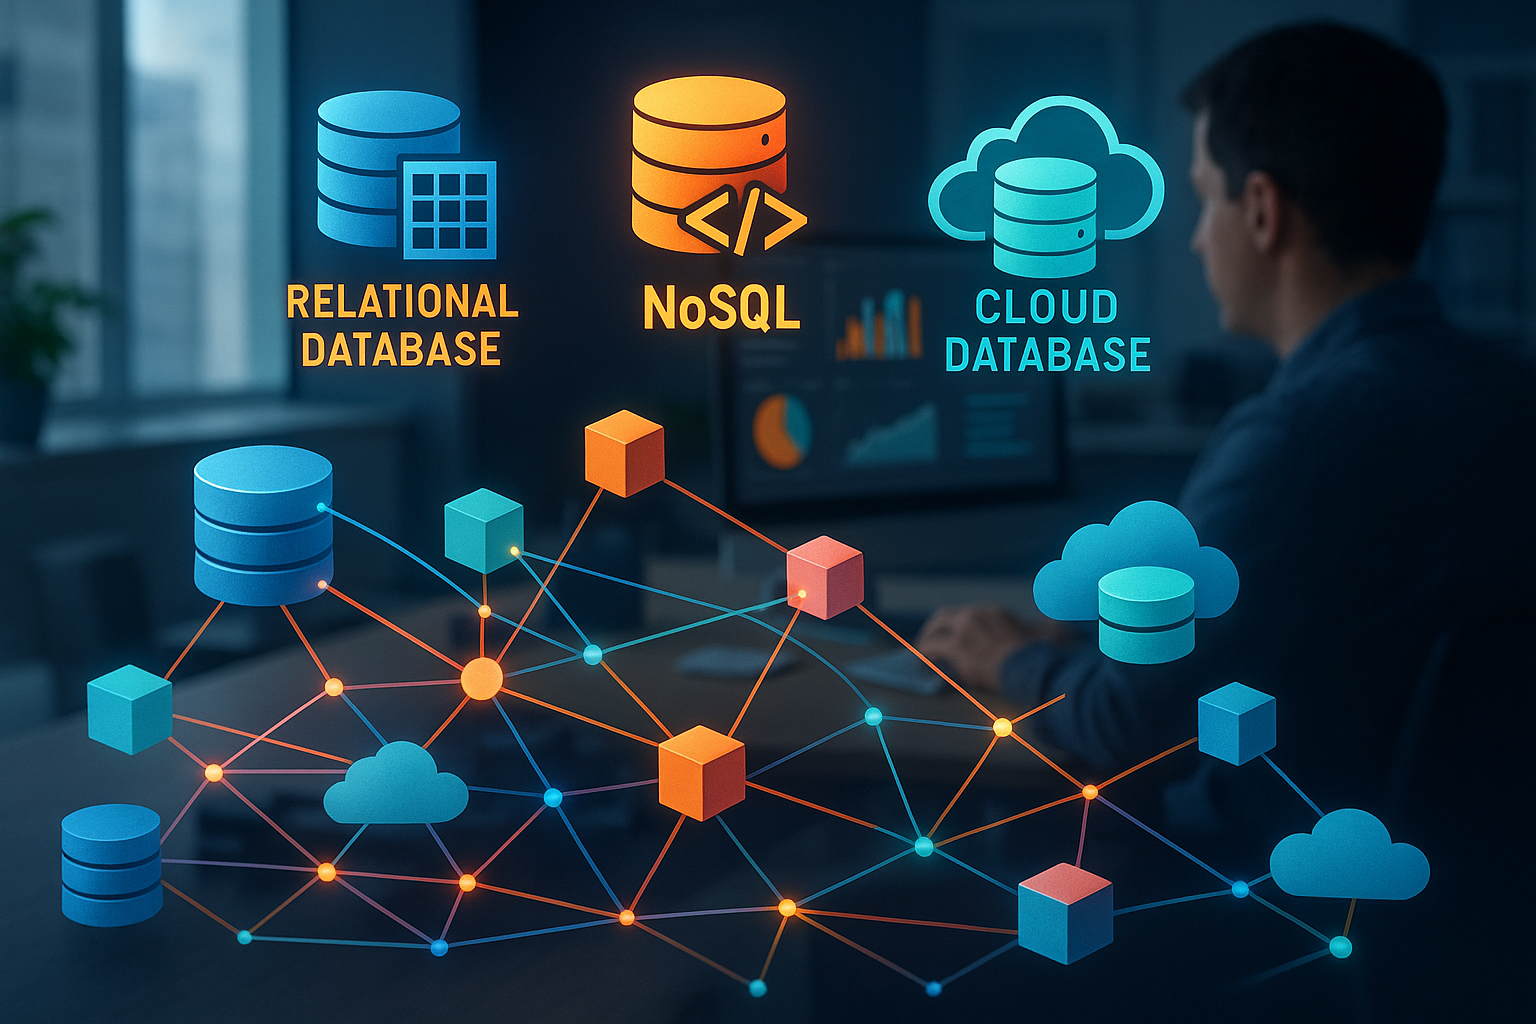
Базы данных NoSQL хранят контент динамически - в виде документов, пар ключ-значение или графовых связей. Ведущими представителями являются MongoDB, Redis и Cassandra. Я успешно использую MongoDB для мобильных проектов с часто меняющимися полями данных. Большое преимущество: новые поля можно добавлять без изменения схемы. Если вы не можете определиться между двумя мирами, вы можете найти поддержку в Сравнение SQL и NoSQL.
Функции безопасности, необходимые для СУБД
СУБД должна не просто хранить данные. Она защищает данные с помощью Права пользователя, Аутентификация и Шифрование. Кроме того, очень важно бесперебойное ведение журнала. При выборе я обращаю внимание на ежедневное резервное копирование, доступ на основе ролей и поддержку SSL. Особенно важны возможности автоматического восстановления после системных сбоев.
Оптимизированные для приложений архитектуры баз данных
Особенно в крупных проектах быстро становится очевидным, что стандартной настройки часто недостаточно: в зависимости от отрасли и объемов данных стандартной настройки часто бывает недостаточно. Специально разработанные архитектуры необходимо. Проект электронной коммерции с тысячами ежедневных транзакций требует иной базы данных, чем решение для управления журналами, которое управляет миллиардами постоянно растущих записей. Поэтому я рекомендую, чтобы требования к Наличие, Латентность и Пропускная способность данных определить. Выбор инфраструктуры - локальной или облачной - также характеризует дизайн. В то время как реляционные системы хорошо подходят для классических бизнес-процессов и структурированных таблиц, системы NoSQL убеждают, когда речь идет о высокой скорости записи и неструктурированных данных.
Во многих случаях Гибридные архитектуры Реляционные базы данных могут обрабатывать, например, данные инвентаризации или транзакций, в то время как системы NoSQL используются для анализа в реальном времени или неструктурированных журналов. Таким образом, вы получаете преимущества обоих миров, но в то же время сталкиваетесь со сложностью синхронизации данных. Именно здесь Решения для среднего программного обеспечения которые объединяют данные из разных систем и обеспечивают стандартизированный доступ.
Интеграция данных и процессы ETL
Другим важнейшим аспектом управления базами данных является Интеграция данных. Информация часто распределена по нескольким источникам данных, таким как CRM-системы, платформы веб-аналитики и внутренние базы данных ERP. Процессы ETL (Extract, Transform, Load) предлагают профессиональные возможности для автоматического объединения данных. Я использую инструменты ETL для извлечения необработанных данных из различных систем, преобразования их в стандартизированный формат и окончательного сохранения в целевой системе, например в хранилище данных.
Тщательное планирование этапов ETL необходимо для обеспечения качества и согласованности данных. Если значительная часть задач автоматизирована, можно сэкономить ресурсы и свести к минимуму человеческие ошибки. Особенно важно Мониторинг конвейеров данных: регулярное ведение журналов помогает выявить узкие места на ранней стадии, чтобы сократить время отклика. Комплексные процессы ETL поддерживают СУБД в создании центрального "единого источника истины", что значительно упрощает дальнейшую обработку в аналитических системах или приложениях машинного обучения.
Роль интеграции в микросервисах и DevOps
Современная разработка программного обеспечения все больше опирается на микросервисы и методы DevOps. В этом контексте базы данных должны Масштабируемый, отказоустойчивый и легкий могут быть интегрированы. В то время как монолитные приложения обращаются к центральной базе данных, хранение данных в микросервисах часто распределяется между несколькими небольшими экземплярами БД. Это облегчает независимое развертывание, но повышает сложность с точки зрения согласованности и безопасности.
Непрерывная интеграция и непрерывная доставка (CI/CD) становятся все более важными и для баз данных: схемы баз данных версионируются, сценарии миграции выполняются автоматически, а тестовые среды можно быстро запустить в контейнерных технологиях, таких как Docker и Kubernetes. Для меня хорошо продуманная Оркестровка баз данных Незаменима в средах DevOps, чтобы иметь возможность быстро предоставлять обновления или релизы функций без ущерба для целостности данных.
Облако, искусственный интеллект и автоматизированное управление - тренды будущего
Облачные базы данных, такие как Google Cloud Spanner или Amazon Aurora, устанавливают новые стандарты. Также Самооптимизирующиеся системы приобретают все большее значение. Они автоматически распознают "узкие места" и корректируют индексы. Искусственный интеллект обеспечивает автоматическую оптимизацию запросов или оценку релевантности. На мой взгляд, будущее за гибридными решениями, сочетающими реляционные структуры и свободу NoSQL. Хорошим примером из практики является MariaDBкоторый поддерживает оба подхода.
Помимо оптимизации с помощью искусственного интеллекта, наиболее важными Бессерверные модели баз данных это новая тенденция. В этом случае вы платите только за те ресурсы, которые фактически используете, что особенно выгодно при пиковых нагрузках и нерегулярном использовании. Некоторые облачные провайдеры также предлагают интегрированные функции для Машинное обучение-процессы для получения прогнозов непосредственно из хранимых данных. Это снижает сложность внешних ETL-процессов и в то же время уменьшает препятствия для создания бизнес-моделей, основанных на данных.
Мониторинг и наблюдаемость в средах баз данных
Для достижения оптимальной производительности Мониторинг среды базы данных. Помимо чистых показателей, таких как загрузка процессора и памяти, инструменты наблюдаемости позволяют получить более глубокие сведения. Например, они анализируют, как быстро выполняются отдельные запросы или какие индексы базы данных используются чаще. Я использую решения для мониторинга, которые отправляют автоматические предупреждения при превышении пороговых значений, таких как буфер базы данных или количество активных соединений.
Этому способствует и хорошая наблюдательность, Бутылочные горлышки производительности выявить. Если определенные таблицы сканируются регулярно, несмотря на то что индекс может оптимизировать запрос, это свидетельствует о наличии потенциала для тонкой настройки. Конечно, полностью избежать простоев таким образом невозможно, но целенаправленный мониторинг может значительно сократить время простоя и одновременно повысить удовлетворенность пользователей.
Развертывание и эффективное внедрение шаг за шагом
Начните с точного анализа требований: какие типы данных обрабатываются? Как часто они меняются? Затем я выбираю модель базы данных. NoSQL дает преимущества при растущем числе пользователей, а реляционные модели отображают четко структурированные бизнес-процессы. Для работы рекомендуется использовать хостинг-провайдера с опытом предоставления баз данных. Автоматическое резервное копирование и Высокая доступность для меня не подлежит обсуждению.
После закрепления основания рекомендуется Пошаговая процедурапостепенно интегрировать такие компоненты, как кэширование, балансировка нагрузки или механизмы репликации. Концепция распределения ролей и авторизации между базами данных предотвращает нежелательный доступ. В то же время команда должна быть обучена новым процессам и инструментам, чтобы все знали, когда выполняется резервное копирование данных, какие инструменты мониторинга активны и какие шаги по эскалации должны быть предприняты в случае ошибки. Таким образом, создается адаптивная организация, которая может постоянно развивать свою среду данных.

Обслуживание и производительность: регулярный уход приносит свои плоды
Я рекомендую планировать регулярное обслуживание. Это включает в себя обслуживание индексов, проверку файлов журналов, обновление версий и анализ производительности. Такие инструменты, как анализаторы запросов, помогают выявить медленные SQL-команды. Активный мониторинг производительности с оповещениями о превышении пороговых значений также оправдывает себя в долгосрочной перспективе. Обращайте внимание на потребление памяти и скорость отклика, особенно когда нагрузка на пользователя возрастает.
Часто недооцениваемая область - это Разделение таблиц или баз данныхВ этом случае большие объемы данных распределяются между несколькими физическими или виртуальными серверами. Этот процесс может привести к значительному увеличению производительности быстрорастущих приложений. Однако распределение требует тщательного планирования для равномерного распределения нагрузки и исключения "горячих точек". И наоборот, неправильное распределение или несогласованная стратегия шардинга приводит к высоким задержкам и трудоемкому устранению неполадок.
Обеспечение долгосрочной надежности
Помимо технологий, все большее значение приобретает управление данными. Четко структурируйте таблицы, документируйте изменения и внедряйте четкие ролевые концепции. Это сэкономит время при проведении аудита и внесении изменений. Надежная система управления базами данных облегчит вам работу в соответствии с GDPR в долгосрочной перспективе - будь то электронная коммерция или работа с конфиденциальными данными клиентов.
Кроме того, хорошо продуманная Стратегия резервного копирования и восстановления незаменимы. Часовое или ежедневное резервное копирование является стандартным, но важно, чтобы восстановленные данные были действительно готовы к использованию. Поэтому следует регулярно проводить тесты восстановления. Для критически важных приложений также стоит многорегиональное резервное копированиедля сохранения данных даже в случае региональной катастрофы. Наконец, высокая надежность достигается за счет сочетания автоматического восстановления после сбоев, резервного оборудования и концепций безопасности, охватывающих весь стек.
Резюме: Как начать работу с базами данных
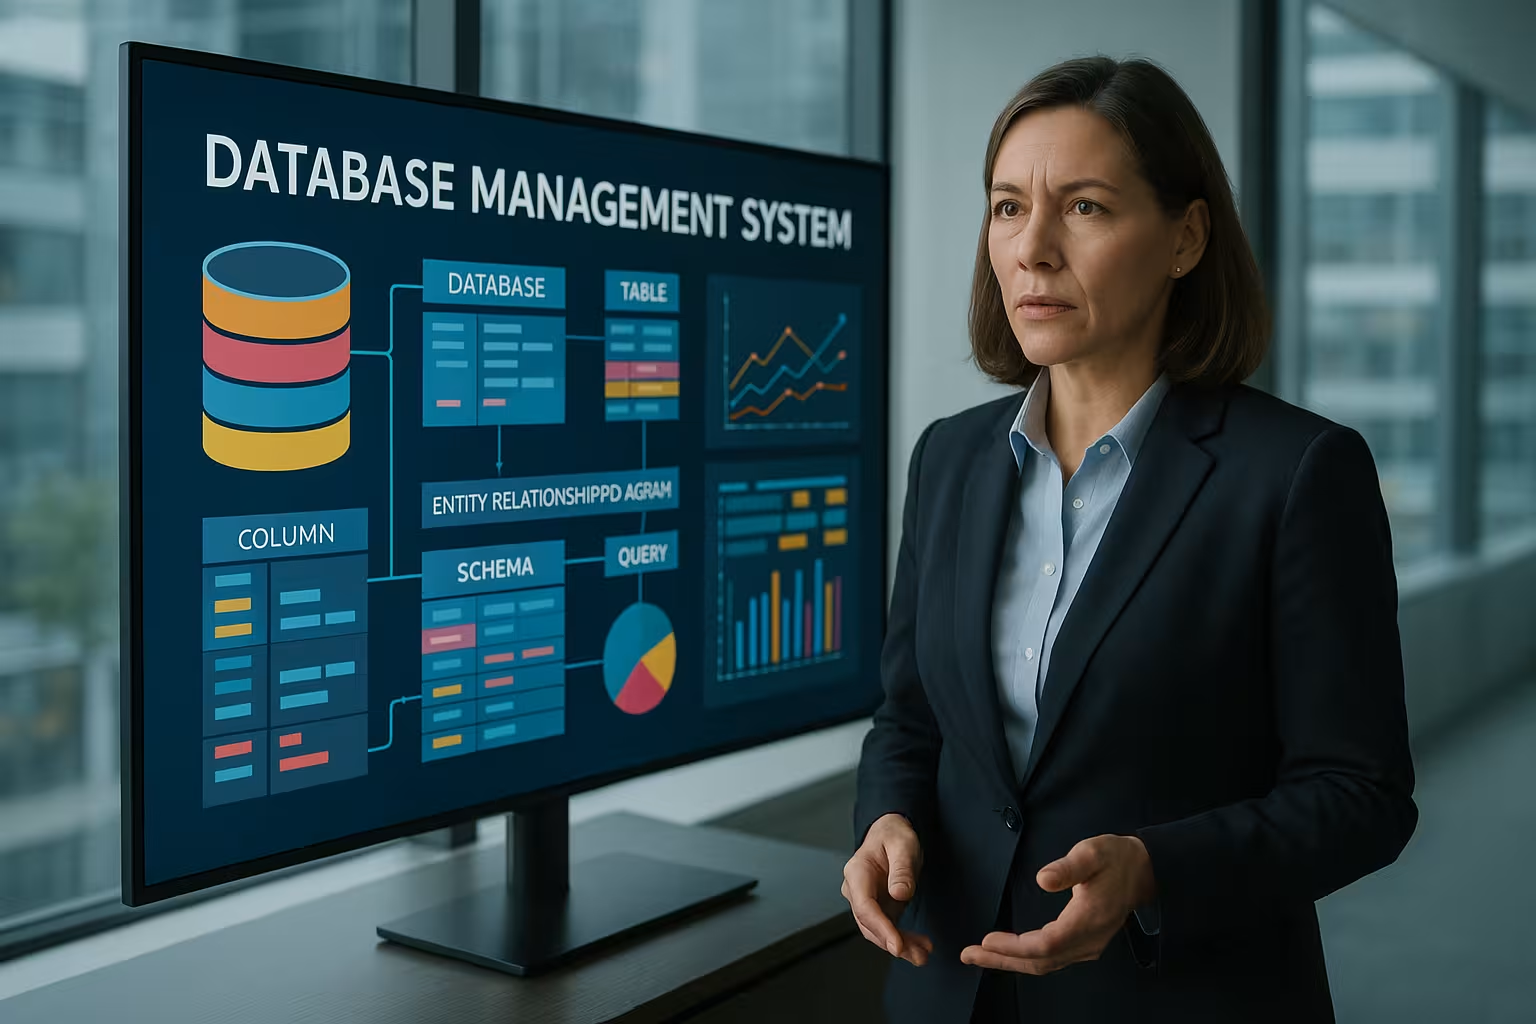
Системы управления базами данных предлагают мощные инструменты для приложений, управляемых данными. Будь то гибкие структуры NoSQL, основанные на документах, или традиционно реляционные - вы должны адаптировать модель к своему сценарию использования. Уделяйте внимание аспектам безопасности, планируйте резервное копирование и используйте современные решения, такие как облачные СУБД или гибридные платформы. При правильной настройке вы сможете создавать масштабируемые, перспективные системы для любых объемов данных.