 Перейти к содержимому

Я покажу тебе, как целенаправленно анализировать вывод команды vmstat в Linux: за считанные секунды ты сможешь выявить перегрузки ЦП, давление на память, использование свопа и время ожидания ввода-вывода. Вот как правильно интерпретировать столбцы r, b, free, si/so, bi/bo и us/sy/id/wa/st и на основе выявленных закономерностей определять конкретные меры — без догадок, с помощью очистить Правила.
Центральные пункты
- Очередь выполнения vs. блокировки: r отображает нагрузку на ЦП, b предупреждает о времени ожидания ввода-вывода.
- Память Оценить реально: бесплатно — это еще не все, решающим фактором является «так или иначе».
- ВВОД/ВЫВОД В поле зрения: показатели bi/bo не вызывают опасений, если уровень wa остается низким.
- Доли рынка процессоров значение: us+sy высокое, id низкое → высокая загрузка.
- Базовые линии Составить: сравнить показатели в повседневной жизни с показателями в периоды возникновения проблем.
Что на самом деле показывает vmstat?
Vmstat объединяет данные о состоянии процессов, памяти, свопе, блочном вводе-выводе и доле использования ЦП в одном компактном отчете, который за считанные секунды предоставляет в масштабах всей системы Это даёт общее представление. Сначала я просматриваю „procs“ для r/b, затем „memory/swap“ для free, buff, cache, а также si/so. Затем я проверяю „io“ с bi/bo и завершаю „cpu“ для us, sy, id, wa и, по желанию, st. Такой порядок помогает мне различать причину и следствие: высокое значение r указывает на вычислительную нагрузку, высокое значение b — на время ожидания ввода-вывода, а wa связывает простой процессора с задержкой ввода-вывода. Так я определяю, что именно тормозит работу: вычислительная нагрузка, нехватка памяти или носитель данных — и тем самым экономлю Обходные пути.
Запуск через 60 секунд: вызовы и интервалы
Чтобы получить моментальный снимок состояния системы с момента загрузки, я запускаю команду „vmstat“ без параметров; для оперативного анализа я использую „vmstat 1“ или „vmstat 5 12“ (для получения двенадцати точек измерения каждые пять секунд) и получаю временные Строка. Важно: первая строка отражает средние значения с момента запуска системы, поэтому я в первую очередь анализирую последующие строки. С помощью параметров Delay/Count я регулирую частоту опроса и продолжительность, например, „vmstat 1 30“ при кратковременных пиках. При нестабильных нагрузках я устанавливаю 1–2 секунды, а при стабильных сценариях — скорее 5 секунд. Я наблюдаю за тенденциями, а не за отдельными кадрами, потому что закономерности отражают истинные Причины показать.
Изучение процессов: r и b в повседневной жизни
Колонка «r» отображает готовые к выполнению потоки, ожидающие времени процессора, а «b» — количество заблокированных потоков, часто находящихся в режиме ожидания ввода-вывода. Если значение «r» значительно превышает количество физических ядер, то возникает необходимость ограничение производительности процессора ; на четырёх ядрах значение r=8, сохраняющееся в течение длительного времени, считается явным сигналом. Значение b, превышающее 0 в течение длительного времени, указывает на медленные носители данных, перегруженные базы данных или медленные сетевые или хранилищные пути. Я соотношу r с us+sy и id: если id низкое, а r высокое, то процессор перегружен; если wa высокое и b высокое, то тормозит ввод-вывод. Так я решаю, нужно ли масштабировать вычислительную мощность, оптимизировать запросы или Система хранения проверьте.
Интерпретация регистров памяти: free, buff, cache, swpd
Низкое значение параметра «free» в Linux является нормальным явлением, поскольку ядро активно использует оперативную память в качестве кэша, что ускоряет доступ к файлам и обеспечивает реальный Пропускная способность приводит. Поэтому я уделяю больше внимания показателям swpd и потокам свопа si/so, чем только показателю free. Высокий уровень кэша — это хорошо, пока si/so почти всегда остаются равными 0; только постоянная активность свопа свидетельствует о реальной нагрузке. Если дополнительно возникает задержка или даже OOM, я принимаю меры: увеличиваю объем оперативной памяти, своевременно сокращаю процессы или настраиваю размеры кэша и JVM. Важен контекст: рабочая нагрузка, объем памяти и расположение NUMA определяют, что в вашей среде считается здоровый применяется.
Активность свопов: классификация по принципу «так или иначе»
Колонки «si/so» измеряют постоянный поток данных между оперативной памятью и областью подкачки в кБ/с и позволяют увидеть реальную нагрузку на память, а не только субъективное ощущение Недостаток. Кратковременные всплески — это нормальное явление, например, при перемещении редко используемых страниц. Ситуация становится критической, когда эти значения постоянно остаются выше нуля; это замедляет работу системы, поскольку каждое перемещение в файловую память влечет за собой дополнительные затраты на ввод-вывод. Высокие значения so указывают на активное выгрузку, и время отклика болезненно увеличивается. В этот момент я устраняю причины: сокращаю потребление памяти, расширяю объём ОЗУ или переносите ресурсоёмкие службы настройка.
Понимание блочного ввода-вывода: bi и bo
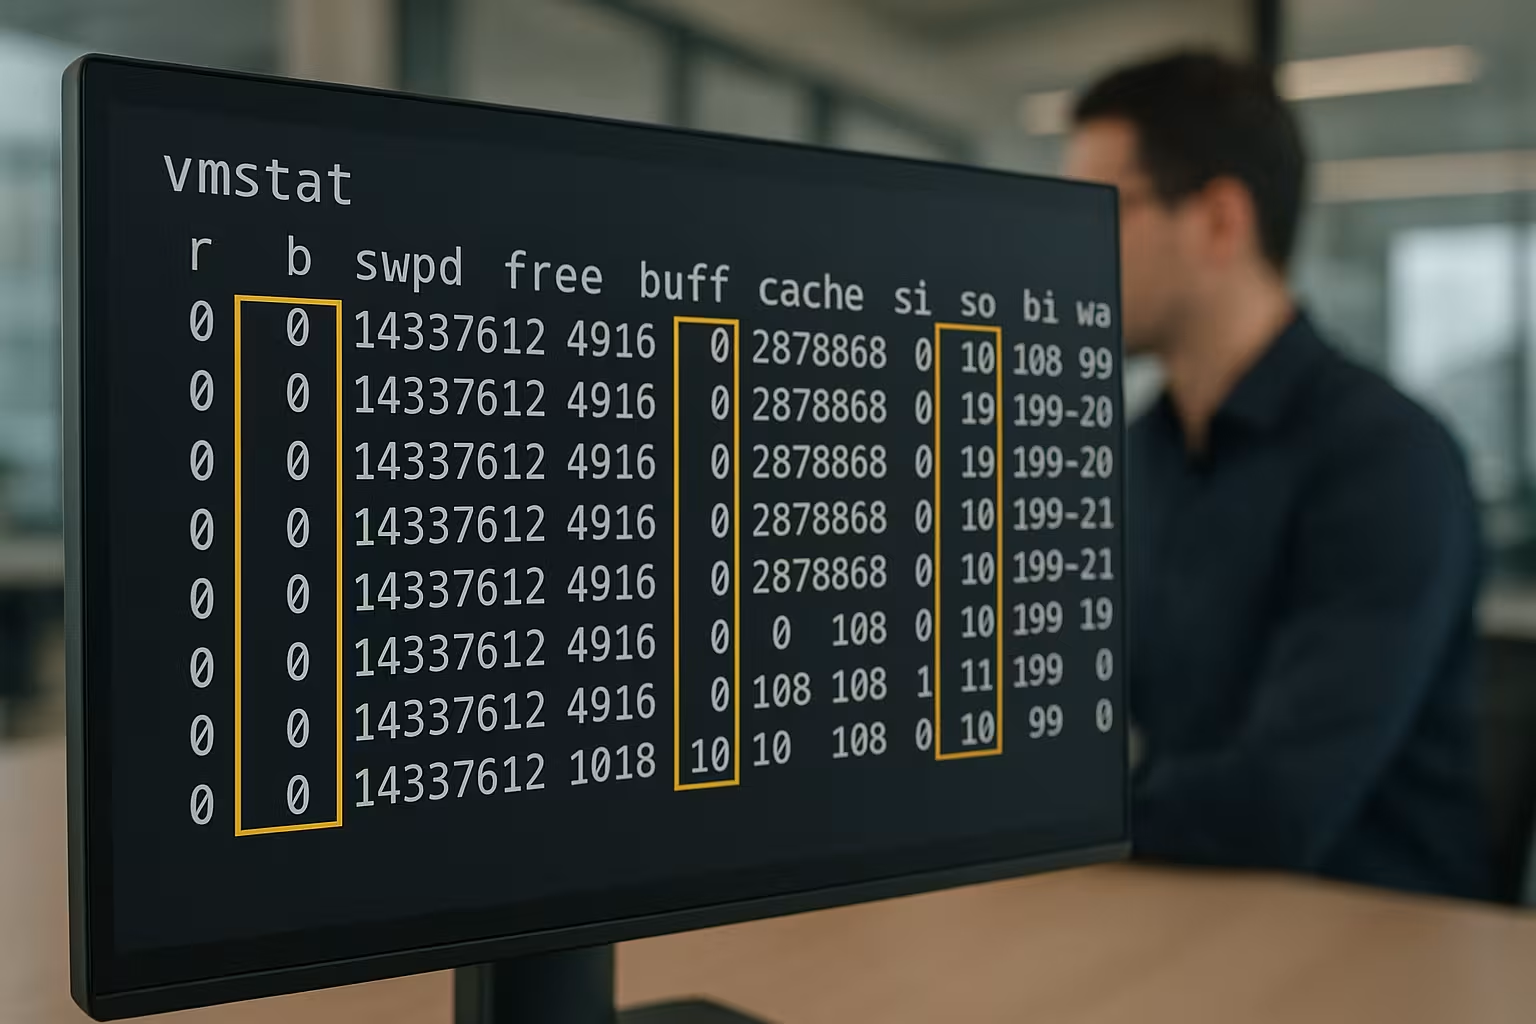
С помощью bi/bo я определяю скорость чтения и записи в блоках в секунду, но без контекста я не даю ей оценки; решающую роль играет взаимодействие с wa. Высокие значения bi/bo и одновременно высокий показатель wa свидетельствуют о том, что система хранения не справляется. Если высокий показатель bi наблюдается в базе данных, я проверяю профили запросов и количество попаданий в кэш, прежде чем заменять оборудование. Для более глубокого анализа таймингов я использую iostat и анализирую длину очередей и задержки, чтобы Анализ ожидания ввода-вывода и целенаправленно устранять узкие места. Только когда wa останется на низком уровне, а bi/bo стабильно взлетит, я задумаюсь о Масштабирование системы хранения.
Доли процессора: us, sy, id, wa, st
Высокие значения us при низком значении wa свидетельствуют о высокой производительности полезной работы, тогда как высокие значения sy указывают на значительные накладные расходы ядра, например, бесчисленное количество мелких операций ввода-вывода или большое количество Изменение контекста. Если id близок к 0 и остается на этом уровне, процессор работает на пределе своих возможностей; в сочетании с высоким значением r это свидетельствует о высокой вычислительной нагрузке. Если wa растёт, процессор ожидает операции ввода-вывода — в этом случае точная настройка системы хранения данных часто даёт больший эффект, чем модернизация процессора. В виртуальных машинах я обращаю внимание на st (steal): высокие значения st указывают на то, что гипервизор отвлекает время процессора, поэтому я обсуждаю с оператором загрузку хоста. Я всегда оцениваю us+sy как сумму, поскольку она показывает активную Труд в системе.
Краткое руководство: столбцы и ориентировочные значения
Следующую таблицу я использую в качестве краткой памятки, когда анализирую вывод команды vmstat для первоначального Оценка прочитать по диагонали.
| Колонка | Значение | На что я обращаю внимание |
|---|---|---|
| r | Активные темы | Постоянные > Ядра → Нагрузка на процессор |
| b | Заблокированные ветки | Постоянное значение > 0 + wa в возвышенном состоянии → проблема с вводом-выводом |
| бесплатно | Бесплатная оперативная память | Низкое значение допустимо, пока si/so остается ≈ 0 |
| буфер/кэш | Буфер FS/Кэш страниц | Большой объем кэша — это хорошо; можно публиковать стать |
| си/со | Обмен (вход/выход) | Постоянное > 0 → фактическое давление в накопителе |
| bi/bo | Блочный ввод-вывод | Критическое значение имеет только в том случае, если wa одновременно высокое |
| us/sy | Пользователь/ядро | us+sy постоянно > 80% → высокий Загрузить |
| id | холостой ход | Значение близко к 0 во времени → процессор перегружен |
| wa | Ожидание ввода-вывода | Высокий уровень с b → Причина — хранение данных |
| ул. | Украсть (виртуальные машины) | Высокий → Гипервизор принимает CPU-время |
Базовые показатели и постоянный мониторинг
Я не полагаюсь на отдельные моментальные снимки, а сравниваю показатели с базовыми значениями, зафиксированными в спокойные периоды, чтобы четко выявить аномалии узнайте. Команда „vmstat 1 60“ выдает мне профиль нагрузки за минуту, который я сравниваю с известными нормальными показателями. Для анализа исторических данных я использую Мониторинг sar/sysstat, чтобы анализировать динамику в течение нескольких дней и уточнять пороговые значения. Я настраиваю оповещения с запасом: r относительно Kernen, si/so не равно 0 в течение нескольких интервалов, wa заметно повышен. Таким образом, я реагирую на проблему на ранней стадии, до того как пользователи сообщат о задержках и до того, как Пик-этапы переходят в более серьезную стадию.
Vmstat в сочетании с другими инструментами
Я начинаю с vmstat, делаю выводы на основе наблюдаемых закономерностей, а затем целенаправленно углубляюсь в анализ с помощью iostat, mpstat, pidstat или метрик приложений, чтобы выяснить причины прояснить присваиваю. vmstat показывает время ожидания ввода-вывода, а с помощью iostat я измеряю задержки и длину очередей для каждого устройства. Если r указывает на ограничение ядра, то mpstat показывает асимметрию ядер. При пиковой нагрузке на процессы обеспечивается pidstat — анализ процессов самые оживлённые темы о времени. Только корреляция с логами и временными показателями приложения позволяет составить более полную картину и привести меня к истинной Причина.
Распознавать закономерности и действовать
Если я вижу, что показатель r высокий, id низкий, а wa умеренный, то приложение часто оптимизируется с чрезмерной вычислительной нагрузкой, поэтому я проверяю код или параллелизм и планирую ресурсы ЦП, прежде чем Оборудование требую. Если показатели b, wa и bi/bo одновременно высокие, я рассматриваю возможность настройки хранилища, оптимизации запросов и кэширования. При низком значении free с si/so больше 0 я снижаю потребление памяти, использую потоковую передачу результатов или увеличиваю объем ОЗУ. Если показатели us умеренные, а sy очень высокие, я проверяю пакетные фильтры, параметры файловой системы или драйверы. С помощью этого чек-листа я действую оперативно и направляю время туда, где оно наиболее считает.
Как избежать ошибок измерения: выборка, единицы измерения, первая строка
Я сознательно не использую первую строку для обнаружения острых сбоев, поскольку она усредняет данные с момента загрузки и полностью сглаживает пики. Кроме того, я выбираю частоту опроса исходя из гипотезы о причине: пики загрузки ЦП я фиксирую с интервалом в 1 секунду, медленные утечки памяти — с интервалом 5–10 секунд. Я обращаю внимание на единицы измерения: si/so — это КБ/с, bi/bo — „блоки/с“ (исторически 1 КБ на блок, может варьироваться в зависимости от версии vmstat). Я проверяю, позволяет ли команда „vmstat -w“ (расширенный вывод) избежать обрезания столбцов и влияют ли изменения тактовой частоты (P-состояния, Turbo) на краткосрочное восприятие нагрузки. Я синхронизирую измерения с пиковыми нагрузками приложений, а не слепо ориентируюсь на „целые минуты“.
Расшифровка системного раздела: in и cs
Помимо показателей procs/memory/swap/io/cpu, vmstat также отображает показатель „system“: на сайте (прерываний в секунду) и cs (переключения контекста в секунду). Эти два показателя дают мне много информации о накладных расходах ядра.
- cs очень высокий при умеренной нагрузке: колебания потоков, слишком маленькие пакеты рабочих процессов или конфликты блокировок. Я увеличиваю размер пакетов, регулирую степень параллелизма (пулы потоков) и проверяю «горячие точки» планировщика и мьютекс.
- резкий скачок: шквал сетевых или хранилищных прерываний, эффекты NAPI/опроса или прерывания таймера. Я сравниваю эти данные с долей sy и результатами iostat, чтобы проверить драйверы или сетевые пути.
- cs пропорционально r: это указывает на постоянную нагрузку, связанную со сменой контекста, из-за чрезмерного параллелизма. Я ограничиваю активный параллелизм или привязываю «горячие» потоки к ядрам.
Я всегда соотношу показатели in/cs с sy и b/wa: только в совокупности можно получить чёткое представление о том, является ли работа ядра полезной (например, пропускная способность) или представляет собой чистое наложение.
Полезные варианты и параметры команды vmstat
Я гибко использую vmstat, чтобы получить дополнительные точки зрения без смены инструмента:
- vmstat -s: Счетчики сумм (например, процессы, запущенные с момента загрузки, основные и второстепенные сбои страниц). Идеально подходят для сравнения утечек или количества сбоев за определенные временные интервалы.
- vmstat -m: Использование Slab — помогает классифицировать кэши ядра (Dentry/Inode, сеть) как потребителей оперативной памяти.
- vmstat -d: События диска на уровне сумм. Не заменяет iostat, но хорошо подходит для быстрой проверки реальной ситуации.
- vmstat -S M: Переключить единицы измерения (М/К), чтобы числа было легче читать.
- vmstat -w: Более широкие столбцы позволяют избежать обрезания при отображении длинных столбцов цифр.
Я сочетаю эти варианты с короткими интервалами, чтобы не пропустить важные события и при этом не терять обзор ситуации.
Контейнеры, виртуальные машины и cgroups: особенности
В контейнерах я осторожно интерпретирую данные vmstat: многие данные ядра относятся ко всему хосту, а ограничения задаются Cgroups. Высокие значения r в контейнере отражают ситуацию в пространстве имён, но реальное время процессора может быть ограничено квотами CPU или долями CPU. Я исхожу из ул. (Steal) в виртуальных машинах: высокий показатель st означает, что гипервизор отнимает у меня время — в таком случае даже идеальная оптимизация приложения мало поможет, пока хост перегружен. При ограничениях памяти в Cgroups может не произойти ни того, ни другого, хотя контейнер „барахтается“ на пределе (OOM-Kills вместо свопа). Поэтому я дополнительно проверяю журналы OOM и статистику Cgroup, а также сверяю снимки vmstat с установленными ограничениями.
NUMA и аффинность: когда локальность имеет значение
На хостах NUMA я проверяю показатели r и us/sy для каждого ядра (с помощью mpstat) и наблюдаю, не „перегреваются“ ли отдельные сокеты, в то время как другие простаивают. Неоптимальная локальность памяти приводит к увеличению показателей cs/sy и b/wa из-за удаленных обращений к памяти. Я тестирую аффинность процессора и памяти (cpuset, numactl), настраиваю большие кучи в режиме „interleaved“ или «strictly local» и слежу за тем, чтобы «горячие» потоки выполнялись там, где находится их «след данных». Стабильная NUMA-структура сглаживает показатель cs, уменьшает выбросы показателя wa и повышает Планируемость под нагрузкой.
Как избежать неправильного толкования: wa и b — это не просто „медленные носители данных“
Показатель wa растет не только при классических задержках диска: на него также влияют NFS/сети с высокой задержкой, перегруженное объектное хранилище, блокирующие облачные тома или медленные операции записи в кэш страниц. b учитывает задачи, находящиеся в состоянии непрерывного сна (D-State) — к ним относятся также зависания в драйверах, сетевых путях или блокировках файловой системы. Поэтому я никогда не оцениваю wa/b в отрыве, а всегда вместе с bi/bo и временными показателями приложений. Если wa высокий, а bi/bo низкие, то часто это указывает на Зависимость от ожидания помимо чистого вопроса пропускной способности устройств (например, блокировка, удаленный ввод-вывод, затор при записи с отложенной обработкой).
Тюнинг с учетом разумных пределов: Swappiness, Writeback, Scheduler
Я изменяю настройки Kernel-Tuner только после проведения измерений и при наличии плана отката:
- vm.swappiness: Низкое значение снижает активность проактивного свопинга, что хорошо для приложений, чувствительных к задержкам, — слишком низкое значение может увеличить нагрузку на кэш страниц.
- vm.dirty_background_ratio / vm.dirty_ratio (или *_bytes): влияют на моменты записи с отложенной фиксацией. Слишком высокие значения приводят к длительным всплескам записи (пики wa), слишком низкие — к увеличению количества постоянных мелких операций очистки (рост sy/bo).
- Планировщик ввода-вывода/Глубина очереди: На NVMe используются другие настройки Optima, чем на HDD/RAID. Перед внесением изменений я измеряю компромиссы между задержкой и пропускной способностью с помощью iostat.
- Пути в сети: Множество мелких пакетов/прерываний поступает в /cs/sy. Основными параметрами настройки являются GRO/LRO, RPS/RFS, IRQ-Affinity — я провожу измерения до и после.
Моя цель — стабильные и предсказуемые кривые в vmstat: us/sy должны быть более ровными, wa/b — ниже, а si/so — близки к 0. Только после этого я наращиваю мощность оборудования.
Руководство: 3-минутный анализ с помощью vmstat
- 0:00–0:30 — „vmstat 1 30“: пропустить первую строку, затем проанализировать r/b, us/sy/id/wa. Вопрос: ограничение по ЦП (r высокое, id низкое) или ограничение по вводу-выводу (b/wa высокие)?
- 0:30–1:00 — Проверка показаний накопителя: проверить swpd и si/so. si/so постоянно > 0? → реальное давление в накопителе. Показатель free не имеет значения.
- 1:00–1:30 — Контекст ввода-вывода: bi/bo против wa. Высокие значения bi/bo без wa? → Ввод-вывод отключается. Высокие значения wa при умеренных значениях bi/bo? → Задержка/блокировка/удаленный ввод-вывод.
- 1:30–2:00 — секция «system»: соотношение in/cs к sy. cs очень высокое? → Проверить давление смены контекста, параллелизм/блокировку.
- 2:00–3:00 — уточнить гипотезу и выбрать соответствующий инструмент: iostat для показателя ввода-вывода, mpstat для асимметрии ядра, pidstat для «горячих точек» процессов. Только после этого приступать к настройке/масштабированию.
Расширенные примеры из практики
- Насыщение ЦП без высоких значений r: us+sy при 90%+, id ≈ 0, но r умеренное → однопоточный «горячий» участок или проблема аффинности. Решение: параллелизировать «горячий» путь, проверить фиксацию ядра.
- Своп-трэш: в любом случае одновременно значительно > 0, b/wa растут, us падает → ОЗУ явно недостаточно или размер кучи выбран неверно. Меры: увеличить объем ОЗУ, уменьшить рабочий набор, настроить параметр swappiness.
- Накладные расходы ядра: sy высокий, cs/in высокий, us умеренный → много мелких системных вызовов/операций ввода-вывода. Решение: обработка пакетами, сокращение количества системных вызовов, проверка опций монтирования файловой системы.
- Затор в системе списания: высокий уровень wa, высокий уровень bo, короткие волны → слишком высокие значения параметра «dirty», колебания задержки хранения. Проверить настройку механизма отложенной записи (Writeback) и планировщик ввода-вывода.
- Давление виртуализации: st виден, r колеблется, id „скачет“ → хост делит ЦП. Решение: проверить распределение/размещение виртуальных ЦП, уменьшить степень перегрузки.
Ознакомьтесь с ограничениями vmstat
Vmstat — это отличная Датчик раннего предупреждения, но не микроскоп. Он показывает мне, что и где не работает — но не конкретный файл, запрос или поток. Поэтому после диагностики с помощью vmstat я последовательно перехожу к более глубоким инструментам, проверяю гипотезы с нескольких сторон, а затем изменяю только по одному параметру за раз. Так улучшения остаются измеримыми и воспроизводимыми.
Резюме из практики
С помощью vmstat я могу за считанные секунды определить, что именно тормозит систему — процессор, оперативная память, область подкачки или ввод-вывод — путем анализа взаимодействия параметров r, b, si/so, bi/bo и us/sy/id/wa/st читать. Я анализирую тенденции, а не отдельные значения, сравниваю с базовыми показателями и, при необходимости, использую iostat, mpstat, pidstat, а также исторические данные. При возникновении острого сбоя я игнорирую первую строку и сосредотачиваюсь на последующих строках с фиксированной частотой опроса. Я принимаю решения на основе данных: r относительно ядер, si/so постоянно отличаются от 0, wa устойчиво повышен, us+sy близки к полной загрузке. Таким образом, я быстро определяю конкретные меры и поддерживаю системы в работоспособном состоянии реактивный.


