 Перейти к содержимому

Отчеты CloudLinux позволяют мне четко увидеть, какие ограничения LVE затрагивают отдельные учетные записи и где именно процессор, память, ввод-вывод или входные процессы действительно тормозят работу. Я целенаправленно анализирую эти данные, чтобы выявлять повторяющиеся сбои, суточные закономерности и острые узкие места и на их основе разрабатывать конкретные меры по оптимизации.
Центральные пункты
Я заранее обобщу следующие ключевые моменты, чтобы ты мог сразу приступить к анализу.
- Показатели LVE правильно читается: SPEED, MEM, IO, IOPS, PNO, EP
- Данные в реальном времени проверить с помощью LVE Manager и lvetop
- Ход событий через lveinfo, lvechart, cloudlinux-statistics
- Неисправности определить приоритеты: частота, время, причина
- Меры вывести данные для ЦП, ОЗУ, ввода-вывода, EP
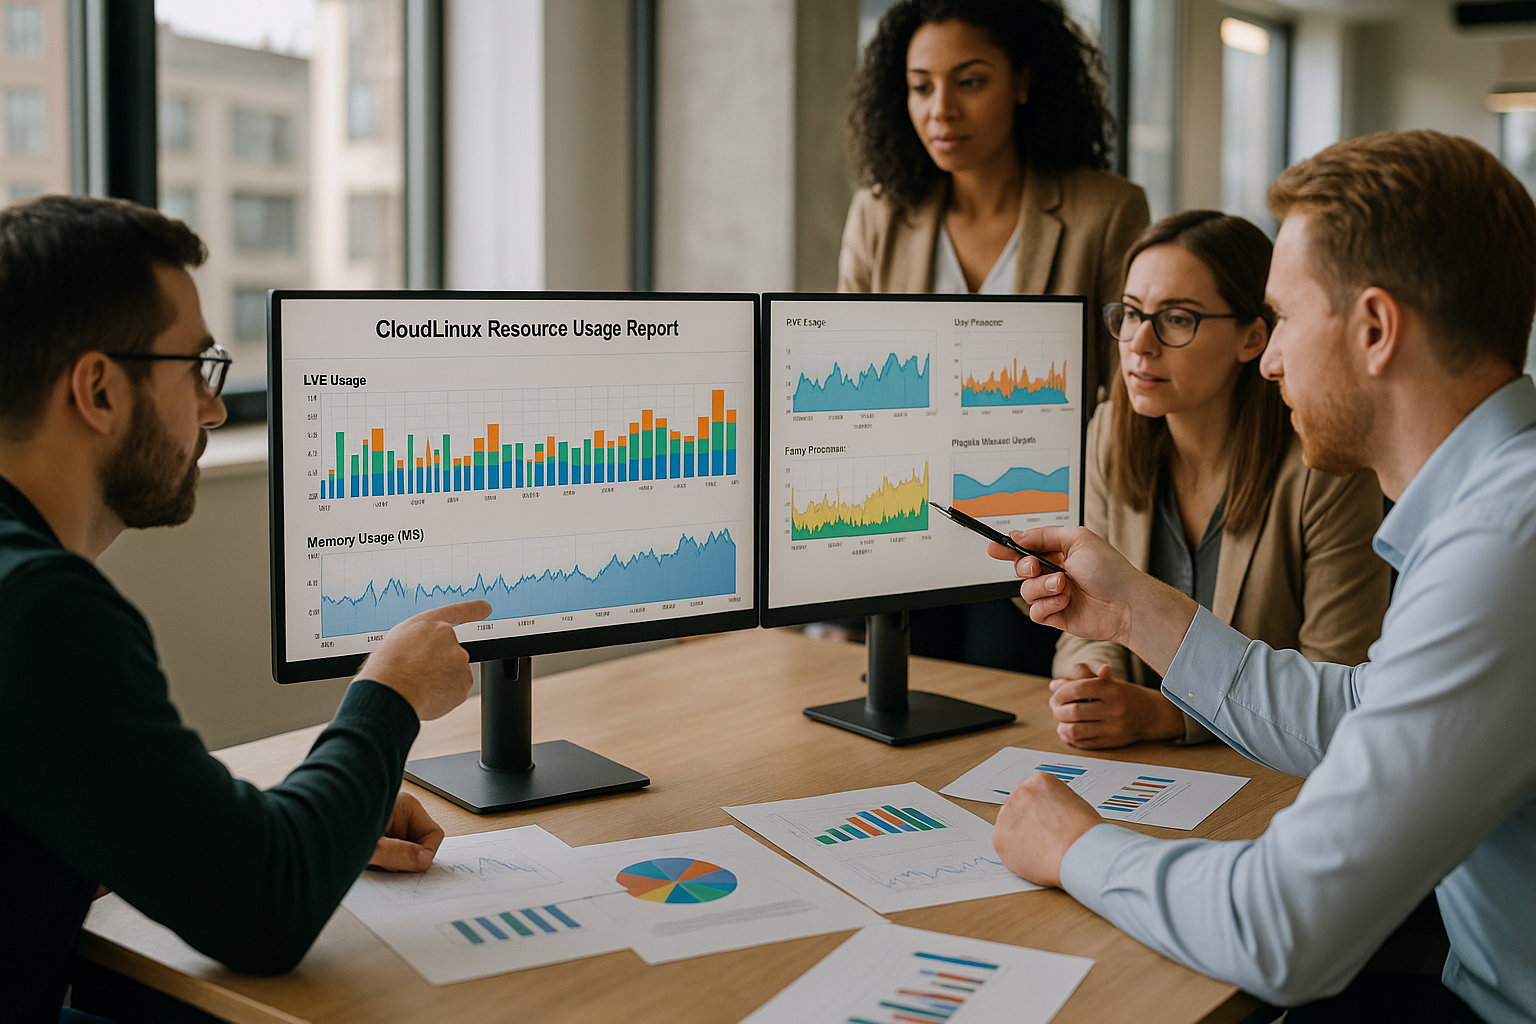
Как правильно интерпретировать ключевые показатели: SPEED, MEM, IO, IOPS, PNO, EP
Я начинаю каждый анализ с Основные показатели, которые CloudLinux отображает в контексте LVE. SPEED описывает выделенную вычислительную мощность ЦП, MEM обозначает потребление оперативной памяти, IO — пропускную способность данных, а IOPS — количество операций ввода-вывода. PNO показывает общее количество запущенных процессов, EP — одновременные входные процессы, ограничивающие доступ к веб-ресурсам. Если вы постоянно наблюдаете высокие значения, то, как правило, речь идет не о кратковременных пиках, а о структурном профиле нагрузки. При этом я всегда проверяю, достигаются ли лимиты постоянно или же возникают лишь единичные всплески, которые можно объяснить без необходимости ограничения пропускной способности.
| Ключевая фигура | Значение | Типичные симптомы | Первые проверки |
|---|---|---|---|
| SPEED | Производительность ЦП (доля/ограничение) | Длительное выполнение PHP, таймауты | Проверить профили PHP, кэш опкодов и кэширование |
| MEM | Объем оперативной памяти на одну учетную запись | Убийства OOM, 500-ошибки под нагрузкой | Проверка параметра memory_limit в PHP, плагинов и запросов |
| IO | Пропускная способность в МБ/с | Медленная скорость загрузки/выгрузки | Статический кэш, сжатие мультимедиа, хранение данных |
| IOPS | Количество операций ввода-вывода | Задержки при обращении к базе данных/файлам | Индексы, план запроса, кэш объектов |
| PNO | Общие процессы | Повышенная нагрузка на сервер | Избыточные процессы daemon/cron, ограничения на количество рабочих процессов |
| EP | Одновременные входы в систему через веб-интерфейс | Ошибка 503 в Peaks | Проверка HTTP-кеша, ограничений скорости и ботов |
Мониторинг в режиме реального времени с помощью LVE Manager и lvetop
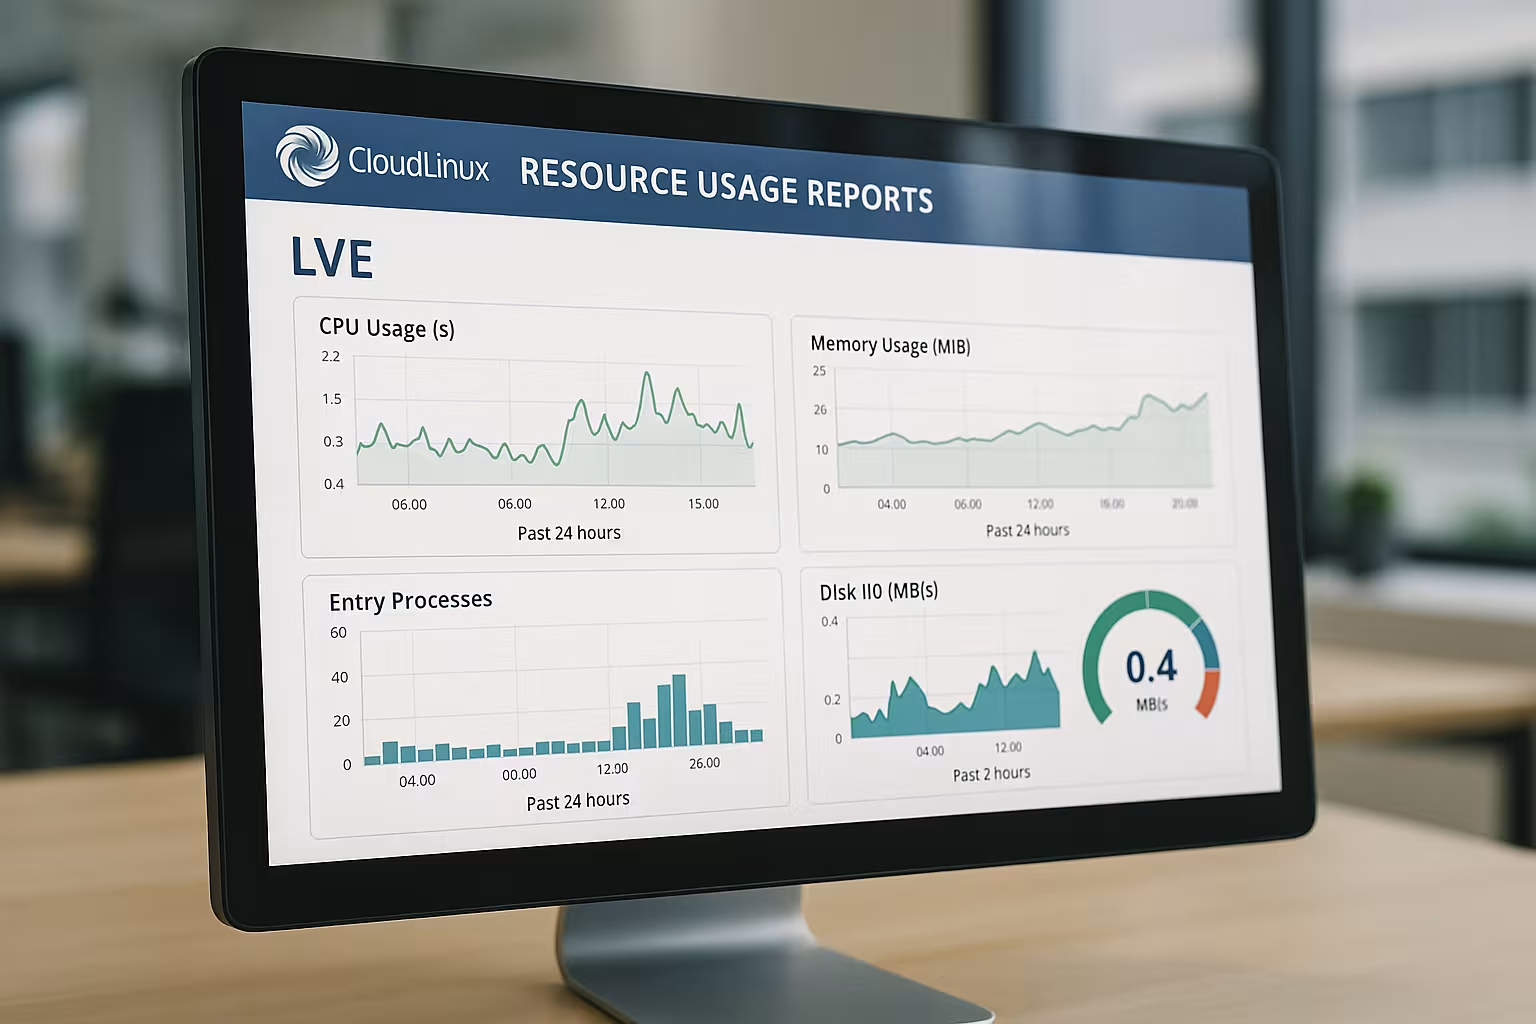
Для оперативного анализа я использую Данные в реальном времени в LVE Manager и lvetop в командной строке. В окне «Current Usage» я вижу в режиме реального времени, как работают ЦП, ОЗУ, ввод-вывод, IOPS, процессы и входные процессы. При пиках нагрузки я слежу за тем, что достигает предела первым — EP или SPEED, — поскольку это влияет на последующие действия. lvetop подходит для того, чтобы сразу отфильтровать самые «шумные» учетные записи и, в случае необходимости, ограничить их или оптимизировать. Те, кто хочет глубже изучить интерфейс, могут целенаправленно настраивать ограничения и представления — я для этого с удовольствием использую это руководство: Настройка LVE Manager.
Исторический анализ: lveinfo, lvechart и cloudlinux-statistics
Я распознаю тенденции с помощью Ход событий и историю сбоев, а не только моментальные снимки. С помощью lveinfo я выделяю временные интервалы и вижу, когда именно срабатывали лимиты и как часто это происходило. lvechart предоставляет мне визуальные пики за часы или дни, благодаря чему становятся заметны суточные паттерны. cloudlinux-statistics дополняет анализ, когда мне нужны более длительные временные ряды по каждому аккаунту. Благодаря этому сочетанию я получаю ответы на вопросы „когда“, „как часто“ и „при каких условиях“ возникают нагрузки.
Понимание и приоритизация неисправностей
«Fault» означает: Это Ограничение было зафиксировано, и CloudLinux ограничил пропускную способность. Поэтому я сортирую сбои сначала по частоте, затем по типу ресурса и времени суток. Ежедневные сбои EP в обеденное время часто указывают на пики трафика или ботов, тогда как ночные сбои RAM чаще связаны с cron-задачами и резервным копированием. Если часто возникают сбои CPU, я ищу неэффективные PHP-процедуры, неисправные кэши или задачи, не подвергающиеся ограничениям. Такая классификация экономит время, поскольку позволяет мне проводить оптимизацию именно там, где пользователи ощущают заметные ограничения.
Выявление причин: типичные схемы и меры противодействия
Исходя из опыта, я классифицирую Образец быстро выявляет конкретные причины. Стабильно высокие значения EP указывают на слишком большое количество одновременных запросов или отсутствие кэширования на периферии. Постоянно высокое потребление ОЗУ часто свидетельствует о наличии плагинов, тем или процессов с утечкой памяти. Пиковые значения IO и IOPS указывают на задачи с интенсивной обработкой данных, неиндексированные запросы или большое количество мелких обращений к файлам. Чтобы избежать неверных интерпретаций, я параллельно проверяю показатели работоспособности системы — быстро ознакомиться с ними можно с помощью Проверки работоспособности CloudLinux.
Обнаружение cron-задач, резервных копий и ботов
Многие серии ошибок можно объяснить, если взглянуть на Точки во времени и задачи. Если ограничение пропускной способности возникает всегда вскоре после начала часа, это часто означает, что параллельно выполняются задания cron, которые конкурируют с посетителями. Периодические пики ночью часто указывают на резервное копирование, которое исчерпывает ресурсы ввода-вывода и IOPS. Заметные EP-ошибки без соответствующего трафика в аналитике часто указывают на ботов или скрейперы, которые обходят статический контент. В таких случаях я устанавливаю ограничения скорости, переношу задания на менее загруженные периоды и последовательно активирую кэши на периферии или страничные кэши.
Анализ данных по каждому реселлеру и учетной записи
В более крупных конфигурациях я разделяю Уровни Четко: реселлеры, их клиенты и отдельные учетные записи. LVE Manager позволяет получить именно такой обзор и показывает, какой поддерево влияет на лимиты. Так я могу определить, вызывает ли подозрение отдельный клиент или же на лимиты одновременно давят несколько проектов в структуре реселлера. Для процессов поддержки я отмечаю затронутые учетные записи и задаю меры, чтобы быстрее решать повторяющиеся запросы. Такая прозрачность помогает справедливо распределять ресурсы и обеспечивать прозрачность затрат по каждому клиенту.
Правильно рассчитать предельные значения и скорректировать тарифы
Я устанавливаю ограничения Реалистичный, а не максимальные. Слишком узкие границы EP приводят к ошибкам 503, в то время как слишком низкие значения SPEED замедляют каждый ответ PHP. Если вы регулярно сталкиваетесь с сбоями, сначала проверьте возможности оптимизации, а затем — тарифные планы. Если проекты становятся критически важными для бизнеса, стоит выбрать более высокий профиль, который сглаживает пики нагрузки и обеспечивает стабильность. Я фиксирую результаты в графиках динамики, чтобы решение оставалось обоснованным.
Проекты с интенсивным использованием баз данных: оптимизация операций ввода-вывода (I/O) и операций ввода-вывода в секунду (IOPS)
В случае сайтов, построенных на базе данных, я проверяю IOPS а IO всегда зависит от качества запросов. Множество мелких запросов без индексов генерирует высокие показатели IOPS и ухудшает время отклика. Как показывает опыт, объектный кэш, кэширование запросов и оптимизированные индексы значительно сокращают этот поток. Для анализа тенденций я дополнительно изучаю отчёты базы данных и сверяю их с динамикой показателей LVE. Этот руководство по Отчеты MySQL Governor, чтобы правильно классифицировать нагрузку на БД.
Руководство по мониторингу: от сигнала тревоги до действий
На основе измеренных значений я формирую Справочник, который четко отображает каждую эскалацию. Шаг 1: Проверить в режиме реального времени, действуют ли в данный момент ограничения и какой ресурс выходит из строя первым. Шаг 2: Открыть историю, сопоставить временные интервалы и отметить повторения. Шаг 3: Определите причину — путь выполнения кода, кэш, БД, Cron, бот — и определите меры по устранению с критериями тестирования. Шаг 4: После вмешательства снова проверьте в режиме реального времени и по истории, снизились ли количество сбоев и задержки. Такая четкая последовательность действий позволяет избежать хаотичных действий и обеспечивает воспроизводимые результаты.
Правильно интерпретировать взаимосвязи между пределами
На практике ограничения редко действуют изолированно. Поэтому я оцениваю Взаимодействия между EP, SPEED, MEM и IO/IOPS: если EP и SPEED растут одновременно, то ограничивающим фактором обычно становится ЦП на один запрос; в этом случае помогает кэш страниц или кэш на границе, и тогда оба показателя снижаются одновременно. Если я наблюдаю повышенный показатель EP при стабильно низком показателе SPEED, это означает скопление запросов на веб-сервере, часто из-за нехватки рабочих процессов, настроек Keep-Alive или блокирующих внешних вызовов (например, API, почта). Ошибки MEM при умеренном значении SPEED указывают на небольшое количество процессов, но требующих большого объёма памяти (например, конвертация изображений, крупные экспорты). Пиковые значения показателей IO/IOPS без заметной нагрузки на ЦП указывают на интенсивный доступ к файлам или базам данных. Эти корреляции я использую для первая гипотеза прежде чем углубляться в детали кода или сервера.
Практика: эффективное использование lvetop, lveinfo и cloudlinux-statistics
Для быстрого получения результатов я работаю с прозрачными Запросы и фильтрации. lvetop позволяет мне с интервалом в одну секунду отслеживать основных потребителей ресурсов и переключаться между сортировкой по CPU, MEM или IO. С помощью lveinfo я создаю окна длительностью 1 час, 24 часа и 7 дней, чтобы составить список моментов возникновения сбоев, пиковых значений и затронутых ресурсов для каждой учетной записи. cloudlinux-statistics предоставляет мне более длительные временные ряды и подходит для подтверждения эффективности принятых мер (до и после). При каждом вмешательстве я всегда документирую: период времени, затронутые аккаунты, максимальные значения по каждому ресурсу, количество сбоев, а также время отклика, полученное из мониторинга приложений или веб-сайтов. Это позволяет мне подтверждать эффективность оптимизаций и предотвращать ослабление ограничений „наобум“.
Тонкости веб-стека: обработчики PHP, рабочие процессы и OPcache
Одним из важных рычагов является Выполнение PHP: Количество PHP-рабочих процессов на каждый аккаунт, их бюджет оперативной памяти (memory_limit) и OPcache. Слишком много рабочих процессов без кэша увеличивают показатели EP/PNO и MEM, а слишком мало — приводят к скоплению запросов (EP растет, время отклика увеличивается). Поэтому я ищу «золотую середину»: столько рабочих процессов, сколько необходимо, и как можно меньше. OPcache должен быть достаточно размерен (память и интернированные строки), иначе PHP будет постоянно перекомпилироваться и ухудшать показатель SPEED. Кроме того, я проверяю, действительно ли статические ресурсы обслуживаются веб-сервером (а не PHP) и правильно ли работают Keep-Alive и мультиплексирование HTTP/2. Цель — динамические запросы уменьшить и оперативно выполнить оставшиеся задачи.
Последовательное применение стратегий кэширования
Я выделяю три уровня: Пограничный/CDN кэш для снижения глобальной нагрузки, Кэш HTTP/страниц непосредственно перед PHP и Кэш объектов внутри приложения. Кэш Edge значительно снижает EP и IO для статических ресурсов. Кэш страниц сокращает количество динамических обращений и напрямую влияет на показатели EP/SPEED. Объектный кэш (например, для частых запросов к БД) снижает показатели IOPS и загрузку ЦП. Важно обеспечить стабильную Ключ кэша (например, отсутствие ненужных файлов cookie), а также оптимальные значения TTL для каждого типа страницы. Для административной панели и корзины покупок я планирую сделать исключения, во всех остальных случаях стремлюсь к максимально высокой доле кэширования. После активации я наблюдаю: возникают ли EP-ошибки? Сокращается ли медианное время отклика?
Управление оперативной памятью: memory_limit, процессы и утечки
Ошибки MEM часто возникают из-за того, что ограничение памяти задана с запасом, и параллельные процессы превышают этот предел. Поэтому я провожу калибровку: сколько оперативной памяти требуется для типичного запроса? На основе этого я определяю максимально целесообразное количество рабочих процессов. Кроме того, я оптимизирую библиотеки и плагины PHP, удаляю неиспользуемые расширения и проверяю долго выполняющиеся скрипты (экспорт, импорт, обработка изображений) на наличие утечек памяти. OPcache снижает нагрузку на ОЗУ, кэшируя скомпилированные данные, но сам не должен быть слишком мал. При повторяющихся пиковых нагрузках я с помощью профилирования выделяю „затратные“ пути и принимаю целенаправленные меры — это чаще позволяет сэкономить ОЗУ, чем общее увеличение лимитов.
Целенаправленное снижение значений I/O и IOPS
Пиковые значения IO/IOPS возникают из-за большого количества мелких обращений к файлам или базам данных. Я объединяю рабочие нагрузки там, где это возможно: генерация миниатюр в пакетном режиме, а не по требованию; минимизация ресурсов в процессе сборки, а не при каждом запросе; объединение сессионной и временной памяти в одну Кэш объектов перенести во внешнюю память, чтобы сократить количество обращений к файлам. В базе данных я устанавливаю приоритет индексам для часто используемых условий WHERE и JOIN и устраняю запросы N+1. Параллельно я сравниваю графики LVE с отчётами базы данных из MySQL Governor, чтобы выявить «горячие точки». Цель состоит в том, чтобы преобразовать множество мелких операций ввода-вывода (IOPS) в несколько эффективных обращений — это сглаживает пики нагрузки и снижает вероятность сбоев.
Устранение ошибок EP: управление очередями и потоками посетителей
EP ограничивает количество одновременных входов. Если на полупустые кэши поступает много запросов, быстро возникают ошибки EP. Я предотвращаю это, делая следующее: Очереди до внедрения PHP (короткие очереди запросов на веб-сервере), правильно настраиваю параметр Keep-Alive и последовательно кэширую динамические пути, которые не являются персонализированными. Для ботов я устанавливаю ограничения по частоте запросов и заблаговременно блокирую явных злоумышленников. Кроме того, я проверяю вызовы сторонних сервисов в пути запроса — блокирующие внешние сервисы увеличивают время обработки каждого запроса и, таким образом, расходуют EP. По возможности я переношу внешние интеграции в задания/очереди.
Планирование заданий Cron и резервного копирования с минимальным потреблением ресурсов
Повторяющиеся задачи я отделяю от пиковых нагрузок и регулирую их: выравниваю графики Cron (сдвигая их на несколько минут), предотвращаю параллельное выполнение с помощью файлов блокировки и регулирую нагрузку с помощью Нисинг и размеры пакетов. Я планирую резервное копирование на временные интервалы с низкой нагрузкой и использую инкрементные методы, чтобы показатели IO/IOPS оставались в допустимых пределах. Для ресурсоемких заданий внутри приложения я устанавливаю ограничения на количество одновременно работающих процессов, чтобы показатели MEM и SPEED не росли скачкообразно. В ходе работы я проверяю результаты: снижается ли количество ночных сбоев, уменьшаются ли пики нагрузки в начале каждого часа?
CageFS: обзор файловой системы и инодов
Помимо лимитов LVE, влияют Факторы, связанные с файловой системой Производительность: миллионы мелких файлов (например, фрагменты кэша) увеличивают количество обращений к метаданным и повышают показатель IOPS. Я поддерживаю порядок в каталогах кэша, ограничиваю поток файлов за счёт разумной агрегации кэшей и проверяю загрузку инодов. CageFS обеспечивает изоляцию, однако неправильно размещённые временные файлы (например, в корневом каталоге веб-сайта вместо каталога tmp) излишне увеличивают нагрузку на ввод-вывод. Периодическая проверка работоспособности этих областей позволяет избежать ошибочной интерпретации узких мест ввода-вывода как проблем, связанных исключительно с ЦП или оперативной памятью.
Прозрачность и коммуникация в контексте работы реселлеров
В средах реселлеров я документирую Драйвер загрузки по каждому подразделению и фиксирую меры: какие ограничения были введены? Какие меры по оптимизации запланированы? Как выглядят графики «до» и «после»? Такая прозрачность ускоряет получение ответов от службы поддержки и способствует принятию решения о смене тарифного плана, когда потенциал оптимизации исчерпан. Я устанавливаю пороговые значения, при превышении которых мы начинаем действовать (например, повторяющиеся сбои > N в день или медианное время отклика > X мс), и связываю их с четкими алгоритмами действий — это позволяет избежать бесконечных циклов в системе тикетов.
Как избежать распространенных ошибок в интерпретации
Я регулярно замечаю несколько типичных ситуаций: рост нагрузки на процессор — это не автоматически появляется сообщение о „недостатке ресурсов ЦП“ — зачастую кэши не работают или запросы выполняются неэффективно. Множество EP-ошибок не обязательно означает „увеличение трафика“ — причиной могут быть боты, неправильно настроенные инструменты мониторинга или сигналы пульса. MEM-ошибки не всегда можно устранить путем увеличения memory_limit — часто причиной является слишком большое количество одновременно запущенных процессов. Пиковые значения IO/IOPS зависят не только от системы хранения данных — их вызывают особенности работы приложений. Поэтому я всегда проверяю гипотезы с помощью коррелированных графиков и, по возможности, с помощью кратких контрольных тестов (например, включаю кэш для отдельного модуля и повторно анализирую динамику).
Проверка, измерение, доточка
Каждое изменение я оцениваю по шкале четких точек измерения: до/после активации кэша страниц, до/после дополнения индекса, до/после настройки рабочих процессов. Для этого я использую историю LVE, метрики времени отклика и показатели ошибок (5xx/4xx). По возможности я провожу A/B-сравнения в часы низкой нагрузки, чтобы изолировать побочные эффекты. Если ошибки сохраняются, я повторяю процесс: тонко настраиваю комбинации ограничений, профилирую дополнительные «горячие» пути, корректирую размеры пакетов заданий. Опыт показывает: два-три целенаправленных цикла дают значительно лучшие результаты, чем одна крупная, обобщённая мера.
Резюме: Как эффективно читать отчеты об использовании ресурсов CloudLinux
I ставка CloudLinux-Данные всегда представлены в трёх уровнях: в реальном времени, история, сбои. Показатели SPEED, MEM, IO, IOPS, PNO и EP дают мне представление о взаимосвязи причин и следствий. С помощью lvetop я сразу вижу, кто создает нагрузку; с помощью lveinfo и lvechart я фиксирую закономерности в течение нескольких дней. На основании повторяющихся сбоев я определяю необходимость кэширования, оптимизации запросов, корректировки лимитов или смены тарифного плана. Этот метод снижает затраты на техническую поддержку, повышает оперативность реагирования и обеспечивает прозрачность производительности хостинга.


