 Hoppa till innehåll

Jag förklarar kortfattat och utförligt hur Händelse MPM som använder Apache Event Queue för att effektivt hantera många samtidiga HTTP-anslutningar. Här går jag igenom grunderna, händelseslingan, interna köer och konkreta optimeringsåtgärder för en högpresterande Konfiguration.
Centrala punkter
- Evenemangsslinga skiljer på anslutningshantering och bearbetning av förfrågningar
- Keep-Alive blockerar inte längre några trådar
- Händelsekö sorterar socklar efter status
- Parametrar hur man finjusterar MaxRequestWorkers
- Övervakning garanterar en tillförlitlig kapacitetsplanering
Hur Event MPM styr anslutningarna
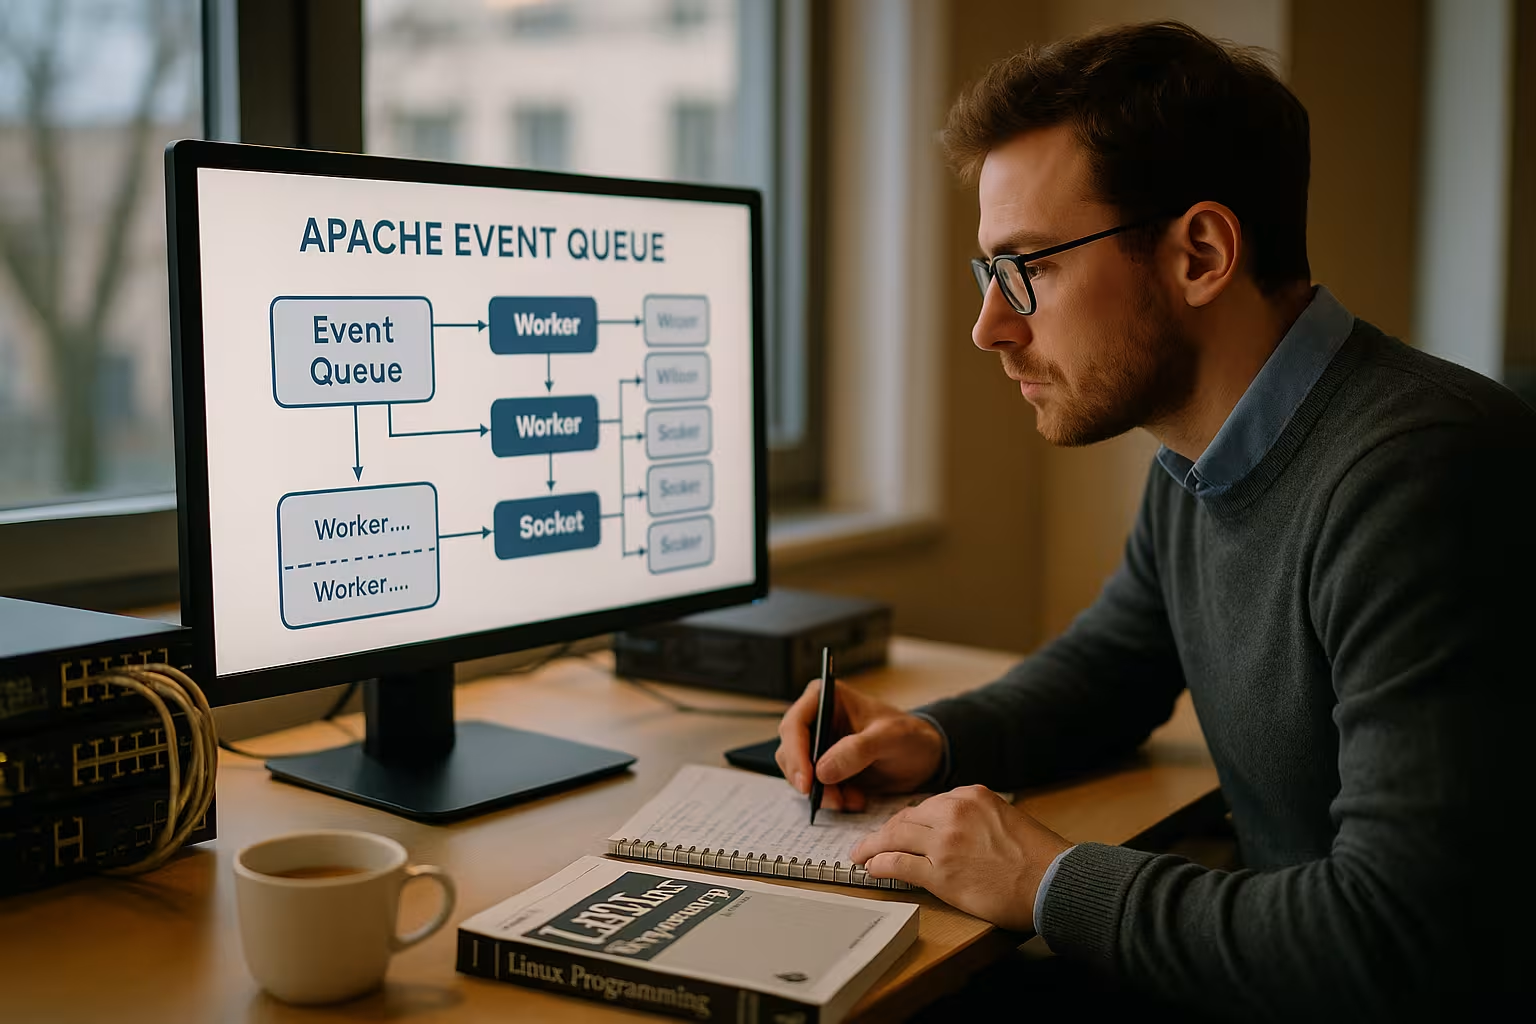
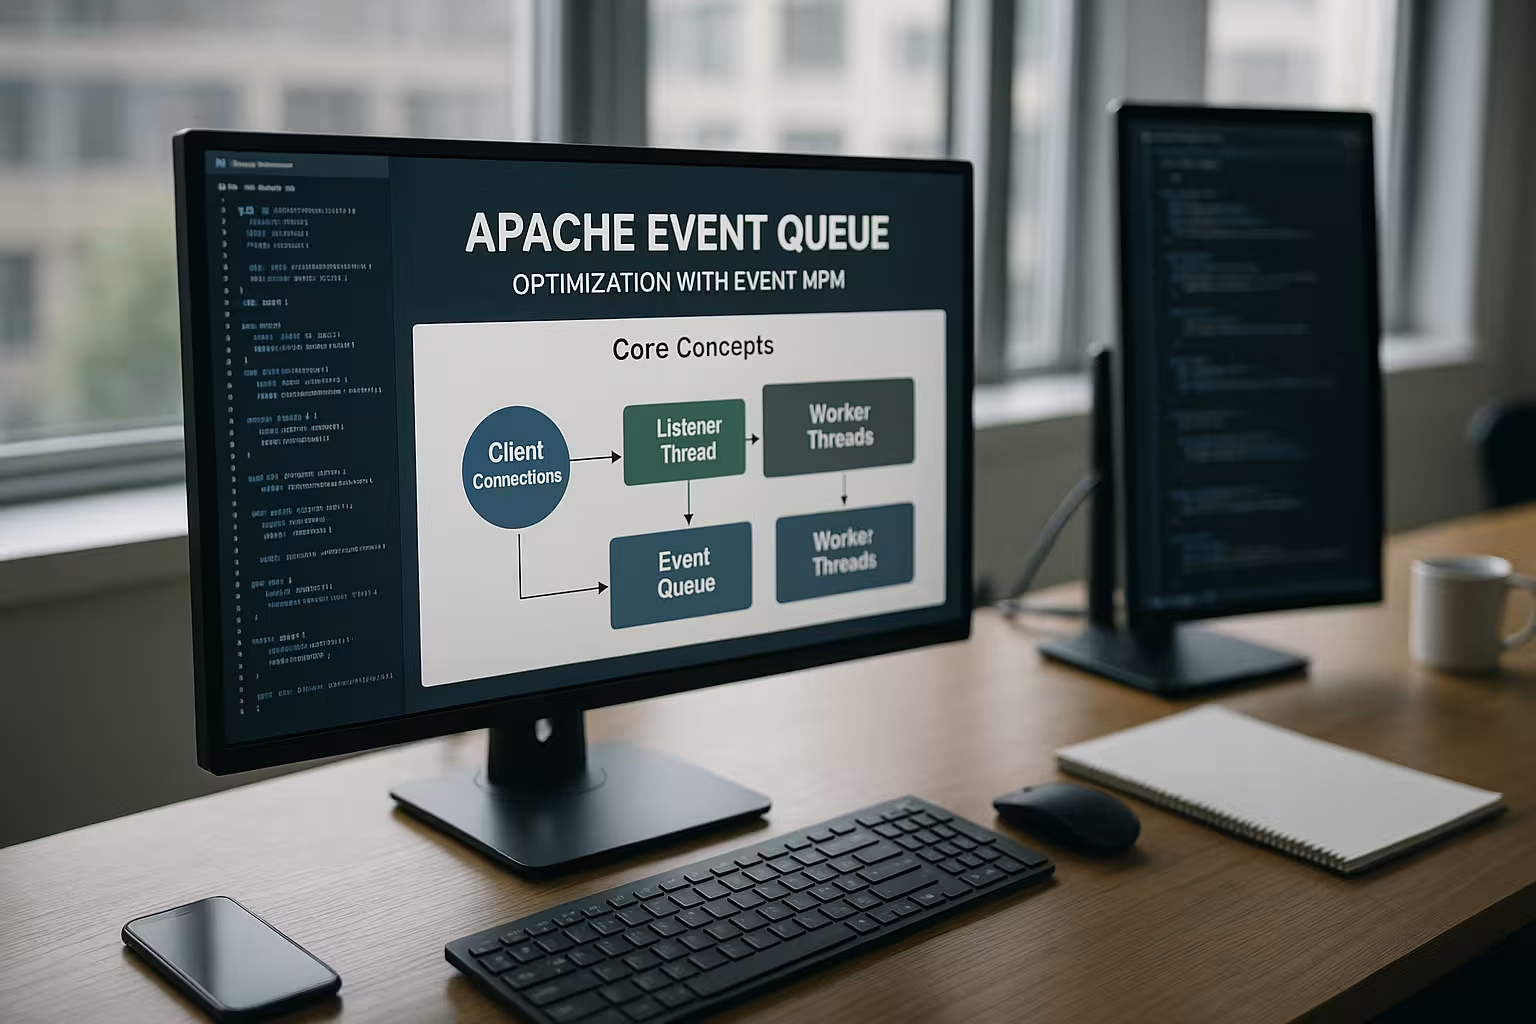
Jag börjar med frågan om hur Apache fungerar under Last hanterar så många anslutningar. Event MPM kombinerar processer och trådar, men prioriterar händelser via en händelseslinga. Lyssnartrådar tar emot nya socklar och övervakar befintliga anslutningar utan att omedelbart blockera en arbetartråd. Först när data är läsbara eller skrivbara överlämnar händelselagret socketen till en ledig arbetartråd. På så sätt förhindrar jag att tomgång-Anslutningar tar upp trådar och slösar bort minne.
Denna uppdelning minskar RAM-belastningen märkbart. Trådar utför främst „verkligt arbete“ som att tolka förfrågningar, generera svar eller hantera proxyserverfunktioner. Därefter återställer händelseslingan socklarna till rätt tillstånd, till exempel tillbaka till Keep-Alive eller till avslutningsfasen. I praktiken ser jag kortare köer vid belastningstoppar, eftersom lediga trådar snabbare blir tillgängliga igen. Arkitekturen ger en tydlig skalande Svarbarhet för typiska HTTP/1.1- och HTTP/2-arbetsbelastningar.
Apache Event Queue i detalj
Händelsekön tilldelar varje anslutning ett tillstånd, och det är just här som Vinst jämfört med klassiska MPM:er. Nya anslutningar hamnar först i en kö som kontrollerar läsbarheten. När data anländer flyttar händelseslingan socketen till en „läsbar“ kö och tilldelar den till en arbetare. Efter bearbetningen avgör statusen återigen: avsluta skrivningen, parkera Keep-Alive eller stänga. Denna cykel förblir smidig eftersom köhanteringen sköts kostnadseffektivt via epoll eller kqueue.
Jag ser ofta missförstånd: Event Queue ersätter inte arbetare, utan samordnar deras Användning effektivare. Trådarna fortsätter att bearbeta förfrågningar, men endast när data faktiskt överförs. Detta sparar på CPU och minne i situationer med många „inaktiva“ keep-alive-anslutningar. Ju renare utformningen av timeout och buffert är, desto mindre är risken att anslutningar befinner sig i resurskrävande tillstånd onödigt länge. På så sätt kan svarstiden hållas konstant även med tusentals öppna socklar.
Keep-Alive-problemet hos klassiska MPM:er
Med HTTP/1.1 förblir anslutningarna ofta öppna för att kunna skicka flera förfrågningar utan en ny handskakning, vilket Fördröjning sparar. Prefork eller Worker reserverar dock processer eller trådar som endast väntar. Vid belastningstoppar blockerar då många keep-alive-anslutningar värdefulla exekveringsresurser. Detta driver upp RAM-förbrukningen och begränsar antalet parallella klienter. Event MPM löser detta genom att Event Queue håller inaktiva socklar utan tråd i ett kostnadseffektivt vänteläge.
På så sätt lägger jag många anslutningar i vänteläge och påbörjar bearbetningen först när det faktiskt behövs. Detta förändrar kapacitetsmodellen: Istället för trådar = anslutningar använder jag trådar = aktivt arbete. I benchmark-scenarier kan jag därmed tillåta betydligt fler öppna anslutningar utan att prestandan försämras Svarstid. För API-backends, WordPress-hosting och stora innehållssajter innebär detta en betydligt jämnare belastning. Fördelarna med Keep-Alive bibehålls utan att trådar blockeras.
Event-MPM kontra Worker-MPM
Jag sammanfattar skillnaderna kortfattat i en Tabell tillsammans. Syftet är att ge en snabb överblick över hantering, resursbehov och typiska användningsområden. Båda varianterna bygger på processer med flera trådar, men Event kopplar Keep-Alive mer sällan till en tråd. Worker fungerar stabilt vid måttlig belastning, medan Event utmärker sig vid många parallella anslutningar. Denna klassificering hjälper dig att fatta välgrundade beslut för din egen miljö. En mer ingående jämförelse finns på Evenemang kontra arbetstagare.
| MPM | Hantering av Keep-Alive | Trådar/processer | Krav på RAM-minne | Lämplig för |
|---|---|---|---|---|
| Prefork | Process fastnar vid tomgång | Endast processer | Hög | Äldre versioner av PHP utan trådsäkerhet |
| Arbetare | Tråd förblir ofta bunden | Processer + trådar | Medium | Måttlig belastning, enkla installationer |
| Evenemang | Evenemangsslinga lagrar tomgångssocklar | Processer + trådar | Låg till medelhög | Många klienter, långa keep-alive-perioder |
Typiska applikationsscenarier
Jag använder Event MPM när det finns många parallella Kunder begära små till medelstora nyttolaster. Bloggar med hög trafik, webbutiker med caching, statiska tillgångar och API-ändpunkter drar märkbar nytta av detta. Detsamma gäller webbhotellkonfigurationer med många webbplatser per server, där Keep-Alive-anslutningar dominerar. Här håller händelsekön antalet aktiva trådar lågt och fördelar arbetet jämnt. Den som använder HTTP/2 drar ytterligare nytta av detta, eftersom en anslutning kan hantera flera strömmar samtidigt som händelselagret koordinerar tillstånden på ett smidigt sätt.
Event visar sina styrkor även i topologier med omvänd proxy. Jag låter Apache hantera SSL-anslutningar, sköta cachelagringen och vidarebefordra förfrågningar till ett applikationslager. Samtidigt förblir anslutningshanteringen lättviktig, vilket minskar risken för flaskhalsar. Även vid trafiktoppar förblir svarstiderna hanterbara, förutsatt att gränserna är klokt inställda. Detta minskar risken för Kö-Köer och tidsgränser.
Konfiguration: Nyckeldirektiv
För att komma fram till en hållbar inställning undersöker jag först ServerLimit, StartServers, ThreadsPerChild och MaxRequestWorkers. Tumregeln: ServerLimit × ThreadsPerChild bör ligga nära MaxRequestWorkers, med en marginal för underhåll och tillväxt. Ett för lågt värde hämmar parallelliteten, medan ett för högt värde ökar RAM-behovet. Jag ställer in KeepAlive på On, men dimensionerar KeepAliveTimeout måttligt så att tomgång inte går överstyr. Värden mellan några få och låga tvåsiffriga sekunder fungerar ofta bra, beroende på trafikprofilen.
Dessutom tar jag hänsyn till timeouts för läsning, skrivning och proxyservrar. Kortare tidsvärden skyddar mot fastnade backend-system, medan längre tidsvärden underlättar vid tröga klienter, vilket Avvägningar krävs. För statiska filer lönar det sig att skicka dem i större block och använda effektiva filterkedjor. Vid användning av PHP via FPM eller proxybalanserare skalar jag backend-arbetare så att de passar frontend-parallelliteten. Jag dokumenterar varje ändring och mäter effekten innan jag går vidare.
Optimering av händelsekön: steg för steg
Jag börjar med en tydlig lastprofil: samtidiga anslutningar, förfrågningar per sekund, svarsstorlekar, andel Keep-Alive-anslutningar. Därefter ställer jag in MaxRequestWorkers så att CPU:n inte går på tomgång, men så att RAM-minnet räcker till med god marginal. Jag justerar ThreadsPerChild tills belastningstoppar hanteras utan väntetid. KeepAliveTimeout kalibrerar jag för att uppnå en bra balans mellan användarupplevelse och resurshushållning. Den som vill förstå köbeteendet på ett djupare plan hittar grundläggande information under Köbildning på webbserver.
Jag utför iterativa tester med verktyg som ab, wrk eller k6 och analyserar latenser i P50, P95 och P99. Samtidigt observerar jag när anslutningarna förblir aktiva (Keep-Alive) och när de stängs. En liten överdimensionering av trådar hjälper till att hantera korta toppar utan att överbelasta maskinen. Samtidigt kontrollerar jag felloggarna för meddelanden som „server reached MaxRequestWorkers“. På så sätt får jag en harmonisk Samspelet mellan händelsekön och arbetarpoolen.
Övervakning och mätetal
Bra mätvärden garanterar en tillförlitlig Kapacitet. Jag aktiverar mod_status och övervakar aktiva, inaktiva och väntande arbetare. Resultattavlan visar om det finns väntande förfrågningar eller om resurser är lediga. Dessutom mäter jag antalet processer och trådar, RAM-utnyttjandet och nätverks-I/O. En visuell utvärdering hjälper till att upptäcka trender och vändpunkter. Mer information finns i Apache Scoreboard.
Jag jämför dessa värden med åtkomstloggar och felkoder. Om 5xx-frekvensen ökar samtidigt som belastningen är full, är gränsvärdena ofta för låga. Om timeouterna ökar kontrollerar jag backend-tjänster, DNS-upplösning och nätverksvägar. Jag tittar även på TCP-backloggar och SYN-återutsändningar vid hög belastning. På så sätt kan jag se om Orsak i webbservern, i backend eller i nätverket.
HTTP/2, omvänd proxy och moduler
HTTP/2 sammanför flera strömmar via en enda anslutning, vilket Evenemang-arkitekturen på bästa sätt. Jag ser till att det finns en balans mellan strömgränser och trådpoolen, så att många små strömmar inte hamnar i köer. Som omvänd proxy drar Apache nytta av korta timeouts och pålitliga backend-anslutningar. Moduler som arbetar på ett starkt blockerande sätt kan dock binda trådar och minska fördelarna. Jag kontrollerar därför kompatibiliteten och byter ut föråldrade komponenter om de orsakar latensspikar.
Cachemoduler och komprimering ökar effektiviteten, förutsatt att CPU-profilerna passar. TLS-optimering med moderna krypteringsalgoritmer och prioritering av HTTP/2 bidrar till snabbare leverans. Jag använder session-resumption och övervakar handskakningskostnaderna under belastning. För statiska tillgångar fungerar zero-copy-metoder och sendfile bra. Den Konst ligger i att hålla kedjan bestående av TLS, händelsekö, arbetare och backend slank.
Interna processer och tillstånd i händelsen MPM
För att förstå de interna processerna tänker jag i termer av tillstånd: accept → läsbar → bearbetning → skrivbar → keep-alive → stäng. Lyssnartrådar övervakar socklar med hjälp av effektiva kärnmekanismer (epoll/kqueue) och väcker arbetartrådar endast när en händelse inträffar. Efter att en begäran har bearbetats avgör händelselagret om anslutningen ska placeras i Keep-Alive-läge, stängas direkt eller avslutas på ett sätt som liknar „lingering close“, så att sena TCP-paket kan bearbetas korrekt. Denna tillståndsautomat förhindrar „busy waiting“ och minimerar kontextbyten.
Det är viktigt att skilja mellan I/O-väntetid och CPU-belastning: Analys av förfrågningar, filterpipelines (t.ex. komprimering) och generering av svar sker i arbetstrådar. Själva väntan på läs- och skrivbehörighet sker fortfarande i händelseslingan. På så sätt utnyttjar Apache de befintliga trådarna bättre och minskar Trådtäthet per öppen anslutning – drastiskt.
Jag tar dessutom hänsyn till beteendet i resultattavlan: I mod_status kan man avläsa faser som „R“ (Reading), „W“ (Sending Reply), „K“ (Keepalive) och „G“ (Gracefully finishing). En hög andel „K“ i kombination med lediga arbetare visar att händelsekön hanteras korrekt och att inga trådar slösas bort. Om „R“-tiderna ökar markant tyder det på att långsamma klienter eller alltför restriktiva läs-timeouts innebär att det finns utrymme för optimering.
Resursplanering: Beräkningsexempel och lämpliga standardvärden
Jag räknar ut Parallellism bestående av CPU, RAM och arbetsbelastning. Ett exempel: 8 vCPU, 16 GB RAM, huvudsakligen cachelagrat innehåll och PHP-FPM i backend. Jag börjar med MaxRequestWorkers 512–768, ThreadsPerChild 32–64 och ServerLimit motsvarande 8–12. Jag räknar med 1–3 MB Apache-overhead plus moduler per aktiv worker, till detta kommer svarbuffertar, TLS-overhead och backend-sockets. Realistiskt sett reserverar jag 4–8 GB för Apache-processer/trådar, 2–4 GB för OS-cache och resten för backends. Jag ser till att ServerLimit × ThreadsPerChild aldrig mindre än MaxRequestWorkers; det är klokt att ha en viss marginal.
Översikt över användbara riktlinjer: – MinSpareThreads/MaxSpareThreads: Se till att reserven är tillräcklig för att hantera belastningstoppar utan „kallstart“, men utan att för många inaktiva trådar tar upp minne. – MaxConnectionsPerChild (alias MaxRequestsPerChild): En begränsad livslängd per process bidrar till att undvika minnesfragmentering och minnesläckor vid långvarig drift (t.ex. 5 000–20 000). – MaxKeepAliveRequests: Begränsar antalet förfrågningar per anslutning; måttliga värden skyddar mot „oändliga“ sessioner utan att försämra fördelarna med Keep-Alive (t.ex. 100–1000). – Tidsgräns, Tidsgränser för läsning/skrivning och ProxyTimeout: Förhindrar att programmet hänger sig; jag anger olika värden för varje sammanhang istället för att vara alltför konservativ globalt.
För statiska filer använder jag EnableSendfile och Aktivera MMAP medvetet: På lokala diskar kan båda ge fördelar; vid NFS/molnvolymer inaktiverar jag ofta sendfile för att undvika gränsfall. I TLS-vägar har sendfile på grund av sin konstruktion mindre effekt, eftersom data passerar genom krypteringspipelines; här är framför allt en effektiv Filterkedja.
Operativsystem- och nätverksbegränsningar
Även den bästa evenemangsarkitekturen är till liten nytta om operativsystemets begränsningar sätter käppar i hjulet. Jag kontrollerar: – Fildeskriptorer (ulimit -n): Värdet bör ligga en bra bit över det maximala antalet samtidiga anslutningar plus backend-socklar; flera tiotusentals är vanligt för välbesökta värdar. – LyssnaBacklog: En tillräckligt stor Accept-backlog förhindrar att SYN-paket avvisas vid trafiktoppar. – Kärnbackloggar (t.ex. somaxconn) och SYN-köer: De måste stämma överens med den förväntade „burst“-hastigheten. – Nätverksbuffert (rmem/wmem): Överdriv inte, men dimensionera så att sträckor med hög RTT eller hög bandbredd inte kollapsar.
Jag fördelar Accept-belastningen med flera lyssnartrådar och låter i regel plattformen välja Accept-mekanism (AcceptMutex auto). På system som stöder detta kan SO_REUSEPORT (plattformsberoende via listalternativ) utjämna acceptansvägarna. Det är viktigt att undvika ”thundering herd”-situationer där många trådar konkurrerar om samma accept.
Dessutom TCP-tillfälliga portar (ip_local_port_range) och TIME-WAIT-beteendet måste stämma överens med antalet parallella proxyanslutningar. Jag undviker aggressiva justeringar, utan testar istället under realistiska förhållanden och ser till att backend-servrarna stöder Keep-Alive, så att anslutningar kan återanvändas och antalet portbyten minskar.
Finesser med omvänd proxy: anslutningspooler och backend-servrar
Som omvänd proxy är den totala prestandan i hög grad beroende av stabila backend-anslutningar. Jag ser till att Proxy-anslutningar Håll anslutningen aktiv (Keep-Alive till backend) och dimensionera backend-poolerna så att de följer frontend-parallelliteten. För små pooler orsakar frontend-köer, medan för stora pooler skapar onödig belastning på appen.
Praktiska justeringsmöjligheter: – ProxyTimeout: Kortare för okritiska vägar, längre för „kostsamma“ slutpunkter – differentiera, inte generalisera globalt. – Balanserare-Inställningar (för mod_proxy_balancer): Viktningar, maximalt antal anslutningar per backend, hälsokänsliga omförsöksintervall. – mod_proxy_fcgi för PHP-FPM: FPM-pm.*-Värdena (pm.max_children, pm.start_servers osv.) måste anpassas till Apaches parallellitet för att undvika 502/504-toppar.
Jag ser till att backend-fel eskaleras på ett smidigt och snabbt sätt, istället för att binda upp frontend-trådar. Hälsokontroller, en försiktig policy för omförsök och mönster som liknar circuit breakers håller latensen stabil. När det är möjligt ser jag till att Cachelagring av svar på lämpliga ställen, så att MPM framför allt kan skicka korta och enkla svar.
Finförfining av HTTP/2 i Event
För HTTP/2 optimerar jag, förutom TLS, framför allt Strömningsbegränsningar och tilldelning av arbetare. Många små strömmar per anslutning kan minska latensen, men öka trådbelastningen. Jag ställer in det maximala antalet strömmar per session så att multiplexering träder i kraft, men utan att det uppstår någon „head-of-line“-ersättning. Dessutom skalar jag upp antalet arbetare på ett konservativt sätt för att dämpa toppbelastningar utan att RAM-minnet blir överbelastat.
Jag har lagt märke till hur ofta strömmar får vänta trots att trådar är lediga. När så är fallet är det oftast strömgränser eller buffertstorlekar som begränsar genomströmningen. En Prioritering Kritiska resurser (t.ex. CSS/JS via HTTP/2-prioriteringar) påverkar direkt den upplevda prestandan. På TLS-sidan minskar sessionåterupptagning, 0-RTT-liknande mekanismer (i den mån de är säkra och tillgängliga) och moderna krypteringsalgoritmer kostnaderna för handskakningen.
Robusthet: Timeouts, skydd mot Slowloris och Graceful Shutdown
Jag aktiverar mod_reqtimeout, för att hantera mönster som liknar ”slowloris”. Timeouts för läsning förhindrar att klienter levererar byte i snigeltakt och därmed tar upp resurser. Timeouts för skrivning skyddar mot tröga anslutningar till klienten. Dessa värden måste väljas utifrån sammanhanget – API:er kräver andra inställningar än nedladdning av stora filer.
När det gäller lanseringar och omstarter satsar jag på Graciös-Processer. Med en väl avvägd „graceful timeout“ avslutas gamla processer på ett kontrollerat sätt medan nya processer tar över. På så sätt förblir keep-alive-anslutningarna stabila, och händelsekön hanterar återstående belastning utan plötsliga avbrott. Roterande loggar, låg loggnivå under toppbelastning (t.ex. „info“ istället för ”debug”) och valfritt Buffrade loggar minskar I/O-belastningen märkbart.
Felsökning under belastning: Identifiera mönster
Typiska symtom och behandlingsmetoder: – Hög P95/P99-Fördröjningar vid lediga arbetare: Oftast väntetider i backend eller nätverket; kontrollera proxy- och läs-timeouts samt backend-pooler. – „server reached MaxRequestWorkers“: För liten parallellitet – höj MaxRequestWorkers och/eller ThreadsPerChild, kontrollera RAM-användningen. – Många Keep-Alive-Anslutningar, få aktiva trådar, men ändå långsamt: Ofta blockerande moduler/filter eller flaskhalsar i backend; profilera filterkedjan, kontrollera CPU-belastning och I/O. – 5xx-toppar med korrelerande TLS-belastning: CPU-bundna handskakningar – optimera krypteringsalgoritmer, återupptagning av sessioner och vid behov avlastning.
Jag åtgärdar flaskhalsar längs kedjan: Socket-acceptans (backlog), händelseslinga (väntetillstånd), arbetare (CPU-begränsade), filter (I/O-begränsade), proxy (backend-begränsade). Denna tankemodell förhindrar att jag justerar MaxRequestWorkers, trots att det egentligen är backenden som är begränsande.
Checklista för praktiken och vanliga fallgropar
Jag arbetar med en kort Checklista: aktuell Apache-version, Event MPM aktiverat, gränsvärden korrekt inställda, rimliga tidsgränser. Därefter kontrollerar jag Keep-Alive-frekvenserna och förhållandet mellan anslutningar och aktiva trådar. Jag kontrollerar om modulerna är trådsäkra och om filtren inte orsakar långa blockeringar. För PHP via FPM ser jag till att FPM-arbetare passar frontend-parallelliteten. Jag kalibrerar även operativsystemets gränsvärden, såsom filbeskrivare, TCP-backlog och kärnparametrar för nätverksbuffertar, så att Rörledning inte avstannar.
Jag upptäcker ofta vanliga problem snabbt: för stora KeepAliveTimeouts, för få MaxRequestWorkers, låga ThreadsPerChild eller olämplig loggning. Alltför detaljerad loggning slukar I/O och saktar ner svaren. En för liten storlek på proxy-backend-poolen minskar värdet av frontend-optimeringen. Felaktiga TLS-konfigurationer förlänger handskakningarna i onödan. Den som får ordning på dessa punkter skapar en pålitlig Grunden för konstanta latenser.
Sammanfattning för teknikansvariga
Event MPM skiljer tydligt mellan hantering av anslutningar och körning och satsar på en Händelsekö, som hanterar inaktiva anslutningar på ett effektivt sätt. På så sätt kan Apache skala upp vid många samtidiga klienter utan att lämna trådar hängande i luften. Rätt kombination av MaxRequestWorkers, ThreadsPerChild och väl genomtänkta timeouts håller latensen och RAM-förbrukningen under kontroll. Med kontinuerlig övervakning, benchmarking och några få riktade justeringar skapas ett system som hanterar toppar och svarar konsekvent. Den som tar dessa principer till sig får ut det mesta av sin Apache-Installationen ger betydligt mer och är samtidigt kompatibel med vanliga program och protokoll.


