 Hoppa till innehåll

Jag visar dig hur du tolkar vmstat i Linux på ett målmedvetet sätt: Du kan upptäcka CPU-flaskhalsar, minnesbelastning, swap och I/O-väntetider på bara några sekunder. Så här tolkar du kolumnerna r, b, free, si/so, bi/bo och us/sy/id/wa/st på ett säkert sätt och drar slutsatser om konkreta åtgärder utifrån mönstren – utan gissningar, med klar Regler.
Centrala punkter
- Körningskö vs. blockeringar: r visar CPU-belastning, b varnar för I/O-väntetider.
- Minne Bedöma realistiskt: att det är gratis räcker inte, det är resultatet som avgör.
- I/O Att tänka på: bi/bo är okritiska om wa förblir lågt.
- CPU-andelar läs: us+sy högt, id lågt → hög belastning.
- Baslinjer Skapa: Jämför värden i vardagen med värden under problemperioder.
Vad visar vmstat egentligen?
Vmstat sammanfattar processstatus, minne, swap, block-I/O och CPU-andelar i en kompakt utskrift som på några sekunder ger en systemomfattande Ger en bra överblick. Jag läser först „procs“ för r/b, därefter „memory/swap“ för free, buff, cache samt si/so. Sedan kontrollerar jag „io“ med bi/bo och avslutar med „cpu“ för us, sy, id, wa och eventuellt st. Denna ordning hjälper mig att skilja mellan orsak och verkan: ett högt r-värde indikerar beräkningsbelastning, ett högt b-värde pekar på I/O-väntetider, medan ett högt wa-värde kopplar samman CPU-inaktivitet med I/O-latens. På så sätt kan jag se om det är beräkningsarbete, minnesbrist eller lagringsenheter som bromsar systemet – och jag slipper Omvägar.
Start om 60 sekunder: Anrop och intervaller
För att få en ögonblicksbild sedan uppstarten kör jag „vmstat“ utan parametrar, för omedelbara analyser använder jag „vmstat 1“ eller „vmstat 5 12“ för tolv mätpunkter var femte sekund och får en tidsmässig Rad. Viktigt: Den första raden visar medelvärden sedan systemstart, därför utvärderar jag främst de följande raderna. Med Delay/Count styr jag samplingsfrekvensen och varaktigheten, till exempel „vmstat 1 30“ vid korta toppar. Vid oroliga arbetsbelastningar ställer jag in 1–2 sekunder, vid lugna scenarier snarare 5 sekunder. Jag observerar trender, inte enskilda bildrutor, eftersom mönstren visar de verkliga Orsaker visa.
Att tolka processer: r och b i vardagen
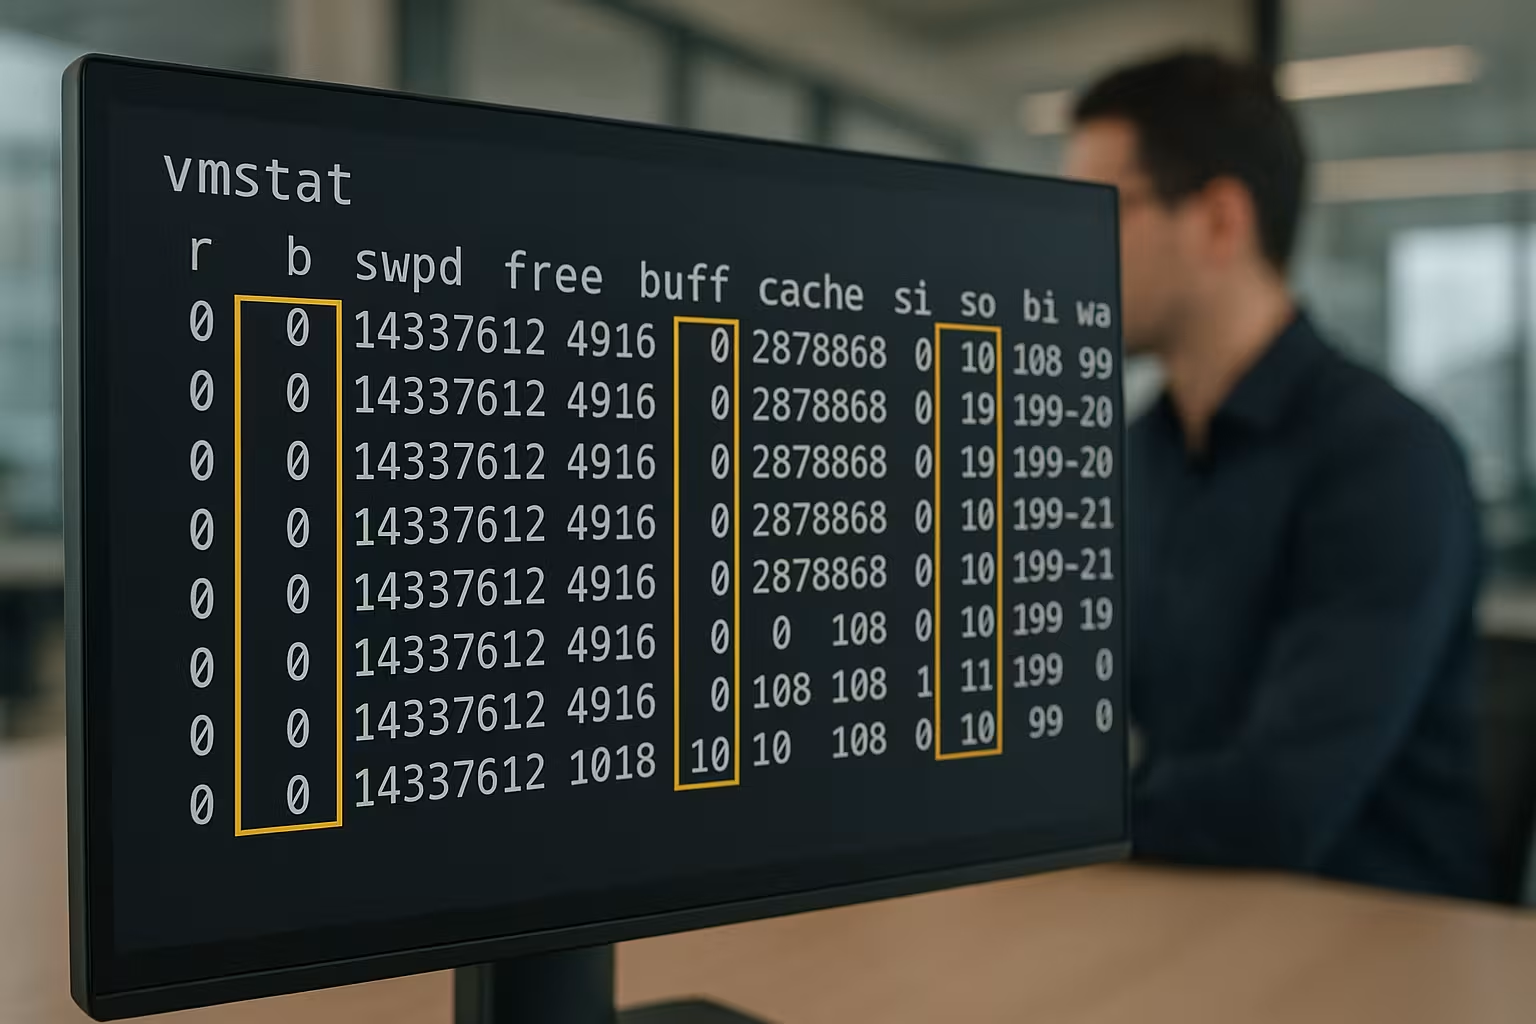
Kolumnen r visar trådar som är redo att köras och väntar på CPU-tid, medan b räknar blockerade trådar, ofta i I/O-kö. Om r ligger betydligt över antalet fysiska kärnor, är det uppenbart att CPU-flaskhals ; på fyra kärnor betraktas r=8 under en längre tid som en tydlig signal. Ett b-värde större än 0 under en längre tid tyder på tröga datamedier, överbelastade databaser eller långsamma nätverks- eller lagringsvägar. Jag korrelerar r med us+sy och id: om id är lågt och r högt, kämpar CPU:n; om wa är högt och b är högt, bromsar I/O. Så avgör jag om jag ska skala upp datorkraften, optimera sökningar eller Förvaringssystem check.
Tolkning av minnesvariabler: free, buff, cache, swpd
Ett lågt free-värde är normalt under Linux, eftersom kärnan använder RAM-minnet intensivt som cache, vilket påskyndar filåtkomsten och ger verklig Genomströmning ger. Jag lägger därför större vikt vid swpd och swap-strömmarna si/so än vid free ensamt. En hög cache är bra så länge si/so nästan alltid förblir 0; först när det förekommer ihållande swap-aktivitet uppstår verklig belastning. Om det dessutom uppstår latens eller till och med OOM, ingriper jag: ökar RAM-minnet, trimmar processer i tid eller justerar cache- och JVM-storlekar. Sammanhanget är viktigt: arbetsbelastning, minnesstorlek och NUMA-layout avgör vad som i din miljö betraktas som hälsosam gäller.
Swap-aktivitet: klassificera på ett eller annat sätt
Kolumnerna si/so mäter den kontinuerliga strömmen mellan RAM och swap i KB/s och synliggör den faktiska belastningen på minnet, inte bara den upplevda Brist. Korta toppar är normala, till exempel när sidor som sällan används flyttas. Det blir kritiskt om de på ett eller annat sätt förblir större än 0 under en längre tid; det saktar ner allt, eftersom varje utlagring medför extra I/O-kostnader. Höga so-värden tyder på aktiv utlagring, och svarstiderna ökar kraftigt. Vid denna punkt åtgärdar jag orsakerna: minska minnesbehovet, utöka RAM-minnet eller minneskrävande tjänster melodi.
Att förstå block-I/O: bi och bo
Med bi/bo kan jag avläsa läs- och skrivhastigheten i block per sekund, men utan sammanhang gör jag ingen bedömning av den; det avgörande är samspelet med wa. Höga bi/bo-värden i kombination med ett högt wa-värde tyder på att lagringssystemet inte hinner med. Om höga bi-värden uppträder i samband med en databas kontrollerar jag förfrågningsprofiler och cacheträffar innan jag byter ut hårdvaran. För en mer ingående tidsanalys använder jag iostat och analyserar köernas längd och latenser, så att jag Analysera I/O-väntetid och på ett målinriktat sätt kan hantera flaskhalsar. Först när wa förblir lågt, men bi/bo stiger kraftigt på lång sikt, funderar jag på Skalning i lagringssystemet.
CPU-andelar: us, sy, id, wa, st
Höga us-värden vid låga wa-värden tyder på produktiv nyttolast, medan höga sy-värden tyder på stor kärnöverhead, till exempel otaliga små I/O-operationer eller många Förändrad kontext. Om id ligger nära 0 och förblir där, går CPU:n på gränsen; i kombination med ett högt r-värde tyder detta på hög beräkningsbelastning. Om wa stiger, väntar CPU:n på I/O – här ger finjustering av lagringen ofta större vinster än CPU-uppgraderingar. I virtuella maskiner (VM) tittar jag på st (steal): Höga st-värden avslöjar att hypervisorn avleder CPU-tid, vilket gör att jag tar upp frågan om värdbelastningen med operatören. Jag utvärderar alltid us+sy som en summa, eftersom detta visar den aktiva Arbetskraft i systemet.
Snabbguide: Kolumner och riktvärden
Jag använder följande tabell som en kortfattad minneshjälp när jag tittar på vmstat-utdata för en första Bedömning läs i snedgående ordning.
| Kolumn | Betydelse | Vad jag uppmärksammar |
|---|---|---|
| r | Trådar som är redo att köras | Permanent > Kärnor → CPU-belastning |
| b | Spärrade trådar | Konstant > 0 + wa högt → I/O-problem |
| fri | Gratis RAM-minne | Lågt är okej, så länge si/so förblir ≈ 0 |
| buff/cache | FS-buffert/sidcache | Mycket cache är bra; kan godkännas bli |
| si/so | Swap in/ut | Konstant > 0 → verkligt lagringstryck |
| bi/bo | Block-I/O | Endast kritiskt om wa samtidigt är högt |
| us/sy | Användare/Kärna | us+sy kontinuerligt > 80% → hög Last |
| id | tomgång | Nära 0 över tid → CPU överbelastad |
| wa | I/O-väntetid | Högt med b högt → Lagring som orsak |
| st | Stjäla (VM:er) | Hög → Hypervisor tar CPU-tid |
Baslinjer och kontinuerlig övervakning
Jag förlitar mig inte på enstaka ögonblicksbilder, utan jämför värdena med referensvärden från lugna perioder för att på ett tydligt sätt kunna identifiera avvikelser känna igen. „vmstat 1 60“ ger mig en belastningsprofil för en minut, som jag jämför med kända normala faser. För att få en historisk överblick använder jag sar/sysstat-övervakning, för att utvärdera trender över flera dagar och skärpa gränsvärdena. Jag ställer in varningar på ett konservativt sätt: r i förhållande till kärnor, si/so olikt 0 över flera intervall, wa märkbart förhöjt. På så sätt kan jag reagera tidigt, innan användarna rapporterar fördröjningar och innan Topp-faserna eskalerar.
Vmstat i kombination med andra verktyg
Jag börjar med vmstat, drar slutsatser utifrån mönstren och fördjupar mig sedan specifikt med iostat, mpstat, pidstat eller applikationsmetriker för att kunna identifiera orsakerna klar tilldela. När vmstat visar I/O-väntetider mäter jag latenser och köer per enhet med iostat. Om r indikerar en kärnbegränsning visar mpstat kärnasymmetrier. Vid toppbelastning i processerna ger pidstat Processanalys de mest intensiva trådarna om tid. Det är först korrelationen med loggar och applikationstider som ger en tydligare bild och leder mig till den verkliga Orsak.
Att upptäcka mönster och agera
Om jag ser att r är högt, id lågt och wa moderat, optimerar applikationen ofta på ett sätt som kräver för mycket beräkningskraft, varför jag kontrollerar koden eller parallelliteten och planerar CPU-resurserna innan jag Hårdvara kräver. Om b, wa och bi/bo uppträder samtidigt överväger jag lagringsoptimering, frågeoptimering och cachelagring. Vid lågt free-värde med si/so större än 0 minskar jag lagringsförbrukningen, strömmar resultat eller ökar RAM-minnet. Om us är måttligt och sy mycket högt, tittar jag på paketfilter, filsystemalternativ eller drivrutiner. Med denna checklista agerar jag snabbt och lägger tiden där den gör mest räkningar.
Undvika mätfel: Provtagning, enheter, första raden
Jag utelämnar medvetet den första raden vid akuta störningar, eftersom den har beräknats som ett medelvärde sedan uppstarten och jämnar ut topparna helt. Dessutom anpassar jag samplingsfrekvensen efter orsakshypotesen: CPU-toppar fångar jag upp med 1-sekundersintervall, långsamma minnesläckor med 5–10 sekunder. Jag beaktar enheterna: si/so är KB/s, bi/bo är „block/s“ (historiskt 1 KB per block, varierar beroende på vmstat-version). Jag kontrollerar om „vmstat -w“ (bred utskrift) undviker avskurna kolumner och om förändringar i klockfrekvensen (P-tillstånd, Turbo) påverkar den kortsiktiga uppfattningen av belastningen. Jag synkroniserar mätningarna med applikationstoppar istället för att blint titta på „hela minuter“.
Avkoda systemsektionen: in och cs
Förutom procs/memory/swap/io/cpu visar vmstat även „system“: på (avbrott/sek.) och cs (Kontextväxlingar/s). Dessa två värden ger mig mycket information om kärnans overhead.
- cs är mycket hög vid måttlig arbetsbelastning: trådfladder, för små arbetsbatcher eller låskonflikter. Jag ökar batchstorlekarna, justerar parallelliteten (trådpooler) och kontrollerar schemaläggar- och mutex-hotspots.
- plötsliga toppar: nätverks- eller lagringsavbrott, NAPI/polling-effekter eller timeravbrott. Jag jämför med sy-andelen och iostat-resultaten för att kontrollera drivrutiner eller nätverksvägar.
- cs är proportionellt mot r: Detta tyder på ett ständigt tryck att byta sammanhang på grund av överdriven parallellitet. Jag minskar den aktiva parallelliteten eller kopplar hot-threads till kärnor.
Jag korrelerar alltid in/cs med sy och b/wa: Det är först när man betraktar dem tillsammans som man får en tydlig bild av om kärnans arbete är meningsfullt (t.ex. genomströmning) eller om det bara är ren overhead.
Användbara vmstat-varianter och alternativ
Jag använder vmstat på ett flexibelt sätt för att få ytterligare perspektiv utan att behöva byta verktyg:
- vmstat -s: Summatör (t.ex. processer som startats sedan uppstart, större/mindre sidfel). Perfekt för att jämföra läckor eller antal fall över olika tidsintervall.
- vmstat -m: Slab-användning – hjälper till att klassificera kärncacher (Dentry/Inode, nätverk) som RAM-förbrukare.
- vmstat -d: Diskhändelser på sammanfattningsnivå. Inget substitut för iostat, men bra för en snabb verklighetskontroll.
- vmstat -S M: Ändra enheterna (M/K) för att göra siffrorna lättare att läsa.
- vmstat -w: Bredare kolumner förhindrar att stora sifferrader blir avskurna.
Jag kombinerar dessa alternativ med korta intervall så att jag inte missar några händelser och ändå behåller överblicken.
Containrar, virtuella maskiner och cgroups: Särdrag
I containrar tolkar jag vmstat med försiktighet: Många kärndata gäller för hela värden, medan gränsvärdena kommer från Cgroups. Höga r-värden i en container återspeglar namnområdets synvinkel, men den faktiska CPU-tiden kan begränsas av CPU-kvoter eller CPU-andelar. Jag utgår från st (Steal) i virtuella maskiner: Hög st innebär att hypervisorn tar tid från mig – då hjälper inte ens perfekt app-optimering särskilt mycket så länge värddatorn är överbokad. Vid minnesbegränsningar i Cgroups kan si/so utebli, trots att containern „kämpar“ vid gränsen (OOM-avstängningar istället för swap). Därför kontrollerar jag dessutom OOM-loggar och Cgroup-statistik och jämför vmstat-bilder med gränserna.
NUMA och affinitet: När lokalitet spelar roll
På NUMA-värdar kontrollerar jag r och us/sy per kärna (med mpstat) och observerar om enskilda socklar „blir överbelastade“ medan andra går på tomgång. Olämplig minneslokalisering leder till högre cs/sy-värden och ökningar av b/wa på grund av minnesåtkomst från avlägsna platser. Jag testar CPU- och minnesaffinitet (cpuset, numactl), ställer in stora heap som „interleaved“ eller strikt lokala och ser till att ”heta” trådar körs där deras datafotavtryck finns. En stabil NUMA-layout jämnar ut cs, minskar wa-avvikelser och ökar Planerbarhet under belastning.
Undvik missförstånd: wa och b är mer än bara „långsamma lagringsmedier“
wa stiger inte bara vid klassiska disklatenser: även NFS/nätverk med hög latens, mättad objektlagring, blockerande molnvolymer eller tröga skrivåterföringar till sidcachen driver upp wa. b räknar uppgifter i oavbrytbar viloläge (D-State) – detta inkluderar även hängningar i drivrutiner, nätverksvägar eller filsystemslås. Därför utvärderar jag aldrig wa/b isolerat, utan alltid tillsammans med bi/bo och applikationstider. Om wa är högt men bi/bo är lågt, beror det ofta på en Beroende av väntetiden utöver den rena frågan om enhetens genomströmning (t.ex. låsning, fjärr-I/O, writeback-kö).
Tuning med omdöme: Swappiness, Writeback, Scheduler
Jag ändrar inte Kernel-Tuner förrän efter mätningen och med en plan för återställning:
- vm.swappiness: Ett lågt värde dämpar proaktivt utbyte, vilket är bra för applikationer där latensen är avgörande – ett för lågt värde kan öka belastningen på sidcachen.
- vm.dirty_background_ratio / vm.dirty_ratio (eller *_bytes): Påverkar tidpunkterna för writeback. För höga värden orsakar långa skrivburstar (wa-toppar), medan för låga värden ökar antalet kontinuerliga små flushar (sy/bo stiger).
- I/O-schemaläggare/ködjup: Andra inställningar för NVMe än för HDD/RAID. Jag mäter avvägningarna mellan latens och genomströmning med iostat innan jag gör några ändringar.
- Nätvägar: Många små paket/avbrott strömmar in i /cs/sy. De viktigaste inställningarna är GRO/LRO, RPS/RFS och IRQ-affinitet – jag mäter före och efter.
Mitt mål är stabila, förutsägbara kurvor i vmstat: us/sy ska vara jämnare, wa/b lägre och si/so nära 0. Först då utökar jag hårdvaran.
Playbook: 3-minutersanalys med vmstat
- 0:00–0:30 – „vmstat 1 30“: Ignorera den första raden, granska sedan r/b, us/sy/id/wa. Fråga: CPU-begränsning (r hög, id låg) eller I/O-begränsning (b/wa hög)?
- 0:30–1:00 – Översikt över tryckbeholder: kontrollera swpd och si/so. Är si/so konstant > 0? → verkligt tryck i behållaren. free är av underordnad betydelse.
- 1:00–1:30 – I/O-sammanhang: bi/bo vs. wa. Höga bi/bo-värden utan wa? → I/O kopplas bort. Höga wa-värden vid måttliga bi/bo-värden? → Latens/Lock/Remote-I/O.
- 1:30–2:00 – systemsektionen: in/cs i förhållande till sy. Är cs mycket högt? → Kontrollera trycket vid kontextbyte samt parallellitet/låsning.
- 02:00–03:00 – Fastställa hypotes och välja lämpligt verktyg: iostat för I/O-index, mpstat för kärnasymmetrier, pidstat för processhotspots. Först därefter optimering/skalning.
Utökade exempel från praktiken
- CPU-mättnad utan hög r: us+sy vid 90%+, id ≈ 0, men r är måttligt → Single-thread-hotspot eller affinitetsproblem. Lösning: Parallellisera hot-path, kontrollera core-pinning.
- Swap-Thrash: si och so samtidigt klart > 0, b/wa stiger, us sjunker → RAM:en är alldeles för liten eller heapet har fel storlek. Åtgärder: Öka RAM-minnet, minska arbetsuppsättningen, justera swappiness.
- Kärnans overhead: sy hög, cs/in hög, us måttlig → många små systemanrop/I/O. Åtgärd: Batchbearbetning, minskning av systemanrop, kontrollera monteringsalternativ för filsystem.
- Återföringsstockning: wa hög, bo hög, korta vågor → dirty-gränserna för höga, lagringslatensen varierar. Kontrollera writeback-inställningarna och I/O-schemaläggaren.
- Pressen att virtualisera: st synlig, r varierar, id „hoppar“ → Värden delar CPU. Lösning: Kontrollera vCPU-tilldelning/placering, minska överbelastningen.
Att känna till gränserna för vmstat
Vmstat är ett utmärkt Tidigt varningssensor, men inget mikroskop. Det visar mig att och var det fastnar – inte den enskilda felaktiga filen, frågan eller tråden. Därför går jag efter vmstat-diagnosen konsekvent vidare till mer avancerade verktyg, bekräftar hypoteser från flera håll och ändrar sedan bara en sak i taget. På så sätt förblir förbättringarna mätbara och reproducerbara.
Sammanfattning från praktiken
Med vmstat kan jag på några sekunder se om det är CPU, RAM, swap eller I/O som bromsar systemet genom att titta på hur r, b, si/so, bi/bo och us/sy/id/wa/st samverkar läs. Jag utvärderar trender istället för enskilda värden, jämför med referensvärden och tar vid behov hjälp av iostat, mpstat, pidstat samt historiska mätningar. Vid akuta störningar bortser jag från den första raden och koncentrerar mig på de efterföljande raderna med fast samplingsfrekvens. Jag fattar beslut utifrån data: r i förhållande till kärnor, si/so som konstant skiljer sig från 0, wa som är ihållande förhöjt, us+sy nära full belastning. På så sätt kan jag snabbt fastställa konkreta åtgärder och hålla systemen i gott skick. reaktiv.


