 Zum Inhalt springen

Ich zeige, wie ich den Redis Offset gezielt lese, analysiere und für hohe DatenKonsistenz nutze. So erkenne ich Replikationslücken früh, bewerte Failover-Risiken und halte produktive Cluster verlässlich synchron.
Zentrale Punkte
Die folgenden Kernaussagen führen gezielt in Thema, Terminologie und praktische Umsetzung ein.
- Offset misst den Fortschritt des Replikationsstroms Byte für Byte.
- Lag ist die Differenz aus master_repl_offset und slave_repl_offset.
- ID+Offset kennzeichnet eine exakte Datenversion für Teilabgleiche.
- Backlog schützt vor Full Syncs bei kurzen Verbindungsabbrüchen.
- Monitoring mit INFO/Cluster-Metriken steuert Alarmierung und Failover.
Was bedeutet der Redis Replication Offset?
Der Replikationsoffset ist ein fortlaufender 64‑Bit‑Zähler, der jeden übertragenen Bytestrom zwischen Primary und Replica abbildet. Ich lese daraus ab, wie weit die Replikation fortgeschritten ist und ob eine Replica noch Arbeit vor sich hat. Der master_repl_offset auf dem Primary steigt mit jedem neu erzeugten Byte, während die Replica ihren eigenen Zähler erhöht, sobald sie Befehle angewendet hat. Differenzen ergeben einen Lag in Bytes und zeigen an, ob die Replica hinterherhinkt. Diese einfache, aber wirkungsvolle Semantik macht den Offset zur zentralen Zahl für Synchronität, Ausfallanalyse und saubere Failover-Entscheidungen.
Offsets auslesen: INFO replication richtig nutzen
Ich beginne die Diagnose fast immer mit INFO replication, weil der Befehl die relevanten Felder kompakt liefert. Auf dem Primary prüfe ich master_repl_offset sowie den Status verbundener Replicas inklusive deren Offsets. Auf einer Replica kontrolliere ich zusätzlich master_link_status und Synchronisationszustände, um laufende Full Syncs oder Teilabgleiche zu erkennen. Für eine tiefergehende Auswertung greife ich auf strukturierte Ausgaben zurück und korreliere Offsets mit CPU-, I/O- und Netzwerkwerten. Eine fundierte Einführung in den Befehl liefert mir dieser Leitfaden: Redis INFO für Monitoring.
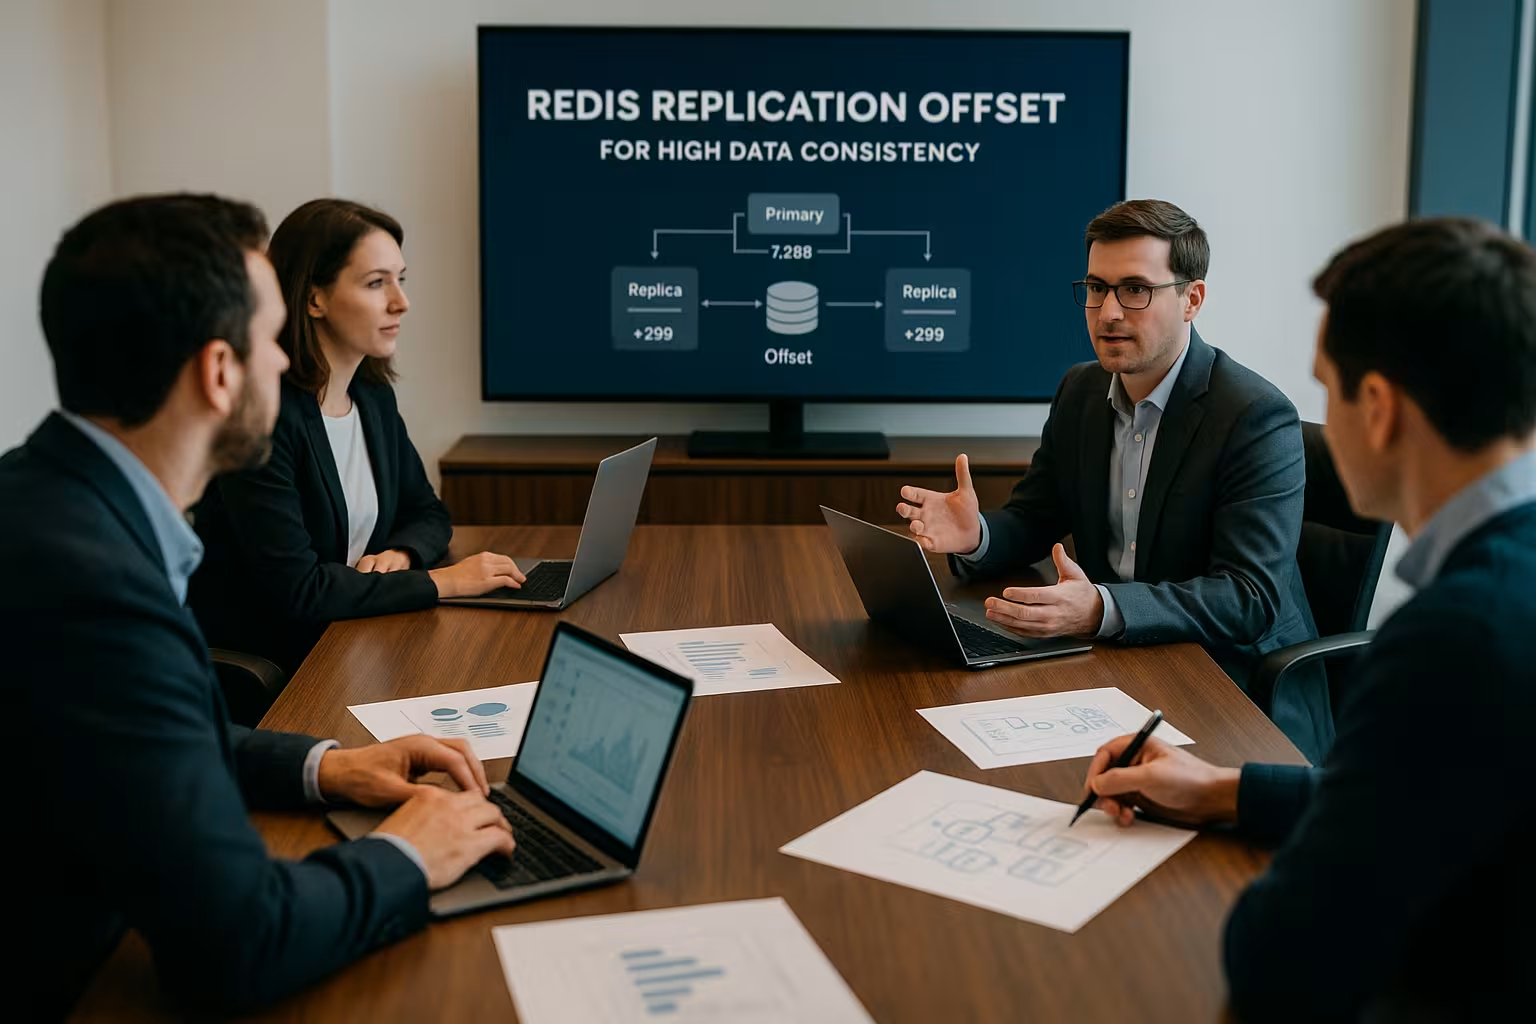
Replication ID + Offset: eindeutige Datenversion
Für eine eindeutige Version nutze ich die Kombination aus Replication ID und Offset. Die ID markiert eine Historie, der Offset eine Position innerhalb dieser Historie. Stimmen ID und Offset auf zwei Instanzen überein, gehe ich davon aus, dass beide denselben Datenstand besitzen. Diese Kombination macht Partial Resync möglich, weil eine Replica dem Primary exakt mitteilen kann, wo sie zuletzt stand. Ich erkenne daran auch, ob ein Failover ohne Datenabweichung gelingt oder ein vollständiger Abgleich nötig wird.
Replikations-Backlog und Gap dimensionieren
Der Primary hält einen Backlog als Ringpuffer vor, der jüngste Schreibvorgänge speichert und Teilabgleiche ermöglicht. Ist der Puffer zu klein, laufen Bytes bei Lastspitzen schneller heraus und eine kurz getrennte Replica verpasst den Partial Resync. Ich dimensioniere die Größe abhängig vom Schreibprofil und den RPO‑Zielen, damit kurze Unterbrechungen keine teuren Full Syncs auslösen. Als grobe Leitlinie wähle ich eine Größe, die mindestens die erwartete Datenmenge über mehrere Sekunden bis Minuten Aufnahmezeit puffert. So senke ich den Gap zwischen Primary und Replica und halte den Wiederanschluss schlank.
Backlog-Größe präzise bestimmen
In der Praxis berechne ich die Backlog-Größe nicht nur nach Gefühl, sondern anhand des tatsächlich beobachteten Bytestroms:
- Ich ermittle den Durchsatz in Bytes/s, indem ich den Anstieg von master_repl_offset über definierte Intervalle messe (z. B. 10–60 s) und Spitzenwerte notiere.
- Ich definiere eine tolerierte Unterbrechungsdauer (z. B. Wartungsfenster, Netzwerkflaps) in Sekunden.
- Ich multipliziere Spitzen-Bytes/s mit der Unterbrechungsdauer und füge einen Sicherheitsfaktor (1,5–3×) hinzu.
Beispiel: 80 MB/s Peak, 20 s erwartete Trennung, Faktor 2 → 80×20×2 = 3.200 MB Backlog. So stelle ich sicher, dass selbst bei ungünstigem Timing ein Teilabgleich gelingt. Anschließend verifiziere ich im Monitoring, ob der Backlog selten gegen seine Kapazitätsgrenze läuft; falls doch, erhöhe ich ihn schrittweise.
Tuning von hz, Batchgrößen und Netzwerk
Ich betrachte neben dem Backlog auch die hz-Einstellung, weil sie interne Wartungszyklen beeinflusst und damit den durchschnittlichen Lag. Zusätzlich prüfe ich Schreibbatchgrößen, Pipeline-Nutzung und TCP-Parameter, um den Replikationsstrom glatter zu machen. Eine niedrige Latenz zwischen Primary und Replica zahlt direkt auf kleinere Offset-Differenzen ein. Engstellen auf der Replica-Seite, etwa langsame Datenträger oder wenig CPU, vergrößern den Rückstand ebenfalls. Ich ändere deshalb jeweils nur einen Faktor, messe den Effekt auf den Offset-Gap und dokumentiere die Wirkung klar.
Diskless Sync und Snapshot-Effekte auf den Offset
Für Full Syncs nutze ich bevorzugt diskless sync, weil der Primary dann den RDB‑Stream direkt übers Netz liefert und keine zusätzliche Schreiblast auf lokale Datenträger erzeugt. Das senkt die I/O‑Spitzen und stabilisiert Offsets während An- und Abkoppelphasen. Eine moderate Verzögerung (repl-diskless-sync-delay) gibt weiteren Replicas Zeit, sich einzuklinken, sodass ein RDB‑Stream mehrfach genutzt wird. Ich beobachte dazu CPU‑ und Netzwerkauslastung, denn auch ein diskloser Transfer kann bei sehr großen Datenmengen zu kurzzeitigen Lags führen.
Snapshots (RDB) verursachen beim Fork Copy‑on‑Write. Auf stark schreibenden Systemen erhöht das den Speicherbedarf temporär und kann die Anwendungsrate auf der Replica ausbremsen. Ich takte daher Snapshots in ruhigere Tageszeiten, prüfe Speicherreserven und achte darauf, dass Replikations‑ und AOF‑Pfade nicht in Konkurrenz geraten.
Partial Resynchronisation in der Praxis
Fällt eine Replica kurz aus, versuche ich immer zuerst einen Teilabgleich zu erreichen. Beim Wiederverbinden meldet sich die Replica mit Replication ID und letztem Offset, worauf der Primary die fehlenden Bytes aus dem Backlog nachliefert. Reicht der Backlog nicht aus oder hat sich die ID geändert, startet ein Full Sync mit RDB-Transfer und Aufholphase. Ich beobachte in diesem Moment die Offsets, um zu sehen, wie schnell die Replica anzieht und ab wann beide Zähler wieder eng beieinander liegen. Gelingt der Teilabgleich, bleiben Latenzen und I/O‑Spitzen deutlich geringer.
Replication IDs, PSYNC2 und Reset-Verhalten
Für saubere Interpretationen setze ich auf die PSYNC2‑Semantik. Der Primary führt eine aktuelle Replication ID und zusätzlich eine Historien‑ID mit zugehörigem Offset. Bei Neustarts oder Führungswechseln ändert sich die Primär‑ID; die alte ID bleibt als Historie mit Endoffset erhalten. Eine Replica kann damit trotz ID‑Wechsel weiter per Teilabgleich aufholen, solange der benötigte Bereich im Backlog liegt. Ich werte in INFO replication deshalb beide IDs samt Offsets aus und erkenne so, ob ein ID‑Wechsel gerade stattgefunden hat oder ansteht.
Wichtig ist: Der Offset ist monoton pro Historie, aber ein ID‑Wechsel definiert eine neue Zeitlinie. Ich dokumentiere diesen Wechsel im Betrieb, damit Trendanalysen den Sprung korrekt einordnen. Ein 64‑Bit‑Offset läuft praktisch nie über; deutlich relevanter sind Neustarts, Failover oder Backlog‑Verdrahtungen, die die Historie beeinflussen.
Client-Quittungen und Haltbarkeit im Kontext Offset
Offsets zeigen Fortschritt, aber keine Garantien zur Haltbarkeit. Wenn ich Bestätigungen über Replikate brauche, nutze ich ergänzend:
- WAIT: Der Primary bestätigt, nachdem N Replicas einen Schreibbefehl empfangen und in ihren Input‑Puffer aufgenommen haben. Das ist schneller als Full‑Sync‑Sicherheit, garantiert aber keine Persistenz auf Datenträgern.
- min-replicas-to-write und min-replicas-max-lag: Der Primary nimmt nur Writes an, wenn ausreichend nahe Replicas verbunden sind und deren Lag unter einer Schwelle bleibt. Das reduziert Split‑Brain‑Risiken.
Ich setze diese Mechanismen in Zusammenschau mit dem Offset ein: Der Offset prüft die tatsächliche Aufholgeschwindigkeit und Langzeittrends, während WAIT/min‑replicas pro Befehl Schutz bieten. Für strenge RPOs kombiniere ich sie und protokolliere beide Sichten im Monitoring.
Alerting und Metriken im Monitoring-Stack
Für die Überwachung definiere ich klare Schwellwerte auf Basis der Offset-Differenz in Bytes. Ich verknüpfe diese Metrik mit Zeitreihen aus Prometheus/Grafana und löse Alarme aus, wenn der Gap über definierte Dauer steigt. Zusätzlich protokolliere ich Trends, um Lastspitzen zu erkennen und Gegenmaßnahmen zu planen. Dashboards visualisieren master_repl_offset, replica Offsets und den berechneten Lag, was Auswertungen im Betrieb deutlich beschleunigt. Praktische Hinweise für Setups mit Zeitreihen erhalte ich hier: Redis Monitoring mit Prometheus und Grafana.
Runbooks und Eskalationspfade
Ich halte standardisierte Schritte vor, damit Teams bei steigendem Lag zielgerichtet handeln:
- Warnung: Lag > X MB für > Y s → Durchsatz und Latenz der Replikationsverbindung prüfen, konkurrierende Jobs (Snapshot, große Lua‑Skripte) identifizieren.
- Major: Lag steigt kontinuierlich → Backlog‑Auslastung, Replica‑CPU/IO, Netzwerkfehler (Retransmits, Drops) korrelieren, ggf. Schreiblast drosseln.
- Kritisch: Backlog droht zu überlaufen → Replica entlasten (z. B. temporär Leselast umlenken), Full‑Sync‑Fenster planen oder zusätzliche Replica einschwenken.
Ich dokumentiere Entscheidungsbäume, damit klar ist, wann ein Failover noch risikoarm ist und wann ich warten sollte, bis der Offset‑Gap abgeflacht ist.
Redis Cluster: Offsets pro Shard bewerten
In einem Cluster prüfe ich Offsets je Shard, weil jeder Shard seinen eigenen Replikationsstrom führt. Der Befehl CLUSTER SHARDS liefert mir Slot-Ranges, Knotenrollen und die relevanten Offsets für Primary und Replica. Große Differenzen in einem Shard deuten auf Risiken beim geordneten Failover dieses Shards hin. Ich vergleiche deshalb systematisch die Offsets aller Shards und priorisiere Knoten mit minimalem Lag als Kandidaten für die Führung. So halte ich das Gesamtbild konsistent und verhindere Überraschungen beim Umschalten.
Cluster-Alltag: Resharding und Slot-Migration beobachten
Bei Slot‑Verschiebungen steigt der Schreibdruck oft ungleichmäßig an. Ich messe Offsets pro Shard während MIGRATE‑Phasen, um zu sehen, ob einzelne Replicas in Rückstand geraten. Besonders heikel sind längere Migrationsfenster in Verbindung mit kleinen Backlogs: Hier plane ich entweder größere Backlogs ein oder steppe Migrationen, damit Teilabgleiche nicht verloren gehen. Ich bewerte vor jedem Shard‑Failover, ob der Zielknoten jüngst Slot‑Last übernommen hat und ob sein Replica‑Offset stabil bleibt.
Use Cases: Offset zielgerichtet interpretieren
Für die Bewertung des Replikationslags vergleiche ich systematisch den master_repl_offset mit jedem Replica-Offset und leite daraus das Alter potenziell veralteter Daten ab. Vor einem geplanten Umschalten bewerte ich das Failover-Risiko, indem ich die engste Replica identifiziere und ihre Konsistenz über mehrere Minuten bestätige. Steigt der Lag wiederholt an, korreliere ich ihn mit Netzwerkmetriken, CPU-Last und I/O, um Flaschenhälse zu finden und gezielt zu beheben. Für strenge Haltbarkeitsziele prüfe ich außerdem, ob Operationen im AOF bestätigt sind und wie sich Offsets dazu verhalten. Diese Muster helfen mir, Entscheidungen auf eine objektive Zahl zu stützen und Downtime kurz zu halten.
Cascading Replication und Geo-Layouts
In verteilten Setups wähle ich oft Replica‑Ketten (Replica‑of‑Replica), um Weitverkehr zu entlasten. Dabei beachte ich, dass der Offset je Kante separat gilt und WAIT nur direkt verbundene Replicas zählt. Für Geo‑Replikation setze ich realistische Latenzbudgets und messe Offsets getrennt nach Region. Ein geplanter Region‑Failover ist erst dann vertretbar, wenn die nächste Führungskandidatin über längere Zeit einen minimalen Gap zeigt und die Netzwerkpfade stabil sind. Bei großen Distanzen senke ich Schreiben im Burst, nutze Pipelining maßvoll und erhöhe Backlogs an den Knoten mit der größten RTT.
Praxisnaher Betrieb in Hosting-Umgebungen
Im Managed-Umfeld setze ich auf klare Dashboards, die Offset, Lag und Gesundheitszustände zusammenführen. Für Teams, die Diagnosen beschleunigen möchten, lohnt ein Blick auf Tools mit tiefer Redis-Sicht und übersichtlicher Visualisierung. So erkenne ich driftende Offsets früh und leite Gegenmaßnahmen ein, bevor Backlogs überlaufen oder Full Syncs Lastspitzen erzeugen. Zusätzlich übe ich Failover-Proben in Staging-Umgebungen und messe, wie schnell sich Offsets nach Umschalten wieder annähern. Einen praxisnahen Einstieg in grafische Auswertung liefert mir dieser Leitfaden: Redis Insight für Diagnose.
Troubleshooting-Muster bei wachsendem Lag
Wenn der Offset‑Gap steigt, gehe ich nach wiederkehrenden Mustern vor:
- Replica‑CPU ausgelastet: Single‑Thread‑Bottlenecks oder teure Lua‑Skripte bremsen die Verarbeitung; ich verifiziere dies an der Bearbeitungsrate und entzerre Spitzen.
- Speicher- oder I/O‑Druck: AOF‑Rewrite, Snapshot oder laute Nachbarn erhöhen Latenz; ich verschiebe Jobs, optimiere Storage‑Klassen oder aktiviere diskless‑Sync.
- Netzwerkpfad schwankt: Retransmits, Drops oder MTU‑Mismatches; ich prüfe Interface‑Fehler, Puffergrößen und reduziere Paketverluste.
- Replica‑Output‑Buffer: Wird das Limit für Replicas zu klein gewählt, trennt der Primary die Verbindung; ich setze client‑output‑buffer‑limit für Replicas passend zur Last.
- TLS‑Overhead: Auf schwacher CPU kann Verschlüsselung den Strom drosseln; ich messe Krypto‑Kosten und skaliere Kerne oder entlaste per Hardwarebeschleunigung.
- Diagnosetools mit Nebenwirkung: MONITOR oder zu lautes Logging verlangsamt; ich nutze solche Tools sparsam und zeitlich begrenzt.
Ich halte diese Muster im Team präsent, damit wir bei Alarmsignalen nicht grundsätzlich neu suchen, sondern Hypothesen zügig testen und verwerfen.
Tabellarische Orientierung: Schlüsselmetriken auf einen Blick
Die folgende Übersicht fasse ich im Betrieb gerne zusammen, weil sie die wichtigsten Kennzahlen und Aktionen an einem Ort bündelt.
| Signal | Bedeutung | Typische Quelle | Aktion/Interpretation |
|---|---|---|---|
| master_repl_offset | Bytes, die der Primary im Replikationsstrom erzeugt hat | INFO replication | Baseline für Lag-Berechnung, Verlauf beobachten |
| slave_repl_offset | Bytes, die die Replica bereits angewendet hat | INFO replication, Replica-Abschnitt | Von master_repl_offset abziehen, Gap bestimmen |
| Replication ID | Marker für Historie/Generation der Daten | INFO replication | Mit Offset kombinieren, Teilabgleich prüfen |
| Backlog-Größe | Ringpuffer für jüngste Bytestücke | Konfiguration, INFO replication | Größer wählen bei hohem Schreibvolumen |
| replication-offset (Cluster) | Offsets pro Shard für Primary/Replica | CLUSTER SHARDS | Shard-Kandidaten für Umschalten bewerten |
Zusammenfassung: Offset beherrschen, Ausfälle vermeiden
Ich setze den Offset als zentrale Leitmetrik ein, um Konsistenz, Teilabgleiche und Failover-Verhalten sicher zu steuern. Mit INFO replication, geeigneter Backlog-Größe und sauberem Alerting halte ich replizierte Knoten eng zusammen. In Cluster-Topologien bewerte ich pro Shard die Offsets und priorisiere Kandidaten mit minimalem Lag. Tuning von hz, Netzwerk und Speicherwegen senkt den Rückstand weiter und verhindert kostspielige Full Syncs. Wer Offsets konsequent überwacht, reduziert Ausfallzeiten und erhöht die Verlässlichkeit des gesamten Redis-Stacks deutlich.


