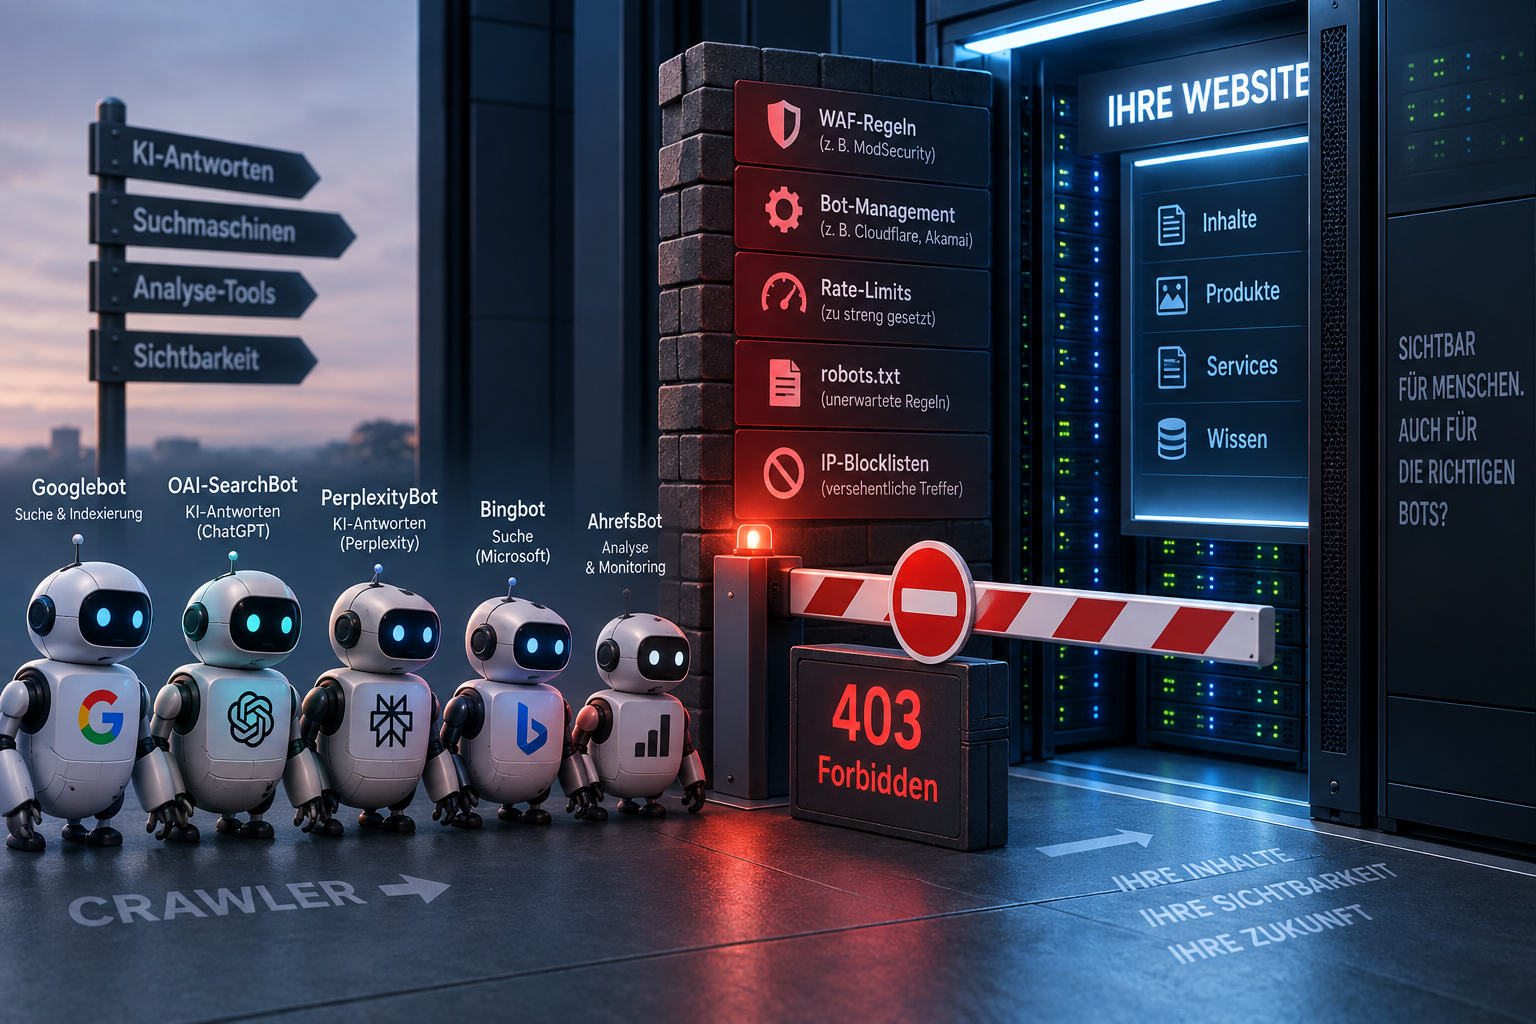
Viele Websites schließen Crawler aus, ohne es zu wissen: Bot-Management, WAF-Regeln oder aggressive Rate-Limits liefern bestimmten User-Agents ein 403 zurück. Für Googlebot ist das ein Sichtbarkeitsproblem, für Antwort-Crawler wie OAI-SearchBot oder PerplexityBot kann es verhindern, dass Inhalte vom jeweiligen Dienst als Quelle abgerufen werden. Wer Analyse-Crawler blockiert, verliert dagegen vor allem den Blick auf die eigenen Daten.
Das Bemerkenswerte daran: In der Regel funktioniert alles. Du rufst deine Seite im Browser auf, sie lädt schnell, kein Fehlerbild, kein Hinweis. Trotzdem kann dein Server parallel dazu bestimmte Bots konsequent abweisen. Und genau aus diesem Grund bleiben solche Blockaden so oft monatelang unentdeckt. Der Browser-Abruf ist eben kein Beweis dafür, dass ein Bot denselben Zugriff bekommt.
Dieser Leitfaden zeigt, welche Crawler heute unterwegs sind, wie Blockaden entstehen, welche davon harmlos und welche teuer sind. Außerdem erfährst du, wie du das auf deiner eigenen Infrastruktur sauber prüfst.
Welche Crawler besuchen heute eine Unternehmenswebsite?
Der Traffic auf deinem Server lässt sich in drei große Bot-Gruppen einteilen; hinzu kommt eine vierte, die du nicht unbedingt willst. Crawling-Technologie kommt dabei längst nicht nur bei klassischen Suchmaschinen zum Einsatz. Auch spezialisierte Plattformen können damit Inhalte externer Websites automatisiert erfassen und für ihre eigenen Dienste aufbereiten.
Die erste Gruppe sind die klassischen Suchmaschinen-Crawler: Googlebot und Bingbot rufen deine Seiten ab, damit sie im Index landen und über die Suche gefunden werden können. Sie sind seit jeher Teil des Alltags und in fast jeder Konfiguration erwünscht.
Die zweite Gruppe ist jünger: Crawler von KI- und Antwortsystemen. OpenAI unterscheidet hier zwischen dem OAI-SearchBot, der Inhalte für Antworten in der Suche abruft, und dem GPTBot, der Inhalte für das Modelltraining sammeln kann. Hinzu kommen PerplexityBot, ClaudeBot, Google-Extended und CCBot sowie der ChatGPT-User-Agent. Letzterer ist ein Sonderfall: Er wird durch einen konkreten Nutzer angestoßen, etwa wenn jemand in ChatGPT eine Frage stellt, die einen Webseitenabruf auslöst, und crawlt nicht automatisiert das Web. Für die Steuerung der Sucheinbindung ist laut OpenAI-Dokumentation ausschließlich der OAI-SearchBot relevant.
Die dritte Gruppe sind Analyse- und SEO-Crawler wie AhrefsBot oder SemrushBot. Sie sammeln Daten über Titel, Inhalte und Verlinkungen. Dies sind Daten, die du selbst nutzt, wenn du in den entsprechenden Tools deine eigene Domain auswertest.
Und dann gibt es die unbekannten und gefälschten Bots, die beliebige User-Agents mitschicken, Last erzeugen und scrapen, ohne dir irgendeinen Gegenwert zu liefern.
Was passiert, wenn ein Crawler ein 403 bekommt?
Ein HTTP 403 bedeutet schlicht: Der Server hat die Anfrage verstanden und verweigert sie. Entscheidend ist, wie oft und wie dauerhaft das passiert.
- Einmalige Sperre: Ein einzelner fehlgeschlagener Abruf ist noch keine Katastrophe. Suchmaschinen versuchen es erneut; aus einem isolierten Fehler folgt nicht automatisch ein Indexausschluss.
- Dauerhafter Ausschluss: Bekommt Googlebot über einen längeren Zeitraum konsequent 403-Antworten, sinkt die Crawling-Frequenz, und Seiten können mittelfristig aus dem Index verschwinden.
- Soft-Blocking über Rate-Limits: Ein HTTP 429 signalisiert, dass zu viele Anfragen kamen. Aggressive Rate-Limits bremsen Bots aus, ohne dass eine explizite User-Agent-Sperre eingerichtet wurde. Gerade das ist besonders tückisch, weil niemand bewusst „blockiert“ hat.
Wichtig ist außerdem die Unterscheidung der Ebene: Die robots.txt ist eine Anweisung an kooperative Crawler, keine technische Zugriffssperre. Laut der Google-Dokumentation zur robots.txt liegt die Datei im Stammverzeichnis, folgt dem Robots-Exclusion-Standard und steuert über Regelgruppen mit user-agent und disallow/allow, welche Pfade gecrawlt werden dürfen. Das bloße Vorhandensein eines Eintrags reicht nicht aus, um Besucher auszusperren. Eine echte Sperre entsteht erst dann, wenn der Server oder eine Web Application Firewall (WAF) den Zugriff aktiv blockiert.
Warum bleibt das so oft unbemerkt? Weil alle üblichen Kontrollen am Bot vorbeigehen: Monitoring prüft meist nur, ob die Seite mit einem User-Agent „erreichbar“ ist, der nicht gesperrt ist. Der Browser-Abruf funktioniert einwandfrei, während GPTBot oder Bingbot parallel ein 403 kassieren.
Welche Blockade ist harmlos und welche kostet Sichtbarkeit?
Die entscheidende Frage ist nicht „blockieren oder nicht“, sondern: Welchen Zweck hat der Bot und was verlierst du, wenn er nicht mehr durchkommt? Die Antwort fällt je nach Crawler-Typ völlig unterschiedlich aus:
| Crawler-Typ | Beispiele (User-Agents) | Was eine Blockade bewirkt | Empfehlung |
|---|---|---|---|
| Suchmaschinen-Crawler | Googlebot, Bingbot | Seiten verschwinden mittelfristig aus dem Index, Rankings brechen weg | Niemals blockieren |
| Antwort- und KI-Suchcrawler | OAI-SearchBot, PerplexityBot, ChatGPT-User | Eine Blockade kann die Heranziehung deiner Inhalte als Quelle durch den jeweiligen Dienst verhindern | Bewusst freigeben, wenn Sichtbarkeit in KI-Antworten gewünscht ist |
| Trainings- und Datensammlungs-Crawler | GPTBot, ClaudeBot, CCBot; Google-Extended als Steuerungstoken | Inhalte werden vom jeweiligen Dienst nicht beziehungsweise nicht erneut für den vorgesehenen Datenerfassungs- oder Trainingszweck abgerufen | Bewusste Entscheidung, beide Richtungen legitim |
| Analyse- und SEO-Crawler | AhrefsBot, SemrushBot | Rankings bleiben unberührt, aber eigene Auswertungen laufen ins Leere: Seitentitel, Inhalte und interne Verlinkung fehlen in den Tools | Für die eigene Domain freigeben, sonst analysierst du blind |
| Unbekannte und gefälschte Bots | beliebige User-Agents ohne verifizierbare Herkunft | Last und Scraping ohne Gegenwert | Über Verifizierung filtern, nicht über den User-Agent-String allein |
Die Kernaussage verdient eine Wiederholung: Suchmaschinen- und Antwortsystem-Crawler auszusperren kostet Reichweite. Analyse-Crawler auszusperren kostet dagegen nicht die Rankings, sondern deine eigene Messbarkeit. Und Trainingscrawler zu blockieren ist weder richtig noch falsch, es ist eine bewusste Abwägung zwischen der Kontrolle über die eigenen Inhalte als Trainingsdaten und der möglichen Präsenz in KI-Systemen. Beide Richtungen sind legitim, solange sie bewusst getroffen werden. Welche Regeln und Nutzungsmuster rund um das automatisierte Abrufen von Inhalten in der Praxis greifen, untersucht eine Studie der Rundfunk und Telekom Regulierungs-GmbH zu Text und Data Mining.
Wie erkenne ich, dass mein Server Crawler blockiert?
Die gute Nachricht: Das ist reproduzierbar prüfbar, ohne Spezialwerkzeuge. Gehe in dieser Reihenfolge vor:
- Logfiles nach User-Agent filtern. Suche im Access-Log gezielt nach den bekannten Bots: Googlebot, Bingbot, GPTBot, OAI-SearchBot, PerplexityBot, AhrefsBot, SemrushBot.
- Statuscodes je Bot auswerten. Ein 403 oder 429 bei einem bekannten Bot ist das deutlichste Signal. Ein einzelner Fehlversuch ist unkritisch; wiederkehrende Fehler über Tage sind es nicht.
- Abruf mit gesetztem User-Agent testen. Rufe eine URL per curl mit dem jeweiligen User-Agent-String ab und vergleiche den Statuscode mit einem normalen Browser-Abruf. Weicht er ab, filtert irgendwo eine Regel.
- Abdeckung in der Google Search Console prüfen. Der Bericht zur Seitenindexierung in der Search Console zeigt, welche URLs ausgeschlossen sind und warum, etwa wenn sie durch die robots.txt blockiert werden. 403-Antworten oder WAF-Sperren lassen sich dagegen zusätzlich über Server- oder Crawling-Logs prüfen, da diese Blockadearten je nach Konfiguration unterschiedlich ausgewiesen werden.
- robots.txt und CDN-/WAF-Regelwerk kontrollieren. Viele Blockierungen entstehen nicht auf dem Webserver selbst, sondern in vorgelagerten Bot-Management-Systemen. Häufig sind dafür voreingestellte Standardprofile verantwortlich, die bestimmte Zugriffe automatisch als verdächtig einstufen und sperren.
Ein Hinweis zum Datenschutz: Logfiles enthalten IP-Adressen, und die gelten im Rahmen der DSGVO als personenbezogene Daten. Richte die Auswertung deshalb an den üblichen Prinzipien aus wie Zweckbindung, Datenminimierung, Zugriffsbeschränkung auf wenige Berechtigte und eine angemessene, dokumentierte Aufbewahrungsdauer. Die konkrete Ausgestaltung gehört in die Datenschutzkonzeption deines Unternehmens.
Typischerweise entstehen Blockaden auf diesen Ebenen:
| Ebene | Typische Ursache | Woran man es erkennt |
|---|---|---|
| robots.txt | Alte disallow-Regeln, Template-Reste aus der Entwicklung | Crawler melden „durch robots.txt blockiert“ |
| Webserver-Konfiguration | Explizite Sperren nach User-Agent in der vhost- oder Server-Konfiguration | 403 nur für bestimmte User-Agents |
| WAF- oder CDN-Bot-Management | Standardprofile, die „KI-Bots“ oder „SEO-Bots“ pauschal ablehnen | 403/429 bereits am Edge, bevor der Server erreicht wird |
| Rate-Limiting | Zu enge Limits pro IP oder User-Agent | 429-Antworten bei höherer Crawling-Frequenz |
| Geo-Blocking | Ländersperren treffen auch Bots aus betroffenen Regionen | Blockaden abhängig von der Quell-IP |
Wie unterscheide ich echte Crawler von gefälschten?
Der User-Agent-String allein taugt nicht als Entscheidungsgrundlage. Er lässt sich beliebig setzen, und genau das tun Scraper regelmäßig, indem sie sich als Googlebot ausgeben. Wer sein Rate-Limit für „Googlebot“ aufhebt, öffnet damit womöglich jedem beliebigen Bot die Tür.
Belastbar ist die Verifizierung über das Netzwerk: Zuerst eine Reverse-DNS-Abfrage der anfragenden IP. Der ermittelte Hostname muss zum Anbieter passen, so bei Google beispielsweise auf googlebot.com oder google.com enden. Anschließend eine Forward-DNS-Prüfung: Der Hostname muss sich wieder auf die ursprüngliche IP auflösen lassen. Erst wenn beide Richtungen stimmen, gilt der Bot als verifiziert. Google beschreibt dieses Vorgehen in seiner Dokumentation zur Crawler-Verifizierung, und auch andere Anbieter veröffentlichen offizielle IP-Bereiche. OpenAI stellt für jeden seiner Bots eine eigene, maschinell lesbare IP-Liste bereit, wie die OpenAI-Dokumentation zu ihren Crawlern zeigt.
Das ist ausdrücklich kein Aufruf, fremde Schutzmechanismen zu umgehen. Es geht ausschließlich um die korrekte Konfiguration deiner eigenen Infrastruktur.
Wie richte ich Bot-Regeln ein, ohne Sichtbarkeit zu verlieren?
Ein sauberes Bot-Management ist kein einmaliger Einrichtungsschritt, sondern ein Betriebsprozess. Diese fünf Schritte halten dich auf der sicheren Seite:
- Bestandsaufnahme: Welche Bots rufen deine Seite tatsächlich ab, und mit welchen Statuscodes? Ohne diese Grundlage konfigurierst du blind.
- Bewusste Whitelist statt Sammelsperre: Lege fest, welche Crawler-Typen du zulassen willst. Suchmaschinen sollten immer ausgewählt sein, Antwort- und Analyse-Crawler nach Bedarf und Trainingscrawler nach bewusster Entscheidung.
- Differenzierte Rate-Limits: Setze Limits je Bot-Gruppe statt global. Ein verifizierter Googlebot darf mehr Abrufe machen als ein unbekannter Scraper. Wie sich Rate-Limiting in nginx gegen Bot-Traffic gezielt einrichten lässt, zeigt ein eigener Leitfaden.
- Monitoring der Statuscodes: Werte regelmäßig aus, ob bekannte Bots 403- oder 429-Antworten bekommen. Das ist die Frühwarnung, die dir das reine Uptime-Monitoring nicht liefert.
- Kontrolle nach jedem Wechsel: Nach einem CDN-, Hosting- oder WAF-Wechsel stehen oft neue Default-Regeln im Regelwerk. Prüfe danach konsequent Bot-Regeln, robots.txt und Indexabdeckung.
Wer diese Schritte umsetzt, beseitigt eine Grundvoraussetzung für Sichtbarkeit. Mehr verspricht das nicht, aber ohne sie bleibt alles andere wirkungslos.
Was bedeutet das für die Auffindbarkeit in KI-Antworten?
Technische Erreichbarkeit ist die Grundvoraussetzung jeder Sichtbarkeit: Was ein Crawler nicht abrufen kann, kann kein System empfehlen. Das gilt für den klassischen Google-Index genauso wie für generative Antwortsysteme.
Für die sogenannte Generative Engine Optimization (GEO) heißt das: Bevor du über Prompt-Optimierung oder Quellenstrategien nachdenkst, muss die Basis stimmen. Antwort-Crawler wie OAI-SearchBot oder PerplexityBot müssen deine Inhalte überhaupt erreichen können. Hinzu kommt sauberes, strukturiertes Markup: klare Überschriftenhierarchien, semantisches HTML und gut gegliederte Inhalte erleichtern Suchmaschinen wie Antwortsystemen das maschinelle Erfassen. Das verbessert die Chancen, als Quelle herangezogen zu werden. Es ist jedoch kein nachgewiesener Garantiemechanismus, und Versprechen in diese Richtung sind unseriös.
Wer das Thema strategisch angehen will, etwa mit Unterstützung durch einen Anbieter für technische KI-Sichtbarkeit, sollte die Serverseite in jedem Fall zuerst prüfen. Und noch einmal zur Einordnung: Trainingscrawler zu blockieren bleibt eine legitime Entscheidung. Sie kostet keine Rankings, kann aber die Nutzung deiner Inhalte durch diesen Crawler begrenzen. Ebenso gilt: Ein blockierter Analyse-Crawler kostet keine Rankings, aber die Fähigkeit, die eigene Sichtbarkeit überhaupt zu messen.
Häufige Fragen zu Crawlern, robots.txt und Bot-Blocking
Woran erkenne ich, ob mein Server Crawler blockiert?
Filtere die Logfiles nach User-Agent und werte die Statuscodes aus. Wiederholt auftretende 403- oder 429-Fehler für bekannte Bots wie den Googlebot oder GPTBot gelten als eines der eindeutigsten Signale für eine Zugriffsbeschränkung.
Schadet es meinem Ranking, wenn ich SEO-Tools aussperre?
Nein. Analyse-Crawler wie AhrefsBot oder SemrushBot haben keinen Einfluss auf Google-Rankings. Du verlierst lediglich deine eigene Datengrundlage, weil die Tools deine Seite nicht mehr erfassen können.
Sollte ich KI-Crawler blockieren?
Das ist eine strategische Entscheidung ohne pauschale Antwort. Wer in KI-Antworten als Quelle vorkommen will, sollte Antwort-Crawler zulassen. Für reine Trainingscrawler kannst du anders entscheiden, wenn dir die Kontrolle über deine Inhalte wichtiger ist.
Reicht ein Eintrag in der robots.txt zum Ausschluss?
Die robots.txt ist eine Bitte an kooperative Crawler, keine technische Sperre. Verbindlich wird ein Ausschluss erst auf Server- oder WAF-Ebene. Und sensible Bereiche solltest du ohnehin anders absichern.
Wie unterscheide ich echte von gefälschten Crawlern?
Die Identifikation erfolgt nicht über den User-Agent-String, da dieser leicht manipuliert werden kann. Stattdessen wird die anfragende IP-Adresse mithilfe einer Reverse-DNS-Prüfung verifiziert, anschließend durch eine Forward-DNS-Abfrage bestätigt und mit den offiziell veröffentlichten IP-Bereichen des jeweiligen Anbieters abgeglichen.
Was ist der Unterschied zwischen GPTBot und OAI-SearchBot?
Der GPTBot sammelt Inhalte für das mögliche Modelltraining, der OAI-SearchBot ruft Inhalte für Antworten in der Suche ab. Eine Sperre hat deshalb völlig unterschiedliche Konsequenzen.
Warum bemerkt man solche Blockaden so spät?
Da die Website im Browser weiterhin erreichbar ist, fällt die Blockierung oft nicht auf. Betroffen sind ausschließlich Bots, deren Zugriffe in der Praxis nur selten regelmäßig überprüft werden.
Was sollte ich nach einem Hosting- oder CDN-Wechsel prüfen?
Das Bot-Regelwerk der neuen Umgebung, die robots.txt, die Statuscodes je Crawler und die Indexabdeckung in der Google Search Console.
Fazit
TL;DR – das solltest du mitnehmen:
- Bestimme vor jeder Regelentscheidung den Bot-Typ: Suchen, Antworten, Training oder Analyse haben völlig unterschiedliche Konsequenzen.
- Prüfe regelmäßig die Statuscodes bekannter Bots in deinen Logfiles. Der Browser-Abruf allein beweist nichts.
- Verwechsle robots.txt nicht mit Zugriffsschutz; verbindliche Sperren gehören auf Server- oder WAF-Ebene.
- Verifiziere echte Crawler über Reverse-DNS und offizielle IP-Listen, nicht über den User-Agent-String.
- Kontrolliere dein Bot-Regelwerk nach jedem CDN-, Hosting- oder WAF-Wechsel neu.
Technische Erreichbarkeit ist keine Garantie für Sichtbarkeit, sie ist aber eine zentrale Voraussetzung dafür, dass Crawler Inhalte zuverlässig erfassen und als Quelle berücksichtigen können. Wer seine Bot-Regeln bewusst pflegt, schafft damit eine wichtige technische Grundlage für die eigene Auffindbarkeit, klassisch wie in KI-Systemen.