 Videre til indhold

Jeg vil kort og grundigt forklare, hvordan Begivenhed MPM der bruger Apache Event Queue til effektivt at styre mange samtidige HTTP-forbindelser. Her gennemgår jeg grundprincipperne, event-loopen, interne køer og konkrete optimeringstiltag for en performant Konfiguration.
Centrale punkter
- Event-loop adskiller forbindelsesstyring og behandling af anmodninger
- Keep-Alive blokerer ikke længere tråde
- Begivenhedskø sorterer stik efter tilstand
- Parametre hvordan man målrettet justerer MaxRequestWorkers
- Overvågning sikrer pålidelig kapacitetsplanlægning
Sådan styrer Event MPM forbindelserne
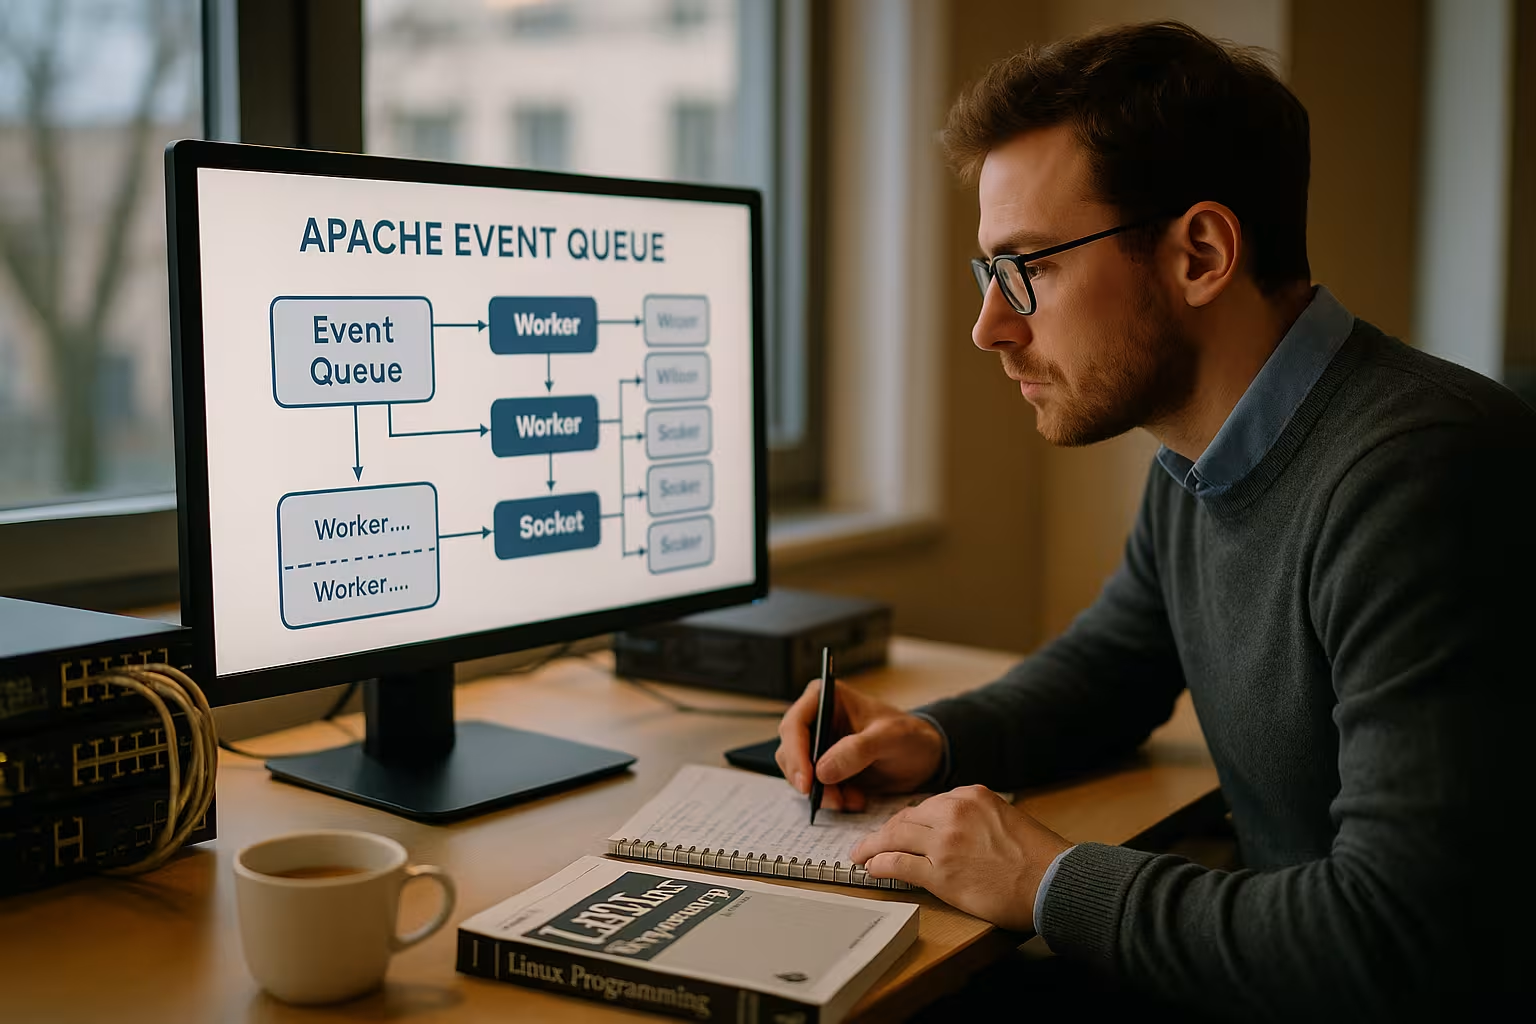
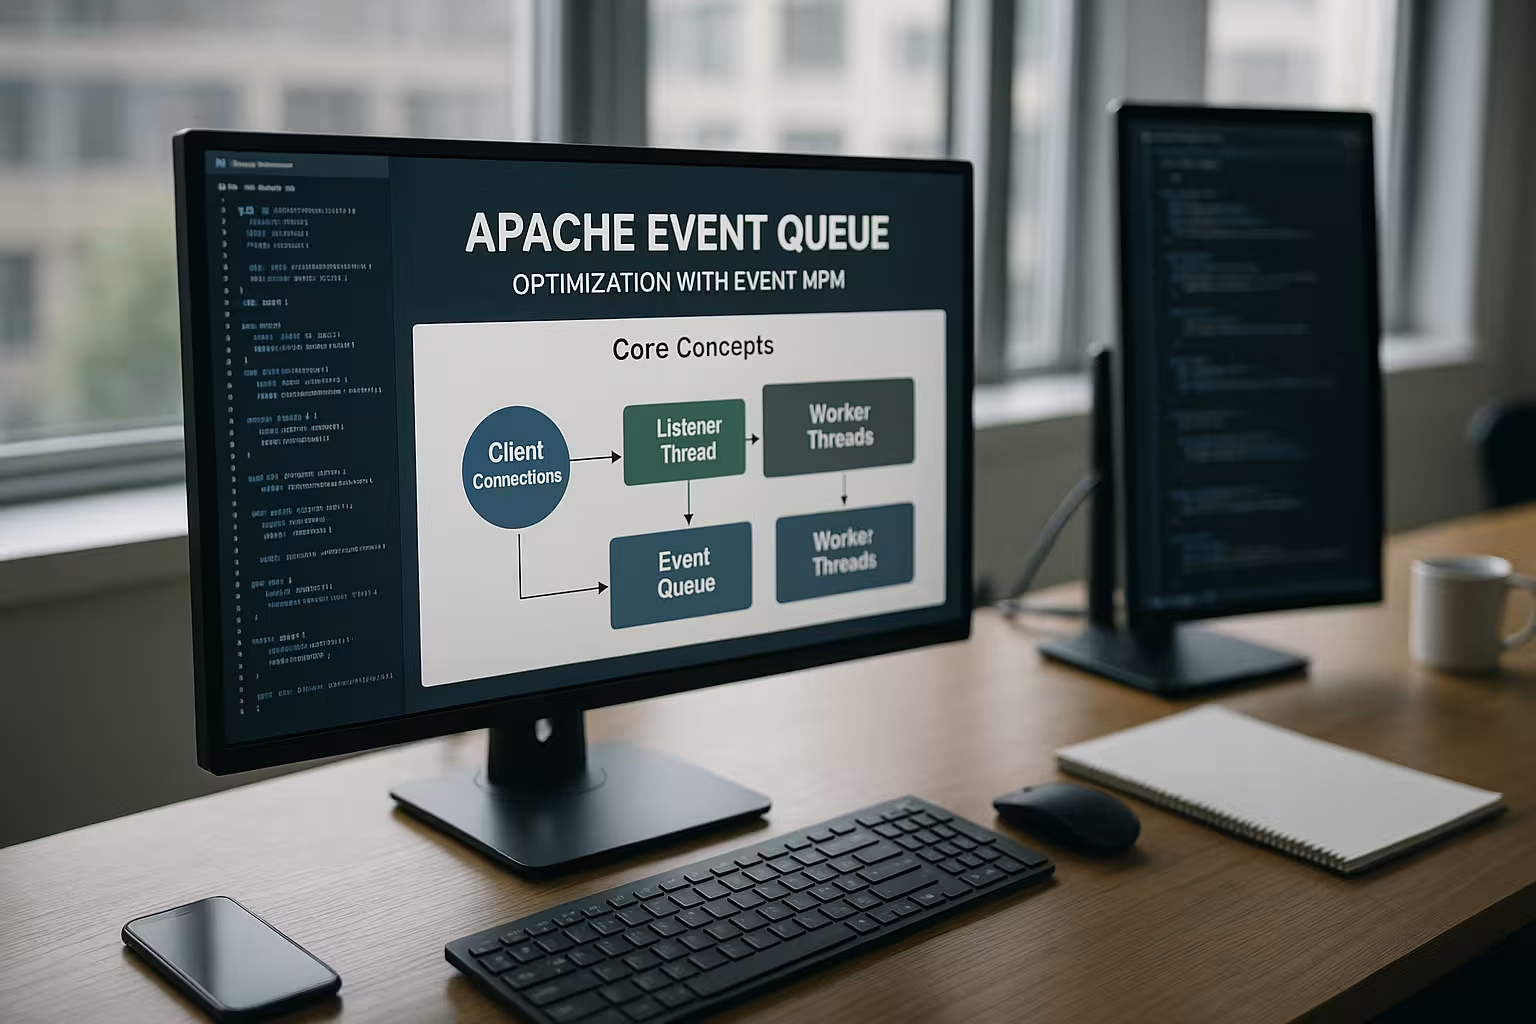
Jeg vil starte med at spørge, hvordan Apache kører under Belastning administrerer så mange forbindelser. Event MPM kombinerer processer og tråde, men prioriterer begivenheder via en begivenhedsløkke. Lyttertråde accepterer nye sokler og overvåger eksisterende forbindelser uden straks at blokere en arbejdstråd. Først når data kan læses eller skrives, overfører begivenhedslaget soklen til en ledig arbejdstråd. På den måde forhindrer jeg, at tomgang-Forbindelser optager tråde og spilder hukommelse.
Denne opdeling reducerer RAM-belastningen mærkbart. Tråde udfører primært „rigtigt arbejde“ såsom analyse af anmodninger, generering af svar eller proxying. Begivenhedsløkken bringer derefter soklerne tilbage til den rette tilstand, f.eks. tilbage til Keep-Alive eller til afslutningsfasen. I praksis observerer jeg kortere køer ved belastningsspidser, fordi ledige tråde hurtigere bliver tilgængelige igen. Arkitekturen leverer en klar skalerende Reaktionshastighed for typiske HTTP/1.1- og HTTP/2-arbejdsbelastninger.
Apache Event Queue i detaljer
Event-køen tildeler hver forbindelse en tilstand, og det er netop her, at Overskud i forhold til klassiske MPM’er. Nye forbindelser havner først i en kø, der kontrollerer, om de er læsbare. Når der modtages data, flytter event-loopen soklen til en „readable“-kø og tildeler den til en worker. Efter behandlingen afgør status igen: afslut skrivning, sæt Keep-Alive på hold eller luk. Denne cyklus forbliver strømlinet, fordi køhåndteringen drives omkostningseffektivt via epoll eller kqueue.
Jeg ser ofte misforståelser: Event Queue erstatter ikke workerne, den koordinerer deres Brug mere effektivt. Tråde fortsætter med at behandle anmodninger, men kun når der rent faktisk overføres bytes. Det skåner CPU’en og hukommelsen i situationer med mange „inaktive“ keep-alive-forbindelser. Jo mere velgennemtænkt timeout- og buffer-designet er, desto mindre er risikoen for, at forbindelser unødigt længe befinder sig i ressourcekrævende tilstande. På denne måde kan responstiden holdes konstant, selv med tusindvis af åbne sockets.
Keep-Alive-problemet ved klassiske MPM’er
I HTTP/1.1 forbliver forbindelser ofte åbne, så der kan sendes flere anmodninger uden en ny håndtryk, hvilket Forsinkelse sparer. Prefork eller Worker opretter imidlertid processer eller tråde, der blot venter. Ved belastningsspidser blokerer mange keep-alive-forbindelser derfor værdifulde eksekveringsressourcer. Dette øger RAM-forbruget og begrænser antallet af parallelle klienter. Event MPM afhjælper dette ved at holde inaktive sockets uden tråd i en gunstig ventetilstand i event-køen.
På den måde sætter jeg mange forbindelser i venteposition og starter først behandlingen, når der faktisk er behov for det. Det ændrer kapacitetsmodellen: I stedet for tråde = forbindelser bruger jeg tråde = aktivt arbejde. I benchmark-scenarier kan jeg dermed tillade betydeligt flere åbne forbindelser uden nedgang i Svartid. For API-backends, WordPress-hosting og store indholdssider betyder det en betydeligt mere jævn belastning. Fordelene ved Keep-Alive bevares, uden at tråde blokeres.
Event-MPM vs. Worker-MPM
Jeg vil kortfattet opsummere forskellene i en Bord sammen. Formålet er at give et hurtigt overblik over håndtering, ressourcebehov og typiske anvendelsesområder. Begge varianter er baseret på processer med flere tråde, men Event binder Keep-Alive sjældnere til en tråd. Worker er stabil ved moderat belastning, mens Event udmærker sig ved mange parallelle forbindelser. Denne inddeling hjælper med at træffe velovervejede beslutninger for ens eget miljø. En mere dybdegående sammenligning finder du under Begivenhed vs. medarbejder.
| MPM | Håndtering af Keep-Alive | Tråde/processer | Krav til RAM | Velegnet til |
|---|---|---|---|---|
| Prefork | Proces blokerer ved tomgang | Kun sager | Høj | Ældre PHP uden trådsikkerhed |
| Arbejder | Tråd forbliver ofte bundet | Processer + tråde | Medium | Moderat belastning, enkle opsætninger |
| Begivenhed | Event-loop gemmer tomgangssockets | Processer + tråde | Lav til middel | Mange klienter, lange keep-alive-faser |
Typiske anvendelsesscenarier
Jeg bruger Event MPM, når der er mange parallelle Klienter anmodninger om små til mellemstore payloads. Blogs med høj trafik, webshops med caching, statiske ressourcer og API-endepunkter oplever en mærkbar fordel. Det samme gælder hosting-opsætninger med mange hjemmesider pr. server, hvor Keep-Alive-forbindelser dominerer. Event-køen holder antallet af aktive tråde lavt og fordeler arbejdet jævnt. Brugere af HTTP/2 får yderligere fordele, da en forbindelse kan bære flere streams, mens event-laget koordinerer tilstandene på en overskuelig måde.
Event viser også sine styrker i reverse-proxy-topologier. Jeg lader Apache håndtere SSL-kryptering, cache-håndtering og videresendelse af anmodninger til et app-lag. Dermed forbliver forbindelsesstyringen letvægtsbaseret, hvilket afbøder flaskehalse. Selv ved trafikspidser forbliver svartiderne under kontrol, forudsat at grænserne er sat fornuftigt. Det mindsker risikoen for Kø-Overbelastning og timeouts.
Konfiguration: Nøgledirektiver
For at sikre en holdbar indstilling tjekker jeg først ServerLimit, StartServers, ThreadsPerChild og MaxRequestWorkers. Tommelfingerreglen er: ServerLimit × ThreadsPerChild bør ligge tæt på MaxRequestWorkers, med en buffer til vedligeholdelse og vækst. En for lav værdi begrænser paralleliteten, mens en for høj værdi øger RAM-behovet unødigt. Jeg sætter KeepAlive til On, men dimensionerer KeepAliveTimeout moderat, så inaktivitet ikke løber løbsk. Værdier mellem få og lave tocifrede sekunder fungerer ofte godt, afhængigt af trafikprofilen.
Desuden tager jeg højde for timeouts for læsning, skrivning og proxyer. Kortere værdier beskytter mod fastlåste backends, mens længere værdier hjælper ved langsomt reagerende klienter, hvilket Afvejninger kræves. For statiske filer er det en god idé at sende dem i større blokke og anvende effektive filterkæder. Når jeg bruger PHP via FPM eller proxy-loadbalancere, skalerer jeg backend-workere, så de passer til frontend-parallelliteten. Jeg dokumenterer hver ændring og måler effekten, før jeg fortsætter.
Optimering af begivenhedskøen: trin for trin
Jeg starter med en klar lastprofil: samtidige forbindelser, anmodninger pr. sekund, svarstørrelser, andel af Keep-Alive-forbindelser. Derefter indstiller jeg MaxRequestWorkers, så CPU’en ikke går i tomgang, men RAM’en stadig er rigeligt tilgængelig. Jeg justerer ThreadsPerChild, indtil belastningstoppe håndteres uden ventetid. KeepAliveTimeout kalibrerer jeg for at opnå en god balance mellem brugeroplevelse og ressourcebesparelse. Hvis du ønsker at forstå køadfærd mere indgående, kan du finde grundlæggende information under Kø til webserver.
Jeg udfører iterative tests med værktøjer som ab, wrk eller k6 og analyserer ventetiderne i P50, P95 og P99. Her holder jeg øje med, hvornår forbindelserne forbliver i Keep-Alive-tilstand, og hvornår de lukkes. En let overprovisionering af tråde hjælper med at afbøde korte spidsbelastninger uden at overbelaste maskinen. Samtidig tjekker jeg fejllogfilerne for meddelelser som „server reached MaxRequestWorkers“. På den måde får jeg et harmonisk Samspillet mellem event-køen og arbejdspuljen.
Overvågning og målinger
Gode måleparametre sikrer en pålidelig Kapacitet. Jeg aktiverer mod_status og overvåger aktive, inaktive og ventende arbejdsprocesser. Resultattavlen viser, om der er anmodninger, der venter, eller om der er ledige ressourcer. Derudover måler jeg antallet af processer og tråde, RAM-udnyttelsen og netværks-I/O. En visuel analyse hjælper med at identificere tendenser og vendepunkter. Flere detaljer findes i Apache Scoreboard.
Jeg sammenholder disse værdier med Access-logfiler og fejlkoder. Hvis 5xx-procenten stiger, samtidig med at systemet kører på fuld kapacitet, er grænseværdierne ofte for lave. Hvis timeouts stiger, tjekker jeg backend-tjenester, DNS-opløsning og netværksstier. Jeg ser også på TCP-backlogs og SYN-retransmissioner ved høj belastning. På den måde kan jeg se, om Årsag på webserveren, i backend eller i netværket.
HTTP/2, reverse proxy og moduler
HTTP/2 samler flere strømme i én forbindelse, hvilket Begivenhed-arkitekturen fungerer optimalt. Jeg sørger for at finde den rette balance mellem stream-begrænsninger og trådpuljen, så mange små streams ikke ender i køer. Som reverse proxy drager Apache fordel af korte timeouts og pålidelige backend-forbindelser. Moduler, der arbejder meget blokerende, kan dog binde tråde og mindske fordelene. Derfor tjekker jeg kompatibiliteten og udskifter forældede komponenter, hvis de skaber spidsbelastninger i latenstiden.
Cache-moduler og komprimering øger effektiviteten, så længe CPU-profilerne passer til formålet. TLS-optimering med moderne krypteringsalgoritmer og prioritering af HTTP/2 bidrager til hurtigere levering. Jeg anvender session-resumption og overvåger handshake-omkostningerne under belastning. For statiske ressourcer fungerer zero-copy-tilgange og sendfile godt. Den Kunst består i at holde kæden bestående af TLS, event-kø, worker og backend slank.
Interne processer og tilstande i MPM-begivenheden
For at forstå de interne processer tænker jeg i tilstande: accept → læsbar → under behandling → skrivbar → keep-alive → luk. Lytter-tråde overvåger sokler ved hjælp af effektive kerne-mekanismer (epoll/kqueue) og vækker kun arbejdstråde, når der indtræffer en begivenhed. Efter behandlingen af en anmodning beslutter begivenhedslaget, om forbindelsen skal sættes i keep-alive-tilstand, lukkes direkte eller afsluttes på en måde, der ligner en „lingering close“, så sene TCP-pakker behandles korrekt. Denne tilstandsautomat forhindrer „busy waiting“ og minimerer kontekstskift.
Det er vigtigt at skelne mellem I/O-ventetid og CPU-belastning: Parsning af anmodninger, filter-pipelines (f.eks. komprimering) og generering af svaret kører i arbejdstråde. Den rene ventetid på læse-/skriveadgang forbliver i begivenhedsløkken. Dermed udnytter Apache de eksisterende tråde bedre og reducerer Trådtæthed drastisk pr. åben forbindelse.
Jeg tager desuden højde for scoreboard-adfærden: I mod_status kan man aflæse faser som „R“ (Reading), „W“ (Sending Reply), „K“ (Keepalive) og „G“ (Gracefully finishing). En høj „K“-andel kombineret med ledige workere viser, at event-køen fungerer korrekt og ikke spilder tråde. Hvis „R“-tiderne stiger markant, tyder det på, at der er potentiale for optimering på grund af langsomme klienter eller for restriktive læsetimeouts.
Ressourceplanlægning: Beregningseksempel og fornuftige standardindstillinger
Jeg beregner Parallelisme bestående af CPU, RAM og arbejdsbelastning. Et eksempel: 8 vCPU, 16 GB RAM, primært cachelagret indhold og PHP-FPM i backend. Jeg starter med MaxRequestWorkers på 512–768, ThreadsPerChild på 32–64 og ServerLimit tilsvarende 8–12. Jeg regner med 1–3 MB Apache-overhead plus moduler pr. aktiv worker, og dertil kommer svarbuffer, TLS-overhead og backend-sockets. Realistisk set reserverer jeg 4–8 GB til Apache-processer/tråde, 2–4 GB til OS-cache og resten til backends. Jeg sørger for, at ServerLimit × ThreadsPerChild aldrig mindre end MaxRequestWorkers; det er en god idé at have lidt buffer.
Oversigt over nyttige retningslinjer: – MinSpareThreads/MaxSpareThreads: Indstil reserven således, at spidsbelastninger kan afhjælpes uden „koldstart“, men uden at for mange inaktive tråde optager hukommelse. – MaxConnectionsPerChild (alias MaxRequestsPerChild): En begrænset levetid pr. proces hjælper med at undgå hukommelsesfragmentering og lækager ved langvarig drift (f.eks. 5k–20k). – MaxKeepAliveRequests: Begrænser antallet af anmodninger pr. forbindelse; moderate værdier beskytter mod „uendelige“ sessioner uden at forringe fordelene ved Keep-Alive (f.eks. 100–1000). – Timeout, Tidsgrænser for læsning/skrivning og ProxyTimeout: Undgå, at systemet hænger sig fast; jeg indstiller forskellige værdier alt efter konteksten i stedet for at være for konservativ på globalt plan.
Til statiske filer bruger jeg EnableSendfile og Aktiver MMAP Bevidst: På lokale diske kan begge dele være en fordel; ved NFS/cloud-volumener deaktiverer jeg ofte sendfile for at undgå særlige tilfælde. I TLS-stier har sendfile på grund af sin opbygning mindre effekt, da dataene løber gennem krypteringspipelines; her er det især vigtigt med en effektiv Filterkæde.
Operativsystem- og netværksbegrænsninger
Selv den bedste event-arkitektur nytter ikke meget, hvis begrænsninger i operativsystemet bremser den. Jeg tjekker: – Fildeskriptorer (ulimit -n): Værdien bør ligge et godt stykke over det maksimale antal samtidige forbindelser plus backend-sockets; flere titusinder er normalt for travle værter. – LytBacklog: En tilstrækkelig stor Accept-backlog forhindrer afviste SYN-pakker i spidsbelastningsperioder. – Kernel-backlogs (f.eks. somaxconn) og SYN-køer: De skal passe til den forventede „burst“-hastighed. – Netværksbuffer (rmem/wmem): Undgå at overbelaste, men dimensioner det således, at strækninger med høj RTT eller høj båndbredde ikke bryder sammen.
Jeg fordeler Accept-belastningen på flere lyttertråde og lader som regel platformen vælge Accept-mekanismen (AcceptMutex auto). På systemer, der understøtter det, kan SO_REUSEPORT (afhængigt af platformen via en listeindstilling) udjævne acceptstierne. Det er vigtigt at undgå »Thundering Herd«-situationer, hvor mange tråde kæmper om den samme accept.
Også TCP-midlertidige porte (ip_local_port_range) og TIME-WAIT-adfærd skal passe til antallet af parallelle proxy-forbindelser. Jeg undgår aggressive justeringer, men tester i stedet under realistiske forhold og sikrer, at backend-serverne understøtter Keep-Alive, så forbindelserne kan genbruges, og der opstår færre portskift.
Finesser ved reverse-proxy: Forbindelsespuljer og backends
Som reverse proxy afhænger den samlede ydeevne i høj grad af stabile backend-forbindelser. Jeg sørger for, at Proxy-forbindelser Sørg for, at forbindelsen forbliver vedvarende (Keep-Alive til backend), og dimensioner backend-puljerne, så de følger frontend-parallelliteten. For små puljer skaber frontend-flaskehalse, mens for store puljer skaber unødvendig belastning på appen.
Praktiske justeringsmuligheder: – ProxyTimeout: Kortere for ukritiske stier, længere for „dyre“ slutpunkter – differentier, undgå globale generaliseringer. – Afbalancering-Indstillinger (for mod_proxy_balancer): Vægte, maksimalt antal forbindelser pr. backend, helbredssensitive gentagelsesintervaller. – mod_proxy_fcgi for PHP-FPM: FPM-pm.*-Værdierne (pm.max_children, pm.start_servers osv.) skal passe til Apache-parallelliteten for at undgå 502/504-spidsbelastninger.
Jeg sørger for, at backend-fejl eskaleres korrekt og hurtigt, i stedet for at optage frontend-tråde. Health-checks, en forsigtig retry-politik og mønstre, der ligner circuit breakers, holder latenstiderne stabile. Hvor det er muligt, sørger jeg for Caching af svar på passende steder, så MPM-arrangementet først og fremmest kan sende korte, enkle svar.
Finjustering af HTTP/2 under Event
Når det gælder HTTP/2, optimerer jeg ud over TLS især Stream-begrænsninger og tildeling af arbejdstråde. Mange små streams pr. forbindelse kan reducere latenstiden, men øge trådbelastningen. Jeg indstiller det maksimale antal streams pr. session, så multiplexing træder i kraft, men uden at der opstår en „head-of-line“-erstatning. Derudover skalerer jeg antallet af arbejdsprocesser forsigtigt opad, så spidsbelastninger kan afbødes uden at overbelaste RAM'en.
Jeg har lagt mærke til, hvor ofte streams venter, selvom der er ledige tråde. Når det sker, er det som regel stream-begrænsninger eller bufferstørrelser, der begrænser gennemstrømningen. En Prioritering Kritiske ressourcer (f.eks. CSS/JS via HTTP/2-prioriteter) har en direkte indflydelse på den oplevede ydeevne. På TLS-siden reducerer session-resumption, 0-RTT-lignende mekanismer (forudsat at de er sikre og tilgængelige) og moderne krypteringsalgoritmer omkostningerne ved håndtrykket.
Robusthed: Timeouts, beskyttelse mod Slowloris og »graceful shutdown«
Jeg aktiverer mod_reqtimeout, for at afbøde »slowloris«-lignende mønstre. Læsetimeouts forhindrer, at klienter leverer bytes i sneglefart og dermed optager ressourcer. Skrivetimeouts beskytter mod træge forbindelser til klienten. Disse værdier skal vælges ud fra konteksten – API’er kræver andre profiler end store filoverførsler.
Når det gælder udrulninger og genstarter, satser jeg på Yndefuld-Processer. Med en fornuftig „graceful timeout“ afvikles gamle processer kontrolleret, mens nye processer overtager. På den måde forbliver keep-alive-forbindelser stabile, og eventkøen afvikler den resterende belastning uden pludselige afbrydelser. Roterende logfiler, lav log-detaljeringsgrad i spidsbelastningsperioder (f.eks. „info“ i stedet for »debug«) og valgfrit BufferedLogs reducerer I/O-belastningen mærkbart.
Fejlfinding under belastning: Genkende mønstre
Typiske symptomer og tilgange: – Høj P95/P99-Forsinkelser ved ledige workere: Oftest ventetider i backend eller på netværket; kontroller proxy- og læsetimeouts samt backend-puljer. – „server reached MaxRequestWorkers“: For lidt parallelitet – øg MaxRequestWorkers og/eller ThreadsPerChild, og kontroller RAM-forbruget. – Mange Keep-Alive-Forbindelser, få aktive tråde, men alligevel langsomt: Ofte blokerende moduler/filtre eller flashrum i backend; udfør profilering af filterkæden, og kontroller CPU-udnyttelse og I/O. – 5xx-spidsbelastninger med korrelerende TLS-belastning: CPU-afhængige håndtryk – optimer krypteringsalgoritmer, genoptagelse af sessioner og eventuelt offload.
Jeg fjerner flaskehalse i hele kæden: Socket-accept (backlog), event-loop (ventetilstande), worker (CPU-begrænset), filter (I/O-begrænset), proxy (backend-begrænset). Denne tankemodel forhindrer mig i at justere MaxRequestWorkers, selvom det egentlig er backendet, der er flaskehalsen.
Tjekliste til praksis og typiske forhindringer
Jeg arbejder med en kort Tjekliste: den aktuelle Apache-version, Event MPM aktiveret, grænseværdier korrekt indstillet, timeouts fornuftigt valgt. Derefter kontrollerer jeg Keep-Alive-frekvenser og forholdet mellem forbindelser og aktive tråde. Jeg tjekker, om modulerne er trådsikre, og om filtre ikke forårsager lange blokeringer. For PHP via FPM sikrer jeg, at FPM-workere passer til frontend-parallelliteten. Ligeledes kalibrerer jeg OS-begrænsninger såsom filbeskrivere, TCP-backlog og kerneparametre for netværksbuffere, så Rørledning ikke går i stå.
Jeg opdager hurtigt almindelige faldgruber: for store KeepAliveTimeouts, for få MaxRequestWorkers, lavt ThreadsPerChild eller uhensigtsmæssig logning. Alt for detaljeret logning belaster I/O og forsinker svarene. En for lille proxy-backend-poolstørrelse undergraver frontend-optimeringen. Forkerte TLS-konfigurationer forlænger håndtryk unødigt. Hvis man får styr på disse punkter, skaber man en pålidelig Grundlaget for konstante latenstider.
Resumé til de tekniske ansvarlige
Event MPM adskiller klart forbindelsesstyring og udførelse og satser på en Begivenhedskø, som effektivt parkerer inaktive forbindelser. Dermed kan Apache skalere ved mange samtidige klienter uden at lade tråde hænge i luften. Den rette kombination af MaxRequestWorkers, ThreadsPerChild og gennemtænkte timeouts holder latenstiden og RAM-forbruget under kontrol. Med løbende overvågning, benchmarking og nogle få målrettede justeringer skabes et system, der håndterer spidsbelastninger og svarer konsekvent. Den, der følger disse principper, får det bedste ud af sin Apache-Installationen får langt mere ud af det og er samtidig kompatibel med gængse applikationer og protokoller.


